本篇目录
- 91 团队项目开发的问题和解决方案
- 92 Docker容器技术详解
- 93 MySQL性能优化
- 94 网络API接口设计
- 95 使用Django开发商业项目
- 96 软件测试和自动化测试
- 97 电商网站技术要点剖析
- 98 项目部署上线指南
- 99 面试中的公共问题
- 100 补充内容
目录里每一条都可以点开直达对应章节;右侧(移动端为悬浮按钮)的「文章目录」也会列出同一批标题。
91 团队项目开发的问题和解决方案
个人开发和团队开发这两个词相信对大家来说并不陌生。所谓个人开发就是一个人把控产品的所有内容;而团队开发则是由多个人组团并完成产品的开发。要实施团队开发以下几点是不可或缺的:
- 对开发过程中的各种事件(例如:谁到什么时间完成了什么事情)进行管理和共享。
- 在团队内部共享各类工作成果以及新的知识技巧等。
- 管理工作成果的变更,既要防止成果被破坏,又要保证各个成员利用现有成果并行作业。
- 证明团队开发出的软件在任何时候都是可以正常运行的。
- 使用自动化的工作流程,让团队成员能够正确的实施开发、测试和部署。
团队项目开发常见问题
团队开发相较于个人开发,容易遇到以下几个方面的问题。
问题1:传统的沟通方式无法确定处理的优先级
例如:使用邮件进行沟通可能出现邮件数量太多导致重要的邮件被埋没,无法管理状态,不知道哪些问题已经解决,哪些问题尚未处理,如果用全文检索邮件的方式来查询相关问题效率过于低下。
解决方案:使用缺陷管理工具。
问题2:没有能够用于验证的环境
例如:收到项目正式环境中发生的故障报告后,需要还原正式环境需要花费很长的时间。
解决方法:实施持续交付。
问题3:用别名目录管理项目分支
解决方法:实施版本控制。
问题4:重新制作数据库非常困难
例如:正式环境和开发环境中数据库表结构不一致或者某个表列的顺序不一致。
解决方法:实施版本控制。
问题5:不运行系统就无法察觉问题
例如:解决一个bug可能引入其他的bug或者造成系统退化,不正确的使用版本系统覆盖了其他人的修改,修改的内容相互发生了干扰,如果问题不能尽早发现,那么等过去几个月后再想追溯问题就非常麻烦了。
解决方法:实施持续集成,将团队成员的工作成果经常、持续的进行构建和测试。
问题6:覆盖了其他成员修正的代码
解决方法:实施版本控制。
问题7:无法实施代码重构
例如:在实施代码重构(在不影响代码产生的结果的前提下对代码内部的构造进行调整)时可能引发退化。
解决方法:大量的可重用的测试并实施持续集成。
问题8:不知道bug的修正日期无法追踪退化
解决方法:版本控制系统、缺陷管理系统和持续集成之间需要交互,最好能够和自动化部署工具集成到一起来使用。
问题9:发布过程太复杂
解决方法:实施持续交付。
基于对上述问题的阐述和分析,我们基本上可以得到以下的结论,在团队开发中版本控制、缺陷管理和持续集成都是非常重要且不可或缺的。
版本控制
针对上面提到的一系列问题,我们可以得出一个简单的结论,版本控制是实施团队开发的首要前提,必须通过版本控制对产品研发过程中产生的各种信息进行管理,这些内容包括:
- 代码。
- 需求和设计的相关文档。
- 数据库模式和初始数据。
- 配置文件。
- 库的依赖关系定义。
Git简介
Git是诞生于2005年的一个开源分布式版本控制系统,最初是Linus Torvalds(Linux之父) 为了帮助管理Linux内核开发而开发的一个版本控制软件。Git与常用的版本控制工具Subversion等不同,它采用了分布式版本控制的方式,在没有中央服务器支持的环境下也能够实施版本控制。
对于有使用Subversion(以下简称为SVN)经验的人来说,Git和SVN的共同点是摒弃了传统的基于锁定模式的版本控制(早期的CVS和VSS使用了锁定模式,当一个开发者编辑一个文件时会锁定该文件,其他开发者在此期间无法编辑该文件),采用了更有效率的基于合并模式的版本控制,而二者的区别在于:
- Git是分布式的,SVN是集中式的,SVN需要中央服务器的支持才能工作。
- Git把内容按元数据方式存储,而SVN是按文件,即把文件的元信息隐藏在一个.svn文件夹里。
- Git分支和SVN的分支不同,SVN对分支的处理是相当“狗血”的。
- Git没有一个全局版本号,但是可以自己维护一个版本标签。
- Git的内容完整性要优于SVN,Git的内容存储使用的是SHA-1哈希算法。这能确保代码内容的完整性,确保在遇到磁盘故障和网络问题时降低对版本库的破坏。
总而言之,Git真的非常棒!!!
安装Git
可以在Git官方网站找到适合自己系统的Git下载链接并进行安装,macOS和Windows平台下安装Git都非常简单。
Git本地操作
可以使用下面的命令将一个文件夹变成Git仓库。
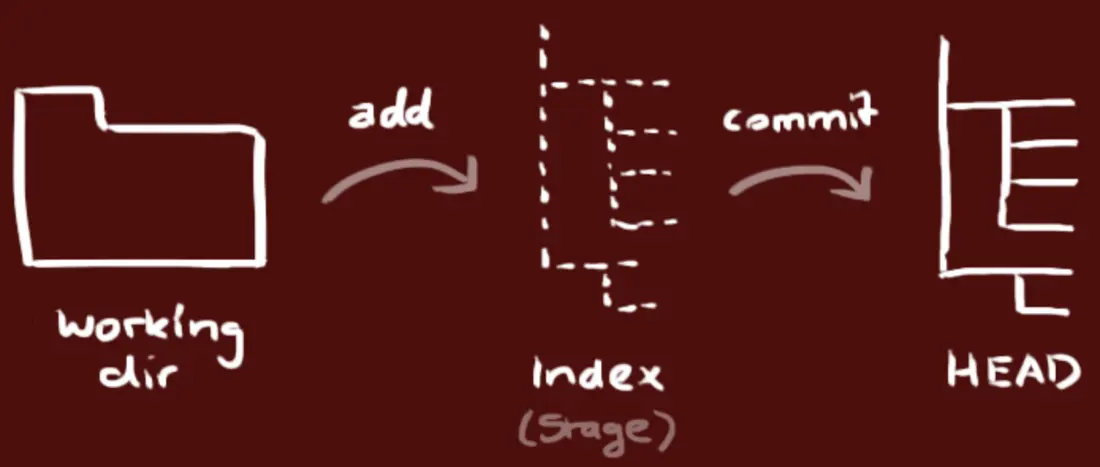
git init当你完成了上述操作后,本地目录就变成了下面的样子,下图左边是你的工作区(正在操作的工作目录),而右边是你的本地仓库,中间是工作区和本地仓库之间的暂存区(也称为缓存区)。
提示:用
ls -la查看所有文件会发现在执行完上面的命令后,文件夹下多了一个名为.git的隐藏文件夹,这个就是本地的Git版本仓库。
通过git add可以将指定的文件或所有文件添加到暂存区。
git add <file>git add .这个时候使用下面的命令可以查看工作区、暂存区和本地仓库的状态。
git status提示:如果不希望将文件添加到暂存区,可以按照提示,使用
git rm --cached <file>命令将文件从暂存区放回到工作区。
如果这个时候对工作区的文件又进行了修改使得工作区和暂存区的内容并不相同了,再次执行git status可以看到哪个或哪些文件被修改了,如果希望用暂存区的内容恢复工作区,可以使用下面的命令。
git restore <file>git restore .注意:上面的命令目前仍然处于试验性阶段,在Git较早的版本中对应的命令是
git checkout -- <file>。由于git checkout这个命令还可以用于切换分支,容易引起混淆,所以Git最新版本中将这个命令的两项功能分别赋予两个新的命令,一个就是上面的git restore,另一个是git switch。
如果第一次使用Git,需要配置用户名和邮箱,然后才能将代码提交到仓库。
git config --global user.name "jackfrued"git config --global user.email "jackfrued@126.com"提示:可以用
git config --list来查看Git的配置信息。
通过下面的命令可以将暂存区的内容纳入本地仓库,
git commit -m '本次提交的说明'可以通过git log查看每次提交对应的日志。
git loggit log --graph --oneline --abbrev-commitGit服务器概述
Git不像SVN那样一定需要中央服务器才能工作,上面我们演示的版本控制操作都是在本地执行的,但是对于企业开发多人协作这样的场景还是需要中央服务器的支持。通常,企业可以选择使用代码托管平台(如GitHub)或自己搭建Git私服的方式来建立中央服务器(版本仓库),当然大多数的企业更倾向于后者。Github创办于2008年4月,目前是全世界最大的代码托管平台,支持企业用户(可以创建私有仓库,私有仓库内容不对外界公开)和普通用户(受限的使用私有仓库,不受限的使用公开仓库,公开仓库内容对他人可见)。Github上面代码库惊人的增长速度证明了它是非常成功的,在2018年6月被微软以75亿美元的天价收购。
国内也有不少类似Github的代码托管平台(例如:码云和CODING),目前码云和CODING对注册用户都提供了受限的使用私有仓库的功能,支持Pull Request(一种对话机制,可以在提交你的工作成果时让相关人员或团队注意到这件事情),同时还提供了对缺陷管理、Webhook等功能支持,这些使得版本控制系统还具备了缺陷管理和持续集成的能力。当然,很多公司都不愿意将自己的商业代码托管于别人的平台,这样的公司可以用Gitlab来搭建公司内部的Git私服,具体的做法在下一章为大家介绍。
这里我们直接以码云为例来说明使用Git服务器的一些注意事项。首先需要在码云上注册账号,当然也可以使用第三方登录(github账号、微信账号、新浪微博账号、CSDN账号等),登录成功后就可以创建项目,创建项目几乎是“傻瓜式”的,无需赘述,我们只对几个地方加以说明。
-
创建项目时不建议勾选如下图所示的这些选项,编程语言可以暂时不做选择,而
.gitignore模板也可以稍后自己编写或者通过更专业的工具(如:http://gitignore.io/网站)自动生成。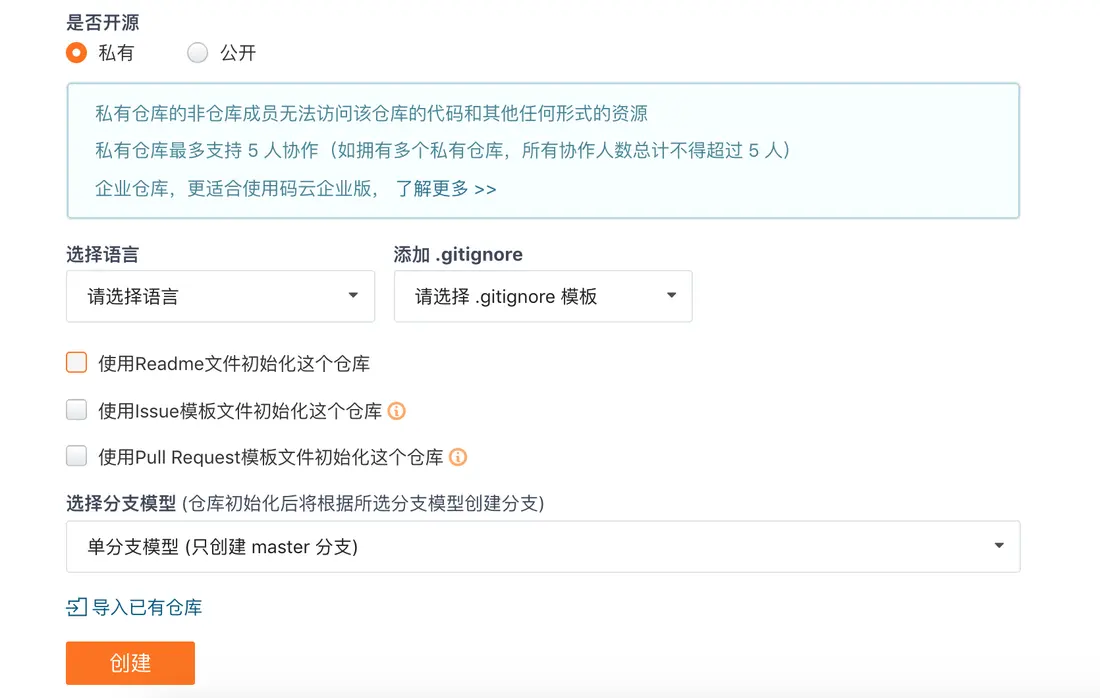
-
添加项目成员。创建项目后,可以在项目的“设置”或“管理”中找到“成员管理”功能,这样就可以将其他开发者设置为项目团队的成员,项目成员通常分为“所有者”、“管理者”、“普通成员”和“受限成员”几种角色。
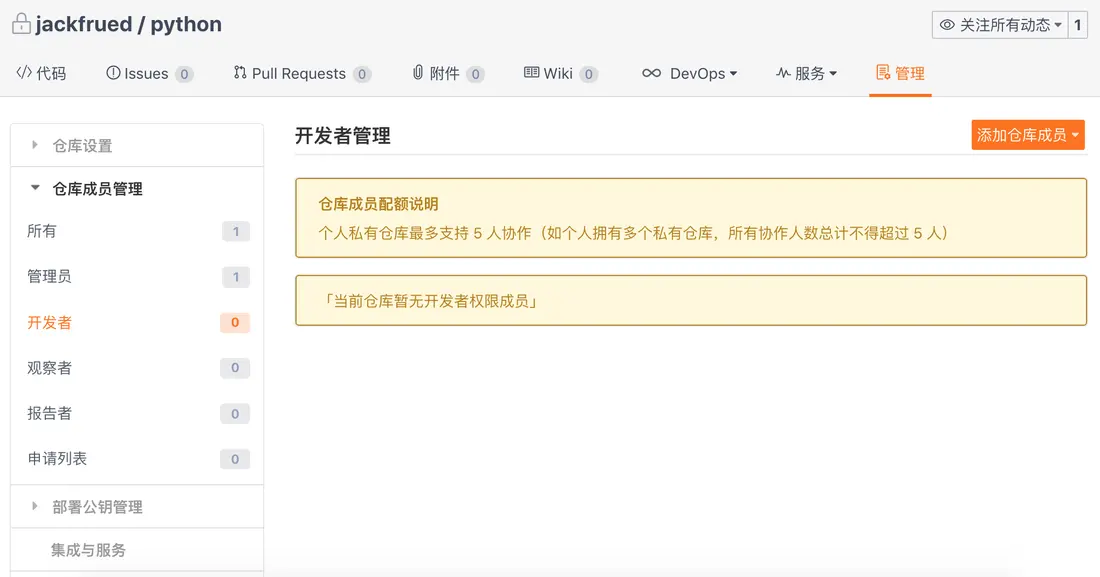
-
项目的分支。创建项目后,项目只有一个默认的master分支,应该将该分支设置为“保护分支”来避免项目管理者之外的成员修改该分支(不可直接提交)。当然,如果需要我们也可以在线创建新的代码分支。
-
设置公钥实现免密访问。在项目的“设置”或“管理”中我们还可以找到“部署公钥管理”的选项,通过添加部署公钥,可以通过SSH(安全远程连接)的方式访问服务器而不用每次输入用户名和口令。可以使用
ssh-keygen命令来创建密钥对。Terminal window ssh-keygen -t rsa -b 2048 -C "your_email@example.com"说明:上面命令生成的密钥对在
~/.ssh目录下,公钥文件默认的名字为id_rsa.pub,可以通过cat id_rsa.pub来查看自己的公钥。Windows用户在安装Git工具后,可以通过Git Bash来输入上面的命令。
Git远程操作
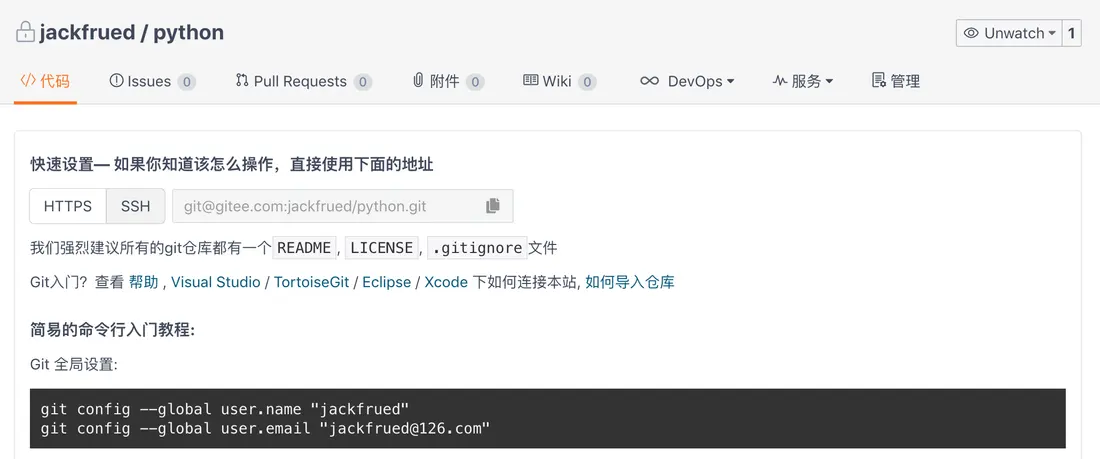
拥有了Git服务器之后,我们就可以通过Git的远程操作将自己的工作成果推到服务器的仓库中,也可以将他人的工作成果从服务器仓库更新到本地。我们以刚才在码云上创建的仓库(仓库名为python)为例来说明如何进行远程操作。可以在如下所示的页面上找到仓库的地址(URL),如果配置了SSH Key就使用SSH方式访问仓库,否则就用HTTPS方式,后者需要在进行远程操作时提供用户名和口令。
-
添加远程仓库(Git服务器)。
Terminal window git remote add origin git@gitee.com:jackfrued/python.git其中
git@gitee.com:jackfrued/python.git是上图中显示的仓库的URL,而前面的origin是替代这个冗长的URL的字符串,简单的说origin就是服务器上仓库的别名(如果有多个Git服务器,这个简短的名字也会有多个)。可以用git remote -v来查看已经指定的Git服务,也可以用git remote remove来删除指定的Git服务器。 -
将本地代码(工作成果)推送到远程仓库。
Terminal window git push -u origin master:master其中,
-u是--set-upstream的缩写,用来指定推送的服务器仓库,后面的origin就是刚才给仓库起的简短的别名,冒号前面的master是本地分支名,冒号后面的master是远程分支名,如果本地分支master已经和远程分支master建立过关联,则冒号以及后面的部分可以省略。 -
从远程仓库取回代码。
Terminal window git pull origin master
Git分支操作
-
创建和切换分支。下面的命令创建了名为
dev的分支并切换到该分支。Terminal window git branch <branch-name>git switch <branch-name>或
Terminal window git switch -c <branch-name>注意:在之前的Git版本中,切换分支使用
git checkout <branch-name>命令,也可以通过git checkout -b <branch-name>来创建并切换分支。git switch命令目前仍然处于试验性阶段,但很明显这个命令更加清晰的表达了它要做的事情。 -
关联远程分支。例如:如果当前所在的分支还没有关联到远程分支,可以使用下面的命令为它们建立关联。
Terminal window git branch --set-upstream-to origin/develop如果需要为指定的分支关联远程分支,可以如下操作。
Terminal window git branch --set-upstream-to origin/develop <branch-name>提示:上面的操作假设Git服务器上存在名为
develop的分支,--set-upstream-to可以缩写为-u。当然,在创建分支时,如果使用了
--track参数,也可以直接指定与本地分支关联的远程分支,如下所示。Terminal window git branch --track <branch-name> origin/develop如果需要解除本地分支与远程分支的关联,可以使用下面的命令。
Terminal window git branch --unset-upstream <branch-name> -
分支合并。例如在
dev分支上完成开发任务之后,如果希望将dev分支上的成果合并到master,可以先切回到master分支然后使用git merge来做分支合并,合并的结果如下图右上方所示。Terminal window git switch mastergit merge --no-ff dev使用
git merge合并分支时,默认使用Fast Forward合并,这意味着如果删除了分支,分支上的信息就全都丢掉了,如果希望将分支上的历史版本保留下来,可以使用--no-ff参数来禁用Fast Forward。在合并分支时,没有冲突的部分Git会做自动合并。如果发生了冲突(如
dev和master分支上都修改了同一个文件),会看到CONFLICT (content): Merge conflict in <filename>. Automatic merge failed; fix conflicts and then commit the result(自动合并失败,修复冲突之后再次提交)的提示,这个时候我们可以用git diff来查看产生冲突的内容。解决冲突通常需要当事人当面沟通之后才能决定保留谁的版本,冲突解决后需要重新提交代码。 -
分支变基。分支合并操作可以将多个分支上的工作成果最终合并到一个分支上,但是再多次合并操作之后,分支可能会变得非常的混乱和复杂,为了解决这个问题,可以使用
git rebase操作来实现分支变基。如下图所示,当我们希望将master和dev上的工作成果统一到一起的时候,也可以使用变基操作。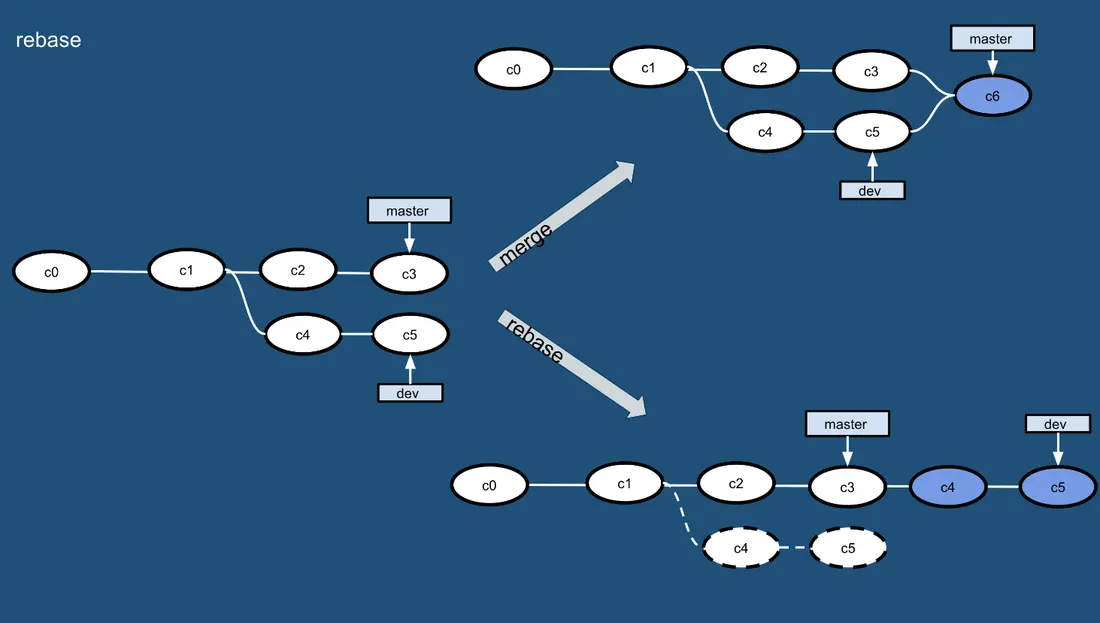
Terminal window git rebase mastergit switch mastergit merge dev当我们在
dev分支执行git rebase命令时,将首先计算dev分支和master分支的差集,然后应用该差集到dev分支,最后我们切回到master分支并执行操作合并,这样就看到了如上图右下方所示的干净的分支。 -
删除分支。删除分支可以使用
git branch加上-d参数,如果分支上的工作成果还没有合并,那么在删除分支时会看到error: The branch '<branch-name>' is not fully merged.这样的错误提示。如果希望强行删除分支,可以使用-D参数。删除分支的操作如下所示。Terminal window git branch -d <branch-name>error: The branch '<branch-name>' is not fully merged.If you are sure you want to delete it, run 'git branch -D <branch-name>'.git branch -D <branch-name>如果要删除远程分支,可以使用下面的命令,但是请慎重的操作。
Terminal window git branch -r -d origin/developgit push origin :develop或者
Terminal window git push origin --delete develop
Git其他操作
-
git fetch:下载远程仓库的所有变动,可以将远程仓库下载到一个临时分支,然后再根据需要进行合并操作,git fetch命令和git merge命令可以看作是之前讲的git pull命令的分解动作。Terminal window git fetch origin master:tempgit merge temp -
git diff:常用于比较工作区和仓库、暂存区与仓库、两个分支之间有什么差别。 -
git stash:将当前工作区和暂存区发生的变动放到一个临时的区域,让工作区变干净。这个命令适用于手头工作还没有提交,但是突然有一个更为紧急的任务(如线上bug需要修正)需要去处理的场景。Terminal window git stashgit stash listgit stash pop -
git reset:回退到指定的版本。该命令主要有三个参数,如下图所示。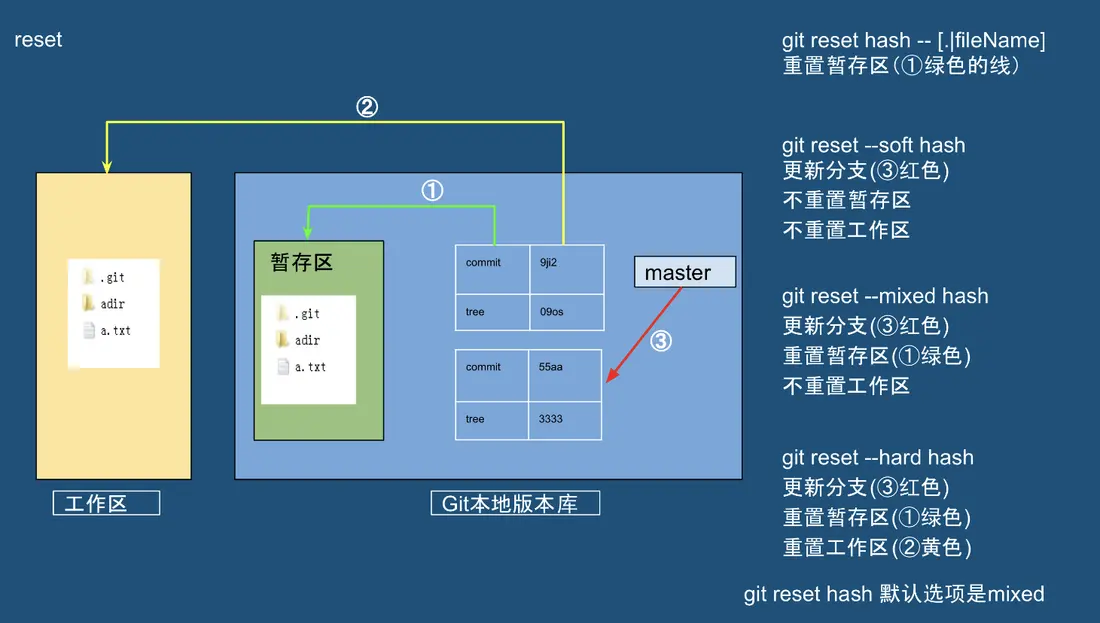
-
git cherry-pick:挑选某个分支的单次提交并作为一个新的提交引入到你当前分支上。 -
git revert:撤回提交信息。 -
git tag:经常用于查看或新增一个标签。
Git工作流程(分支管理策略)
既然Git是团队开发必备的工具,那么在团队协作时就必须有一个规范的工作流程,这样才能让团队高效的工作,让项目顺利的进展下去,否则工具再厉害但团队成员各自为战,冲突就会无处不在,协作更加无从谈起。我们仍然以刚才码云上创建的python项目为例,来说明Git的分支管理策略。
Github-flow
-
克隆服务器上的代码到本地。
Terminal window git clone git@gitee.com:jackfrued/python.git -
创建并切换到自己的分支。
Terminal window git switch -c <branch-name>或
Terminal window git checkout -b <branch-name> -
在自己的分支上开发并在本地做版本控制。
-
将自己的分支(工作成果)推到服务器。
Terminal window git push origin <branch-name> -
在线发起一次合并请求(通常称之为Pull Request,有的地方称为Merge Request),请求将自己的工作成果合并到
master分支,合并之后可以删除该分支。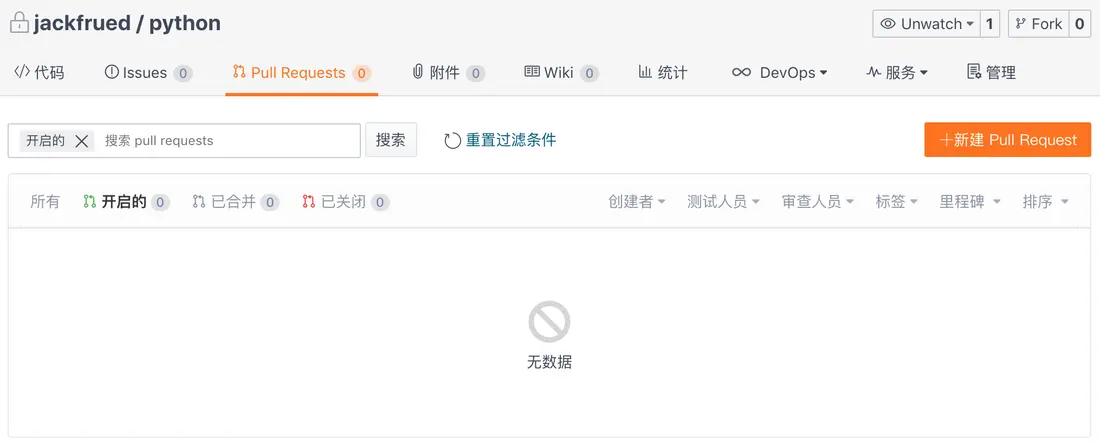
上面这种分支管理策略就是被称为github-flow或PR的流程,它非常简单容易理解,只需要注意以下几点:
master的内容都是可以进行发布的内容(不能直接在master上进行修改)。- 开发时应该以
master为基础建立新分支(日常开发任务在自己的分支上进行)。 - 分支先在本地实施版本控制,然后以同名分支定期向服务器进行push操作。
- 开发任务完成后向
master发送合并请求。 - 合并请求通过审查之后合并到
master,并从master向正式环境发布。
当然,github-flow的缺点也很明显,master分支默认就是当前的线上代码,但是有的时候工作成果合并到master分支,并不代表它就能立刻发布,这样就会导致线上版本落后于master分支。
Git-flow
除了上述的github-flow分支管理策略外,还有一种名为git-flow的分支管理策略,它也是大多数公司愿意使用的一套流程。Git-flow借鉴了中央集权型版本控制系统的长处,为团队内部统一建立、合并和关闭分支的方法,如下图所示。
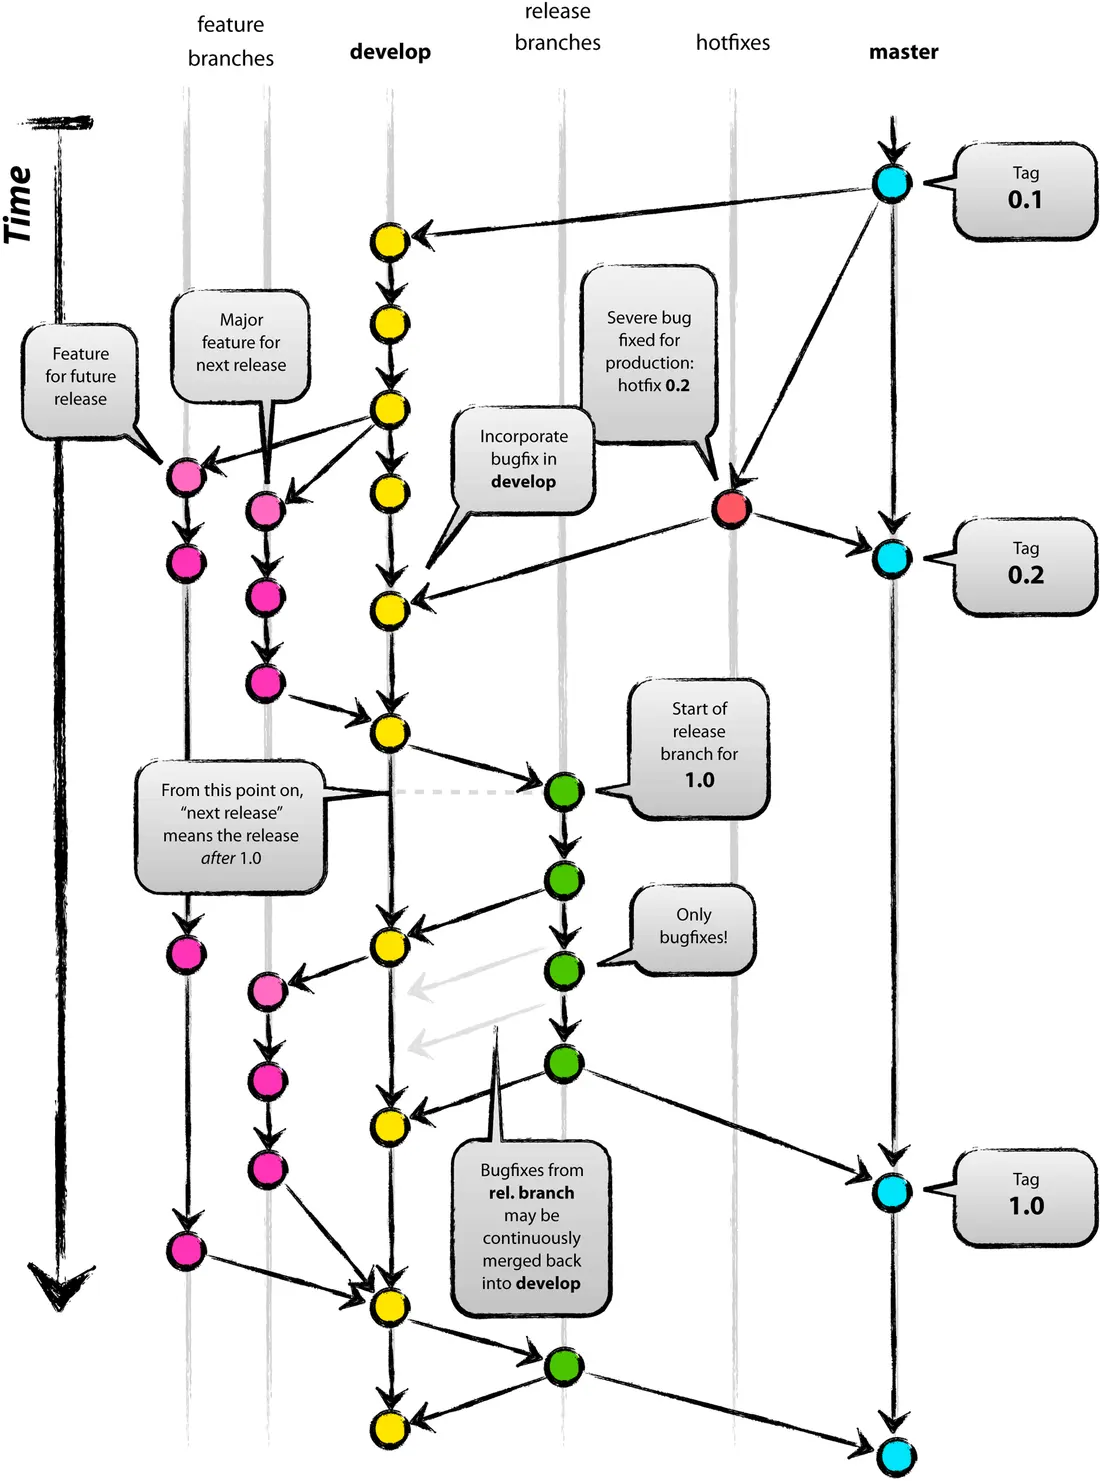
在这种模式下,项目有两个长线分支,分别是master和develop,其他都是临时的的辅助分支,包括feature(开发特定功能的分支,开发结束后合并到develop)、release(从develop分离出来的为发布做准备的分支,发布结束后合并到master和develop)和hotfix(产品发布后出现问题时紧急建立的分支,直接从master分离,问题修复后合并到master并打上标签,同时还要合并到develop来避免将来的版本遗漏了这个修复工作,如果此时有正在发布中的release分支,还要合并到release分支)。具体的实施过程如下所示:
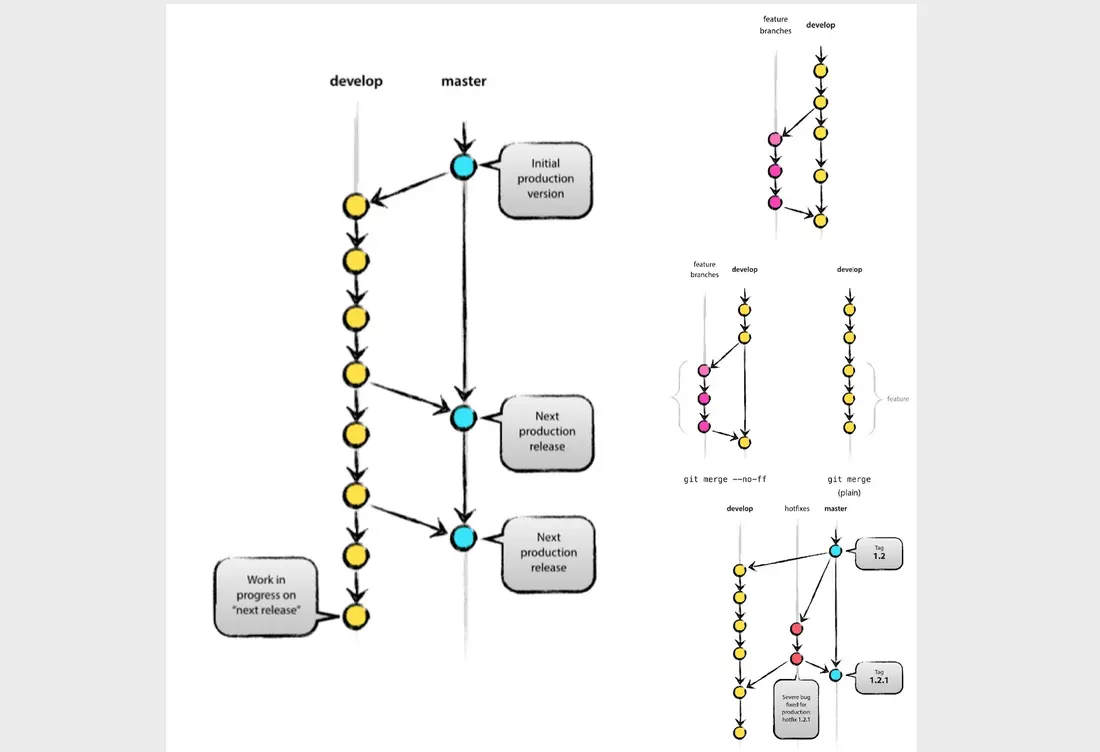
-
最开始的时候只有
master和develop分支,如上图左侧所示。 -
从
develop分支创建feature分支(上图右上),工作完成后将工作成果合并到develop分支(上图右中)。创建
feature分支:Terminal window git switch -c feature/user develop或
Terminal window git checkout -b feature/user develop接下来就是在
feature分支上进行开发并实施版本控制,这一段如何操作我们就不再赘述了。工作完成后,将feature分支合并到develop分支:Terminal window git checkout developgit merge --no-ff feature/usergit branch -d feature/usergit push origin develop -
从
develop分支创建release分支,发布结束后合并回master和develop分支。创建
release分支:Terminal window git checkout -b release-0.1 developgit push -u origin release-0.1... ... ...git pullgit commit -a -m "............"将
release分支合并回master和develop分支:Terminal window git checkout mastergit merge --no-ff release-0.1git pushgit checkout developgit merge --no-ff release-0.1git pushgit branch -d release-0.1git push --delete release-0.1git tag v0.1 mastergit push --tags -
从
master分支创建hotfix分支,在修复bug后合并到develop和master分支(上图右下)。创建
hotfix分支:Terminal window git checkout -b hotfix-0.1.1 mastergit push -u origin hotfix-0.1.1... ... ...git pullgit commit -a -m "............"将
hotfix分支合并回develop和master分支。Terminal window git checkout mastergit merge --no-ff hotfix-0.1.1git pushgit checkout developgit merge --no-ff hotfix-0.1.1git pushgit branch -d hotfix-0.1.1git push --delete hotfix-0.1.1git tag v0.1.1 mastergit push --tags
Git-flow流程比较容易控制各个分支的状况,但是在运用上github-flow要复杂得多,因此实际使用的时候通常会安装名为gitflow的命令行工具(Windows环境的Git自带了该工具)或者使用图形化的Git工具(如:SmartGit、SourceTree等)来简化操作,具体的可以参考《git-flow 的工作流程》一文,因为这篇文章写得已经很好了,本文不再进行赘述。
缺陷管理
没有好的团队管理工具必然导致项目进展不顺利,任务管理困难,而引入缺陷管理系统正好可以解决这些问题,通常一个缺陷管理系统都包含了以下的功能:
- 任务管理(包括必须做什么、谁来做、什么时候完成、现在处于什么状态等)。
- 直观而且可以检索过去发生的各种问题。
- 能够对信息进行统一的管理和共享。
- 能够生成各类报表。
- 能够关联到其他系统,具有可扩展性。
禅道
禅道是国产的专业项目管理软件,它不仅仅是缺陷管理工具,它提供了完整软件生命周期管理功能,支持Scrum敏捷开发,能够实现需求管理、缺陷管理、任务管理等一系列的功能,而且拥有强大的扩展机制和丰富的功能插件。可以从禅道的官方网站提供的下载链接来下载禅道,推荐使用一键安装包。
下面仍然以CentOS Linux为例,讲解如何利用官方提供的一键安装包来安装禅道。
cd /optwget http://dl.cnezsoft.com/zentao/pro8.5.2/ZenTaoPMS.pro8.5.2.zbox_64.tar.gzgunzip ZenTaoPMS.pro8.5.2.zbox_64.tar.gztar -xvf ZenTaoPMS.pro8.5.2.zbox_64.tar我们在/opt目录下(官方推荐使用这个目录)下载了禅道的归档压缩文件,并进行了解压缩和解归档的操作,完成上述步骤后,会看到一个名为zbox的文件夹。一键安装包中内置了Apache、MySQL、PHP等应用,也就是说这些都不需要单独安装部署了,接下来我们通过下面的命令来启动禅道。
/opt/zbox/zbox -ap 8080 -mp 3307/opt/zbox/zbox start说明:上面使用
zbox文件夹下的zbox命令,其中-ap是为了指定Apache服务器使用的端口,-mp是为了指定MySQL数据库使用的端口,这里使用3307端口是为了避开服务器上可能已经存在的MySQL服务的3306端口;start表示启动服务,stop可以用来停止服务。此外,需要打开防火墙8080端口以便访问禅道,注意数据库的端口决不能暴露给公网。
打开浏览器,输入服务器的公网IP地址就可以访问禅道,如果愿意,也可以通过DNS解析绑定一个域名来进行访问,禅道的首页如下图所示,默认的管理员是admin,口令是123456。
第一次使用禅道时,建议通过点击用户名,然后通过“帮助”菜单的“新手教程”来迅速了解禅道。官方网站的文档链接中提供了视频教程,初学者也可以通过视频教程来上手。
对敏捷开发以及敏捷闭环工具不是特别了解的,可以参考《基于JIRA的Scrum敏捷开发的项目管理》一文。
GitLab
常用的代码托管平台和之前提到的Git私服Gitlab都提供了缺陷管理的功能,当我们要报告一个bug时,可以在如下图所示的界面创建一个新的问题票(issue ticket)。填写的内容包括:
- **[必填]**出现问题的软件版本号、具体的使用环境(如操作系统)等相关信息。
- **[必填]**能够稳定重现该问题的相关步骤。
- **[必填]**描述此处期待的行为和实际的行为。
- **[可选]**你对这个bug的看法(产生bug的原因是什么)。
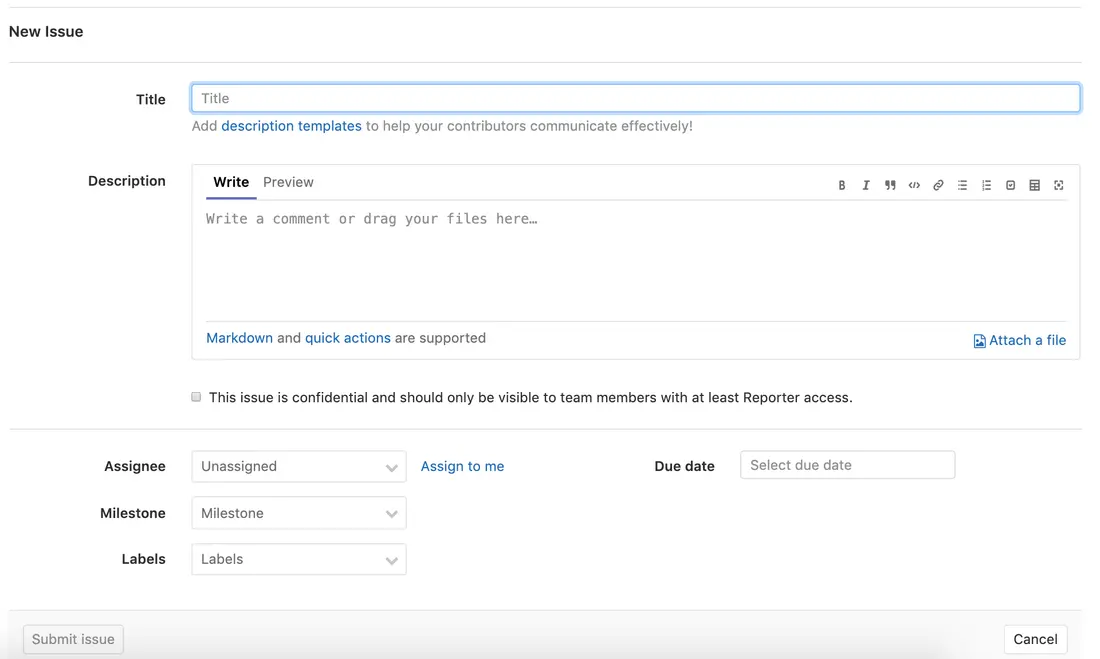
如上图所示,我们在创建问题票时,还需要将问题指派给处理问题的人,如果不清楚应该由谁来修复这个bug,就指派给项目管理者,除此之外还要指定问题的优先级(十分紧急、紧急、普通、不紧急等)、问题的标签(功能缺陷、新特性、改进增强、前瞻研究等)、里程碑(通过里程碑可以将问题与某些特定的项目节点关联起来,之后可以查看每一个里程碑的进展,可以基于软件版本号来建立里程碑,也可以基于迭代周期来建立里程碑)以及需要在哪个时间点以前修复等信息。
有些敏捷团队使用问题票来管理产品的需求,称之为“问题驱动开发”(TiDD),也就是说新功能的开发是通过创建问题票来驱动的,具体的步骤包括:建立问题票、指定责任人、开发、提交、Push到代码库。如果要创建一个和需求相关的问题票,应该要填写以下的内容:
- **[必填]**简短的描述需求,并用它作为标题。
- **[必填]**这个需求是解决什么问题的。
- **[必填]**这个需求对软件现有功能会造成什么影响。
- **[必填]**这个需求应该实现什么样的功能。
- **[必填]**这个需求是否依赖其他模块提供相关支持。
- **[可选]**这个需求有哪些实现方式。
- **[可选]**这些可选的实现方式分别有哪些优缺点。
其他产品
除了禅道和GitLab之外,JIRA、Redmine、Backlog等也是不错的缺陷管理系统。目前,这些系统大都不仅仅提供了缺陷管理的功能,更多的时候它们可以作为敏捷闭环工具来使用,关于敏捷闭环工具这个话题,请大家参考《基于JIRA的Scrum敏捷开发的项目管理》一文。
持续集成
为了快速的产出高质量的软件,在团队开发中持续集成(CI)是一个非常重要的环节。所谓CI,就是一种让计算机自动任意次重复编译、测试、汇报等工作的方法,通过CI可以帮助开发者提早发现问题,降低各种人为失误给项目带来的风险。按照经典的软件过程模型(瀑布模型),集成的工作一般要等到所有的开发工作都结束后才能开始,但这个时候如果发现了问题,修复问题的代价是非常具体的。基本上,集成实施得越晚,代码量越大,解决问题就越困难。持续集成将版本控制、自动化构建、代码测试融入到一起,让这些工作变得自动化和可协作。由于其频繁重复整个开发流程(在指定时间内多次pull源代码并运行测试代码),所以能帮助开发者提早发现问题。
在所有的CI工具中,Jenkins和TravisCI是最具有代表性的,前者是基于 Java的开源CI工具,后者是新晋的在线CI工具,下图是Jenkins的工作面板。
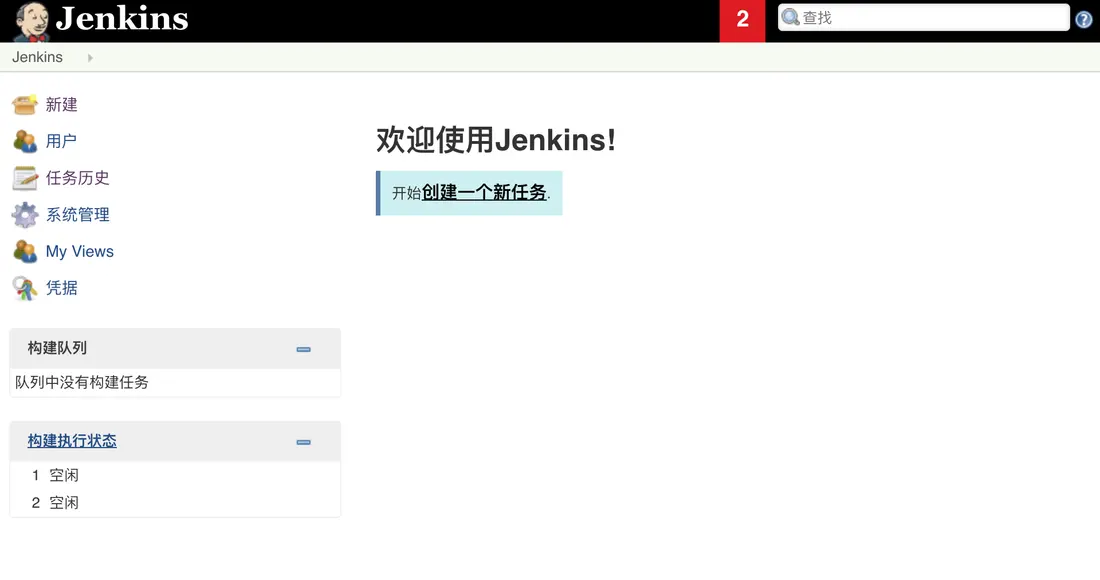
持续集成对于编译型语言的意义更大,对于Python这样的解释型语言,更多的时候是用于对接版本控制系统触发自动化测试并产生相应的报告,类似的功能也可以通过配置Webhook来完成。如果要通过Docker这样的虚拟化容器进行项目打包部署或者通过K8S进行容器管理,可以在持续集成平台安装对应的插件来支持这些功能。码云甚至可以直接对接钉钉开放平台使用钉钉机器人来向项目相关人员发送即时消息。GitLab也对CI和CD(持续交付)提供了支持,具体内容请大家参考《GitLab CI/CD基础教程》。
说明:
关于敏捷开发的相关内容,有兴趣的读者可以阅读知乎上的《这才是敏捷开发》一文。
本章中的部分插图来自于网易云课堂《人人都会用Git》课程(免费哟),在此表示感谢。
92 Docker容器技术详解
Docker是基于Go语言开发的开源应用容器引擎,遵从Apache Licence 2.0协议,可以让开发者打包应用以及应用的依赖包到一个可移植的容器中,然后发布到各种发行版本的Linux系统上。
Docker简介
软件开发中最为麻烦的事情可能就是配置环境了。由于用户使用的操作系统具有多样性,即便使用跨平台的开发语言(如Java和Python)都不能保证代码能够在各种平台下都可以正常的运转,而且在不同的环境下我们安装的软件需要依赖的软件包也是不一样的。
那么问题来了,我们安装软件的时候可不可以把软件运行的环境一并安装?我们是不是可以把原始环境一模一样地复制过来呢?
虚拟机(virtual machine)就是带环境安装的一种解决方案,它可以在一种操作系统里面运行另一种操作系统,比如在Windows系统里面运行Linux系统,在macOS上运行Windows,而应用程序对此毫无感知。使用过虚拟机的人都知道,虚拟机用起来跟真实系统一模一样,而对于虚拟机的宿主系统来说,虚拟机就是一个普通文件,不需要了就删掉,对宿主系统或者其他的程序并没有影响。但是虚拟机通常会占用较多的系统资源,启动和关闭也非常的缓慢,总之用户体验并没有想象中的那么好。
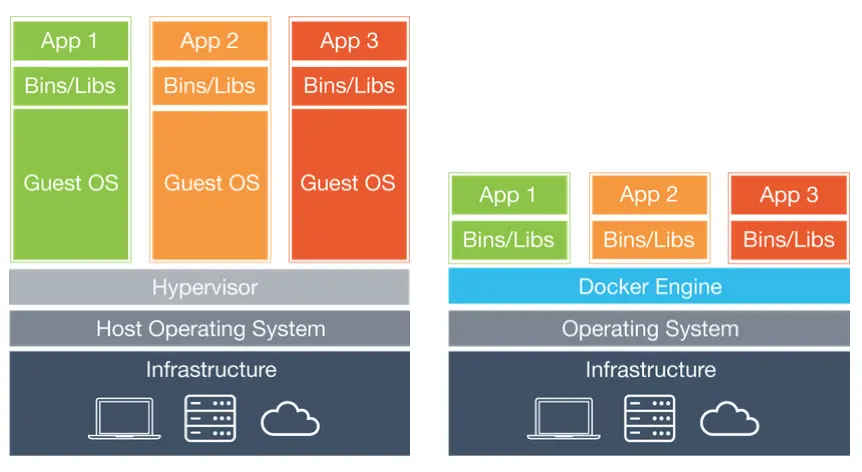
Docker属于对Linux容器技术(LXC)的一种封装(利用了Linux的namespace和cgroup技术),它提供了简单易用的容器使用接口,是目前最流行的 Linux 容器解决方案。Docker将应用程序与该程序的依赖打包在一个文件里面,运行这个文件,就会生成一个虚拟容器。程序在这个虚拟容器里运行,就好像在真实的物理机上运行一样。下图是虚拟机和容器的对比,左边是传统的虚拟机,右边是Docker。
目前,Docker主要用于几下几个方面:
- 提供一次性的环境。
- 提供弹性的云服务(利用Docker很容易实现扩容和收缩)。
- 实践微服务架构(隔离真实环境在容器中运行多个服务)。
安装Docker
下面以CentOS为例讲解如何安装Docker,使用Ubuntu、macOS或Windows的用户可以通过点击对应的链接了解这些平台下如何进行安装。
-
确定操作系统内核版本(CentOS 7要求64位,内核版本3.10+;CentOS 6要求64位,内核版本2.6+)。
Terminal window uname -r -
更新系统底层的库文件(建议一定要执行,否则在使用Docker时可能会出现莫名其妙的问题)。
Terminal window yum update -
移除可能存在的旧的Docker版本。
Terminal window yum list installed | grep dockeryum erase -y docker docker-common docker-engine -
安装yum工具包和依赖项。
Terminal window yum install -y yum-utils device-mapper-persistent-data lvm2 -
通过yum工具包添加yum源(安装Docker-ce的源)。
Terminal window yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo -
在CentOS下使用yum安装Docker-ce并启动。
Terminal window yum -y install docker-cesystemctl start docker -
查看Docker的信息和版本。
Terminal window docker versiondocker info
接下来可以通过下载镜像和创建容器来看看Docker是否可以运转起来。可以使用下面的命令从Docker的镜像仓库下载名为hello-world的镜像文件。
docker pull hello-world查看所有镜像文件。
docker imagesREPOSITORY TAG IMAGE ID CREATED SIZEdocker.io/hello-world latest fce289e99eb9 7 months ago 1.84 kB通过镜像文件创建并运行容器。
docker container run --name mycontainer hello-world说明:其中
mycontainer是我们给容器起的名字,跟在--name参数之后;hello-world就是我们刚才下载的镜像文件。
Hello from Docker!This message shows that your installation appears to be working correctly.
To generate this message, Docker took the following steps: 1. The Docker client contacted the Docker daemon. 2. The Docker daemon pulled the "hello-world" image from the Docker Hub. (amd64) 3. The Docker daemon created a new container from that image which runs the executable that produces the output you are currently reading. 4. The Docker daemon streamed that output to the Docker client, which sent it to your terminal.
To try something more ambitious, you can run an Ubuntu container with: $ docker run -it ubuntu bash
Share images, automate workflows, and more with a free Docker ID: https://hub.docker.com/
For more examples and ideas, visit: https://docs.docker.com/get-started/如果要删除这个容器,可以使用下面的命令。
docker container rm mycontainer在删除容器之后,我们还可以删除刚才下载的镜像文件。
docker rmi hello-world说明:如果要在Ubuntu(内核版本3.10+)下面安装和启动Docker,可以按照如下的步骤进行。
国内用户可以通过更换Ubuntu软件下载源来提升下载速度,具体请参照清华大学开源软件镜像站上的《Ubuntu镜像使用帮助》。
安装Docker后,由于直接访问dockerhub下载镜像会非常缓慢,建议将服务器更换为国内镜像,可以通过修改 /etc/docker/daemon.json 文件来做到。一般的云服务器会有自己专属的镜像,就不需要手动修改了。
{ "registry-mirrors": [ "http://hub-mirror.c.163.com", "https://registry.docker-cn.com" ]}使用Docker
想要玩转Docker,最简单的办法就是马上用Docker创建一些自己学习和工作中需要用到的容器,下面我们带着大家一起来创建这些容器。
运行Nginx
Nginx是高性能的Web服务器,同时也是做反向代理服务器的上佳选择。使用Docker可以非常简单的创建一个运行Nginx的容器,命令如下所示。
docker container run -d -p 80:80 --rm --name mynginx nginx说明:上面的参数
-d表示容器在后台运行(不产生输出到Shell)并显示容器的ID;-p是用来映射容器的端口到宿主机的端口,冒号前面是宿主机的端口,冒号后面是容器内部使用的端口;--rm表示容器停止后自动删除容器,例如执行命令docker container stop mynginx后,容器就不复存在了;--name后面的mynginx是自定义的容器名字;在创建容器的过程中,需要用到nginx的镜像文件,镜像文件的下载是自动完成的,如果没有指定版本号,默认是最新版本(latest)。
如果需要将自己的Web项目(页面)部署到Nginx上,可以使用容器拷贝命令将指定路径下所有的文件和文件夹拷贝到容器的指定目录中。
docker container cp /root/web/index.html mynginx:/usr/share/nginx/html如果不愿意拷贝文件也可以在创建容器时通过数据卷操作--volume将指定的文件夹映射到容器的某个目录中,例如将Web项目的文件夹直接映射到/usr/share/nginx/html目录。我们先通过下面的命令让刚才创建的容器停止运行。
docker container stop mynginx然后用下面的命令重新创建容器。
docker container run -d -p 80:80 --rm --name mynginx --volume /root/docker/nginx/html:/usr/share/nginx/html nginx说明:上面创建容器和拷贝文件的命令中,
container是可以省略的,也就是说docker container run和docker run是一样的,而docker container cp和docker cp是一样的。此外,命令中的--volume也可以缩写为-v,就如同-d是--detach的缩写,-p是--publish的缩写。$PWD代表宿主系统当前文件夹,这些对于使用过Unix或者Linux系统的人来说,应该是很容易理解的。
要查看运行中的容器,可以使用下面的命令。
docker psCONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES3c38d2476384 nginx "nginx -g 'daemon ..." 4 seconds ago Up 4 seconds 0.0.0.0:80->80/tcp mynginx要启动和停止容器,可以使用下面的命令。
docker start mynginxdocker stop mynginx由于在创建容器时使用了--rm选项,容器在停止时会被移除,当我们使用下面的命令查看所有容器时,应该已经看不到刚才的mynginx容器了。
docker container ls -a如果在创建容器时没有指定--rm选项,那么也可以使用下面的命令来删除容器。
docker rm mynginx要删除正在运行中的容器,需要使用-f选项。
docker rm -f mynginx运行MySQL
我们再来尝试用Docker安装一台MySQL服务器,首先可以先检查一下有没有MySQL的镜像文件。
docker search mysqlINDEX NAME DESCRIPTION STARS OFFICIAL AUTOMATEDdocker.io docker.io/mysql MySQL is a ... 8486 [OK]...说明:上面查询结果的列依次代表索引、镜像名、镜像描述、用户评价、是否官方镜像、自动构建。
下载MySQL镜像并指定镜像的版本号。
docker pull mysql:5.7如果需要查看已经下载的镜像文件,可以使用下面的命令。
docker imagesREPOSITORY TAG IMAGE ID CREATED SIZEdocker.io/nginx latest e445ab08b2be 2 weeks ago 126 MBdocker.io/mysql 5.7 f6509bac4980 3 weeks ago 373 MB创建并运行MySQL容器。
docker run -d -p 3306:3306 --name mysql57 -v /root/docker/mysql/conf:/etc/mysql/mysql.conf.d -v /root/docker/mysql/data:/var/lib/mysql -e MYSQL_ROOT_PASSWORD=123456 mysql:5.7注意:上面创建容器时我们又一次使用了数据卷操作,那是因为通常容器是随时创建随时删除的,而数据库中的数据却是需要保留下来的。
上面的两个数据卷操作一个是映射了MySQL配置文件所在的文件夹,一个是映射了MySQL数据所在的文件夹,这两个数据卷操作非常重要。我们可以将MySQL的配置文件放在$PWD/mysql/conf目录下,配置文件的具体内容如下所示:
[mysqld]pid-file=/var/run/mysqld/mysqld.pidsocket=/var/run/mysqld/mysqld.sockdatadir=/var/lib/mysqllog-error=/var/log/mysql/error.logserver-id=1log-bin=/var/log/mysql/mysql-bin.logexpire_logs_days=30max_binlog_size=256Msymbolic-links=0如果安装了MySQL 8.x版本(目前的最新版本),在使用客户端工具连接服务器时可能会遇到error 2059: Authentication plugin 'caching_sha2_password' cannot be loaded的问题,这是因为MySQL 8.x默认使用了名为“caching_sha2_password”的机制对用户口令进行了更好的保护,但是如果客户端工具不支持新的认证方式,连接就会失败。解决这个问题有两种方式:一是升级客户端工具来支持MySQL 8.x的认证方式;二是进入容器,修改MySQL的用户口令认证方式。下面是具体的步骤,我们先用docker exec命令进入容器的交互式环境,假设运行MySQL 8.x的容器名字叫mysql8x。
docker exec -it mysql8x /bin/bash进入容器的交互式Shell之后,可以首先利用MySQL的客户端工具连接MySQL服务器。
mysql -u root -pEnter password:Your MySQL connection id is 16Server version: 8.0.12 MySQL Community Server - GPLCopyright (c) 2000, 2018, Oracle and/or its affiliates. All rights reserved.Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.mysql>接下来通过SQL来修改用户口令就可以了。
alter user 'root'@'%' identified with mysql_native_password by '123456' password expire never;当然,如果愿意你也可以查看一下用户表检查是否修改成功。
use mysql;select user, host, plugin, authentication_string from user where user='root';+------+-----------+-----------------------+-------------------------------------------+| user | host | plugin | authentication_string |+------+-----------+-----------------------+-------------------------------------------+| root | % | mysql_native_password | *6BB4837EB74329105EE4568DDA7DC67ED2CA2AD9 || root | localhost | mysql_native_password | *6BB4837EB74329105EE4568DDA7DC67ED2CA2AD9 |+------+-----------+-----------------------+-------------------------------------------+2 rows in set (0.00 sec)在完成上面的步骤后,现在即便不更新客户端工具也可以连接MySQL 8.x了。
运行Redis
接下来我们试一试运行多个容器并让多个容器之间通过网络通信。我们创建4个Redis容器来实现一主三从的主从复制结构。
docker run -d -p 6379:6379 --name redis-master redisdocker run -d -p 6380:6379 --name redis-slave-1 --link redis-master:redis-master redis redis-server --replicaof redis-master 6379docker run -d -p 6381:6379 --name redis-slave-2 --link redis-master:redis-master redis redis-server --replicaof redis-master 6379docker run -d -p 6382:6379 --name redis-slave-3 --link redis-master:redis-master redis redis-server --replicaof redis-master 6379上面的命令中,--link参数用于给容器创建网络别名,因为三台从机(slave)需要通过网络连接自己的主机(master)。虽然,我们可以通过docker inspect --format '{{ .NetworkSettings.IPAddress }}' <container-ID>命令来查看到容器的IP地址,但是由于容器的即装即用性,容器的IP地址有可能会发生变化,如果直接使用IP地址,在容器重启后就可能会因为IP地址的变化导致从机无法连接到主机。使用--link参数创建网络别名就是为了在启动Redis服务器时在redis-server后面的--replicaof参数后使用这个别名而不是IP地址。
接下来我们进入名为redis-master的容器,看看主从复制的配置是否成功。
docker exec -it redis-master /bin/bash通过redis-cli启动命令行工具。
redis-cli127.0.0.1:6379> info replication# Replicationrole:masterconnected_slaves:3slave0:ip=172.17.0.4,port=6379,state=online,offset=1988,lag=0slave1:ip=172.17.0.5,port=6379,state=online,offset=1988,lag=1slave2:ip=172.17.0.6,port=6379,state=online,offset=1988,lag=1master_replid:94703cfa03c3ddc7decc74ca5b8dd13cb8b113eamaster_replid2:0000000000000000000000000000000000000000master_repl_offset:1988second_repl_offset:-1repl_backlog_active:1repl_backlog_size:1048576repl_backlog_first_byte_offset:1repl_backlog_histlen:1988运行GitLab
GitLab是由GitLab Inc.开发的Git仓库管理工具,具有wiki、问题跟踪、持续集成等一系列的功能,分为社区版和企业版。通过Docker提供的虚拟化容器,我们可以安装社区版的Docker。因为GitLab需要使用SSH协议进行安全连接,我们要暴露容器的22端口,所以可以先将宿主机SSH连接的22端口修改为其他端口(如:12345),然后再进行后续的操作。
vim /etc/ssh/sshd_config将其中定义端口的那行代码去掉注释并将端口修改为12345。
Port 12345重新启动sshd服务。
systemctl restart sshd提示:修改端口后应该确保防火墙上也开启对应的端口,否则无法使用SSH连接到Linux服务器。
创建需要用于数据卷映射操作的文件夹。
mkdir -p /root/gitlab/{config,logs,data}基于gitlab/gitlab-ce镜像创建容器,并暴露80端口(HTTP连接)和22端口(SSH连接)。
docker run -d -p 80:80 -p 22:22 --name gitlab -v /root/gitlab/config:/etc/gitlab -v /root/gitlab/logs:/var/log/gitlab -v /root/gitlab/data:/var/opt/gitlab gitlab/gitlab-ce说明:GitLab的启动比较缓慢,创建好容器后可能需要等待一段时间才能通过浏览器来进行访问。
首次进入GitLab访问界面会提示我们修改管理员密码,设置好管理员密码后就可以在登录界面输入用户名root和刚才设置的密码登录到管理员控制台,在使用上还是非常简单和人性化的。
构建镜像
通过上面的讲解,我们已经掌握了如何通过官方提供的镜像来创建容器。当然如果愿意,我们也可以用配置好的容器来生成镜像。简而言之,Docker镜像是由文件系统叠加而成的,系统的最底层是bootfs,相当于就是Linux内核的引导文件系统;接下来第二层是rootfs,这一层可以是一种或多种操作系统(如Debian或Ubuntu文件系统),Docker中的rootfs是只读状态的;Docker利用联合挂载技术将各层文件系统叠加到一起,最终的文件系统会包含有底层的文件和目录,这样的文件系统就是一个镜像。
之前我们讲过了如何查找、列出镜像和拉取(下载)镜像,接下来看看构建镜像的两种方式:
- 使用
docker commit命令。(不推荐) - 使用
docker build命令和Dockerfile文件。
使用commit命令构建镜像
为了演示如何构建镜像,我们先使用Ubuntu镜像来定制一个容器,命令如下所示。
docker run --name myubuntu -it ubuntu /bin/bash在容器中执行下面的命令来安装Apache服务器并退出容器。
apt -y upgradeapt -y install apache2exit我们将这个容器作为一个定制的Web服务器保存起来,当需要这样一台Web服务器的时候,就没有必要重新创建容器并安装Apache了。
首先我们通过下面的命令查看容器的ID。
docker container ls -adocker container ls -aCONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES014bdb321612 ubuntu "/bin/bash" 5 minutes ago Exited (0) myubuntu提交定制的容器。
docker commit 014bdb321612 jackfrued/mywebserver查看镜像文件。
docker imagesREPOSITORY TAG IMAGE ID CREATED SIZEjackfrued/mywebserver latest 795b294d265a 14 seconds ago 189 MB生成镜像文件以后,后面就可以利用刚才创建的镜像文件来创建新的容器。
使用Dockerfile构建镜像
Dockerfile使用DSL(Domain Specific Language)来构建一个Docker镜像,只要编辑好了Dockerfile文件,就可以使用docker build命令来构建一个新的镜像。
我们先创建一个名为myapp的文件夹来保存项目代码和Dockerfile的文件,如下所示:
[ECS-root temp]# tree myappmyapp├── api│ ├── app.py│ ├── requirements.txt│ └── start.sh└── Dockerfile其中api是Flask项目的文件夹,其中包括了项目代码、依赖项以及启动脚本等文件,具体内容如下所示:
app.py文件:
from flask import Flaskfrom flask_restful import Resource, Apifrom flask_cors import CORS
app = Flask(__name__)CORS(app, resources={r'/api/*': {'origins': '*'}})api = Api(app)
class Product(Resource):
def get(self): products = ['Ice Cream', 'Chocolate', 'Coca Cola', 'Hamburger'] return {'products': products}
api.add_resource(Product, '/api/products')requirements.txt文件:
flaskflask-restfulflask-corsgunicornstart.sh文件:
#!/bin/bashexec gunicorn -w 4 -b 0.0.0.0:8000 app:app提示:需要给start.sh文件以执行权限,可以使用
chmod 755 start.sh命令来做到。
Dockerfile文件:
# 指定基础镜像FROM python:3.7# 指定镜像的维护者MAINTAINER jackfrued "jackfrued@126.com"# 将指定文件添加到容器中指定的位置ADD api/* /root/api/# 设置工作目录WORKDIR /root/api# 执行命令(安装Flask项目的依赖项)RUN pip install -r requirements.txt -i https://pypi.doubanio.com/simple/# 容器启动时要执行的命令ENTRYPOINT ["./start.sh"]# 暴露端口EXPOSE 8000我们来解释一下上面的Dockerfile文件。Dockerfile文件通过特殊的指令来指定基础镜像(FROM指令)、创建容器后需要指定的命令(RUN指令)以及需要暴露的端口(EXPOSE)等信息。我们稍后会专门为大家介绍这些Dockfile中的指令。
接下来我们可以使用docker build命令来创建镜像,如下所示。
docker build -t "jackfrued/myapp" .提示:上面的命令最后面的
.千万不要漏掉了哦,它表示从当前路径下寻找Dockerfile。
通过下面的命令可以查看创建好的镜像。
docker imagesREPOSITORY TAG IMAGE ID CREATED SIZEjackfrued/myapp latest 6d6f026a7896 5 seconds ago 930 MB如果想知道镜像文件是如何创建出来的,可以使用下面的命令。
docker history jackfrued/myappIMAGE CREATED CREATED BY SIZE COMMENT6d6f026a7896 31 seconds ago /bin/sh -c #(nop) EXPOSE 8000/tcp 0 B3f7739173a79 31 seconds ago /bin/sh -c #(nop) ENTRYPOINT ["./start.sh"] 0 B321e6bf09bf1 32 seconds ago /bin/sh -c pip install -r requirements.txt... 13 MB2f9bf2c89ac7 37 seconds ago /bin/sh -c #(nop) WORKDIR /root/api 0 B86119afbe1f8 37 seconds ago /bin/sh -c #(nop) ADD multi:4b76f9c9dfaee8... 870 B08d465e90d4d 3 hours ago /bin/sh -c #(nop) MAINTAINER jackfrued "j... 0 Bfbf9f709ca9f 12 days ago /bin/sh -c #(nop) CMD ["python3"] 0 B使用该镜像来创建容器运行Web服务器。
docker run -d -p 8000:8000 --name myapp jackfrued/myapp如果希望将上面创建的镜像文件放到dockerhub仓库中,可以按照如下所示的步骤进行操作。
通过下面的命令登录到dockerhub。
docker login输入用户名和口令进行登录。
Login with your Docker ID to push and pull images from Docker Hub. If you don't have a Docker ID, head over to https://hub.docker.com to create one.Username: jackfruedPassword:Login Succeeded通过下面的命令将镜像推到仓库中。
docker push jackfrued/webserver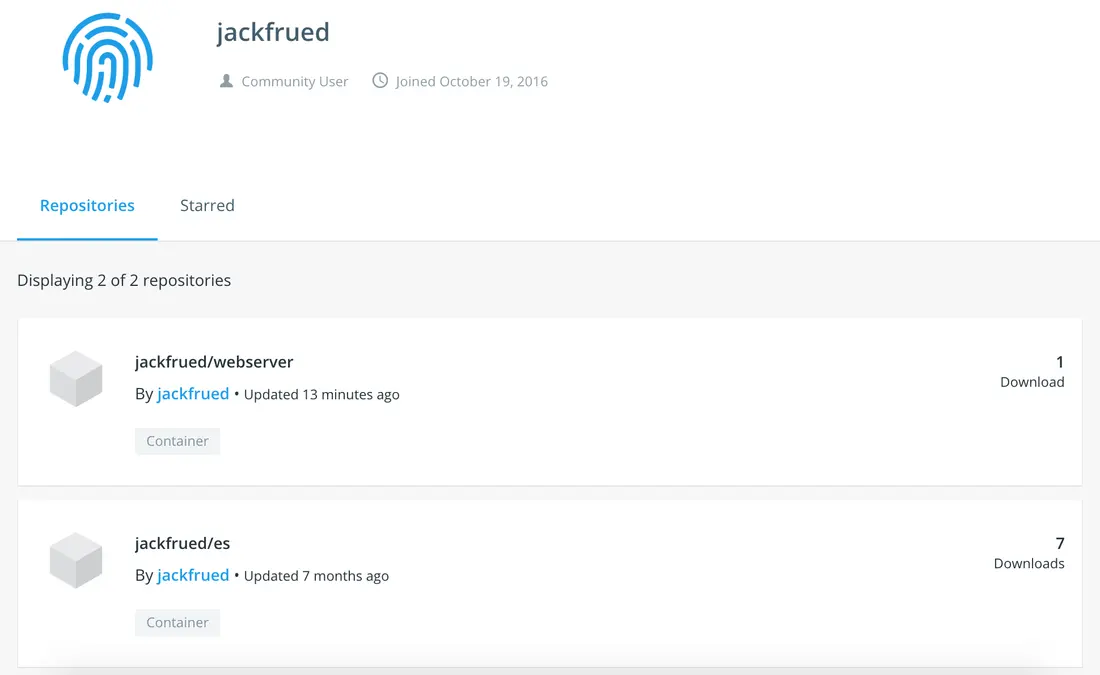
Dockerfile指令
想了解Dockerfile的指令可以查看官方提供的参考手册,下面我们为大家介绍一些常用的指令。
-
FROM:设置基础镜像,必须是Dockerfile中的第一条指令。
FROM <镜像名> [AS <别名>]或
FROM <镜像名>[:<标签>] [AS <别名>] -
RUN:指定构建镜像时要执行的命令。
RUN <命令> [参数1], [参数2], ...或
RUN ["可执行文件", "参数1", "参数2", ...] -
CMD:指定构建镜像后要执行的命令。
CMD <命令> [参数1], [参数2], ...或
CMD ["可执行文件", "参数1", "参数2", ...]说明:Docker不同于虚拟机,容器本身就是一个进程,容器中的应用应该位于前台运行。CMD命令相当于就是用来指定容器主进程(创建容器后要在前台执行的程序)的,如果主进程结束了,容器也就停止运行了。所以在容器中启动Nginx不能使用
service nginx start或是systemctl start nginx而是要通过CMD ["nginx", "-g", "daemon off;"]让它在前台运行。 -
ENTRYPOINT:和CMD类似,也可以执行命令,但
docker run命令行中指定的任何参数都会被当做参数再次传给ENTRYPOINT指令中的命令,这就使得我们可以构建一个镜像,它既可以运行一个默认的命令,也支持通过docker run命令行为该命令指定可覆盖的参数选项。ENTRYPOINT <命令> [参数1], [参数2], ...或
ENTRYPOINT ["可执行文件", "参数1", "参数2", ...] -
WORKDIR:在通过镜像创建新容器时,在容器内部创建一个工作目录,ENTRYPOINT和CMD指定的程序会在这个目录下执行。在使用
docker run命令时可以通过-w参数来覆盖由WORKDIR指定的工作目录。例如:WORKDIR /opt/webappTerminal window docker run -w /usr/share/webapp ... -
ENV:在创建镜像时设置环境变量。在使用
docker run命令时,可以通过-e参数来修改环境变量的设置。例如:ENV DEFAULT_PORT=8080Terminal window docker run -e "DEFAULT_PORT=8000" ... -
USER:指定镜像会以什么用户身份去运行。例如:
USER nginx -
VOLUME:在创建容器时添加一个数据卷的挂载点。通过数据卷操作可以实现容器间数据的共享和重用,对卷所作的修改可以马上生效而不需要重新启动容器,我们之前创建容器时使用
--volume参数就是为了实现数据卷的映射操作。VOLUME ["/路径1", "/路径2/子路径2.1/", ...] -
ADD:将构建目录下的文件和文件夹复制到镜像中,如果是压缩文件和归档文件,ADD命令会对这些文件进行解压缩解归档的操作。
ADD [--chown=<用户>:<用户组>] <源文件> <目标文件> -
COPY:非常类似于ADD,但不会主动对文件进行提取操作。
-
LABEL:为Docker镜像添加一些元数据,在使用
docker inspect命令时会看到这些元数据。LABEL version="1.0.0" location="Chengdu" -
ONBUILD:为镜像添加触发器,当一个镜像被用作其他镜像的基础镜像,触发器将会被执行。例如:
ONBUILD ADD . /app/srcONBUILD RUN cd /app/src && make
多容器管理
我们的项目可能会使用了多个容器,容器多了之后管理容器的工作就会变得麻烦。如果要对多个容器进行自动配置使得容器可以相互协作甚至实现复杂的调度,这就需要进行容器编排。Docker原生对容器编排的支持非常弱,但是可以通过社区提供的工具来实现容器编排。
Docker Compose
可以通过安装Docker Compose工具来实现基于YAML文件的容器编排,YAML文件会定义一系列的容器以及容器运行时的属性,Docker Compose会根据这些配置来管理容器。
-
安装Docker Compose。
Terminal window curl -L "https://github.com/docker/compose/releases/download/1.25.4/docker-compose-$(uname -s)-$(uname -m)" -o /usr/local/bin/docker-composechmod +x /usr/local/bin/docker-compose说明:如果没有curl工具,在CentOS下可以先通过包管理工具yum安装curl再执行上面的命令。
当然我们也可以使用Python的包管理工具pip来安装Docker Compose,命令如下所示。
Terminal window pip3 install -U docker-compose -
使用Docker Compose。
我们在刚才的Flask项目中引入缓存,然后再利用Flask提供的数据接口为前端页面提供数据,使用Vue.js进行页面渲染并将静态页面部署在Nginx服务器上。项目文件夹结构如下所示:
Terminal window [ECS-root ~]# tree temptemp├── docker-compose.yml├── html│ └── index.html└── myapp├── api│ ├── app.py│ ├── requirements.txt│ └── start.sh└── Dockerfile修改后的app.py文件代码如下所示:
from pickle import dumps, loadsfrom flask import Flaskfrom flask_restful import Resource, Apifrom flask_cors import CORSfrom redis import Redisapp = Flask(__name__)CORS(app, resources={r'/api/*': {'origins': '*'}})api = Api(app)redis = Redis(host='redis-master', port=6379)class Product(Resource):def get(self):data = redis.get('products')if data:products = loads(data)else:products = ['Ice Cream', 'Chocolate', 'Coca Cola', 'Hamburger']redis.set('products', dumps(products))return {'products': products}api.add_resource(Product, '/api/products')html文件夹用来保存静态页面,稍后我们会通一个运行Nginx的容器来向浏览器提供静态页面。index.html文件的内容如下所示:
<!DOCTYPE html><html lang="en"><head><meta charset="utf-8"><title>首页</title></head><body><div id="app"><h2>产品列表</h2><ul><li v-for="product in products">{{ product }}</li></ul></div><script src="https://cdn.bootcss.com/vue/2.6.10/vue.min.js"></script><script>new Vue({el: '#app',data: {products: []},created() {fetch('http://1.2.3.4:8000/api/products').then(resp => resp.json()).then(json => {this.products = json.products})}})</script></body></html>接下来,我们要通过docker-compose.yml文件来创建三个容器并指明容器之间的依赖关系。
version: '3'services:api-server:build: ./myappports:- '8000:8000'links:- redis-masterweb-server:image: nginxports:- '80:80'volumes:- ./html:/usr/share/nginx/htmlredis-master:image: redisexpose:- '6379'有了这个YAML文件,我们就可以使用
docker-compose命令来创建容器运行项目,其命令如下所示:Terminal window [ECS-root temp]# docker-compose upCreating network "temp_default" with the default driverCreating temp_web-server_1 ... doneCreating temp_redis-master_1 ... doneCreating temp_api-server_1 ... doneAttaching to temp_redis-master_1, temp_web-server_1, temp_api-server_1redis-master_1 | 1:C 05 Dec 2019 11:57:26.828 # oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Ooredis-master_1 | 1:C 05 Dec 2019 11:57:26.828 # Redis version=5.0.6, bits=64, commit=00000000, modified=0, pid=1, just startedredis-master_1 | 1:C 05 Dec 2019 11:57:26.828 # Warning: no config file specified, using the default config. In order to specify a config file use redis-server /path/to/redis.confredis-master_1 | 1:M 05 Dec 2019 11:57:26.830 * Running mode=standalone, port=6379.redis-master_1 | 1:M 05 Dec 2019 11:57:26.831 # WARNING: The TCP backlog setting of 511 cannot be enforced because /proc/sys/net/core/somaxconn is set to the lower value of 128.redis-master_1 | 1:M 05 Dec 2019 11:57:26.831 # Server initializedredis-master_1 | 1:M 05 Dec 2019 11:57:26.831 # WARNING overcommit_memory is set to 0! Background save may fail under low memory condition. To fix this issue add 'vm.overcommit_memory = 1' to /etc/sysctl.conf and then reboot or run the command 'sysctl vm.overcommit_memory=1' for this to take effect.redis-master_1 | 1:M 05 Dec 2019 11:57:26.831 # WARNING you have Transparent Huge Pages (THP) support enabled in your kernel. This will create latency and memory usage issues with Redis. To fix this issue run the command 'echo never > /sys/kernel/mm/transparent_hugepage/enabled' as root, and add it to your /etc/rc.local in order to retain the setting after a reboot. Redis must be restarted after THP is disabled.redis-master_1 | 1:M 05 Dec 2019 11:57:26.831 * Ready to accept connectionsapi-server_1 | [2019-12-05 11:57:27 +0000] [1] [INFO] Starting gunicorn 20.0.4api-server_1 | [2019-12-05 11:57:27 +0000] [1] [INFO] Listening at: http://0.0.0.0:8000 (1)api-server_1 | [2019-12-05 11:57:27 +0000] [1] [INFO] Using worker: syncapi-server_1 | [2019-12-05 11:57:27 +0000] [8] [INFO] Booting worker with pid: 8api-server_1 | [2019-12-05 11:57:27 +0000] [9] [INFO] Booting worker with pid: 9api-server_1 | [2019-12-05 11:57:27 +0000] [10] [INFO] Booting worker with pid: 10api-server_1 | [2019-12-05 11:57:27 +0000] [11] [INFO] Booting worker with pid: 11要停止容器的运行,可以使用下面的命令。
Terminal window docker-compose down
Kubernetes(K8S)
实际的生产环境中常常需要部署和管理多个协同工作的容器,docker compose解决了多容器创建和管理的问题,但是实际项目中,我们还需要Kubernetes(以下都简称为K8S)来提供一个跨主机集群的容器调度平台。K8S可以进行自动化容器的部署、扩展和操作,从而提供以容器为中心的基础架构。该项目是谷歌在2014年启动的项目,建立在谷歌公司十余年运维经验的基础之上,而且谷歌自己的应用也是运行在容器上的。
93 MySQL性能优化
基本原则
想要发挥 MySQL 的最佳性能,需要遵循 3 个基本使用原则。
- 让MySQL回归存储的基本职能:MySQL 数据库只用于数据的存储,不进行数据的复杂计算,不承载业务逻辑,确保存储和计算分离;
- 查询数据时,尽量单表查询,减少跨库查询和多表关联;
- 杜绝大事务、大 SQL、大批量、大字段等一系列性能杀手。
- 大事务:运行步骤较多,涉及的表和字段较多,容易造成资源的争抢,甚至形成死锁。一旦事务回滚,会导致资源占用时间过长。
- 大 SQL:复杂的SQL意味着过多的表的关联,MySQL 数据库处理关联超过3张表以上的SQL时,占用资源多,性能低下。
- 大批量:多条SQL一次性执行完成,可以减少一条条执行SQL产生的额外开销,但必须确保进行充分的测试,并且在业务低峰时段或者非业务时段执行。
- 大字段:blob、text类型的大字段要尽量少用,必须要用时,尽量与主业务表分离,减少对这类字段的检索和更新。
建库建表
- 必须指定默认存储引擎为 InnoDB,并且禁用 MyISAM 存储引擎,随着 MySQL 8.0 版本的发布,所有的数据字典表都已经转换成了 InnoDB,MyISAM 存储引擎已成为了历史。
- 默认字符集 UTF8mb4,以前版本的 UTF8 是 UTF8mb3,未包含个别特殊字符,新版本的 UTF8mb4 包含所有字符,官方强烈建议使用此字符集。
- 关闭区分大小写功能。设置参数
lower_case_table_names的值为1,即可关闭区分大小写功能,即大写字母 T 和小写字母 t 一样。 - 存储过程、触发器、视图、event等功能尽量在程序中实现,一方面是为了存储和计算分离,另一方面是因为这些功能非常不完整,调试、排错、监控都非常困难,相关数据字典也不完善,存在潜在的风险。一般在生产数据库中,禁止使用。
- 单个数据库实例表数量控制在2000个以内。
InnoDB表的注意事项
- 主键列使用
unsigned整数,可以使用auto_increment,但是要禁止手动更新主键。 - 每个列都必须添加
comment注释。 - 在建表时必须显示指定
engine。 - 表必备三字段:
xxx_id、xxx_create、xxx_modified。其中xxx_id为主键,类型unsigned整数类型(例如:int unsigned);xxx_create、xxx_modified的类型均为datetime类型,分别记录该条数据的创建时间、修改时间。 - 所有字段必须指定
not null,为空值指定default值,因为MySQL难以优化null值,含null值的复合索引会失效,最终导致查询效率低。 - 单张表的字段数尽量空值在50个字段以内,如果字段过多可以考虑垂直拆分。
- 禁用
enum和set类型,因为这样的类型兼容性不好且性能较差。 - 大文件不应该使用
blob类型而是保存它们的路径,blob和text这样的类型会导致处理性能下降,全表扫描代价大大增加。 - 对货币等对精度敏感的数据,应该使用定点数(
decimal)而不是浮点数(float)。 - 保存IP地址不要用
char(15),应该使用int unsigned,可以使用inet_aton和inet_ntoa函数实现整数和IP地址的转换。
使用索引
在前面《关系型数据库MySQL》一文中,我们已经讲到过索引的相关知识,这里我们做一个简单的回顾。
索引的设计原则
- 创建索引的列并不一定是
select操作中要查询的列,最适合做索引的列是出现在where子句中经常用作筛选条件或连表子句中作为表连接条件的列。 - 具有唯一性的列,索引效果好;重复值较多的列,索引效果差。
- 如果为字符串类型创建索引,最好指定一个前缀长度,创建短索引。短索引可以减少磁盘I/O而且在做比较时性能也更好,更重要的是MySQL底层的高速索引缓存能够缓存更多的键值。
- 创建一个包含N列的复合索引(多列索引)时,相当于是创建了N个索引,此时应该利用最左前缀进行匹配。
- 不要过度使用索引。索引并不是越多越好,索引需要占用额外的存储空间而且会影响写操作的性能(插入、删除、更新数据时索引也需要更新)。MySQL在生成执行计划时,要考虑各个索引的使用,这个也是需要耗费时间的。
- 要注意可能使索引失效的场景,例如:模糊查询使用了前置通配符、使用负向条件进行查询等。
使用过程
过程,通常也称之为存储过程,它是事先编译好存储在数据库中的一组SQL的集合。调用存储过程可以简化应用程序开发人员的工作,减少与数据库服务器之间的通信,对于提升数据操作的性能是有帮助的,这些我们在之前的《关系型数据库MySQL》一文中已经提到过。
数据分区
MySQL支持做数据分区,通过分区可以存储更多的数据、优化查询,获得更大的吞吐量并快速删除过期的数据。关于这个知识点建议大家看看MySQL的官方文档。数据分区有以下几种类型:
-
RANGE分区:基于连续区间范围,把数据分配到不同的分区。
CREATE TABLE tb_emp (eno INT NOT NULL,ename VARCHAR(20) NOT NULL,job VARCHAR(10) NOT NULL,hiredate DATE NOT NULL,dno INT NOT NULL)PARTITION BY RANGE( YEAR(hiredate) ) (PARTITION p0 VALUES LESS THAN (1960),PARTITION p1 VALUES LESS THAN (1970),PARTITION p2 VALUES LESS THAN (1980),PARTITION p3 VALUES LESS THAN (1990),PARTITION p4 VALUES LESS THAN MAXVALUE); -
LIST分区:基于枚举值的范围,把数据分配到不同的分区。
-
HASH分区 / KEY分区:基于分区个数,把数据分配到不同的分区。
CREATE TABLE tb_emp (eno INT NOT NULL,ename VARCHAR(20) NOT NULL,job VARCHAR(10) NOT NULL,hiredate DATE NOT NULL,dno INT NOT NULL)PARTITION BY HASH(dno)PARTITIONS 4;
SQL优化
-
定位低效率的SQL语句 - 慢查询日志。
-
查看慢查询日志相关配置
mysql> show variables like 'slow_query%';+---------------------------+----------------------------------+| Variable_name | Value |+---------------------------+----------------------------------+| slow_query_log | OFF || slow_query_log_file | /mysql/data/localhost-slow.log |+---------------------------+----------------------------------+mysql> show variables like 'long_query_time';+-----------------+-----------+| Variable_name | Value |+-----------------+-----------+| long_query_time | 10.000000 |+-----------------+-----------+ -
创建慢查询日志文件并修改所有者。
Terminal window touch /var/log/mysqld-slow.logchown mysql /var/log/mysqld-slow.log -
修改全局慢查询日志配置。
mysql> set global slow_query_log_file='/var/log/mysqld-slow.log'mysql> set global slow_query_log='ON';mysql> set global long_query_time=1; -
或者直接修改MySQL配置文件启用慢查询日志。
[mysqld]slow_query_log=ONslow_query_log_file=/var/log/mysqld-slow.loglong_query_time=1
注意:修改了配置文件需要重启MySQL,CentOS上对应的命令是
systemctl restart mysqld。 -
-
通过
explain了解SQL的执行计划。例如:explain select ename, job, sal from tb_emp where dno=20\G*************************** 1. row ***************************id: 1select_type: SIMPLEtable: tb_emptype: refpossible_keys: fk_emp_dnokey: fk_emp_dnokey_len: 5ref: constrows: 7Extra: NULL1 row in set (0.00 sec)select_type:查询类型(SIMPLE - 简单查询、PRIMARY - 主查询、UNION - 并集、SUBQUERY - 子查询)。table:输出结果集的表。type:访问类型(ALL - 全表查询性能最差、index、range、ref、eq_ref、const、NULL)。possible_keys:查询时可能用到的索引。key:实际使用的索引。key_len:索引字段的长度。rows:扫描的行数,行数越少肯定性能越好。extra:额外信息。
-
通过
show profiles和show profile for query分析SQL。MySQL从5.0.37开始支持剖面系统来帮助用户了解SQL执行性能的细节,可以通过下面的方式来查看MySQL是否支持和开启了剖面系统。
select @@have_profiling;select @@profiling;如果没有开启剖面系统,可以通过下面的SQL来打开它。
set profiling=1;接下来就可以通过剖面系统来了解SQL的执行性能,例如:
mysql> select count(*) from tb_emp;+----------+| count(*) |+----------+| 14 |+----------+1 row in set (0.00 sec)mysql> show profiles;+----------+------------+-----------------------------+| Query_ID | Duration | Query |+----------+------------+-----------------------------+| 1 | 0.00029600 | select count(*) from tb_emp |+----------+------------+-----------------------------+1 row in set, 1 warning (0.00 sec)mysql> show profile for query 1;+----------------------+----------+| Status | Duration |+----------------------+----------+| starting | 0.000076 || checking permissions | 0.000007 || Opening tables | 0.000016 || init | 0.000013 || System lock | 0.000007 || optimizing | 0.000005 || statistics | 0.000012 || preparing | 0.000010 || executing | 0.000003 || Sending data | 0.000070 || end | 0.000012 || query end | 0.000008 || closing tables | 0.000012 || freeing items | 0.000032 || cleaning up | 0.000013 |+----------------------+----------+15 rows in set, 1 warning (0.00 sec) -
优化CRUD操作。
-
优化
insert语句- 在
insert语句后面跟上多组值进行插入在性能上优于分开insert。 - 如果有多个连接向同一个表插入数据,使用
insert delayed可以获得更好的性能。 - 如果要从一个文本文件装载数据到表时,使用
load data infile比insert性能好得多。
- 在
-
优化
order by语句- 如果
where子句的条件和order by子句的条件相同,而且排序的顺序与索引的顺序相同,如果还同时满足排序字段都是升序或者降序,那么只靠索引就能完成排序。
- 如果
-
优化
group by语句- 在使用
group by子句分组时,如果希望避免排序带来的开销,可以用order by null禁用排序。
- 在使用
-
优化嵌套查询
- MySQL从4.1开始支持嵌套查询(子查询),这使得可以将一个查询的结果当做另一个查询的一部分来使用。在某些情况下,子查询可以被更有效率的连接查询取代,因为在连接查询时MySQL不需要在内存中创建临时表来完成这个逻辑上需要多个步骤才能完成的查询。
-
优化or条件
- 如果条件之间是
or关系,则只有在所有条件都用到索引的情况下索引才会生效。
- 如果条件之间是
-
优化分页查询
-
分页查询时,一个比较头疼的事情是如同
limit 1000, 20,此时MySQL已经排序出前1020条记录但是仅仅返回第1001到1020条记录,前1000条实际都用不上,查询和排序的代价非常高。一种常见的优化思路是在索引上完成排序和分页的操作,然后根据返回的结果做表连接操作来得到最终的结果,这样可以避免出现全表查询,也避免了外部排序。select * from tb_emp order by ename limit 10000, 20;select * from tb_emp t1 inner join (select eno from tb_emp order by ename limit 10000, 20) t2 on t1.eno=t2.eno;上面的代码中,第2行SQL是优于第1行SQL的,当然我们的前提是已经在
ename字段上创建了索引。
-
-
使用SQL提示
- USE INDEX:建议MySQL使用指定的索引。
- IGNORE INDEX:建议MySQL忽略掉指定的索引。
- FORCE INDEX:强制MySQL使用指定的索引。
-
配置优化
可以使用下面的命令来查看MySQL服务器配置参数的默认值。
show variables;show variables like 'key_%';show variables like '%cache%';show variables like 'innodb_buffer_pool_size';通过下面的命令可以了解MySQL服务器运行状态值。
show status;show status like 'com_%';show status like 'innodb_%';show status like 'connections';show status like 'slow_queries';- 调整
max_connections:MySQL最大连接数量,默认151。在Linux系统上,如果内存足够且不考虑用户等待响应时间这些问题,MySQL理论上可以支持到万级连接,但是通常情况下,这个值建议控制在1000以内。 - 调整
back_log:TCP连接的积压请求队列大小,通常是max_connections的五分之一,最大不能超过900。 - 调整
table_open_cache:这个值应该设置为max_connections的N倍,其中N代表每个连接在查询时打开的表的最大个数。 - 调整
innodb_lock_wait_timeout:该参数可以控制InnoDB事务等待行锁的时间,默认值是50ms,对于反馈响应要求较高的应用,可以将这个值调小避免事务长时间挂起;对于后台任务,可以将这个值调大来避免发生大的回滚操作。 - 调整
innodb_buffer_pool_size:InnoDB数据和索引的内存缓冲区大小,以字节为单位,这个值设置得越高,访问表数据需要进行的磁盘I/O操作就越少,如果可能甚至可以将该值设置为物理内存大小的80%。
架构优化
-
通过拆分提高表的访问效率。
- 垂直拆分
- 水平拆分
-
逆范式理论。数据表设计的规范程度称之为范式(Normal Form),要提升表的规范程度通常需要将大表拆分为更小的表,范式级别越高数据冗余越小,而且在插入、删除、更新数据时出问题的可能性会大幅度降低,但是节省了空间就意味着查询数据时可能花费更多的时间,原来的单表查询可能会变成连表查询。为此,项目实践中我们通常会进行逆范式操作,故意降低范式级别增加冗余来减少查询的时间开销。
- 1NF:列不能再拆分
- 2NF:所有的属性都依赖于主键
- 3NF:所有的属性都直接依赖于主键(消除传递依赖)
- BCNF:消除非平凡多值依赖
-
使用中间表提高统计查询速度。
使用
insert into 中间表 select ... where ...这样的语句先将需要的数据筛选出来放到中间表中,然后再对中间表进行统计,避免不必要的运算和处理。 -
主从复制和读写分离,具体内容请参考《项目部署上线和性能调优》。
-
配置MySQL集群。
说明:本章内容参考了网易出品的《深入浅出MySQL》一书,该书和《高性能MySQL》一样,都对MySQL进行了深入细致的讲解,虽然总体感觉后者更加高屋建瓴,但是前者也算得上是提升MySQL技能的佳作(作者的文字功底稍显粗糙,深度也不及后者),建议有兴趣的读者可以阅读这两本书。
94 网络API接口设计
目前许多的Web应用和移动应用都使用了前后端分离的开发模式,前后端分离简单的说就是前端或移动端通过网络API接口和后台进行交互,获得接口中提供的数据并负责用户界面的渲染。API是应用程序的编程接口的缩写,网络API通常指的是基于一个URL(统一资源定位符)可以访问到的资源,也就是说通过这个URL我们就可以请求服务器对某个资源进行操作并返回操作的结果。大家可以想想,网络API接口不也是一种封装吗,简单的说就是将复杂的业务逻辑隐藏在简单的API接口中。
URL的通用格式如下所示:
协议://用户名:口令@主机:端口/路径1/.../路径N/资源名说明:URL中的用户名(有可能不需要提供用户名)、口令(有可能不需要提供口令)、端口(有可能使用默认端口)、路径(资源有可能直接位于根路径
/下)并不是必需的部分,可以根据需要进行设置。
网络API通常基于HTTP或HTTPS进行访问,基于HTTP/HTTPS最大的好处就在于访问起来非常的简单方便,而且可以跨语言、跨应用进行访问和互操作。
设计原则
关键问题
为移动端或者PC端设计网络API接口一个非常重要的原则是:根据业务实体而不是用户界面或操作来设计API接口。如果API接口的设计是根据用户的操作或者界面上的功能设置来设计,随着需求的变更,用户界面也会进行调整,需要的数据也在发生变化,那么后端开发者就要不停的调整API,或者给一个API设计出多个版本,这些都会使项目的开发和维护成本增加。我们可以将业务实体理解为服务器提供的资源,而URL就是资源的定位符(标识符),这种方式是最为简单自然的。对于相对复杂的用户操作,我们可以提供一个“门面”(设计模式中的“门面模式”),通过该“门面”把多个接口的功能组装起来即可。
下面是某个网站开放API的接口,可以看出API的设计是围绕业务实体来进行的,而且都做到了“见名知意”。
| 评论 | |
|---|---|
| comments/show | 获取某条微博的评论列表 |
| comments/by_me | 自己的评论列表 |
| comments/to_me | 收到的评论列表 |
| comments/mentions | @了自己的评论列表 |
| comments/create | 创建一条评论 |
| comments/destroy | 删除一条评论 |
| comments/reply | 回复一条评论 |
需要说明的是,上面的API接口并不是REST风格的。REST是一种网络应用架构风格,被认为最适合分布式的网络应用。关于REST的知识,可以阅读阮一峰的《理解RESTful架构》以及《RESTful API设计指南》,当然这两篇文章大家也要批判的阅读,因为上面阐述的观点并不完全正确,有些内容甚至是自相矛盾的。
API接口返回的数据通常都是JSON或XML格式,XML这种数据格式目前基本已经被弃用了。对于JSON格式的数据,我们需要做到不要返回null这的值,因为这样的值一旦处置失当,会给前端和移动端开发带来不必要的麻烦(因为开发者有可能会使用强类型语言)。要解决这个问题可以从源头入手,在设计数据库的时候,尽量给每个字段都加上“not null”约束或者设置合理的默认值约束。
其他问题
- 更新提示问题:设计一个每次使用系统首先要访问的API,该API会向移动端返回系统更新的相关信息,这样就可以提升用户更新App了。
- 版本升级问题:API版本升级时应该考虑对低版本的兼容,同时要让新版本和旧版本都能够被访问,可以在URL中包含版本信息或者在将版本号放在HTTP(S)协议头部,关于这个问题有很多的争论,有兴趣的可以看看stack overflow上面对这个问题的讨论。
- 图片尺寸问题:移动端对于一张图片可能需要不同的尺寸,可以在获取图片时传入尺寸参数并获取对应的资源;更好的做法是直接使用云存储或CDN(直接提供了图片缩放的功能),这样可以加速对资源的访问。
文档撰写
下面以设计评论接口为例,简单说明接口文档应该如何撰写。
首先,我们可以定义全局返回状态码。
| 返回码 | 返回信息 | 说明 |
|---|---|---|
| 10000 | 获取评论成功 | |
| 10001 | 创建评论成功 | |
| 10002 | 无法创建评论 | 创建评论时因违反审核机制而无法创建 |
| 10003 | 评论已被删除 | 查看评论时评论因不和谐因素已被删除 |
| 10004 | …… | …… |
-
获取文章评论。
GET
/articles/{article-id}/comments/开发者:王大锤
最后更新时间:2018年8月10日
标签:v 1.0
接口说明:获取指定文章的所有评论
使用帮助:默认返回20条数据,需要在请求头中设置身份标识(key)
请求参数:
参数名 类型 是否必填 参数位置 说明 page 整数 否 查询参数 页码,默认值1 size 整数 否 查询参数 每次获取评论数量(10~100),默认值20 key 字符串 是 请求头 用户的身份标识 响应信息:
{"code": 10000,"message": "获取评论成功","page": 1,"size": 10,"totalPage": 35,"contents": [{"userId": 1700095,"nickname": "王大锤","pubDate": "2018年7月31日","content": "小编是不是有病呀",/* ... */},{"userId", 1995322,"nickname": "白元芳","pubDate": "2018年8月2日","content": "楼上说得好",/* ... */}]/* ... */} -
新增文章评论。
POST
/articles/{article-id}/comments开发者:王大锤
最后更新时间:2018年8月10日
标签:v 1.0
接口说明:为指定的文章创建评论
使用帮助:暂无
请求参数:
参数名 类型 是否必填 参数位置 说明 userId 字符串 是 消息体 用户ID key 字符串 是 请求头 用户的令牌 content 字符串 是 消息体 评论的内容 响应信息:
{"code": 10001,"message": "创建评论成功","comment": {"pubDate": "2018年7月31日","content": "小编是不是有病呀"/* ... */}/* ... */}
95 使用Django开发商业项目
说明:本文的部分插图来自于《Python项目开发实战》和《精通Django》,这两本书中都包含了对Django框架精彩的讲解,有兴趣的读者可以自行购买阅读。
Web应用
问题1:描述一个Web应用的工作流程。
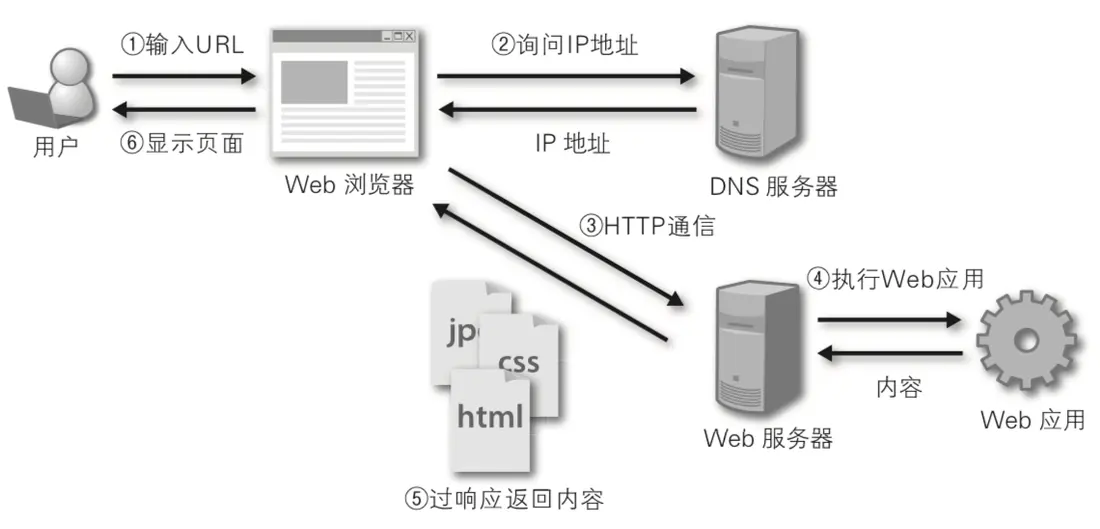
问题2:描述项目的物理架构。(上图中补充负载均衡(反向代理)服务器、数据库服务器、文件服务器、邮件服务器、缓存服务器、防火墙等,而且每个节点都有可能是多节点构成的集群。当然,架构都是根据业务的需要一步步演进而不是一蹴而就的。)
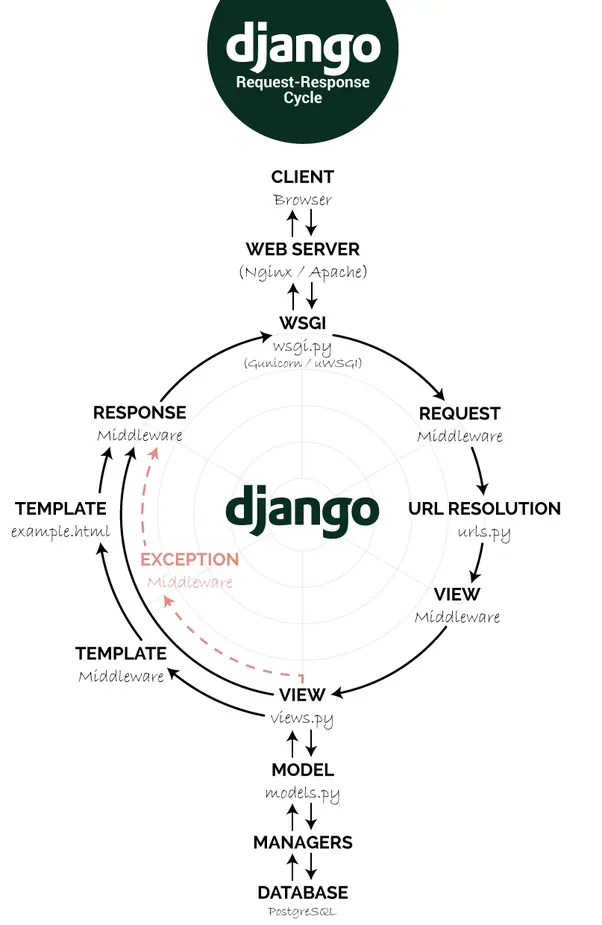
问题3:描述Django项目的工作流程。(如下图所示)
MVC架构模式
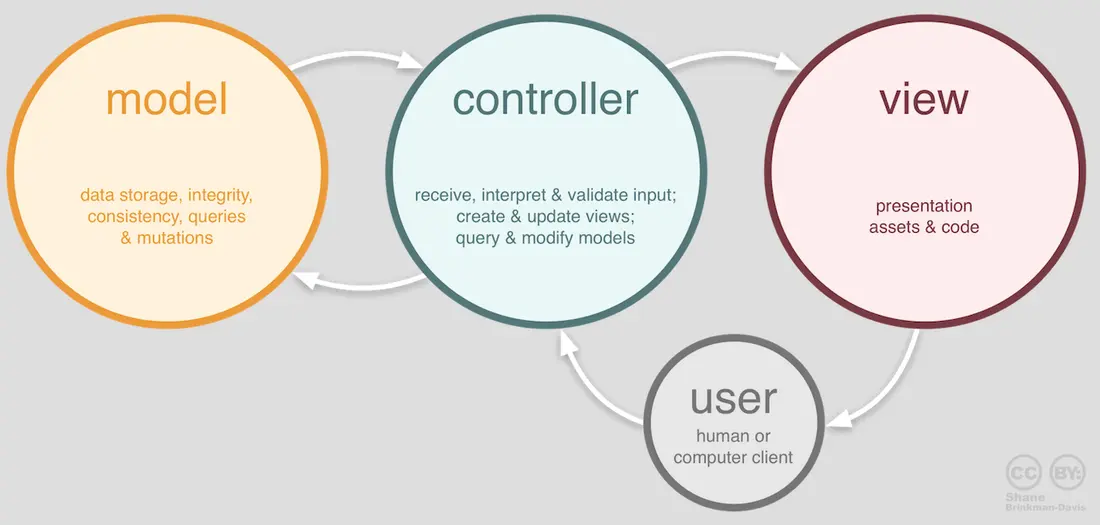
问题1:为什么要使用MVC架构模式?(模型和视图解耦合)
问题2:MVC架构中每个部分的作用?(如下图所示)
HTTP请求和响应
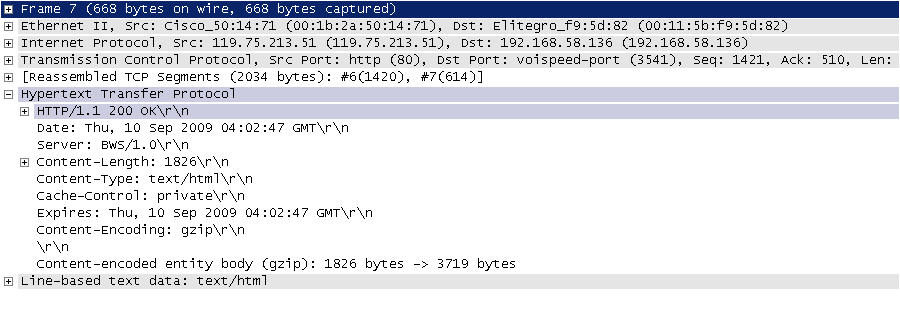
HTTP请求 = 请求行+请求头+空行+[消息体]
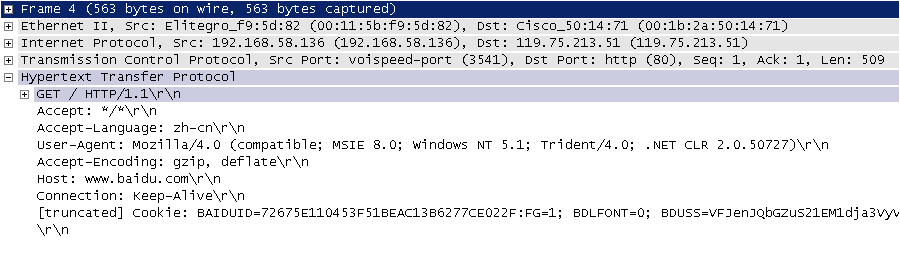
HTTP响应 = 响应行+响应头+空行+消息体
-
HTTPRequest对象的属性和方法:method- 获取请求方法path/get_full_path()- 获取请求路径/带查询字符串的路径scheme/is_secure()/get_host()/get_port()- 获取请求的协议/主机/端口META/COOKIES- 获取请求头/Cookie信息GET/POST/FILES- 获取GET或POST请求参数/上传的文件get_signed_cookie()- 获取带签名的Cookieis_ajax()- 是不是Ajax异步请求body/content_type/encoding- 获取请求的消息体(bytes流)/MIME类型/编码
-
中间件添加的属性:
session/user/site
-
HttpResponse对象的属性和方法:set_cookie()/set_signed_cookie()/delete_cookie()- 添加/删除Cookie__setitem__/__getitem__/__delitem__- 添加/获取/删除响应头charset/content/status_code- 响应的字符集/消息体(bytes流)/状态码- 1xx:请求已经收到,继续处理
- 2xx(成功):请求已经成功收到、理解和接收。
- 3xx(重定向):为完成请求要继续执行后续的操作。
- 4xx(客户端错误):请求不正确或不能够被受理。
- 5xx(服务器错误):服务器处理请求失败。
-
JsonResponse(HttpResponse的子类型)对象>>> from django.http import HttpResponse, JsonResponse>>>>>> response = JsonResponse({'foo': 'bar'})>>> response.content>>>>>> response = JsonResponse([1, 2, 3], safe=False)>>> response.content>>>>>> response = HttpResponse(b'...')>>> response['cotent-type'] = 'application/pdf';>>> response['content-disposition'] = 'inline; filename="xyz.pdf"'>>> response['content-disposition'] = 'attachment; filename="xyz.pdf"'>>>>>> response.set_signed_cookie('foo', 'bar', salt='')>>> response.status_code = 200
数据模型(Model)
问题1:关系型数据库表的设计应该注意哪些问题(范式理论和逆范式)?如何通过表来创建模型类(反向工程)?如何通过模型类来创建表(正向工程)?
python manage.py makemigrations <appname>python manage.py migrate
python manage.py inspectdb > <appname>/models.py问题2:关系型数据库中数据完整性指的是什么?什么时候需要牺牲数据完整性?(实体完整性/参照完整性/域完整性)
问题3:ORM是什么以及解决了什么问题?(对象模型-关系模型双向转换)
-
Field及其子类的属性:- 通用选项:
db_column/db_tablespacenull/blank/defaultprimary_keydb_index/unqiuechoices/help_text/error_message/editable/hidden
- 其他选项:
CharField:max_lengthDateField:auto_now/auto_now_addDecimalField:max_digits/decimal_placesFileField:storage/upload_toImageField:height_field/width_field
- 通用选项:
-
ForeignKey的属性:-
重要属性:
-
db_constraint(提升性能或者数据分片的情况可能需要设置为False) -
on_deleteCASCADE:级联删除。
PROTECT:抛出ProtectedError异常,阻止删除引用的对象。SET_NULL:把外键设置为null,当null属性被设置为True时才能这么做。SET_DEFAULT:把外键设置为默认值,提供了默认值才能这么做。
-
related_nameclass Dept(models.Model):passclass Emp(models.Model):dept = models.ForeignKey(related_name='+', ...)Dept.objects.get(no=10).emp_set.all()Emp.objects.filter(dept__no=10)说明:
related_name设置为'+',可以防止一对多外键关联从“一”的一方查询“多”的一方。
-
-
其他属性:
to_field/limit_choices_to/swappable
-
-
Model的属性和方法-
objects/pk -
save()/delete() -
clean()/validate_unique()/full_clean()
-
-
QuerySet的方法-
get()/all()/values()说明:
values()返回的QuerySet中不是模型对象而是字典 -
count()/order_by()/exists()/reverse() -
filter()/exclude()-
exact/iexact:精确匹配/忽略大小写的精确匹配查询 -
contains/icontains/startswith / istartswith / endswith / iendswith:基于like的模糊查询 -
in:集合运算 -
gt/gte/lt/lte:大于/大于等于/小于/小于等于关系运算 -
range:指定范围查询(SQL中的between…and…) -
year/month/day/week_day/hour/minute/second:查询时间日期 -
isnull:查询空值(True)或非空值(False) -
search:基于全文索引的全文检索 -
regex/iregex:基于正则表达式的模糊匹配查询 -
aggregate()/annotate() -
Avg/Count/Sum/Max/Min>>> from django.db.models import Avg>>> Emp.objects.aggregate(avg_sal=Avg('sal'))(0.001) SELECT AVG(`TbEmp`.`sal`) AS `avg_sal` FROM `TbEmp`; args=(){'avg_sal': 3521.4286}>>> Emp.objects.values('dept').annotate(total=Count('dept'))(0.001) SELECT `TbEmp`.`dno`, COUNT(`TbEmp`.`dno`) AS `total` FROM `TbEmp` GROUP BY `TbEmp`.`dno` ORDER BY NULL LIMIT 21; args=()<QuerySet [{'dept': 10, 'total': 4}, {'dept': 20, 'total': 7}, {'dept': 30, 'total': 3}]
-
-
first()/last()说明:调用
first()方法相当于用[0]对QuerySet进行切片。 -
only()/defer()>>> Emp.objects.filter(pk=7800).only('name', 'sal')(0.001) SELECT `TbEmp`.`empno`, `TbEmp`.`ename`, `TbEmp`.`sal` FROM `TbEmp` WHERE `TbEmp`.`empno` = 7800 LIMIT 21; args=(7800,)<QuerySet [<Emp: Emp object (7800)>]>>>> Emp.objects.filter(pk=7800).defer('name', 'sal')(0.001) SELECT `TbEmp`.`empno`, `TbEmp`.`job`, `TbEmp`.`mgr`, `TbEmp`.`comm`, `TbEmp`.`dno` FROM `TbEmp` WHERE `TbEmp`.`empno` = 7800 LIMIT 21; args=(7800,)<QuerySet [<Emp: Emp object (7800)>]> -
create()/update()/raw()>>> Emp.objects.filter(dept__no=20).update(sal=F('sal') + 100)(0.011) UPDATE `TbEmp` SET `sal` = (`TbEmp`.`sal` + 100) WHERE `TbEmp`.`dno` = 20; args=(100, 20)>>>>>> Emp.objects.raw('select empno, ename, job from TbEmp where dno=10')<RawQuerySet: select empno, ename, job from TbEmp where dno=10>
-
-
Q对象和F对象说明:Q对象主要用来解决多条件组合的复杂查询;F对象主要用于更新数据。
>>> from django.db.models import Q>>> Emp.objects.filter(... Q(name__startswith='张'),... Q(sal__lte=5000) | Q(comm__gte=1000)... ) # 查询名字以“张”开头且工资小于等于5000或补贴大于等于1000的员工<QuerySet [<Emp: 张三丰>]>>>> from backend.models import Emp, Dept>>> emps = Emp.objects.filter(dept__no=20)>>> from django.db.models import F>>> emps.update(sal=F('sal') + 100) -
原生SQL查询
from django.db import connectionswith connections['...'].cursor() as cursor:cursor.execute("UPDATE TbEmp SET sal=sal+10 WHERE dno=30")cursor.execute("SELECT ename, job FROM TbEmp WHERE dno=10")row = cursor.fetchall() -
模型管理器
class BookManager(models.Manager):def title_count(self, keyword):return self.filter(title__icontains=keyword).count()class Book(models.Model):objects = BookManager()
视图函数(Controller)
如何设计视图函数
-
用户的每个请求(用户故事)对应一个视图函数,当然也可以将用户要执行的业务逻辑封装到独立的函数中,也就是有专门的模块处理程序中的业务逻辑。
-
用户的请求可能会包含多个(持久化)操作,这些操作有可能需要设计成不可分割的原子性操作,那么这里就形成了事务的边界。
-
事务的ACID特性。
- 原子性(Atomicity):事务中各项的操作要么全做要么全不做;
- 一致性(Consistentcy):事务前后系统的状态是一致的;
- 隔离性(Isolation):并发执行的事务无法看到彼此的中间状态;
- 持久性(Duration):事务完成后所做的改动都会被持久化。
-
事务隔离级别 - 设置事务隔离级别是为了数据库底层依据事务隔离级别为数据加上适当的锁。如果需要保证数据的强一致性,那么关系型数据库仍然是唯一的也是最好的选择,因为关系型数据库可以通过锁机制来保护数据。事务隔离级别从低到高依次是:Read Uncommitted(读未提交)、Read Committed(读提交)、Repeatable Read(可重复读)、Serializable(串行化)。事务隔离级别越高,数据并发访问的问题越少,但是性能越差;事务隔离级别越低,数据并发访问的问题越多,但是性能越好。
-
数据并发访问会产生5种问题(请参考我的《Java面试题全集(上)》第80题对该问题的讲解):
- 第1类丢失更新(A事务撤销覆盖B事务更新的数据)和第2类丢失更新(A事务提交覆盖B事务更新的数据)。
- 脏读(读脏数据):一个事务读取到其他尚未提交的事务的数据。
- 不可重复读: 一个事务在读取它的查询结果时,被另一个事务更新了它的查询记录导致无法读到数据。
- 幻读:一个事务在读取它的查询结果时,发现读到了被另一个事务提交的新数据。
-- 设置全局默认的事务隔离级别set global transaction isolation level repeatable read;-- 设置当前会话的事务隔离级别set session transaction isolation level read committed;-- 查询当前会话的事务隔离级别select @@tx_isolation; -
Django中的事务控制。
-
给每个请求绑定事务环境(反模式)。
ATOMIC_REQUESTS = True -
使用事务装饰器(简单易用) - 粗粒度(控制不够精细)。
@transaction.non_atomic_requests@transaction.atomic -
使用上下文语法(细粒度 - 事务控制的范围更加精准)。
with transaction.atomic():pass -
关闭自动提交使用手动提交。
AUTOCOMMIT = Falsetransaction.commit()transaction.rollback()
-
-
URL配置
-
可以让部分URL只在调试模式下生效。
from django.conf import settingsurlpatterns = [...]if settings.DEBUG:urlpatterns += [ ... ] -
可以使用命名捕获组捕获路径参数。
url(r'api/code/(?P<mobile>1[3-9]\d{9})'),path('api/code/<str:mobile>'), -
URL配置不关心请求使用的方法(一个视图函数可以处理不同的请求方式)。
-
如果使用
url函数捕获的路径参数都是字符串,path函数可以指定路径参数类型。 -
可以使用
include函数引入其他URL配置并指定namespace来解决命名冲突,捕获的参数会向下传递。 -
在
url和path函数甚至是include函数中都可以用字典向视图传入额外的参数,如果参数与捕获的参数同名,则使用字典中的参数。 -
可以用
reverse函数实现URL的逆向解析(从名字解析出URL),在模板中也可以用{% url %}实现同样的操作。path('', views.index, name='index')return redirect(reverse('index'))return redirect('index')
模板(View)
后端渲染
-
模板的配置和渲染函数。
TEMPLATES = [{'BACKEND': 'django.template.backends.django.DjangoTemplates','DIRS': [os.path.join(BASE_DIR, 'templates'), ],'APP_DIRS': True,'OPTIONS': {'context_processors': ['django.template.context_processors.debug','django.template.context_processors.request','django.contrib.auth.context_processors.auth','django.contrib.messages.context_processors.messages',],},},]resp = render(request, 'index.html', {'foo': ...}) -
模板遇到变量名的查找顺序。
- 字典查找(如:
foo['bar']) - 属性查找(如:
foo.bar) - 方法调用(如:
foo.bar())- 方法不能有必须传值的参数
- 在模板中不能够给方法传参
- 如果方法的
alters_data被设置为True则不能调用该方法(避免误操作的风险),模型对象动态生成的delete()和save()方法都设定了alters_data = True。
- 列表索引查找(如:
foo[0])
- 字典查找(如:
-
模板标签的使用。
{% if %}/{% else %}/{% endif %}{% for %}/{% endfor %}{% ifequal %}/{% endifequal %}/{% ifnotequal %}/{% endifnotequal %}{# comment #}/{% comment %}/{% endcomment %}
-
过滤器的使用。
lower/upper/first/last/truncatewords/date/time/length/pluralize/center/ljust/rjust/cut/urlencode/default_if_none/filesizeformat/join/slice/slugify
-
模板的包含和继承。
{% include %}/{% block %}{% extends %}
-
模板加载器(后面优化部分会讲到)。
-
文件系统加载器
TEMPLATES = [{'BACKEND': 'django.template.backends.django.DjangoTemplates','DIRS': [os.path.join(BASE_DIR, 'templates')],}] -
应用目录加载器
TEMPLATES = [{'BACKEND': 'django.template.backends.django.DjangoTemplates','APP_DIRS': True,}]
-
前端渲染
- 前端模板引擎:Handlebars / Mustache。
- 前端MV*框架。
- MVC - AngularJS
- MVVM(Model-View-ViewModel) - Vue.js
其他视图
-
MIME(多用途Internet邮件扩展)类型 - 告知浏览器传输的数据类型。
-
如何处置生成的内容(inline / attachment)。
>>> from urllib.parse import quote>>>>>> response['content-type'] = 'application/pdf'>>> filename = quote('Python语言规范.pdf')>>> filename'Python%E8%AF%AD%E8%A8%80%E8%A7%84%E8%8C%83.pdf'>>> response['content-disposition'] = f'attachment; filename="{filename}"'提醒:URL以及请求和响应头中的中文都应该处理成百分号编码。
-
生成CSV / Excel / PDF / 统计报表。
-
向浏览器传输二进制数据。
from io import BytesIObuffer = BytesIO()resp = HttpResponse(content_type='...')resp['Content-Disposition'] = 'attachment; filename="..."'resp.write(buffer.getvalue())from io import BytesIOimport xlwtdef get_style(name, color=0, bold=False, italic=False):font = xlwt.Font()font.name, font.colour_index, font.bold, font.italic = \name, color, bold, italicstyle = xlwt.XFStyle()style.font = fontreturn styledef export_emp_excel(request):# 创建Excel工作簿(使用三方库xlwt)workbook = xlwt.Workbook()# 向工作簿中添加工作表sheet = workbook.add_sheet('员工详细信息')# 设置表头titles = ['编号', '姓名', '主管', '职位', '工资', '部门名称']for col, title in enumerate(titles):sheet.write(0, col, title, get_style('HanziPenSC-W3', 2, True))# 使用Django的ORM框架查询员工数据emps = Emp.objects.all().select_related('dept').select_related('mgr')cols = ['no', 'name', 'mgr', 'job', 'sal', 'dept']# 通过嵌套的循环将员工表的数据写入Excel工作表的单元格for row, emp in enumerate(emps):for col, prop in enumerate(cols):val = getattr(emp, prop, '')if isinstance(val, (Dept, Emp)):val = val.namesheet.write(row + 1, col, val)# 将Excel文件的二进制数据写入内存buffer = BytesIO()workbook.save(buffer)# 通过HttpResponse对象向浏览器输出Excel文件resp = HttpResponse(buffer.getvalue())resp['content-type'] = 'application/msexcel'# 如果文件名有中文需要处理成百分号编码resp['content-disposition'] = 'attachment; filename="detail.xls"'return resp -
大文件的流式处理:
StreamingHttpResponse。def download_file(request):file_stream = open('...', 'rb')# 如果文件的二进制数据较大则最好用迭代器进行处理避免过多的占用服务器内存file_iter = iter(lambda: file_stream.read(4096), b'')resp = StreamingHttpResponse(file_iter)# 中文文件名要处理成百分号编码filename = quote('...', 'utf-8')resp['Content-Type'] = '...'resp['Content-Disposition'] = f'attachment; filename="{filename}"'return resp说明:如果需要生成PDF文件,可以需要安装
reportlab。另外,使用StreamingHttpResponse只能减少内存的开销,但是如果下载一个大文件会导致一个请求长时间占用服务器资源,比较好的做法还是把报表提前生成好(可以考虑使用定时任务),放在静态资源服务器或者是云存储服务器上以访问静态资源的方式访问。 -
- 思路:后端只提供JSON格式的数据,前端JavaScript渲染生成图表。
def get_charts_data(request):"""获取统计图表JSON数据"""names = []totals = []# 通过connections获取指定数据库连接并创建游标对象with connections['backend'].cursor() as cursor:# 在使用ORM框架时可以使用对象管理器的aggregate()和annotate()方法实现分组和聚合函数查询# 执行原生SQL查询(如果ORM框架不能满足业务或性能需求)cursor.execute('select dname, total from vw_dept_emp')for row in cursor.fetchall():names.append(row[0])totals.append(row[1])return JsonResponse({'names': names, 'totals': totals})<!DOCTYPE html><html lang="en"><head><meta charset="UTF-8"><title>统计图表</title><style>#main {width: 600px;height: 400px;}</style></head><body><div id="main"></div><script src="https://cdn.bootcss.com/echarts/4.2.0-rc.2/echarts.min.js"></script><script src="https://cdn.bootcss.com/jquery/3.3.1/jquery.min.js"></script><script>var myChart = echarts.init($('#main')[0]);$.ajax({'url': 'charts_data','type': 'get','data': {},'dataType': 'json','success': function(json) {var option = {title: {text: '员工分布统计图'},tooltip: {},legend: {data:['人数']},xAxis: {data: json.names},yAxis: {},series: [{name: '人数',type: 'bar',data: json.totals}]};myChart.setOption(option);},'error': function() {}});</script></body></html>
-
中间件
问题1:中间件背后的设计理念是什么?(分离横切关注功能/拦截过滤器模式)
问题2:中间件有哪些不同的实现方式?(参考下面的代码)
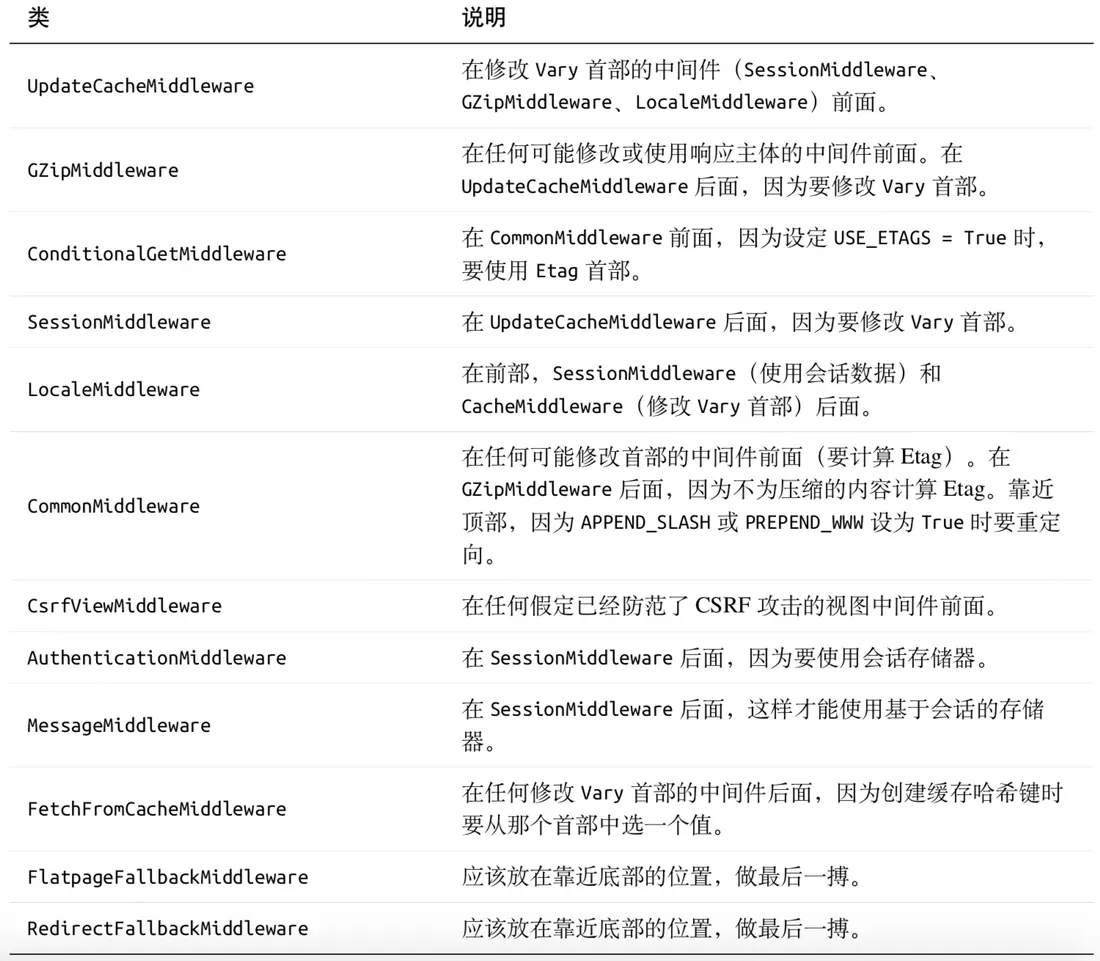
问题3:描述Django内置的中间件及其执行顺序。(推荐阅读:Django官方文档 - 中间件 - 中间件顺序)
激活中间件
MIDDLEWARE = [ 'django.middleware.security.SecurityMiddleware', 'django.contrib.sessions.middleware.SessionMiddleware', 'django.middleware.common.CommonMiddleware', 'django.middleware.csrf.CsrfViewMiddleware', 'django.contrib.auth.middleware.AuthenticationMiddleware', 'django.contrib.messages.middleware.MessageMiddleware', 'django.middleware.clickjacking.XFrameOptionsMiddleware', 'common.middlewares.block_sms_middleware',]自定义中间件
def simple_middleware(get_response):
def middleware(request, *args, **kwargs):
response = get_response(request, *args, **kwargs)
return response
return middlewareclass MyMiddleware:
def __init__(self, get_response): self.get_response = get_response
def __call__(self, request):
response = self.get_response(request)
return responseclass MyMiddleware(MiddlewareMixin):
def __init__(self): pass
def process_request(request): pass
def process_view(request, view_func, view_args, view_kwargs): pass
def process_template_response(request, response): pass
def process_response(request, response): pass
def process_exception(request, exception): pass内置中间件
-
CommonMiddleware - 基础设置中间件
- DISALLOWED_USER_AGENTS - 不被允许的用户代理(浏览器)
- APPEND_SLASH - 是否追加
/ - USE_ETAG - 浏览器缓存相关
-
SecurityMiddleware - 安全相关中间件
- SECURE_HSTS_SECONDS - 强制使用HTTPS的时间
- SECURE_HSTS_INCLUDE_SUBDOMAINS - HTTPS是否覆盖子域名
- SECURE_CONTENT_TYPE_NOSNIFF - 是否允许浏览器推断内容类型
- SECURE_BROWSER_XSS_FILTER - 是否启用跨站脚本攻击过滤器
- SECURE_SSL_REDIRECT - 是否重定向到HTTPS连接
- SECURE_REDIRECT_EXEMPT - 免除重定向到HTTPS
-
SessionMiddleware - 会话中间件
-
CsrfViewMiddleware - 防范跨站身份伪造中间件
-
XFrameOptionsMiddleware - 防范点击劫持攻击中间件
表单
- 用法:通常不要用来生成页面上的表单控件(耦合度太高不容易定制),主要用来验证数据。
- Form的属性和方法:
is_valid()/is_multipart()errors/fields/is_bound/changed_data/cleaned_dataadd_error()/has_errors()/non_field_errors()clean()
- Form.errors的方法:
as_data()/as_json()/get_json_data()
问题1:Django中的Form和ModelForm有什么作用?(通常不用来生成表单主要用来验证数据)
问题2:表单上传文件时应该注意哪些问题?(表单的设置、多文件上传、图片预览(FileReader)、Ajax上传文件、上传后的文件如何存储、调用云存储(如阿里云OSS、七牛云、LeanCloud等))
<form action="" method="post" enctype="multipart/form-data"> <input type="file" name="..." multiple> <input type="file" name="foo"> <input type="file" name="foo"> <input type="file" name="foo"></form>说明:上传图片文件的预览效果可以通过HTML5的FileReader来实现。
说明:使用云存储通常是比自己配置分布式文件系统这种方式更靠谱的做法,而且云存储通常成本并不太高,不仅如此大多数云存储还提供了如图片剪裁、生成水印、视频转码、CDN等服务。如果要自己做上传的视频文件转码,需要安装三方库ffmpeg,在程序中调用该三方库可以实现转码。
Cookie和Session
问题1:使用Cookie能解决什么问题?(用户跟踪,解决HTTP协议无状态问题)
-
URL重写
http://www.abc.com/path/resource?foo=bar -
隐藏域(隐式表单域)- 埋点
<form action="" method="post"><input type="hidden" name="foo" value="bar"></form> -
Cookie - 浏览器中的临时文件(文本文件)- BASE64
问题2:Cookie和Session之间关系是什么?(Session的标识通过Cookie保存和传输)
Session的配置
-
Session对应的中间件:
django.contrib.sessions.middleware.SessionMiddleware。 -
Session引擎。
-
基于数据库(默认方式)
INSTALLED_APPS = ['django.contrib.sessions',] -
基于缓存(推荐使用)
SESSION_ENGINE = 'django.contrib.sessions.backends.cache'SESSION_CACHE_ALIAS = 'session' -
基于文件(基本不考虑)
-
基于Cookie(不靠谱)
SESSION_ENGINE = 'django.contrib.sessions.backends.signed_cookies'
-
-
Cookie相关的配置。
SESSION_COOKIE_NAME = 'djang_session_id'SESSION_COOKIE_AGE = 1209600# 如果设置为True,Cookie就是基于浏览器窗口的Cookie,不会持久化SESSION_EXPIRE_AT_BROWSER_CLOSE = FalseSESSION_SAVE_EVERY_REQUEST = FalseSESSION_COOKIE_HTTPONLY = True -
session的属性和方法。
session_key/session_data/expire_date__getitem__/__setitem__/__delitem__/__contains__set_expiry()/get_expiry_age()/get_expiry_date()- 设置/获取会话超期时间flush()- 销毁会话set_test_cookie()/test_cookie_worked()/delete_test_cookie()- 测试浏览器是否支持Cookie(提示用户如果浏览器禁用Cookie可能会影响网站的使用)
-
session的序列化。
SESSION_SERIALIZER = 'django.contrib.sessions.serializers.JSONSerializer'-
JSONSerializer(1.6及以后默认)- 如果想将自定义的对象放到session中,会遇到“Object of type ‘XXX’ is not JSON serializable”的问题(如果配置使用Redis保存Session,django-redis使用了Pickle序列化,这个问题就不存在了)。
-
PickleSerializer(1.6以前的默认)- 因为安全问题不推荐使用,但是只要不去反序列化用户构造的恶意的Payload其实也没有什么风险。关于这种方式的安全漏洞,可以参考《Python Pickle的任意代码执行漏洞实践和Payload构造》一文或《软件架构-Python语言实现》上关于这个问题的讲解。
说明:如果使用了django_redis整合Redis作为session的存储引擎,那么由于django_redis又封装了一个PickleSerializer来提供序列化,所以不会存在上述的问题,且Redis中保存的value是pickle序列化之后的结果。
-
缓存
配置缓存
CACHES = { # 默认缓存 'default': { 'BACKEND': 'django_redis.cache.RedisCache', 'LOCATION': [ 'redis://1.2.3.4:6379/0', ], 'KEY_PREFIX': 'teamproject', 'OPTIONS': { 'CLIENT_CLASS': 'django_redis.client.DefaultClient', 'CONNECTION_POOL_KWARGS': { 'max_connections': 1000, }, 'PASSWORD': 'yourpass', } }, # 页面缓存 'page': { 'BACKEND': 'django_redis.cache.RedisCache', 'LOCATION': [ 'redis://1.2.3.4:6379/1', ], 'KEY_PREFIX': 'teamproject:page', 'OPTIONS': { 'CLIENT_CLASS': 'django_redis.client.DefaultClient', 'CONNECTION_POOL_KWARGS': { 'max_connections': 500, }, 'PASSWORD': 'yourpass', } }, # 会话缓存 'session': { 'BACKEND': 'django_redis.cache.RedisCache', 'LOCATION': [ 'redis://1.2.3.4:6379/2', ], 'KEY_PREFIX': 'teamproject:session', 'TIMEOUT': 1209600, 'OPTIONS': { 'CLIENT_CLASS': 'django_redis.client.DefaultClient', 'CONNECTION_POOL_KWARGS': { 'max_connections': 2000, }, 'PASSWORD': 'yourpass', } }, # 接口数据缓存 'api': { 'BACKEND': 'django_redis.cache.RedisCache', 'LOCATION': [ 'redis://1.2.3.4:6379/3', ], 'KEY_PREFIX': 'teamproject:api', 'OPTIONS': { 'CLIENT_CLASS': 'django_redis.client.DefaultClient', 'CONNECTION_POOL_KWARGS': { 'max_connections': 500, }, 'PASSWORD': 'yourpass', } },}说明:通过Redis底层提供的多个数据库来隔离缓存数据有助于缓存数据的管理。如果配置了Redis的主从复制(读写分离),LOCATION列表中可以配置多个Redis连接,第一个被视为master用来进行写操作,后面的被视为slave用来进行读操作。
全站缓存
MIDDLEWARE_CLASSES = [ 'django.middleware.cache.UpdateCacheMiddleware', ... 'django.middleware.common.CommonMiddleware', ... 'django.middleware.cache.FetchFromCacheMiddleware',]
CACHE_MIDDLEWARE_ALIAS = 'default'CACHE_MIDDLEWARE_SECONDS = 300CACHE_MIDDLEWARE_KEY_PREFIX = 'djang:cache'视图层缓存
from django.views.decorators.cache import cache_pagefrom django.views.decorators.vary import vary_on_cookie
@cache_page(timeout=60 * 15, cache='page')@vary_on_cookiedef my_view(request): passfrom django.views.decorators.cache import cache_page
urlpatterns = [ url(r'^foo/([0-9]{1,2})/$', cache_page(60 * 15)(my_view)),]其他内容
-
模板片段缓存。
{% load cache %}{% cache %}/{% endcache %}
-
使用底层API访问缓存。
>>> from django.core.cache import cache>>>>>> cache.set('my_key', 'hello, world!', 30)>>> cache.get('my_key')>>> cache.clear()>>> from django.core.cache import caches>>> cache1 = caches['page']>>> cache2 = caches['page']>>> cache1 is cache2True>>> cache3 = caches['session']>>> cache2 is cache3False>>> from django_redis import get_redis_connection>>>>>> redis_client = get_redis_connection()>>> redis_client.hgetall()
日志
日志级别
NOTSET < DEBUG < INFO < WARNING < ERROR < CRITICAL
日志配置
LOGGING = { 'version': 1, 'disable_existing_loggers': False, # 配置日志格式化器 'formatters': { 'simple': { 'format': '%(asctime)s %(module)s.%(funcName)s: %(message)s', 'datefmt': '%Y-%m-%d %H:%M:%S', }, 'verbose': { 'format': '%(asctime)s %(levelname)s [%(process)d-%(threadName)s] ' '%(module)s.%(funcName)s line %(lineno)d: %(message)s', 'datefmt': '%Y-%m-%d %H:%M:%S', } }, # 配置日志过滤器 'filters': { 'require_debug_true': { '()': 'django.utils.log.RequireDebugTrue', }, }, # 配置日志处理器 'handlers': { 'console': { 'class': 'logging.StreamHandler', 'level': 'DEBUG', 'filters': ['require_debug_true'], 'formatter': 'simple', }, 'file1': { 'class': 'logging.handlers.TimedRotatingFileHandler', 'filename': 'access.log', 'when': 'W0', 'backupCount': 12, 'formatter': 'simple', 'level': 'INFO', }, 'file2': { 'class': 'logging.handlers.TimedRotatingFileHandler', 'filename': 'error.log', 'when': 'D', 'backupCount': 31, 'formatter': 'verbose', 'level': 'WARNING', }, }, # 配置日志器 'loggers': { 'django': { 'handlers': ['console', 'file1', 'file2'], 'propagate': True, 'level': 'DEBUG', }, }}日志分析
-
Linux相关命令:head、tail、grep、awk、uniq、sort
Terminal window tail -10000 access.log | awk '{print $1}' | uniq -c | sort -r -
实时日志文件分析:Python + 正则表达式 + Crontab
-
- ElasticSearch:搜索引擎,实现全文检索。
- Logstash:负责从指定节点收集日志。
- Kibana:日志可视化工具。
-
大数据日志处理:Flume+Kafka日志采集、Storm / Spark实时数据处理、Impala实时查询。
RESTful
问题1:RESTful架构到底解决了什么问题?(URL具有自描述性、资源表述与视图的解耦和、互操作性利用构建微服务以及集成第三方系统、无状态性提高水平扩展能力)
问题2:项目在使用RESTful架构时有没有遇到一些问题或隐患?(对资源访问的限制、资源从属关系检查、避免泄露业务信息、防范可能的攻击)
补充:下面的几个和安全性相关的响应头在前面讲中间件的时候提到过的。
- X-Frame-Options: DENY
- X-Content-Type-Options: nosniff
- X-XSS-Protection: 1; mode=block;
- Strict-Transport-Security: max-age=31536000;
问题3:如何保护API中的敏感信息以及防范重放攻击?(摘要和令牌)
推荐阅读:《如何有效防止API的重放攻击》。
使用djangorestframework
安装djangorestfrmework(为了描述方便,以下统一简称为DRF)。
pip install djangorestframework配置DRF。
INSTALLED_APPS = [
'rest_framework',
]
REST_FRAMEWORK = { # 配置默认页面大小 'PAGE_SIZE': 10, # 配置默认的分页类 'DEFAULT_PAGINATION_CLASS': 'rest_framework.pagination.PageNumberPagination', # 配置异常处理器 # 'EXCEPTION_HANDLER': 'api.exceptions.exception_handler', # 配置默认解析器 # 'DEFAULT_PARSER_CLASSES': ( # 'rest_framework.parsers.JSONParser', # 'rest_framework.parsers.FormParser', # 'rest_framework.parsers.MultiPartParser', # ), # 配置默认限流类 # 'DEFAULT_THROTTLE_CLASSES': (), # 配置默认授权类 # 'DEFAULT_PERMISSION_CLASSES': ( # 'rest_framework.permissions.IsAuthenticated', # ), # 配置默认认证类 # 'DEFAULT_AUTHENTICATION_CLASSES': ( # 'rest_framework_jwt.authentication.JSONWebTokenAuthentication', # ),}编写序列化器
from rest_framework import serializersfrom rest_framework.serializers import ModelSerializer
from common.models import District, HouseType, Estate, Agent
class DistrictSerializer(ModelSerializer):
class Meta: model = District fields = ('distid', 'name')
class HouseTypeSerializer(ModelSerializer):
class Meta: model = HouseType fields = '__all__'
class AgentSerializer(ModelSerializer):
class Meta: model = Agent fields = ('agentid', 'name', 'tel', 'servstar', 'certificated')
class EstateSerializer(ModelSerializer): district = serializers.SerializerMethodField() agents = serializers.SerializerMethodField()
@staticmethod def get_agents(estate): return AgentSerializer(estate.agents, many=True).data
@staticmethod def get_district(estate): return DistrictSerializer(estate.district).data
class Meta: model = Estate fields = '__all__'方法1:使用装饰器
@api_view(['GET'])@cache_page(timeout=None, cache='api')def provinces(request): queryset = District.objects.filter(parent__isnull=True) serializer = DistrictSerializer(queryset, many=True) return Response(serializer.data)
@api_view(['GET'])@cache_page(timeout=300, cache='api')def cities(request, provid): queryset = District.objects.filter(parent__distid=provid) serializer = DistrictSerializer(queryset, many=True) return Response(serializer.data)urlpatterns = [ path('districts/', views.provinces, name='districts'), path('districts/<int:provid>/', views.cities, name='cities'),]说明:上面使用了Django自带的视图装饰器(@cache_page)来实现对API接口返回数据的缓存。
方法2:使用APIView及其子类
更好的复用代码,不要重“复发明轮子”。
class HouseTypeApiView(CacheResponseMixin, ListAPIView): queryset = HouseType.objects.all() serializer_class = HouseTypeSerializerurlpatterns = [ path('housetypes/', views.HouseTypeApiView.as_view(), name='housetypes'),]说明:上面使用了drf_extensions提供的CacheResponseMixin混入类实现了对接口数据的缓存。如果重写了获取数据的方法,可以使用drf_extensions提供的@cache_response来实现对接口数据的缓存,也可以用自定义的函数来生成缓存中的key。当然还有一个选择就是通过Django提供的@method_decorator装饰器,将@cache_page装饰器处理为装饰方法的装饰器,这样也能提供使用缓存服务。
drf-extensions配置如下所示。
# 配置DRF扩展来支持缓存API接口调用结果REST_FRAMEWORK_EXTENSIONS = { 'DEFAULT_CACHE_RESPONSE_TIMEOUT': 300, 'DEFAULT_USE_CACHE': 'default', # 配置默认缓存单个对象的key函数 'DEFAULT_OBJECT_CACHE_KEY_FUNC': 'rest_framework_extensions.utils.default_object_cache_key_func', # 配置默认缓存对象列表的key函数 'DEFAULT_LIST_CACHE_KEY_FUNC': 'rest_framework_extensions.utils.default_list_cache_key_func',}方法3:使用ViewSet及其子类
class HouseTypeViewSet(CacheResponseMixin, viewsets.ModelViewSet): queryset = HouseType.objects.all() serializer_class = HouseTypeSerializer pagination_class = Nonerouter = DefaultRouter()router.register('housetypes', views.HouseTypeViewSet)
urlpatterns += router.urlsdjangorestframework提供了基于Bootstrap定制的页面来显示接口返回的JSON数据,当然也可以使用POSTMAN这样的工具对API接口进行测试。
补充说明
在这里顺便提一下跟前端相关的几个问题。
问题1:如何让浏览器能够发起DELETE/PUT/PATCH?
<form method="post">
<input type="hidden" name="_method" value="delete">
</form>if request.method == 'POST' and '_method' in request.POST: request.method = request.POST['_method'].upper()<script> $.ajax({ 'url': '/api/provinces', 'type': 'put', 'data': {}, 'dataType': 'json', 'success': function(json) { // Web = 标签(内容) + CSS(显示) + JS(行为) // JavaScript = ES + BOM + DOM // DOM操作实现页面的局部刷新 }, 'error': function() {} }); $.getJSON('/api/provinces', function(json) { // DOM操作实现页面的局部刷新 });</script>问题2:如何解决多个JavaScript库之间某个定义(如$函数)冲突的问题?
<script src="js/jquery.min.js"></script><script src="js/abc.min.js"></script><script> // $已经被后加载的JavaScript库占用了 // 但是可以直接用绑定在window对象上的jQuery去代替$ jQuery(function() { jQuery('#okBtn').on('click', function() {}); });</script><script src="js/abc.min.js"></script><script src="js/jquery.min.js"></script><script> // 将$让出给其他的JavaScript库使用 jQuery.noConflict(); jQuery(function() { jQuery('#okBtn').on('click', function() {}); });</script>问题3:jQuery对象与原生DOM对象之间如何转换?
<button id="okBtn">点我</button><script src="js/jquery.min.js"></script><script> var btn = document.getElementById('okBtn'); // 原生JavaScript对象(使用相对麻烦) var $btn = $('#okBtn'); // jQuery对象(拥有更多的属性和方法而且没有浏览器兼容性问题) $btn.on('click', function() {}); // $(btn)可以将原生JavaScript对象转成jQuery对象 // $btn.get(0)或$btn[0]可以获得原生的JavaScript对象</script>过滤数据
如果需要过滤数据(对数据接口设置筛选条件、排序条件等),可以使用django-filter三方库来实现。
pip install django-filterINSTALLED_APPS = [
'django_filters',
]REST_FRAMEWORK = {
'DEFAULT_FILTER_BACKENDS': ( 'django_filters.rest_framework.DjangoFilterBackend', 'rest_framework.filters.OrderingFilter', ),
}from django.utils.decorators import method_decoratorfrom django.views.decorators.cache import cache_pagefrom django_filters.rest_framework import DjangoFilterBackendfrom rest_framework.filters import OrderingFilterfrom rest_framework.generics import RetrieveAPIView, ListCreateAPIView
from api.serializers import EstateSerializerfrom common.models import Estate
@method_decorator(decorator=cache_page(timeout=120, cache='api', key_prefix='estates'), name='get')class EstateView(RetrieveAPIView, ListCreateAPIView): queryset = Estate.objects.all().select_related('district').prefetch_related('agents') serializer_class = EstateSerializer filter_backends = (DjangoFilterBackend, OrderingFilter) filter_fields = ('name', 'district') ordering = ('-hot', ) ordering_fields = ('hot', 'estateid')from django_filters import rest_framework as drffrom common.models import HouseInfo
class HouseInfoFilter(drf.FilterSet): """自定义房源数据过滤器"""
title = drf.CharFilter(lookup_expr='starts') dist = drf.NumberFilter(field_name='district') min_price = drf.NumberFilter(field_name='price', lookup_expr='gte') max_price = drf.NumberFilter(field_name='price', lookup_expr='lte') type = drf.NumberFilter()
class Meta: model = HouseInfo fields = ('title', 'district', 'min_price', 'max_price', 'type')class HouseInfoViewSet(CacheResponseMixin, ReadOnlyModelViewSet): queryset = HouseInfo.objects.all() \ .select_related('type', 'district', 'estate', 'agent') \ .prefetch_related('tags').order_by('-pubdate') serializer_class = HouseInfoSerializer filter_backends = (DjangoFilterBackend, OrderingFilter) filterset_class = HouseInfoFilter ordering = ('price',) ordering_fields = ('price', 'area')身份认证
查看DRF中APIView类的代码可以看出,DRF默认的认证方案是 DEFAULT_AUTHENTICATION_CLASSES,如果修改authentication_classes就可以自行定制身份认证的方案。
class APIView(View):
# The following policies may be set at either globally, or per-view. renderer_classes = api_settings.DEFAULT_RENDERER_CLASSES parser_classes = api_settings.DEFAULT_PARSER_CLASSES authentication_classes = api_settings.DEFAULT_AUTHENTICATION_CLASSES throttle_classes = api_settings.DEFAULT_THROTTLE_CLASSES permission_classes = api_settings.DEFAULT_PERMISSION_CLASSES content_negotiation_class = api_settings.DEFAULT_CONTENT_NEGOTIATION_CLASS metadata_class = api_settings.DEFAULT_METADATA_CLASS versioning_class = api_settings.DEFAULT_VERSIONING_CLASS
# 此处省略下面的代码DEFAULTS = { # Base API policies 'DEFAULT_RENDERER_CLASSES': ( 'rest_framework.renderers.JSONRenderer', 'rest_framework.renderers.BrowsableAPIRenderer', ), 'DEFAULT_PARSER_CLASSES': ( 'rest_framework.parsers.JSONParser', 'rest_framework.parsers.FormParser', 'rest_framework.parsers.MultiPartParser' ), 'DEFAULT_AUTHENTICATION_CLASSES': ( 'rest_framework.authentication.SessionAuthentication', 'rest_framework.authentication.BasicAuthentication' ), 'DEFAULT_PERMISSION_CLASSES': ( 'rest_framework.permissions.AllowAny', ), 'DEFAULT_THROTTLE_CLASSES': (), 'DEFAULT_CONTENT_NEGOTIATION_CLASS': 'rest_framework.negotiation.DefaultContentNegotiation', 'DEFAULT_METADATA_CLASS': 'rest_framework.metadata.SimpleMetadata', 'DEFAULT_VERSIONING_CLASS': None,
# 此处省略下面的代码}自定义认证类,继承BaseAuthentication并重写authenticate(self, request)方法,通过请求中的userid和token来确定用户身份。如果认证成功,该方法应返回一个二元组(用户和令牌的信息),否则产生异常。也可以重写 authenticate_header(self, request)方法来返回一个字符串,该字符串将用于HTTP 401 Unauthorized响应中的WWW-Authenticate响应头的值。如果未重写该方法,那么当未经身份验证的请求被拒绝访问时,身份验证方案将返回HTTP 403 Forbidden响应。
class MyAuthentication(BaseAuthentication): """自定义用户身份认证类"""
def authenticate(self, request): try: token = request.GET['token'] or request.POST['token'] user_token = UserToken.objects.filter(token=token).first() if user_token: return user_token.user, user_token else: raise AuthenticationFailed('请提供有效的用户身份标识') except KeyError: raise AuthenticationFailed('请提供有效的用户身份标识')
def authenticate_header(self, request): pass使用自定义的认证类。
class EstateViewSet(CacheResponseMixin, ModelViewSet): # 通过queryset指定如何获取数据(资源) queryset = Estate.objects.all().select_related('district').prefetch_related('agents') # 通过serializer_class指定如何序列化数据 serializer_class = EstateSerializer # 指定根据哪些字段进行数据筛选 filter_fields = ('district', 'name') # 指定根据哪些字段对数据进行排序 ordering_fields = ('hot', ) # 指定用于进行用户身份验证的类 authentication_classes = (MyAuthentication, )说明:也可以在Django配置文件中将自定义的认证类设置为默认认证方式。
授予权限
权限检查总是在视图的最开始处运行,在任何其他代码被允许进行之前。最简单的权限是允许通过身份验证的用户访问,并拒绝未经身份验证的用户访问,这对应于dfr中的IsAuthenticated类,可以用它来取代默认的AllowAny类。权限策略可以在Django的DRF配置中用DEFAULT_PERMISSION_CLASSES全局设置。
REST_FRAMEWORK = { 'DEFAULT_PERMISSION_CLASSES': ( 'rest_framework.permissions.IsAuthenticated', )}也可以在基于APIView类的视图上设置身份验证策略。
from rest_framework.permissions import IsAuthenticatedfrom rest_framework.views import APIView
class ExampleView(APIView): permission_classes = (IsAuthenticated, ) # 此处省略其他代码或者在基于@api_view装饰器的视图函数上设置。
from rest_framework.decorators import api_view, permission_classesfrom rest_framework.permissions import IsAuthenticated
@api_view(['GET'])@permission_classes((IsAuthenticated, ))def example_view(request, format=None): # 此处省略其他代码自定义权限需要继承BasePermission并实现以下方法中的一个或两个,下面是BasePermission的代码。
@six.add_metaclass(BasePermissionMetaclass)class BasePermission(object): """ A base class from which all permission classes should inherit. """
def has_permission(self, request, view): """ Return `True` if permission is granted, `False` otherwise. """ return True
def has_object_permission(self, request, view, obj): """ Return `True` if permission is granted, `False` otherwise. """ return True如果请求被授予访问权限,则方法应该返回True,否则返False。下面的例子演示了阻止黑名单中的IP地址访问接口数据(这个在反爬虫的时候很有用哟)。
from rest_framework import permissions
class BlacklistPermission(permissions.BasePermission): """ Global permission check for blacklisted IPs. """
def has_permission(self, request, view): ip_addr = request.META['REMOTE_ADDR'] blacklisted = Blacklist.objects.filter(ip_addr=ip_addr).exists() return not blacklisted如果要实现更为完整的权限验证,可以考虑RBAC或ACL。
-
RBAC - 基于角色的访问控制,如下图所示。
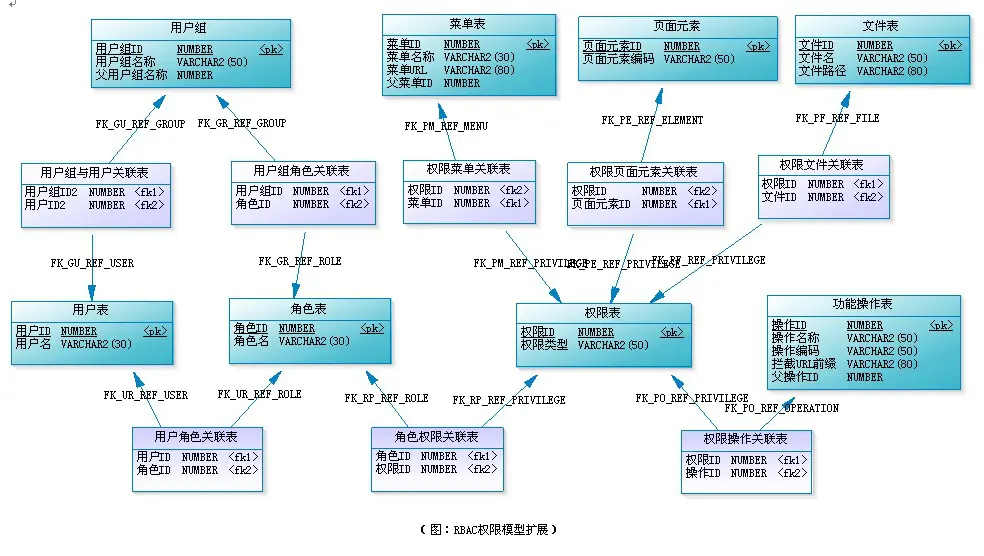
-
ACL - 访问控制列表(每个用户绑定自己的访问白名单或黑名单)。
访问限流
可以修改dfr配置的DEFAULT_THROTTLE_CLASSES 和 DEFAULT_THROTTLE_RATES两个值来设置全局默认限流策略。例如:
REST_FRAMEWORK = { 'DEFAULT_THROTTLE_CLASSES': ( 'rest_framework.throttling.AnonRateThrottle', 'rest_framework.throttling.UserRateThrottle' ), 'DEFAULT_THROTTLE_RATES': { 'anon': '3/min', 'user': '10000/day' }}DEFAULT_THROTTLE_RATES中使用的频率描述可能包括second、minute、hour或day。
如果要为接口单独设置限流,可以在每个视图或视图集上设置限流策略,如下所示:
from rest_framework.throttling import UserRateThrottlefrom rest_framework.views import APIView
class ExampleView(APIView): throttle_classes = (UserRateThrottle, ) # 此处省略下面的代码或
@api_view(['GET'])@throttle_classes([UserRateThrottle, ])def example_view(request, format=None): # 此处省略下面的代码当然也可以通过继承SimpleRateThrottle来自定义限流策略,通常需要重写allow_request和wait方法。
异步任务和计划任务
Celery的应用
Celery 是一个简单、灵活且可靠的,处理大量消息的分布式系统,并且提供维护这样一个系统的必需工具。它是一个专注于实时处理的任务队列,同时也支持任务调度。
推荐阅读:《Celery官方文档中文版》,上面有极为详细的配置和使用指南。
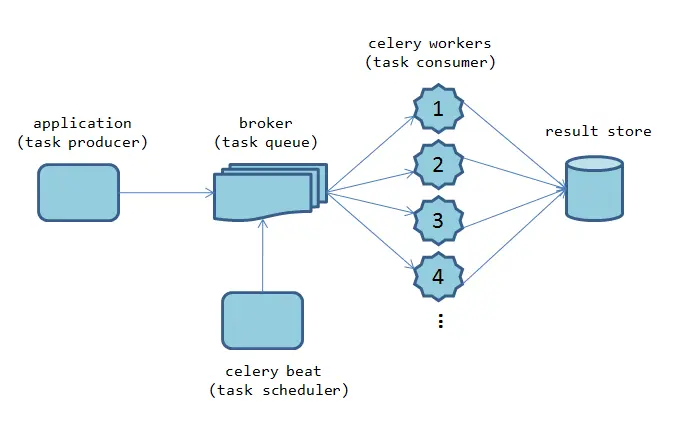
Celery是一个本身不提供队列服务,官方推荐使用RabbitMQ或Redis来实现消息队列服务,前者是更好的选择,它对AMQP(高级消息队列协议)做出了非常好的实现。
-
安装RabbitMQ。
Terminal window docker pull rabbitmqdocker run -d -p 5672:5672 --name myrabbit rabbitmqdocker container exec -it myrabbit /bin/bash -
创建用户、资源以及分配操作权限。
Terminal window rabbitmqctl add_user luohao 123456rabbitmqctl set_user_tags luohao administratorrabbitmqctl add_vhost vhost1rabbitmqctl set_permissions -p vhost1 luohao ".*" ".*" ".*" -
创建Celery实例。
# 注册环境变量os.environ.setdefault('DJANGO_SETTINGS_MODULE', '项目名.settings')# 创建Celery实例app = celery.Celery('fangtx',broker='amqp://luohao:123456@1.2.3.4:5672/vhost1')# 从项目的配置文件读取Celery配置信息# app.config_from_object('django.conf:settings')# 从指定的文件(例如celery_config.py)中读取Celery配置信息# app.config_from_object('celery_config')# 让Celery自动从参数指定的应用中发现异步任务/定时任务# app.autodiscover_tasks(['common', ])# 让Celery自动从所有注册的应用中发现异步任务/定时任务app.autodiscover_tasks(lambda: settings.INSTALLED_APPS) -
启动Celery创建woker(消息的消费者)。
Terminal window celery -A <name> worker -l debug & -
执行异步任务。
@app.taskdef send_email(from_user, to_user, cc_user, subject, content):pass# 消息的生产者send_email.delay('', [], [], '', '') -
创建定时任务。
# 配置定时任务(计划任务)app.conf.update(timezone=settings.TIME_ZONE,enable_utc=True,# 定时任务(计划任务)相当于是消息的生产者# 如果只有生产者没有消费者那么消息就会在消息队列中积压# 将来实际部署项目的时候生产者、消费者、消息队列可能都是不同节点beat_schedule={'task1': {'task': 'common.tasks.scheduled_task','schedule': crontab('*', '*', '*', '*', '*'),'args': ('...', )},},)@app.taskdef scheduled_task(*args, **kwargs):pass -
启动Celery创建执行定时任务的beat(消息的生产者)。
Terminal window celery -A <name> beat -l info -
检查消息队列状况。
Terminal window rabbitmqctl list_queues -p vhost1 -
监控Celery - 可以通过flower来对Celery进行监控。
Terminal window pip install flowercelery flower --broker=amqp://luohao:123456@120.77.222.217:5672/vhost1
其他问题
问题1:如何解决JavaScript跨域获取数据的问题?(django-cors-headers)
INSTALLED_APPS = [ 'corsheaders',]
MIDDLEWARE = [ 'corsheaders.middleware.CorsMiddleware',]
CORS_ORIGIN_ALLOW_ALL = True# 配置跨域白名单# CORS_ORIGIN_WHITELIST = ('www.abc.com', 'www.baidu.com')# CORS_ORIGIN_REGEX_WHITELIST = ('...', )# CORS_ALLOW_CREDENTIALS = True# CORS_ALLOW_METHODS = ('GET', 'POST', 'PUT', 'DELETE')问题2:网站图片(水印、剪裁)和视频(截图、水印、转码)是如何处理的?(云存储、FFmpeg)
问题3:网站如何架设(静态资源)文件系统?(FastDFS、云存储、CDN)
安全保护
问题1:什么是跨站脚本攻击(XSS),如何防范?(对提交的内容进行消毒)
问题2:什么是跨站身份伪造(CSRF),如何防范?(使用随机令牌)
问题3:什么是SQL注射攻击(SQL Injection),如何防范?(不拼接SQL语句,避免使用单引号)
问题4:什么是点击劫持攻击(Click-hacking),如何防范?(不允许<iframe>加载非同源站点内容)
Django提供的安全措施
签名数据的API
>>> from django.core.signing import Signer>>> signer = Signer()>>> value = signer.sign('hello, world!')>>> value'hello, world!:BYMlgvWMTSPLxC-DqxByleiMVXU'>>> signer.unsign(value)'hello, world!'>>>>>> signer = Signer(salt='yoursalt')>>> signer.sign('hello, world!')'hello, world!:9vEvG6EA05hjMDB5MtUr33nRA_M'>>>>>> from django.core.signing import TimestampSigner>>> signer = TimestampSigner()>>> value = signer.sign('hello, world!')>>> value'hello, world!:1fpmcQ:STwj464IFE6eUB-_-hyUVF3d2So'>>> signer.unsign(value, max_age=5)Traceback (most recent call last): File "<console>", line 1, in <module> File "/Users/Hao/Desktop/fang.com/venv/lib/python3.6/site-packages/django/core/signing.py", line 198, in unsign 'Signature age %s > %s seconds' % (age, max_age)) django.core.signing.SignatureExpired: Signature age 21.020604848861694 > 5 seconds>>> signer.unsign(value, max_age=120)'hello, world!'CSRF令牌和小工具
{% csrf_token %}- @csrf_exempt:免除令牌
- @csrf_protect:提供令牌保护
- @require_csrf_token:提供令牌保护
- @ensure_csrf_cookie:强制视图发送带令牌的cookie
说明:可以在Chrome浏览器中安装EditThisCookie插件来方便的查看Cookie。
用户敏感信息的保护
-
哈希摘要(签名)
>>> import hashlib>>>>>> md5_hasher = hashlib.md5()>>> md5_hasher.update('hello, world!'.encode())>>> md5_hasher.hexdigest()'3adbbad1791fbae3ec908894c4963870'>>>>>> sha1_hasher = hashlib.sha1()>>> sha1_hasher.update('hello, world!'.encode())>>> sha1_hasher.update('goodbye, world!'.encode())>>> sha1_hasher.hexdigest()'1f09d30c707d53f3d16c530dd73d70a6ce7596a9' -
加密和解密(对称加密和非对称加密)
Terminal window pip install pycryptoAES对称加密:
>>> from hashlib import md5>>>>>> from Crypto.Cipher import AES>>> from Crypto import Random>>>>>> key = md5(b'mysecret').hexdigest()>>> iv = Random.new().read(AES.block_size)>>> str1 = '我爱你们!'>>> str2 = AES.new(key, AES.MODE_CFB, iv).encrypt(str1)b'p\x96o\x85\x0bq\xc4-Y\xc4\xbcp\n)&'>>> str3 = AES.new(key, AES.MODE_CFB, iv).decrypt(str2).decode()'我爱你们!'RSA非对称加密:
>>> from Crypto.PublicKey import RSA>>> # 生成密钥对>>> key_pair = RSA.generate(2048)>>> # 导入公钥>>> pub_key = RSA.importKey(key_pair.publickey().exportKey())>>> # 导入私钥>>> pri_key = RSA.importKey(key_pair.exportKey())>>> # 明文>>> message1 = 'hello, world!'.encode()>>> # 加密数据>>> message2 = pub_key.encrypt(message1, None)(b'\x03\x86t\xa0\x00\xc4\xea\xd2\x80\xed\xa7YN7\x07\xff\x88\xaa\x1eW\x0cmH0\x06\xa7\'\xbc<w@q\x8b\xaf\xf7:g\x92{=\xe2E\xa5@\x1as2\xdd\xcb\x8e[\x98\x85\xdf,X\xecj.U\xd6\xa7W&u\'Uz"\x0f\x0e\\<\xa4\xfavC\x93\xa7\xbcO"\xb9a\x06]<.\xc1\r1}*\xdf\xccdqXML\x93\x1b\xe9\xda\xdf\xab|\xf8\x18\xe4\x99\xbb\x7f\x18}\xd9\x9a\x1e*J\\\xca\x1a\xd1\x85\xf7t\x81\xd95{\x19\xc9\x81\xb6^}\x9c5\xca\xfe\xcf\xc8\xd8M\x9a\x8c-\xf1t\xee\xf9\x12\x90\x01\xca\x92~\x00c5qg5g\x95&\x10\xb1\x0b\x1fo\x95\xf2\xbc\x8d\xf3f"@\xc5\x188\x0bX\x9cfo\xea\x97\x05@\xe5\xb2\xda\xb8\x97a\xa5w\xa8\x01\x9a\xa5N\xc4\x81\x8d\x0f<\x96iU\xd3\x95\xacJZs\xab_ #\xee\xf9\x0f\xf2\x12\xdb\xfc\xf8g\x18v\x02k+\xda\x16Si\xbf\xbb\xec\xf7w\x90\xde\xae\x97\t\xed{}5\xd0',)>>> # 解密数据>>> message3 = pri_key.decrypt(message2)'hello, world!'
安全相关建议
- 虽然 Django 自带了稳固的安全保护措施,但是依然要采用正确的方式部署应用程序,利用 Web 服务器、操作系统和其他组件提供的安全保护措施。
- 记得把 Python 代码放在 Web 服务器的文档根目录之外,避免代码意外泄露。
- 谨慎处理用户上传的文件。
- Django本身没有对请求次数加以限制(包括验证用户身份的请求),为了防止暴力攻击和破解,可以考虑使用具有一次消费性的验证码或对这类请求的次数进行限制。
- 将缓存系统、数据库服务器以及重要的资源服务器都放在第二级防火墙之后(不要放在DMZ)。
测试相关
测试是发现和标记缺陷的过程。所谓的缺陷是指实际结果和期望结果之间的任何差别。有的地方,测试也被认为是执行以找出错误为目的的程序的过程。 测试是为了让产品达到以下目标:
- 满足需求用户满意
- 改善产品的市场占有率
- 树立对产品的信任
- 减少开发和维护的成本
功能测试
如果一个软件单元的行为方式与它的开发规范完全一样,那么该软件单元就通过了它的功能测试。
- 白盒测试:开发人员自己实现,最基本的形式是单元测试,还有集成测试和系统测试。
- 黑盒测试:由开发团队之外的人执行,对测试代码没有可见性,将被测系统视为黑盒子。通常由测试人员或QA工程师来执行,Web应用可以通过Selenium这样的测试框架自动化实施。
性能测试
软件在高工作负载下对其响应性和健壮性展开的测试。
-
负载测试:在特定负载下执行的测试。
-
压力测试:突发条件或极限条件下的性能测试。
安全性测试
系统的敏感数据都是经过认证和授权之后才能访问。
其他测试
易用性测试 / 安装测试 / 可访问性测试
单元测试
测试函数和对象的方法(程序中最小最基本的单元)。通过对实际输出和预期输出的比对以及各种的断言条件来判定被测单元是否满足设计需求。
- 测试用例
- 测试固件 - 每次测试时都要使用的东西。
- 测试套件(测试集)- 组合了多个测试用例而构成的集合。
class UtilTest(unittest.TestCase):
def setUp(self): self.pattern = re.compile(r'\d{6}')
def test_gen_mobile_code(self): for _ in range(100): self.assertIsNotNone(self.pattern.match(gen_mobile_code()))
def test_to_md5_hex(self): md5_dict = { '123456': 'e10adc3949ba59abbe56e057f20f883e', '123123123': 'f5bb0c8de146c67b44babbf4e6584cc0', '1qaz2wsx': '1c63129ae9db9c60c3e8aa94d3e00495', } for key, value in md5_dict.items(): self.assertEqual(value, to_md5_hex(key))TestCase的断言方法:
- assertEqual / assertNotEqual
- assertTrue / assertFalse / assertIsNot
- assertRaise / assertRaiseRegexp
- assertAlmostEqual / assertNotAlmostEqual
- assertGreater / assertGreaterEqual / assertLess / assertLessEqual
- assertRegexpMatches / assertNotRegexpMatches
- assertListEqual / assertSetEqual / assertTupleEqual / assertDictEqual
可以使用nose2或pytest来辅助执行单元测试,同时通过cov-core或pytest-cov可以对测试覆度进行评估。覆盖率由百分比表示。比如测试代码执行过了程序的每一行,那么覆盖率就是100%。这种时候,几乎不会出现新程序上线后突然无法运行的尴尬情况。覆盖率不关心代码内容究竟是什么,覆盖率是用来检查“测试代码不足、测试存在疏漏”的一个指标,“测试内容是否妥当”并不归它管。
pip install nose2 pytest cov-core pytest-cov可以使用Selenium来实现Web应用的自动化测试,它还可以用于屏幕抓取与浏览器行为模拟,通过爬虫抓取页面上的动态数据也可以使用它。Selenium其实包括三个部分:
-
Selenium IDE:嵌入到浏览器的插件,可以录制和回放脚本。
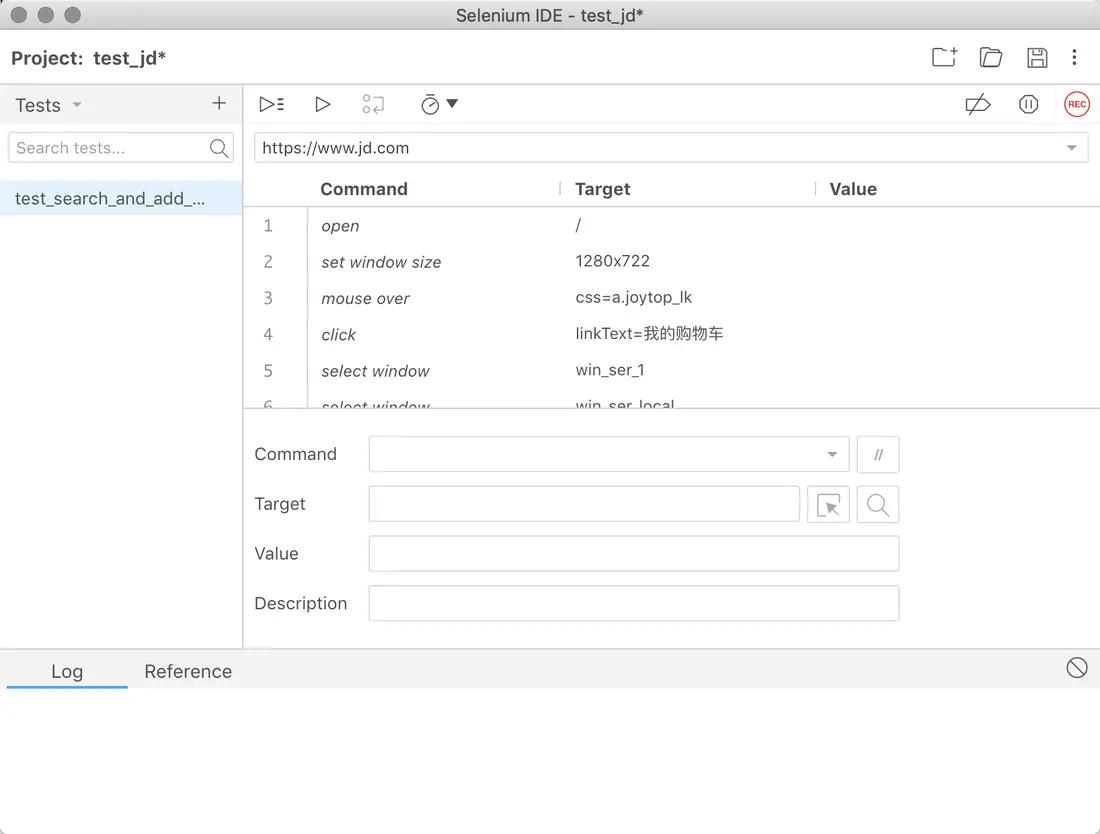
-
Selenium WebDriver:支持多种语言可以操控浏览器的API。
-
Selenium Standalone Server:Selenium Grid、远程控制、分布式部署。
pip install seleniumfrom selenium import webdriverimport pytestimport contextlib
@pytest.fixture(scope='session')def chrome(): # 设置使用无头浏览器(不会打开浏览器窗口) options = webdriver.ChromeOptions() options.add_argument('--headless') driver = webdriver.Chrome(options=options) yield driver driver.quit()
def test_baidu_index(chrome): chrome.get('https://www.baidu.com') assert chrome.title == '百度一下,你就知道'除了Selenium之外,还有一个Web自动化测试工具名叫Robot Framework。
nose2 -v -Cpytest --covRan 7 tests in 0.002s
OKName Stmts Miss Cover----------------------------------------------example01.py 15 0 100%example02.py 49 49 0%example03.py 22 22 0%example04.py 61 61 0%example05.py 29 29 0%example06.py 39 39 0%example07.py 19 19 0%example08.py 27 27 0%example09.py 18 18 0%example10.py 19 19 0%example11.py 22 22 0%example12.py 28 28 0%example13.py 28 28 0%test_ddt_example.py 18 0 100%test_pytest_example.py 11 6 45%test_unittest_example.py 22 0 100%----------------------------------------------TOTAL 427 367 14%在测试过程中需要孤立各种外部依赖(数据库、外部接口调用、时间依赖),具体又包括两个方面:
-
数据源:数据本地化 / 置于内存中 / 测试之后回滚
-
资源虚拟化:存根/桩(stub)、仿制/模拟(mock)、伪造(fake)
- stub:测试期间为提供响应的函数生成的替代品
- mock:代替实际对象(以及该对象的API)的对象
- fake:没有达到生产级别的轻量级对象
集成测试
集成多个函数或方法的输入输出的测试,测试时需要将多个测试对象组合在一起。
- 测试组件互操作性 / 需求变更测试 / 外部依赖和API / 调试硬件问题 / 在代码路径中发现异常
系统测试
对需求的测试,测试成品是否最终满足了所有需求,在客户验收项目时进行。
数据驱动测试
使用外部数据源实现对输入值与期望值的参数化,避免在测试中使用硬编码的数据。
被测函数:
def add(x, y): return x + ydata.csv文件:
3,1,20,1,-1100,50,50100,1,9915,7,8测试代码:
import csv
from unittest import TestCasefrom ddt import ddt, data, unpack
@ddtclass TestAdd(TestCase):
def load_data_from_csv(filename): data_items = [] with open(filename, 'r', newline='') as fs: reader = csv.reader(fs) for row in reader: data_items.append(list(map(int, row))) return data_items
@data(*load_data_from_csv('data.csv')) @unpack def test_add(self, result, param1, param2): self.assertEqual(result, add(param1, param2))Django中的测试
- 测试Django视图 - Django中提供的
TestCase扩展了unittest中的TestCase,绑定了一个名为client的属性,可以用来模拟浏览器发出的GET、POST、DELETE、PUT等请求。
class SomeViewTest(TestCase):
def test_example_view(self): resp = self.client.get(reverse('index')) self.assertEqual(200, resp.status_code) self.assertEqual(5, resp.context['num'])- 运行测试 - 配置测试数据库。
DATABASES = { 'default': { 'ENGINE': 'django.db.backends.mysql', 'HOST': 'localhost', 'PORT': 3306, 'NAME': 'DbName', 'USER': os.environ['DB_USER'], 'PASSWORD': os.environ['DB_PASS'], 'TEST': { 'NAME': 'DbName_for_testing', 'CHARSET': 'utf8', }, }}python manage.py testpython manage.py test commonpython manage.py test common.tests.UtilsTestpython manage.py test common.tests.UtilsTest.test_to_md5_hex- 评估测试覆盖度
pip install coveragecoverage run --source=<path1> --omit=<path2> manage.py test commoncoverage report
Name Stmts Miss Cover---------------------------------------------------common/__init__.py 0 0 100%common/admin.py 1 0 100%common/apps.py 3 3 0%common/forms.py 16 16 0%common/helper.py 32 32 0%common/middlewares.py 19 19 0%common/migrations/__init__.py 0 0 100%common/models.py 71 2 97%common/serializers.py 14 14 0%common/tests.py 14 8 43%common/urls_api.py 3 3 0%common/urls_user.py 3 3 0%common/utils.py 22 7 68%common/views.py 69 69 0%---------------------------------------------------TOTAL 267 176 34%性能测试
问题1:性能测试的指标有哪些?
-
ab( Apache Benchmark) / webbench / httpperf
Terminal window yum -y install httpdab -c 10 -n 1000 http://www.baidu.com/...Benchmarking www.baidu.com (be patient).....doneServer Software: BWS/1.1Server Hostname: www.baidu.comServer Port: 80Document Path: /Document Length: 118005 bytesConcurrency Level: 10Time taken for tests: 0.397 secondsComplete requests: 100Failed requests: 98(Connect: 0, Receive: 0, Length: 98, Exceptions: 0)Write errors: 0Total transferred: 11918306 bytesHTML transferred: 11823480 bytesRequests per second: 252.05 [#/sec] (mean)Time per request: 39.675 [ms] (mean)Time per request: 3.967 [ms] (mean, across all concurrent requests)Transfer rate: 29335.93 [Kbytes/sec] receivedConnection Times (ms)min mean[+/-sd] median maxConnect: 6 7 0.6 7 9Processing: 20 27 22.7 24 250Waiting: 8 11 21.7 9 226Total: 26 34 22.8 32 258Percentage of the requests served within a certain time (ms)50% 3266% 3475% 3480% 3490% 3695% 3998% 5199% 258100% 258 (longest request) -
mysqlslap
Terminal window mysqlslap -a -c 100 -h 1.2.3.4 -u root -pmysqlslap -a -c 100 --number-of-queries=1000 --auto-generate-sql-load-type=read -h <负载均衡服务器IP地址> -u root -pmysqlslap -a --concurrency=50,100 --number-of-queries=1000 --debug-info --auto-generate-sql-load-type=mixed -h 1.2.3.4 -u root -p -
sysbench
Terminal window sysbench --test=threads --num-threads=64 --thread-yields=100 --thread-locks=2 runsysbench --test=memory --num-threads=512 --memory-block-size=256M --memory-total-size=32G run -
JMeter
请查看《使用JMeter进行性能测试》。
-
LoadRunner / QTP
项目调试
可以使用django-debug-toolbar来辅助项目调试。
-
安装
Terminal window pip install django-debug-toolbar -
配置 - 修改settings.py。
INSTALLED_APPS = ['debug_toolbar',]MIDDLEWARE = ['debug_toolbar.middleware.DebugToolbarMiddleware',]DEBUG_TOOLBAR_CONFIG = {# 引入jQuery库'JQUERY_URL': 'https://cdn.bootcss.com/jquery/3.3.1/jquery.min.js',# 工具栏是否折叠'SHOW_COLLAPSED': True,# 是否显示工具栏'SHOW_TOOLBAR_CALLBACK': lambda x: True,} -
配置 - 修改urls.py。
if settings.DEBUG:import debug_toolbarurlpatterns.insert(0, path('__debug__/', include(debug_toolbar.urls))) -
使用 - 在页面右侧可以看到一个调试工具栏,上面包括了执行时间、项目设置、请求头、SQL、静态资源、模板、缓存、信号等调试信息,查看起来非常的方便。
-
项目上线之前,请记住去掉django-debug-toolbar相关的所有配置。
部署相关
请参考《项目部署上线和性能调优》。
性能相关
网站优化两大定律:
-
尽可能的使用缓存 - 牺牲空间换取时间(普适策略)。
-
能推迟的都推迟 - 使用消息队列将并行任务串行来缓解服务器压力。
- 服务器CPU利用率出现瞬时峰值 - 削峰(CPU利用率平缓的增长)
- 上下游节点解耦合(下订单和受理订单的系统通常是分离的)
Django框架
-
配置缓存来缓解数据库的压力,并有合理的机制应对缓存穿透和缓存雪崩。
-
开启模板缓存来加速模板的渲染。
TEMPLATES = [{'BACKEND': 'django.template.backends.django.DjangoTemplates','DIRS': [os.path.join(BASE_DIR, 'templates'), ],# 'APP_DIRS': True,'OPTIONS': {'context_processors': ['django.template.context_processors.debug','django.template.context_processors.request','django.contrib.auth.context_processors.auth','django.contrib.messages.context_processors.messages',],'loaders': [('django.template.loaders.cached.Loader', ['django.template.loaders.filesystem.Loader','django.template.loaders.app_directories.Loader',], ),],},},] -
用惰性求值、迭代器、
defer()、only()等缓解内存压力。 -
用
select_related()和prefetch_related()执行预加载避免“1+N查询问题”。
数据库
-
用ID生成器代替自增主键(性能更好、适用于分布式环境)。
-
自定义ID生成器 - snowflake
-
UUID
>>> my_uuid = uuid.uuid1()>>> my_uuidUUID('63f859d0-a03a-11e8-b0ad-60f81da8d840')>>> my_uuid.hex'63f859d0a03a11e8b0ad60f81da8d840' -
-
避免不必要的外键列上的约束(除非必须保证参照完整性),更不要使用触发器之类的机制。
-
使用索引来优化查询性能(索引放在要用于查询的字段上)。InnoDB用的是BTREE索引,使用>、<、>=、<=、BETWEEN或者LIKE ‘pattern’(pattern不以通配符开头)时都可以用到索引。因为建立索引需要额外的磁盘空间,而主键上是有默认的索引,所以主键要尽可能选择较短的数据类型来减少磁盘占用,提高索引的缓存效果。
create index idx_goods_name on tb_goods (gname(10));-- 无法使用索引select * from tb_goods where gname like '%iPhone%';-- 可以使用索引select * from tb_goods where gname like 'iPhone%';# 无法使用索引Goods.objects.filter(name_icontains='iPhone')# 可以使用索引Goods.objects.filter(name__istartswith='iPhone'); -
使用存储过程(存储在服务器端编译过的一组SQL语句)。
drop procedure if exists sp_avg_sal_by_dept;create procedure sp_avg_sal_by_dept(deptno integer, out avg_sal float)beginselect avg(sal) into avg_sal from TbEmp where dno=deptno;end;call sp_avg_sal_by_dept(10, @a);select @a;>>> from django.db import connection>>> cursor = connection.cursor()>>> cursor.callproc('sp_avg_sal_by_dept', (10, 0))>>> cursor.execute('select @_sp_avg_sal_by_dept_1')>>> cursor.fetchone()(2675.0,) -
使用数据分区。通过分区可以存储更多的数据、优化查询更大的吞吐量、可以快速删除过期的数据。关于这个知识点可以看看MySQL的官方文档。
- RANGE分区:基于连续区间范围,把数据分配到不同的分区。
- LIST分区:基于枚举值的范围,把数据分配到不同的分区。
- HASH分区 / KEY分区:基于分区个数,把数据分配到不同的分区。
CREATE TABLE tb_emp (eno INT NOT NULL,ename VARCHAR(20) NOT NULL,job VARCHAR(10) NOT NULL,hiredate DATE NOT NULL,dno INT NOT NULL)PARTITION BY HASH(dno)PARTITIONS 4;CREATE TABLE tb_emp (eno INT NOT NULL,ename VARCHAR(20) NOT NULL,job VARCHAR(10) NOT NULL,hiredate DATE NOT NULL,dno INT NOT NULL)PARTITION BY RANGE( YEAR(hiredate) ) (PARTITION p0 VALUES LESS THAN (1960),PARTITION p1 VALUES LESS THAN (1970),PARTITION p2 VALUES LESS THAN (1980),PARTITION p3 VALUES LESS THAN (1990),PARTITION p4 VALUES LESS THAN MAXVALUE); -
使用
explain来分析查询性能 - 执行计划。explain select * from ...;explain结果解析:- select_type:表示select操作的类型,常见的值有SIMPLE(简单查询,没有使用子查询或者表连接查询)、PRIMARY(主查询,外层的查询)、UNION(并集操作中的第二个或者后面的查询)、SUBQUERY(子查询中的第一个SELECT)等。
- table:输出结果的表。
- type:MySQL在表中找到所需行的方式,也称为访问类型,常见的值有:
- ALL:全表扫描(遍历全表找到匹配的行)
- index:索引全扫描(遍历整个索引)
- range:索引范围扫描
- ref:非唯一索引扫描或唯一索引的前缀扫描
- eq_ref:唯一索引扫描
- const / system:表中最多有一行匹配
- NULL:不用访问表或者索引
- possible_keys:查询时可能用到的索引。
- key:实际使用的索引。
- key_len:使用到索引字段的长度。
- rows:扫描行的数量。
- Extra:额外的信息(执行情况的说明或描述)。
说明:关于MySQL更多的知识尤其是性能调优和运维方面的内容,推荐大家阅读网易出品的《深入浅出MySQL(第2版)》,网易出品必属精品。
-
使用慢查询日志来发现性能低下的查询。
mysql> show variables like 'slow_query%';+---------------------------+----------------------------------+| Variable_name | Value |+---------------------------+----------------------------------+| slow_query_log | OFF || slow_query_log_file | /mysql/data/localhost-slow.log |+---------------------------+----------------------------------+mysql> show variables like 'long_query_time';+-----------------+-----------+| Variable_name | Value |+-----------------+-----------+| long_query_time | 10.000000 |+-----------------+-----------+mysql> set global slow_query_log='ON';mysql> set global long_query_time=1;[mysqld]slow_query_log=ONslow_query_log_file=/usr/local/mysql/data/slow.loglong_query_time=1
96 软件测试和自动化测试
软件测试概述
软件测试是一种用来促进鉴定软件的正确性、完整性、安全性和品质的过程,也就是在规定的条件下对程序进行操作以发现程序中的错误,衡量软件的品质并对其是否能满足设计要求进行评估的过程。
测试的方法
黑盒测试:测试应用程序的功能,而不是其内部结构或运作。测试者不需具备应用程序的代码、内部结构和编程语言的专门知识。测试者只需知道什么是系统应该做的事,即当键入一个特定的输入,可得到一定的输出。测试案例是依应用系统应该做的功能,照规范、规格或要求等设计。测试者选择有效输入和无效输入来验证是否正确的输出。此测试方法可适合大部分的软件测试,例如集成测试和系统测试。
白盒测试:测试应用程序的内部结构或运作,而不是测试应用程序的功能(即黑箱测试)。在白箱测试时,以编程语言的角度来设计测试案例。测试者输入数据验证数据流在程序中的流动路径,并确定适当的输出,类似测试电路中的节点。
由于时间和成本的约束,软件测试中一个最为关键的问题就是:“在所有可能的测试用例中,哪个子集能发现最多的错误?”。所以在设计测试用例时,白盒测试看重程序逻辑覆盖的程度(语句覆盖、条件覆盖、分支覆盖),黑盒测试可以使用等价类划分、边界值分析、因果图分析、错误猜测等方法来设计测试用例。
测试的种类(阶段)
单元测试:对软件组成单元进行测试,其目的是检验软件基本组成单位的正确性,测试的对象是软件设计的最小单位 - 函数。
集成测试:将程序模块采用适当的集成策略组装起来,对系统的接口及集成后的功能进行正确性检测的测试工作。其主要目的是检查软件单位之间的接口是否正确,集成测试的对象是已经经过单元测试的模块。
系统测试:系统测试主要包括功能测试、界面测试、可靠性测试、易用性测试、性能测试。
回归测试:为了检测代码修改而引入的错误所进行的测试活动。回归测试是软件维护阶段的重要工作,有研究表明,回归测试带来的耗费占软件生命周期的1/3总费用以上。
测试驱动开发(敏捷测试)
测试驱动开发包括以下三个步骤:
- 为未实现的新功能或者改进编写自动化测试。
- 提供通过所有定义的测试的最小代码量。
- 重构代码以满足所需的质量标准。
测试驱动开发的好处在于可以有效的防止软件回归以及提供更有质量的代码。还有就是验收测试应该由客户来进行,客户通过对使用场景来设计验收测试,对应用程序是否满足他们的要求进行客观、公正的确认。能够通过单元测试、甚至是系统测试的功能未必能够通过客户的验收测试。
互联网应用和移动应用的测试
互联网应用的测试策略:
- 表示层测试(内容测试、站点结构测试、用户环境(浏览器、操作系统等))
- 业务层测试(性能、数据验证、事务、外部服务)
- 持久层测试(响应时间、数据完整性、容错性)
移动应用的测试策略:
- 真机测试
- 基于模拟器的测试
单元(模块)测试
Python的标准库里有为编写单元测试而准备的unittest模块,执行测试时建议使用pytest或nose2。pytest是一款能够自动搜索并执行测试的测试执行工具,并且会输出详细的错误报告。关于单元测试可以看看《Python必会的单元测试框架 - unittest》。
可以安装testfixtures库来辅助单元测试,它整合了多种典型配置器,提供了生成目录、更改系统日期、生成mock对象的功能模块,这些模块能够帮助我们将单元测试与单元测试所依赖的环境分离开。mock 是将测试对象所依赖的对象替换为虚拟对象的库,在测试的时候,我们可以为虚拟对象指定其在被调用时的返回值以及是否发生异常等。
tox能便捷地为我们准备好执行测试所需的环境。tox会在多个virtualenv环境中搭建测试 环境,然后在这些环境中执行测试并显示结果。它能够把测试工具的选项及环境变量等内容统 一起来,所以我们只需执行tox命令即能轻松完成所需的测试。
自动化测试
UI自动化测试
桌面端 - PyAutoGui
移动端 - Appnium
Web端 - Selenium
Selenium是实现Web应用程序的功能测试以及集成测试自动化的浏览器驱动测试工具群。和使用浏览器的用户相同,Selenium可以在浏览器进行的鼠标操作、在表单中输入文字、验证表单的值等,利用这一点就可以将手动操作变成自动化操作。
- Selenium优点
- 自动化测试用例制作简单。Selenium提供了Selenium IDE工具,该工具可以捕获鼠标、键盘的操作,然后通过重放功能来重复这些操作,这样就可以简单的制作测试用例。
- 支持多种浏览器和操作系统。
- Selenium的组件
-
与持续集成工具协作
持续集成指的是频繁的将代码集成到主干。它的好处主要有两个:
- 快速发现错误。每完成一点更新,就集成到主干,可以快速发现错误,定位错误也比较容易。
- 防止分支大幅偏离主干。如果不是经常集成,主干又在不断更新,会导致以后集成的难度变大,甚至难以集成。
持续集成的目的,就是让产品可以快速迭代,同时还能保持高质量。它的核心措施是代码集成到主干之前,必须通过自动化测试,只要有一个测试用例失败,就不能集成。编程大师Martin Fowler曾经说过:“持续集成并不能消除Bug,而是让它们非常容易发现和改正。”
可以在Jenkins中安装“Seleniumhq Plugin”插件,这样就可以将Selenium IDE制作的测试用例保存为HTML格式并提供给Jenkins来使用,基本步骤是:
-
在执行测试的机器上,从版本控制系统中下载测试套件和测试用例。
-
在执行测试的机器上下载Selenium Server。
-
从Jenkins的“系统管理”中选择“插件管理”来安装“Seleniumhq Plugin”。
-
在Jenkins的“系统管理”中选择“系统设置”并配置“Selenium Remote Control”下的“HTMLSuite Runner”。
-
新建测试用的Jenkins任务并进行配置,配置的内容包括:浏览器、起始URL、测试套件和测试结果输出文件。
配置完成后,就可以执行Jenkins的“立即构建”了。
除了Selenium之外,WebTest、Splinter和RobotFramework也是Web端测试的选择,其中WebTest可以对WSGI应用执行模拟请求并获取结果,基本上所有WSGI应用的测试都可以用它;Splinter是对Selenium的二次封装,使用上更加方便简单。
接口测试自动化测试
其他方面的自动化测试
测试相关工具
- PostMan
- AB
- JMeter
- LoadRunner
- Benchmark Factory
- WAS
97 电商网站技术要点剖析
商业模式
- B2B - 商家对商家,交易双方都是企业(商家),最典型的案例就是阿里巴巴。
- C2C - 个人对个人,例如:淘宝、人人车。
- B2C - 商家对个人,例如:唯品会,聚美优品。
- C2B - 个人对商家,先有消费者提出需求,后有商家按需求组织生产,例如: 尚品宅配。
- O2O - 线上到线下,将线下的商务机会与互联网结合,让互联网成为线下交易的平台,例如:美团外卖、饿了么。
- B2B2C - 商家对商家对个人,例如:天猫、京东。
需求要点
- 用户端
-
首页(商品分类、广告轮播、滚动快讯、瀑布加载、推荐、折扣、热销、……)
-
用户(登录(第三方登录)、注册、注销、自服务(个人信息、浏览历史、收货地址、……))
-
商品(分类、列表、详情、搜索、热门搜索、搜索历史、添加到购物车、收藏、关注、评论、……)
-
购物车(查看、编辑(修改数量、删除商品、清空))
-
订单(提交订单(支付)、历史订单、订单详情、订单评价、……)
-
- 管理端
- 核心业务实体的CRUD
- 定时任务(周期性和非周期性,如处理未支付订单、采集数据对异常事件报警、……)
- 报表功能(导入导出Excel、PDF等以及前端ECharts统计图表展示)
- 权限控制(RBAC、白名单、黑名单、……)
- 业务流转(如发起退款流程,常用流程引擎有:Activity、Airflow、Spiff等)
- 三方服务(接入地图、短信、物流、支付、实名认证、天气、监控、云存储、……)
物理模型设计
首先要搞清楚两个概念:SPU(Standard Product Unit)和SKU(Stock Keeping Unit)。
- SPU:iPhone 6s
- SKU:iPhone 6s 64G 土豪金
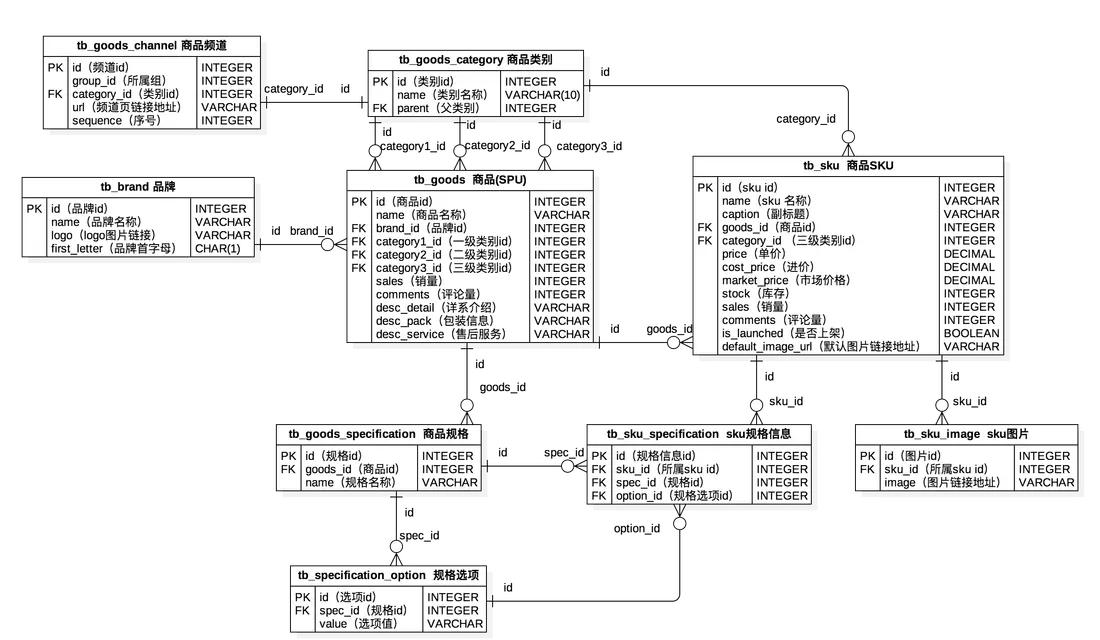
第三方登录
第三方登录是指利用第三方网站(通常是知名社交网站)的账号进行登录验证(主要是通过知名第三方网站获取到用户相关信息),比如国内的 QQ、微博,国外的Google、Facebook等。第三方登录大部分都是使用OAuth协议,它是一个关于授权的开放网络标准(数据的所有者告诉系统,同意授权第三方应用进入系统,获取这些数据。系统从而产生一个短期的进入令牌,用来代替密码,供第三方应用使用),得到了广泛的应用,目前通常使用的是2.0版本。关于OAuth的基础知识,可以阅读阮一峰老师的《理解OAuth 2.0》。关于令牌和密码的区别,我们可以简单总结出以下三点差异:
- 令牌是短期的,到期会自动失效,用户自己无法修改。密码一般长期有效,用户不修改,就不会发生变化。
- 令牌可以被数据所有者撤销,会立即失效。以上例而言,屋主可以随时取消快递员的令牌。密码一般不允许被他人撤销。
- 令牌有权限范围(scope),比如只能进小区的二号门。对于网络服务来说,只读令牌就比读写令牌更安全。密码一般是完整权限。
所以,通过令牌既可以让第三方应用获得权限,同时又随时可控,不会危及系统安全。这就是OAuth协议的优势。
OAuth 2.0授权流程
- 用户打开客户端以后,客户端要求用户(资源所有者)给予授权。
- 用户(资源所有者)同意给予客户端授权。
- 客户端使用上一步获得的授权,向认证服务器申请访问令牌。
- 认证服务器对客户端进行认证以后,发放访问令牌。
- 客户端使用访问令牌向资源服务器申请获取资源。
- 资源服务器确认访问令牌无误,同意向客户端开放资源。
如果使用微博登录进行接入,其具体步骤可以参考微博开放平台上的“微博登录接入”文档。使用QQ登录进行接入,需要首先注册成为QQ互联开发者并通过审核,具体的步骤可以参考QQ互联上的“接入指南”,具体的步骤可以参考“网站开发流程”。
提示:在Gitbook上面有一本名为《Django博客入门》的书以Github为例介绍了第三方账号登录,有兴趣的可以自行阅读。
通常电商网站在使用第三方登录时,会要求与网站账号进行绑定或者根据获取到的第三方账号信息(如:手机号)自动完成账号绑定。
缓存预热和查询缓存
缓存预热
所谓缓存预热,是指在启动服务器时将数据提前加载到缓存中,为此可以在Django应用的apps.py模块中编写AppConfig的子类并重写ready()方法,代码如下所示。
import pymysql
from django.apps import AppConfigfrom django.core.cache import cache
SELECT_PROVINCE_SQL = 'select distid, name from tb_district where pid is null'
class CommonConfig(AppConfig): name = 'common'
def ready(self): conn = pymysql.connect(host='1.2.3.4', port=3306, user='root', password='pass', database='db', charset='utf8', cursorclass=pymysql.cursors.DictCursor) try: with conn.cursor() as cursor: cursor.execute(SELECT_PROVINCE_SQL) provinces = cursor.fetchall() cache.set('provinces', provinces) finally: conn.close()接下来,还需要在应用的__init__.py中编写下面的代码。
default_app_config = 'common.apps.CommonConfig'或者在项目的settings.py文件中注册应用。
INSTALLED_APPS = [ ... 'common.apps.CommonConfig', ...]查询缓存
自定义装饰器实现查询结果的缓存。
from pickle import dumps, loads
from django.core.cache import caches
MODEL_CACHE_KEY = 'project:modelcache:%s'
def my_model_cache(key, section='default', timeout=None): """实现模型缓存的装饰器"""
def wrapper1(func):
def wrapper2(*args, **kwargs): real_key = '%s:%s' % (MODEL_CACHE_KEY % key, ':'.join(map(str, args))) serialized_data = caches[section].get(real_key) if serialized_data: data = loads(serialized_data) else: data = func(*args, **kwargs) cache.set(real_key, dumps(data), timeout=timeout) return data
return wrapper2
return wrapper1@my_model_cache(key='provinces')def get_all_provinces(): return list(Province.objects.all())购物车实现
问题一:已登录用户的购物车放在哪里?未登录用户的购物车放在哪里?
class CartItem(object): """购物车中的商品项"""
def __init__(self, sku, amount=1, selected=False): self.sku = sku self.amount = amount self.selected = selected
@property def total(self): return self.sku.price * self.amount
class ShoppingCart(object): """购物车"""
def __init__(self): self.items = {} self.index = 0
def add_item(self, item): if item.sku.id in self.items: self.items[item.sku.id].amount += item.amount else: self.items[item.sku.id] = item
def remove_item(self, sku_id): if sku_id in self.items: self.items.remove(sku_id)
def clear_all_items(self): self.items.clear()
@property def cart_items(self): return self.items.values()
@property def cart_total(self): total = 0 for item in self.items.values(): total += item.total return total已登录用户的购物车可以放在数据库中(可以先在Redis中缓存);未登录用户的购物车可以保存在Cookie、localStorage或sessionStorage中(减少服务器端内存开销)。
{ '1001': {sku: {...}, 'amount': 1, 'selected': True}, '1002': {sku: {...}, 'amount': 2, 'selected': False}, '1003': {sku: {...}, 'amount': 3, 'selected': True},}request.get_signed_cookie('cart')
cart_base64 = base64.base64encode(pickle.dumps(cart))response.set_signed_cookie('cart', cart_base64)问题二:用户登录之后,如何合并购物车?(目前电商应用的购物车几乎都做了持久化处理,主要是方便在多个终端之间共享数据)
集成支付功能
问题一:支付信息如何持久化?(必须保证每笔交易都有记录)
问题二:如何接入支付宝?(接入其他平台基本类似)
配置文件:
ALIPAY_APPID = '......'ALIPAY_URL = 'https://openapi.alipaydev.com/gateway.do'ALIPAY_DEBUG = False获得支付链接(发起支付):
# 创建调用支付宝的对象alipay = AliPay( # 在线创建应用时分配的ID appid=settings.ALIPAY_APPID, app_notify_url=None, # 自己应用的私钥 app_private_key_path=os.path.join( os.path.dirname(os.path.abspath(__file__)), 'keys/app_private_key.pem'), # 支付宝的公钥 alipay_public_key_path=os.path.join( os.path.dirname(os.path.abspath(__file__)), 'keys/alipay_public_key.pem'), sign_type='RSA2', debug=settings.ALIPAY_DEBUG)# 调用获取支付页面操作order_info = alipay.api_alipay_trade_page_pay( out_trade_no='...', total_amount='...', subject='...', return_url='http://...')# 生成完整的支付页面URLalipay_url = settings.ALIPAY_URL + '?' + order_inforeturn JsonResponse({'alipay_url': alipay_url})通过上面返回的链接可以进入支付页面,支付完成后会自动跳转回上面代码中设定好的项目页面,在该页面中可以获得订单号(out_trade_no)、支付流水号(trade_no)、交易金额(total_amount)和对应的签名(sign)并请求后端验证和保存交易结果,代码如下所示:
# 创建调用支付宝的对象alipay = AliPay( # 在线创建应用时分配的ID appid=settings.ALIPAY_APPID, app_notify_url=None, # 自己应用的私钥 app_private_key_path=os.path.join( os.path.dirname(os.path.abspath(__file__)), 'keys/app_private_key.pem'), # 支付宝的公钥 alipay_public_key_path=os.path.join( os.path.dirname(os.path.abspath(__file__)), 'keys/alipay_public_key.pem'), sign_type='RSA2', debug=settings.ALIPAY_DEBUG)# 请求参数(假设是POST请求)中包括订单号、支付流水号、交易金额和签名params = request.POST.dict()# 调用验证操作if alipay.verify(params, params.pop('sign')): # 对交易进行持久化操作支付宝的支付API还提供了交易查询、交易结算、退款、退款查询等一系列的接口,可以根据业务需要进行调用,此处不再进行赘述。
秒杀和超卖
- 秒杀:秒杀是通常意味着要在很短的时间处理极高的并发,系统在短时间需要承受平时百倍以上的流量,因此秒杀架构是一个比较复杂的问题,其核心思路是流量控制和性能优化,需要从前端(通过JavaScript实现倒计时、避免重复提交和限制频繁刷新)到后台各个环节的配合。流量控制主要是限制只有少部分流量进入服务后端(毕竟最终只有少部分用户能够秒杀成功),同时在物理架构上使用缓存(一方面是因为读操作多写操作少;另外可以将库存放在Redis中,利用DECR原语实现减库存;同时也可以利用Redis来进行限流,道理跟限制频繁发送手机验证码是一样的)和消息队列(消息队列最为重要的作用就是“削峰”和“上下游节点解耦合”)来进行优化;此外还要采用无状态服务设计,这样才便于进行水平扩展(通过增加设备来为系统扩容)。
- 超卖现象:比如某商品的库存为1,此时用户1和用户2并发购买该商品,用户1提交订单后该商品的库存被修改为0,而此时用户2并不知道的情况下提交订单,该商品的库存再次被修改为-1这就是超卖现象。解决超卖现象有三种常见的思路:
- 悲观锁控制:查询商品数量的时候就用
select ... for update对数据加锁,这样的话用户1查询库存时,用户2因无法读取库存数量被阻塞,直到用户1提交或者回滚了更新库存的操作后才能继续,从而解决了超卖问题。但是这种做法对并发访问量很高的商品来说性能太过糟糕,实际开发中可以在库存小于某个值时才考虑加锁,但是总的来说这种做法不太可取。 - 乐观锁控制:查询商品数量不用加锁,更新库存的时候设定商品数量必须与之前查询数量相同才能更新,否则说明其他事务已经更新了库存,必须重新发出请求。
- 尝试减库存:将上面的查询(
select)和更新(update)操作合并为一条SQL操作,更新库存的时候,在where筛选条件中加上库存>=购买数量或库存-购买数量>=0的条件,这种做法要求事务隔离级别为读提交(read committed)。
- 悲观锁控制:查询商品数量的时候就用
提示:有兴趣的可以自己在知乎上看看关于这类问题的讨论。
静态资源管理
静态资源的管理可以自己架设文件服务器或者分布式文件服务器(FastDFS),但是一般的项目中没有必要这样做而且效果未必是最好的,我们建议使用云存储服务来管理网站的静态资源,国内外的云服务提供商如亚马逊、阿里云、七牛、LeanCloud、Bmob等都提供了非常优质的云存储服务,而且价格也是一般公司可以接受的,具体的操作可以参考官方文档,例如:阿里云的对象存储 OSS开发人员指南。
全文检索
方案选择
- 使用数据库的模糊查询功能 - 效率低,每次需要全表扫描,不支持分词。
- 使用数据库的全文检索功能 - MySQL 5.6以前只适用于MyISAM引擎,检索操作和其他的DML操作耦合在数据库中,可能导致检索操作非常缓慢,数据量达到百万级性能显著下降,查询时间很长。
- 使用开源搜索引擎 - 索引数据和原始数据分离,可以使用ElasticSearch或Solr来提供外置索引服务,如果不考虑高并发的全文检索需求,纯Python的Whoosh也可以考虑。
ElasticSearch
ElasticSearch既是一个分布式文档数据库又是一个高可扩展的开源全文搜索和分析引擎,它允许存储、搜索和分析大量的数据,并且这个过程是近实时的。它通常被用作底层引擎和技术,为复杂的搜索功能和要求提供动力,大家熟知的维基百科、Stack-Overflow、Github都使用了ElasticSearch。
ElasticSearch的底层是开源搜索引擎Lucene,但是直接用Lucene会非常麻烦,必须自己编写代码去调用它的接口而且只支持Java语言。ElasticSearch相当于对Lucene进行了一次全面的封装,提供了REST风格的API接口,通过基于HTTP协议的访问方式屏蔽了编程语言的差异。ElasticSearch会为数据构建倒排索引,但是ElasticSearch内置的分词器对中文分词的支持几乎为零,因此需要通过安装elasticsearch-analysis-ik插件来提供中文分词服务。
ElasticSearch的安装和配置可以参考《ElasticSearch之Docker安装》。除了ElasticSearch之外,也可以使用Solr、Whoosh等来提供搜索引擎服务,基本上Django项目中可以考虑如下几种方案:
- haystack(django-haystack / drf-haystack) + whoosh + Jieba
- haystack (django-haystack / drf-haystack)+ elasticsearch
- requests + elasticsearch
- django-elasticsearch-dsl
####安装和使用ElasticSearch
-
使用Docker安装ElasticSearch。
Terminal window docker pull elasticsearch:7.6.0docker run -d -p 9200:9200 -p 9300:9300 -e "discovery.type=single-node" -e ES_JAVA_OPTS="-Xms512m -Xmx512m" --name es elasticsearch:7.6.0说明:上面创建容器时通过
-e参数指定了使用单机模式和Java虚拟机最小最大可用堆空间的大小,堆空间大小可以根据服务器实际能够提供给ElasticSearch的内存大小来决定,默认为2G。 -
创建数据库。
请求:PUT -
http://1.2.3.4:9200/demo/响应:
{"acknowledged": true,"shards_acknowledged": true,"index": "demo"} -
查看创建的数据库。
请求:GET -
http://1.2.3.4:9200/demo/响应:
{"demo": {"aliases": {},"mappings": {},"settings": {"index": {"creation_date": "1552213970199","number_of_shards": "5","number_of_replicas": "1","uuid": "ny3rCn10SAmCsqW6xPP1gw","version": {"created": "6050399"},"provided_name": "demo"}}}} -
插入数据。
请求:POST -
http://1.2.3.4:9200/demo/goods/1/请求头:Content-Type: application/json
参数:
{"no": "5089253","title": "Apple iPhone X (A1865) 64GB 深空灰色 移动联通电信4G手机","brand": "Apple","name": "Apple iPhone X","product": "中国大陆","resolution": "2436 x 1125","intro": "一直以来,Apple都心存一个设想,期待能够打造出这样一部iPhone:它有整面屏幕,能让你在使用时,完全沉浸其中,仿佛忘了它的存在。它是如此智能,哪怕轻轻一瞥,都能得到它心有灵犀的回应。而这个设想,终于随着iPhone X的到来成为了现实。现在,就跟未来见个面吧。"}响应:
{"_index": "demo","_type": "goods","_id": "1","_version": 4,"result": "created","_shards": {"total": 2,"successful": 1,"failed": 0},"_seq_no": 3,"_primary_term": 1} -
删除数据。
请求:DELETE -
http://1.2.3.4:9200/demo/goods/1/响应:
{"_index": "demo","_type": "goods","_id": "1","_version": 2,"result": "deleted","_shards": {"total": 2,"successful": 1,"failed": 0},"_seq_no": 1,"_primary_term": 1} -
更新数据。
请求:PUT -
http://1.2.3.4:9200/demo/goods/1/_update请求头:Content-Type: application/json
参数:
{"doc": {"no": "5089253","title": "Apple iPhone X (A1865) 64GB 深空灰色 移动联通电信4G手机","brand": "Apple(苹果)","name": "Apple iPhone X","product": "美国","resolution": "2436 x 1125","intro": "一直以来,Apple都心存一个设想,期待能够打造出这样一部iPhone:它有整面屏幕,能让你在使用时,完全沉浸其中,仿佛忘了它的存在。它是如此智能,哪怕轻轻一瞥,都能得到它心有灵犀的回应。而这个设想,终于随着iPhone X的到来成为了现实。现在,就跟未来见个面吧。"}}响应:
{"_index": "demo","_type": "goods","_id": "1","_version": 10,"result": "updated","_shards": {"total": 2,"successful": 1,"failed": 0},"_seq_no": 9,"_primary_term": 1} -
查询数据。
请求:GET -
http://1.2.3.4:9200/demo/goods/1/响应:
{"_index": "demo","_type": "goods","_id": "1","_version": 10,"found": true,"_source": {"doc": {"no": "5089253","title": "Apple iPhone X (A1865) 64GB 深空灰色 移动联通电信4G手机","brand": "Apple(苹果)","name": "Apple iPhone X","product": "美国","resolution": "2436 x 1125","intro": "一直以来,Apple都心存一个设想,期待能够打造出这样一部iPhone:它有整面屏幕,能让你在使用时,完全沉浸其中,仿佛忘了它的存在。它是如此智能,哪怕轻轻一瞥,都能得到它心有灵犀的回应。而这个设想,终于随着iPhone X的到来成为了现实。现在,就跟未来见个面吧。"}}}
配置中文分词和拼音插件
-
进入Docker容器的plugins目录。
Terminal window docker exec -it es /bin/bash -
下载和ElasticSearch版本对应的ik和pinyin插件。
Terminal window yum install -y wgetcd plugins/mkdir ikcd ikwget https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.6.0/elasticsearch-analysis-ik-7.6.0.zipunzip elasticsearch-analysis-ik-7.6.0.ziprm -f elasticsearch-analysis-ik-7.6.0.zipcd ..mkdir pinyincd pinyinwget https://github.com/medcl/elasticsearch-analysis-pinyin/releases/download/v7.6.0/elasticsearch-analysis-pinyin-7.6.0.zipunzip elasticsearch-analysis-pinyin-7.6.0.ziprm -f elasticsearch-analysis-pinyin-7.6.0.zip -
退出容器,重启ElasticSearch。
Terminal window docker restart es -
测试中文分词效果。
请求:POST -
http://1.2.3.4:9200/_analyze请求头:Content-Type: application/json
参数:
{"analyzer": "ik_smart","text": "中国男足在2022年卡塔尔世界杯预选赛中勇夺小组最后一名"}响应:
{"tokens": [{"token": "中国","start_offset": 0,"end_offset": 2,"type": "CN_WORD","position": 0},{"token": "男足","start_offset": 2,"end_offset": 4,"type": "CN_WORD","position": 1},{"token": "在","start_offset": 4,"end_offset": 5,"type": "CN_CHAR","position": 2},{"token": "2022年","start_offset": 5,"end_offset": 10,"type": "TYPE_CQUAN","position": 3},{"token": "卡塔尔","start_offset": 10,"end_offset": 13,"type": "CN_WORD","position": 4},{"token": "世界杯","start_offset": 13,"end_offset": 16,"type": "CN_WORD","position": 5},{"token": "预选赛","start_offset": 16,"end_offset": 19,"type": "CN_WORD","position": 6},{"token": "中","start_offset": 19,"end_offset": 20,"type": "CN_CHAR","position": 7},{"token": "勇夺","start_offset": 20,"end_offset": 22,"type": "CN_WORD","position": 8},{"token": "小组","start_offset": 22,"end_offset": 24,"type": "CN_WORD","position": 9},{"token": "最后","start_offset": 24,"end_offset": 26,"type": "CN_WORD","position": 10},{"token": "一名","start_offset": 26,"end_offset": 28,"type": "CN_WORD","position": 11}]} -
测试拼音分词效果。
请求:POST -
http://1.2.3.4:9200/_analyze请求头:Content-Type: application/json
参数:
{"analyzer": "pinyin","text": "张学友"}响应:
{"tokens": [{"token": "zhang","start_offset": 0,"end_offset": 0,"type": "word","position": 0},{"token": "zxy","start_offset": 0,"end_offset": 0,"type": "word","position": 0},{"token": "xue","start_offset": 0,"end_offset": 0,"type": "word","position": 1},{"token": "you","start_offset": 0,"end_offset": 0,"type": "word","position": 2}]}
全文检索功能
可以通过GET或者POST请求进行搜索,下面演示了搜索有“未来”关键词商品。
-
GET -
http://120.77.222.217:9200/demo/goods/_search?q=未来注意:URL中的中文应该要处理成百分号编码。
{"took": 19,"timed_out": false,"_shards": {"total": 5,"successful": 5,"skipped": 0,"failed": 0},"hits": {"total": 2,"max_score": 0.73975396,"hits": [{"_index": "demo","_type": "goods","_id": "1","_score": 0.73975396,"_source": {"doc": {"no": "5089253","title": "Apple iPhone X (A1865) 64GB 深空灰色 移动联通电信4G手机","brand": "Apple(苹果)","name": "Apple iPhone X","product": "美国","resolution": "2436*1125","intro": "一直以来,Apple都心存一个设想,期待能够打造出这样一部iPhone:它有整面屏幕,能让你在使用时,完全沉浸其中,仿佛忘了它的存在。它是如此智能,哪怕轻轻一瞥,都能得到它心有灵犀的回应。而这个设想,终于随着iPhone X的到来成为了现实。现在,就跟未来见个面吧。"}}},{"_index": "demo","_type": "goods","_id": "3","_score": 0.68324494,"_source": {"no": "42417956432","title": "小米9 透明尊享版 手机 透明尊享 全网通(12GB + 256GB)","brand": "小米(MI)","name": "小米(MI)小米9透明","product": "中国大陆","resolution": "2340*1080","intro": "全面透明机身,独特科幻机甲风,来自未来的设计。"}}]}}URL中可用的搜索参数如下表所示:
参数 说明 q 查询字符串 analyzer 分析查询字符串使用的分词器 analyze_wildcard 通配符或者前缀查询是否被分析,默认为false default_operator 多个条件之间的关系,默认为OR,可以修改为AND explain 在返回的结果中包含评分机制的解释 fields 只返回索引中指定的列,多个列中间用逗号隔开 sort 排序参考的字段,可以用 和 来指定升序和降序 timeout 超时时间 from 匹配结果的开始值,默认为0 size 匹配结果的条数,默认为10 -
POST -
http://120.77.222.217:9200/demo/goods/_search请求头:Content-Type: application/json
参数:
{"query": {"term": {"type": ""}}}POST搜索是基于DSL的。
Django对接ElasticSearch
Python对接ElasticSearch的第三方库是HayStack,在Django项目中可以使用django-haystack,通过HayStack可以在不修改代码对接多种搜索引擎服务。
pip install django-haystack elasticsearch配置文件:
INSTALLED_APPS = [ ... 'haystack', ...]
HAYSTACK_CONNECTIONS = { 'default': { # 引擎配置 'ENGINE': 'haystack.backends.elasticsearch_backend.ElasticsearchSearchEngine', # 搜索引擎服务的URL 'URL': 'http://1.2.3.4:9200', # 索引库的名称 'INDEX_NAME': 'goods', },}
# 添加/删除/更新数据时自动生成索引HAYSTACK_SIGNAL_PROCESSOR = 'haystack.signals.RealtimeSignalProcessor'索引类:
from haystack import indexes
class GoodsIndex(indexes.SearchIndex, indexes.Indexable): text = indexes.CharField(document=True, use_template=True)
def get_model(self): return Goods
def index_queryset(self, using=None): return self.get_model().objects.all()编辑text字段的模板(需要放在templates/search/indexes/demo/goods_text.txt):
{{object.title}}{{object.intro}}配置URL:
urlpatterns = [ # ... url('search/', include('haystack.urls')),]生成初始索引:
python manage.py rebuild_index说明:可以参考《Django Haystack 全文检索与关键词高亮》一文来更深入的了解基于Haystack的全文检索操作。
98 项目部署上线指南
准备上线
-
上线前的检查工作。
Terminal window python manage.py check --deploy -
将DEBUG设置为False并配置ALLOWED_HOSTS。
DEBUG = FalseALLOWED_HOSTS = ['*'] -
安全相关的配置。
# 保持HTTPS连接的时间SECURE_HSTS_SECONDS = 3600SECURE_HSTS_INCLUDE_SUBDOMAINS = TrueSECURE_HSTS_PRELOAD = True# 自动重定向到安全连接SECURE_SSL_REDIRECT = True# 避免浏览器自作聪明推断内容类型SECURE_CONTENT_TYPE_NOSNIFF = True# 避免跨站脚本攻击SECURE_BROWSER_XSS_FILTER = True# COOKIE只能通过HTTPS进行传输SESSION_COOKIE_SECURE = TrueCSRF_COOKIE_SECURE = True# 防止点击劫持攻击手段 - 修改HTTP协议响应头# 当前网站是不允许使用<iframe>标签进行加载的X_FRAME_OPTIONS = 'DENY' -
敏感信息放到环境变量或文件中。
SECRET_KEY = os.environ['SECRET_KEY']DB_USER = os.environ['DB_USER']DB_PASS = os.environ['DB_PASS']REDIS_AUTH = os.environ['REDIS_AUTH']
更新服务器Python环境到3.x
说明:如果需要清除之前的安装,就删除对应的文件和文件夹即可
-
安装底层依赖库。
Terminal window yum -y install zlib-devel bzip2-devel openssl-devel ncurses-devel sqlite-devel readline-devel tk-devel gdbm-devel libdb4-devel libpcap-devel xz-devel libffi-devel libxml2 -
下载Python源代码。
Terminal window wget https://www.python.org/ftp/python/3.7.6/Python-3.7.6.tar.xz -
验证下载文件。
Terminal window md5sum Python-3.7.6.tar.xz -
解压缩和解归档。
Terminal window xz -d Python-3.7.6.tar.xztar -xvf Python-3.7.6.tar -
执行安装前的配置(生成Makefile文件)。
Terminal window cd Python-3.7.6./configure --prefix=/usr/local/python37 --enable-optimizations -
构建和安装。
Terminal window make && make install -
配置PATH环境变量(用户或系统环境变量)并激活。
Terminal window vim ~/.bash_profilevim /etc/profile... 此处省略上面的代码...export PATH=$PATH:/usr/local/python37/bin... 此处省略下面的代码...Terminal window source ~/.bash_profilesource /etc/profile -
注册软链接(符号链接)- 这一步不是必须的,但通常会比较有用。
Terminal window ln -s /usr/local/python37/bin/python3 /usr/bin/python3 -
测试Python环境是否更新成功(安装Python 3一定不能破坏原来的Python 2)。
Terminal window python3 --versionpython --version
项目目录结构
假设项目文件夹为project,下面的五个子目录分别是:code、conf、logs、stat和venv分别用来保存项目的代码、配置文件、日志文件、静态资源和虚拟环境。其中,conf目录下的子目录cert中保存了配置HTTPS需要使用的证书和密钥;code目录下的项目代码可以通过版本控制工具从代码仓库中检出;虚拟环境可以通过工具(如:venv、virtualenv、pyenv等)进行创建。
project├── code│ └── fangtx│ ├── api│ ├── common│ ├── fangtx│ ├── forum│ ├── rent│ ├── user│ ├── manage.py│ ├── README.md│ ├── static│ └── templates├── conf│ ├── cert│ │ ├── 214915882850706.key│ │ └── 214915882850706.pem│ ├── nginx.conf│ └── uwsgi.ini├── logs│ ├── access.log│ ├── error.log│ └── uwsgi.log├── stat│ └── css│ └── images│ └── js└── venv ├── bin │ ├── activate │ ├── activate.csh │ ├── activate.fish │ ├── celery │ ├── celerybeat │ ├── celeryd │ ├── celeryd-multi │ ├── coverage │ ├── coverage3 │ ├── coverage-3.7 │ ├── django-admin │ ├── django-admin.py │ ├── easy_install │ ├── easy_install-3.7 │ ├── pip │ ├── pip3 │ ├── pip3.7 │ ├── __pycache__ │ ├── pyrsa-decrypt │ ├── pyrsa-decrypt-bigfile │ ├── pyrsa-encrypt │ ├── pyrsa-encrypt-bigfile │ ├── pyrsa-keygen │ ├── pyrsa-priv2pub │ ├── pyrsa-sign │ ├── pyrsa-verify │ ├── python -> python3 │ ├── python3 -> /usr/bin/python3 │ └── uwsgi ├── include ├── lib │ └── python3.7 ├── lib64 -> lib ├── pip-selfcheck.json └── pyvenv.cfg下面以阿里云为例,简单说明如何为项目注册域名、解析域名以及购买权威机构颁发的证书。
可以使用类似于sftp的工具将证书上传到conf/cert目录,然后使用git克隆项目代码到code目录。
cd codegit clone <url>回到项目目录,创建并激活虚拟环境。
python3 -m venv venvsource venv/bin/activate重建项目依赖项。
pip install -r code/teamproject/requirements.txtuWSGI的配置
-
安装uWSGI。
Terminal window pip install uwsgi -
修改uWSGI的配置文件(
/root/project/conf/uwsgi.ini)。[uwsgi]# 配置前导路径base=/root/project# 配置项目名称name=teamproject# 守护进程master=true# 进程个数processes=4# 虚拟环境pythonhome=%(base)/venv# 项目地址chdir=%(base)/code/%(name)# 指定python解释器pythonpath=%(pythonhome)/bin/python# 指定uwsgi文件module=%(name).wsgi# 通信的地址和端口(自己服务器的IP地址和端口)socket=172.18.61.250:8000# 日志文件地址logto=%(base)/logs/uwsgi.log说明:可以先将“通信的地址和端口”项等号前面改为http来进行测试,如果没有问题再改回 成socket,然后通过Nginx来实现项目的“动静分离”(静态资源交给Nginx处理,动态内容交给 uWSGI处理)。按照下面的方式可以启动uWSGI服务器。
-
启动服务器。
Terminal window nohup uwsgi --ini conf/uwsgi.ini &
Nginx的配置
-
安装Nginx。
Terminal window yum -y install nginx -
修改全局配置文件(
/etc/nginx/nginx.conf)。# 配置用户user nginx;# 工作进程数(建议跟CPU的核数量一致)worker_processes auto;# 错误日志error_log /var/log/nginx/error.log;# 进程文件pid /run/nginx.pid;# 包含其他的配置include /usr/share/nginx/modules/*.conf;# 工作模式(多路IO复用方式)和连接上限events {use epoll;worker_connections 1024;}# HTTP服务器相关配置http {# 日志格式log_format main '$remote_addr - $remote_user [$time_local] "$request" ''$status $body_bytes_sent "$http_referer" ''"$http_user_agent" "$http_x_forwarded_for"';# 访问日志access_log /var/log/nginx/access.log main;# 开启高效文件传输模式sendfile on;# 用sendfile传输文件时有利于改善性能tcp_nopush on;# 禁用Nagle来解决交互性问题tcp_nodelay on;# 客户端保持连接时间keepalive_timeout 30;types_hash_max_size 2048;# 包含MIME类型的配置include /etc/nginx/mime.types;# 默认使用二进制流格式default_type application/octet-stream;# 包含其他配置文件include /etc/nginx/conf.d/*.conf;# 包含项目的Nginx配置文件include /root/project/conf/*.conf;} -
编辑局部配置文件(
/root/project/conf/nginx.conf)。server {listen 80;server_name _;access_log /root/project/logs/access.log;error_log /root/project/logs/error.log;location / {include uwsgi_params;uwsgi_pass 172.18.61.250:8000;}location /static/ {alias /root/project/stat/;expires 30d;}}server {listen 443;server_name _;ssl on;access_log /root/project/logs/access.log;error_log /root/project/logs/error.log;ssl_certificate /root/project/conf/cert/214915882850706.pem;ssl_certificate_key /root/project/conf/cert/214915882850706.key;ssl_session_timeout 5m;ssl_ciphers ECDHE-RSA-AES128-GCM-SHA256:ECDHE:ECDH:AES:HIGH:!NULL:!aNULL:!MD5:!ADH:!RC4;ssl_protocols TLSv1 TLSv1.1 TLSv1.2;ssl_prefer_server_ciphers on;location / {include uwsgi_params;uwsgi_pass 172.18.61.250:8000;}location /static/ {alias /root/project/static/;expires 30d;}}到此为止,我们可以启动Nginx来访问我们的应用程序,HTTP和HTTPS都是没有问题的,如果Nginx已经运行,在修改配置文件后,我们可以用下面的命令重新启动Nginx。
-
重启Nginx服务器。
Terminal window nginx -s reload或
Terminal window systemctl restart nginx
说明:可以对Django项目使用
python manage.py collectstatic命令将静态资源收集到指定目录下,要做到这点只需要在项目的配置文件settings.py中添加STATIC_ROOT配置即可。
负载均衡配置
下面的配置中我们使用Nginx实现负载均衡,为另外的三个Nginx服务器(通过Docker创建)提供反向代理服务。
docker run -d -p 801:80 --name nginx1 nginx:latestdocker run -d -p 802:80 --name nginx2 nginx:latestdocker run -d -p 803:80 --name nginx3 nginx:latestuser root;worker_processes auto;error_log /var/log/nginx/error.log;pid /run/nginx.pid;
include /usr/share/nginx/modules/*.conf;
events { worker_connections 1024;}
# 为HTTP服务配置负载均衡http { upstream xx { server 192.168.1.100 weight=2; server 192.168.1.101 weight=1; server 192.168.1.102 weight=1; }
server { listen 80 default_server; listen [::]:80 default_server; listen 443 ssl; listen [::]:443 ssl;
ssl on; access_log /root/project/logs/access.log; error_log /root/project/logs/error.log; ssl_certificate /root/project/conf/cert/214915882850706.pem; ssl_certificate_key /root/project/conf/cert/214915882850706.key; ssl_session_timeout 5m; ssl_ciphers ECDHE-RSA-AES128-GCM-SHA256:ECDHE:ECDH:AES:HIGH:!NULL:!aNULL:!MD5:!ADH:!RC4; ssl_protocols TLSv1 TLSv1.1 TLSv1.2; ssl_prefer_server_ciphers on;
location / { proxy_set_header Host $host; proxy_set_header X-Forwarded-For $remote_addr; # proxy_set_header X-Real-IP $remote_addr; # proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_buffering off; proxy_pass http://fangtx; } }}说明:Nginx在配置负载均衡时,默认使用WRR(加权轮询算法),除此之外还支持ip_hash、fair(需要安装upstream_fair模块)和url_hash算法。此外,在配置upstream模块时可以指定服务器的状态值,包括:backup(备份机器,其他服务器不可用时才将请求分配到该机器)、down、fail_timeout(请求失败达到max_fails后的暂停服务时间)、max_fails(允许请求失败的次数)和weight(轮询的权重)。
Keepalived
当使用Nginx进行负载均衡配置时,要考虑负载均衡服务器宕机的情况。为此可以使用Keepalived来实现负载均衡主机和备机的热切换,从而保证系统的高可用性。Keepalived的配置还是比较复杂,通常由专门做运维的人进行配置,一个基本的配置可以参照《Keepalived的配置和使用》。
MySQL主从复制
下面还是基于Docker来演示如何配置MySQL主从复制。我们事先准备好MySQL的配置文件以及保存MySQL数据和运行日志的目录,然后通过Docker的数据卷映射来指定容器的配置、数据和日志文件的位置。
root└── mysql ├── master │ ├── conf | └── data └── slave-1 | ├── conf | └── data └── slave-2 | ├── conf | └── data └── slave-3 ├── conf └── data-
MySQL的配置文件(master和slave的配置文件需要不同的server-id)。
[mysqld]pid-file=/var/run/mysqld/mysqld.pidsocket=/var/run/mysqld/mysqld.sockdatadir=/var/lib/mysqllog-error=/var/log/mysql/error.logserver-id=1log-bin=/var/log/mysql/mysql-bin.logexpire_logs_days=30max_binlog_size=256Msymbolic-links=0# slow_query_log=ON# slow_query_log_file=/var/log/mysql/slow.log# long_query_time=1 -
创建和配置master。
Terminal window docker run -d -p 3306:3306 --name mysql-master \-v /root/mysql/master/conf:/etc/mysql/mysql.conf.d \-v /root/mysql/master/data:/var/lib/mysql \-e MYSQL_ROOT_PASSWORD=123456 mysql:5.7docker exec -it mysql-master /bin/bashTerminal window mysql -u root -pEnter password:Welcome to the MySQL monitor. Commands end with ; or \g.Your MySQL connection id is 1Server version: 5.7.23-log MySQL Community Server (GPL)Copyright (c) 2000, 2018, Oracle and/or its affiliates. All rights reserved.Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.mysql> grant replication slave on *.* to 'slave'@'%' identified by 'iamslave';Query OK, 0 rows affected, 1 warning (0.00 sec)mysql> flush privileges;Query OK, 0 rows affected (0.00 sec)mysql> show master status;+------------------+----------+--------------+------------------+-------------------+| File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set |+------------------+----------+--------------+------------------+-------------------+| mysql-bin.000003 | 590 | | | |+------------------+----------+--------------+------------------+-------------------+1 row in set (0.00 sec)mysql> quitByeexit上面创建Docker容器时使用的
-v参数(--volume)表示映射数据卷,冒号前是宿主机的目录,冒号后是容器中的目录,这样相当于将宿主机中的目录挂载到了容器中。 -
备份主表中的数据(如果需要的话)。
mysql> flush table with read lock;Terminal window mysqldump -u root -p 123456 -A -B > /root/backup/mysql/mybak$(date +"%Y%m%d%H%M%S").sqlmysql> unlock table; -
创建和配置slave。
Terminal window docker run -d -p 3308:3306 --name mysql-slave-1 \-v /root/mysql/slave-1/conf:/etc/mysql/mysql.conf.d \-v /root/mysql/slave-1/data:/var/lib/mysql \-e MYSQL_ROOT_PASSWORD=123456 \--link mysql-master:mysql-master mysql:5.7docker run -d -p 3309:3306 --name mysql-slave-2 \-v /root/mysql/slave-2/conf:/etc/mysql/mysql.conf.d \-v /root/mysql/slave-2/data:/var/lib/mysql \-e MYSQL_ROOT_PASSWORD=123456 \--link mysql-master:mysql-master mysql:5.7docker run -d -p 3310:3306 --name mysql-slave-3 \-v /root/mysql/slave-3/conf:/etc/mysql/mysql.conf.d \-v /root/mysql/slave-3/data:/var/lib/mysql \-e MYSQL_ROOT_PASSWORD=123456 \--link mysql-master:mysql-master mysql:5.7docker exec -it mysql-slave-1 /bin/bashTerminal window mysql -u root -pEnter password:Welcome to the MySQL monitor. Commands end with ; or \g.Your MySQL connection id is 2Server version: 5.7.23-log MySQL Community Server (GPL)Copyright (c) 2000, 2018, Oracle and/or its affiliates. All rights reserved.Oracle is a registered trademark of Oracle Corporation and/or itsaffiliates. Other names may be trademarks of their respectiveowners.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.mysql> reset slave;Query OK, 0 rows affected (0.02 sec)mysql> change master to master_host='mysql-master', master_user='slave', master_password='iamslave', master_log_file='mysql-bin.000003', master_log_pos=590;Query OK, 0 rows affected, 2 warnings (0.03 sec)mysql> start slave;Query OK, 0 rows affected (0.01 sec)mysql> show slave status\G*************************** 1. row ***************************Slave_IO_State: Waiting for master to send eventMaster_Host: mysql57Master_User: slaveMaster_Port: 3306Connect_Retry: 60Master_Log_File: mysql-bin.000001Read_Master_Log_Pos: 590Relay_Log_File: f352f05eb9d0-relay-bin.000002Relay_Log_Pos: 320Relay_Master_Log_File: mysql-bin.000001Slave_IO_Running: YesSlave_SQL_Running: YesReplicate_Do_DB:Replicate_Ignore_DB:Replicate_Do_Table:Replicate_Ignore_Table:Replicate_Wild_Do_Table:Replicate_Wild_Ignore_Table:Last_Errno: 0Last_Error:Skip_Counter: 0Exec_Master_Log_Pos: 590Relay_Log_Space: 534Until_Condition: NoneUntil_Log_File:Until_Log_Pos: 0Master_SSL_Allowed: NoMaster_SSL_CA_File:Master_SSL_CA_Path:Master_SSL_Cert:Master_SSL_Cipher:Master_SSL_Key:Seconds_Behind_Master: 0Master_SSL_Verify_Server_Cert: NoLast_IO_Errno: 0Last_IO_Error:Last_SQL_Errno: 0Last_SQL_Error:Replicate_Ignore_Server_Ids:Master_Server_Id: 1Master_UUID: 30c38043-ada1-11e8-8fa1-0242ac110002Master_Info_File: /var/lib/mysql/master.infoSQL_Delay: 0SQL_Remaining_Delay: NULLSlave_SQL_Running_State: Slave has read all relay log; waiting for more updatesMaster_Retry_Count: 86400Master_Bind:Last_IO_Error_Timestamp:Last_SQL_Error_Timestamp:Master_SSL_Crl:Master_SSL_Crlpath:Retrieved_Gtid_Set:Executed_Gtid_Set:Auto_Position: 0Replicate_Rewrite_DB:Channel_Name:Master_TLS_Version:1 row in set (0.00 sec)mysql> quitByeexit接下来可以如法炮制配置出slave2和slave3,这样就可以搭建起一个“一主带三从”的主从复制环境。上面创建创建容器时使用的
--link参数用来配置容器在网络上的主机名(网络地址别名)。
配置好主从复制后,写数据的操作应该master上执行,而读数据的操作应该在slave上完成。为此,在Django项目中需要配置DATABASE_ROUTERS并通过自定义的主从复制路由类来实现读写分离操作,如下所示:
DATABASE_ROUTERS = [ # 此处省略其他配置 'common.routers.MasterSlaveRouter',]class MasterSlaveRouter(object): """主从复制路由"""
@staticmethod def db_for_read(model, **hints): """ Attempts to read auth models go to auth_db. """ return random.choice(('slave1', 'slave2', 'slave3'))
@staticmethod def db_for_write(model, **hints): """ Attempts to write auth models go to auth_db. """ return 'default'
@staticmethod def allow_relation(obj1, obj2, **hints): """ Allow relations if a model in the auth app is involved. """ return None
@staticmethod def allow_migrate(db, app_label, model_name=None, **hints): """ Make sure the auth app only appears in the 'auth_db' database. """ return True上面的内容参考了Django官方文档的DATABASE_ROUTERS配置,对代码进行了适当的调整。
Docker
事实上,项目上线中最为麻烦的事情就是配置软件运行环境,环境的差异会给软件的安装和部署带来诸多的麻烦,而Docker正好可以解决这个问题。关于Docker在之前的文档中我们已经介绍过了,接下来我们对Docker的知识做一些必要的补充。
-
创建镜像文件。
将容器保存成镜像:
Terminal window docker commit -m "..." -a "jackfrued" <container-name> jackfrued/<image-name>使用Dockerfile构建镜像:
# 指定基础镜像文件FROM centos:latest# 指定维护者信息MAINTAINER jackfrued# 执行命令RUN yum -y install gccRUN cd ~RUN mkdir -p project/codeRUN mkdir -p project/logs# 拷贝文件COPY ...# 暴露端口EXPOSE ...# 在容器启动时执行命令CMD ~/init.shTerminal window docker build -t jackfrued/<image-name> . -
镜像的导入和导出。
Terminal window docker save -o <file-name>.tar <image-name>:<version>docker load -i <file-name>.tar -
推送到DockerHub服务器。
Terminal window docker tag <image-name>:<version> jackfrued/<name>docker logindocker push jackfrued/<name> -
容器之间的通信。
Terminal window docker run --link <container-name>:<alias-name>
如果我们能够在Docker中完成项目的部署,并且将整个部署好的容器打包成镜像文件进行分发和安装,这样就可以解决项目在多个节点上进行部署时可能遇到的麻烦,而且整个部署可以在很短的时间内完成。
Supervisor
Supervisor是一个用Python写的进程管理工具,可以很方便的用来在类Unix系统下启动、重启(自动重启程序)和关闭进程,目前Supervisor暂时还没有提供对Python 3的支持,可以通过Python 2来安装和运行Supervisor,再通过Supervisor来管理Python 3的程序。
提示:还有一个和Supervisor功能类似的工具名为Circus,支持Python 3。
-
安装Supervisor。
Terminal window virtualenv -p /usr/bin/python venvsource venv/bin/activatepip install supervisor -
查看Supervisor的配置文件。
Terminal window vim /etc/supervisord.conf; 此处省略上面的代码; The [include] section can just contain the "files" setting. This; setting can list multiple files (separated by whitespace or; newlines). It can also contain wildcards. The filenames are; interpreted as relative to this file. Included files *cannot*; include files themselves.[include]files = supervisord.d/*.ini可以看出自定义的管理配置代码可以放在
/etc/supervisord.d目录中,并且文件名以ini作为后缀即可。 -
编写自己的配置文件
fangtx.ini并放在/etc/supervisord.d目录中。[program:project]command=uwsgi --ini /root/project/conf/uwsgi.inistopsignal=QUITautostart=trueautorestart=trueredirect_stderr=true[program:celery]; Set full path to celery program if using virtualenvcommand=/root/project/venv/bin/celery -A fangtx workeruser=rootnumprocs=1stdout_logfile=/var/log/supervisor/celery.logstderr_logfile=/var/log/supervisor/celery_error.logautostart=trueautorestart=truestartsecs=10; Need to wait for currently executing tasks to finish at shutdown.; Increase this if you have very long running tasks.;stopwaitsecs = 600; When resorting to send SIGKILL to the program to terminate it; send SIGKILL to its whole process group instead,; taking care of its children as well.killasgroup=true; Set Celery priority higher than default (999); so, if rabbitmq is supervised, it will start first.priority=1000 -
启动Supervisor。
Terminal window supervisorctl -c /etc/supervisord.conf
其他服务
-
常用开源软件。
功能 开源方案 版本控制工具 Git、Mercurial、SVN 缺陷管理 Redmine、Mantis 负载均衡 Nginx、LVS、HAProxy 邮件服务 Postfix、Sendmail HTTP服务 Nginx、Apache 消息队列 RabbitMQ、ZeroMQ、Redis、Kafka 文件系统 FastDFS 基于位置服务(LBS) MongoDB、Redis 监控服务 Nagios、Zabbix 关系型数据库 MySQL、PostgreSQL 非关系型数据库 MongoDB、Redis、Cassandra、TiDB 搜索引擎 ElasticSearch、Solr 缓存服务 Mamcached、Redis -
常用云服务。
功能 可用的云服务 团队协作工具 Teambition、钉钉 代码托管平台 Github、Gitee、CODING 邮件服务 SendCloud 云存储(CDN) 七牛、OSS、LeanCloud、Bmob、又拍云、S3 移动端推送 极光、友盟、百度 即时通信 环信、融云 短信服务 云片、极光、Luosimao、又拍云 第三方登录 友盟、ShareSDK 网站监控和统计 阿里云监控、监控宝、百度云观测、小鸟云
99 面试中的公共问题
计算机基础
-
TCP/IP模型相关问题。
建议阅读阮一峰的《互联网协议入门(一)》和《互联网协议入门(二)》。
-
HTTP和HTTPS相关问题。
建议阅读阮一峰的《HTTP 协议入门》和《SSL/TLS协议运行机制的概述》。
-
Linux常用命令和服务。
-
进程和线程之间的关系。什么时候用多线程?什么时候用多进程?。
-
关系型数据库相关问题(ACID、事务隔离级别、锁、SQL优化)。
-
非关系型数据库相关问题(CAP/BASE、应用场景)。
Python基础
-
开发中用过哪些标准库和三方库。
标准库:sys / os / re / math / random / logging / json / pickle / shelve / socket / datetime / hashlib / configparser / urllib / itertools / collections / functools / threading / multiprocess / timeit / atexit / abc / asyncio / base64 / concurrent.futures / copy / csv / operator / enum / heapq / http / profile / pstats / ssl / unittest / uuid
三方库:openpyxl / xlrd / xlwt / PyPDF2 / ReportLab / PyYAML / jieba / pillow / requests / urllib3 / responses / aiohttp / BeautifulSoup4 / lxml / pyquery / PyMySQL / psycopg2 / redis / PyMongo / Peewee / SQLAlchemy / alipay / PyJWT / itsdangerous / celery / flower / elasticsearch-dsl-py / PyCrypto / Paramiko / logbook / nose / pytest / coverage / Selenium / lineprofiler / memoryprofiler / matplotlib / pygal / OpenCV
-
装饰器的作用、原理和实现。
-
使用过哪些魔法方法。
建议阅读《Python魔术方法指南》。
-
生成式、生成器、迭代器的编写。
-
列表、集合、字典的底层实现。
-
垃圾回收相关问题。
-
并发编程的相关问题。
-
协程和异步I/O相关知识。
Django和Flask
-
MVC架构(MTV)解决了什么问题。
-
中间件的执行流程以及如何自定义中间件。
-
REST数据接口如何设计(URL、域名、版本、过滤、状态码、安全性)。
建议阅读阮一峰的《RESTful API设计指南》。
-
使用ORM框架实现CRUD操作的相关问题。
- 如何实现多条件组合查询 / 如何执行原生的SQL / 如何避免N+1查询问题
-
如何执行异步任务和定时任务。
-
如何实现页面缓存和查询缓存?缓存如何预热?
爬虫相关
- Scrapy框架的组件和数据处理流程。
- 爬取的目的(项目中哪些地方需要用到爬虫的数据)。
- 使用的工具(抓包、下载、清理、存储、分析、可视化)。
- 数据的来源(能够轻松的列举出10个网站)。
- 数据的构成(抓取的某个字段在项目中有什么用)。
- 反反爬措施(限速、请求头、Cookie池、代理池、Selenium WebDriver、RoboBrowser、TOR、OCR)。
- 数据的体量(最后抓取了多少数据,多少W条数据或多少个G的数据)。
- 后期数据处理(持久化、数据补全、归一化、格式化、转存、分类)。
数据分析
- 科学运算函数库(SciPy和NumPy常用运算)。
- 数据分析库(Pandas中封装的常用算法)。
- 常用的模型及对应的场景(分类、回归、聚类)。
- 提取了哪些具体的指标。
- 如何评价模型的优劣。
- 每种模型实际操作的步骤,对结果如何评价。
项目相关
- 项目团队构成以及自己在团队中扮演的角色(在项目中的职责)。
- 项目的业务架构(哪些模块及子模块)和技术架构(移动端、PC端、后端技术栈)。
- 软件控制管理相关工具(版本控制、问题管理、持续集成)。
- 核心业务实体及其属性,实体与实体之间的关系。
- 用到哪些依赖库,依赖库主要解决哪方面的问题。
- 项目如何部署上线以及项目的物理架构(Nginx、Gunicorn/uWSGI、Redis、MongoDB、MySQL、Supervisor等)。
- 如何对项目进行测试,有没有做过性能调优。
- 项目中遇到的困难有哪些,如何解决的。
100 补充内容
之前没有来得及安排,准备后面补充的内容:
- 面试相关资源请移步到“Python面试宝典”项目。
- Python 面试宝典
- 商业分析面试宝典
- 数据分析师 SQL 面试宝典
- 机器学习面试宝典
- 数学基础相关资源请移步到“机器学习数学基础知识”项目。
- 线性代数
- 概率论和统计学
- 高等数学
- 信息论
- 深度学习相关内容请移步到“深度学习就是大力出奇迹”项目。
Python100天
已完结分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 301 天
部分内容可能已过时
评论