本篇目录
- 01 PEP 8风格指南
- 02 常见反爬策略及应对方案
- 03 分享几张学习路线图
- 04 接口文档参考示例
- 05 那些年我们踩过的那些坑
- 06 如何快速驾驭 pandas 库
- 07 使用Hexo搭建自己的博客
- 08 我为什么选择了Python
- 09 一个小例子助你彻底理解协程
- 10 用函数还是用复杂的表达式
- 11 知乎问题回答
- 12 用Canvas学习编程
- 13 Python编程惯例
- 14 Python参考书籍
- 15 Python容器类型使用小技巧
- 16 Zen of Python(Python之禅)
目录里每一条都可以点开直达对应章节;右侧(移动端为悬浮按钮)的「文章目录」也会列出同一批标题。
01 PEP 8风格指南
PEP是Python Enhancement Proposal的缩写,通常翻译为“Python增强提案”。每个PEP都是一份为Python社区提供的指导Python往更好的方向发展的技术文档,其中的第8号增强提案(PEP 8)是针对Python语言编订的代码风格指南。尽管我们可以在保证语法没有问题的前提下随意书写Python代码,但是在实际开发中,采用一致的风格书写出可读性强的代码是每个专业的程序员应该做到的事情,也是每个公司的编程规范中会提出的要求,这些在多人协作开发一个项目(团队开发)的时候显得尤为重要。我们可以从Python官方网站的PEP 8链接中找到该文档,下面我们对该文档的关键部分做一个简单的总结。
空格的使用
- 使用空格来表示缩进而不要用制表符(Tab)。这一点对习惯了其他编程语言的人来说简直觉得不可理喻,因为绝大多数的程序员都会用Tab来表示缩进,但是要知道Python并没有像C/C++或Java那样的用花括号来构造一个代码块的语法,在Python中分支和循环结构都使用缩进来表示哪些代码属于同一个级别,鉴于此Python代码对缩进以及缩进宽度的依赖比其他很多语言都强得多。在不同的编辑器中,Tab的宽度可能是2、4或8个字符,甚至是其他更离谱的值,用Tab来表示缩进对Python代码来说可能是一场灾难。
- 和语法相关的每一层缩进都用4个空格来表示。
- 每行的字符数不要超过79个字符,如果表达式因太长而占据了多行,除了首行之外的其余各行都应该在正常的缩进宽度上再加上4个空格。
- 函数和类的定义,代码前后都要用两个空行进行分隔。
- 在同一个类中,各个方法之间应该用一个空行进行分隔。
- 二元运算符的左右两侧应该保留一个空格,而且只要一个空格就好。
标识符命名
PEP 8倡导用不同的命名风格来命名Python中不同的标识符,以便在阅读代码时能够通过标识符的名称来确定该标识符在Python中扮演了怎样的角色(在这一点上,Python自己的内置模块以及某些第三方模块都做得并不是很好)。
- 变量、函数和属性应该使用小写字母来拼写,如果有多个单词就使用下划线进行连接。
- 类中受保护的实例属性,应该以一个下划线开头。
- 类中私有的实例属性,应该以两个下划线开头。
- 类和异常的命名,应该每个单词首字母大写。
- 模块级别的常量,应该采用全大写字母,如果有多个单词就用下划线进行连接。
- 类的实例方法,应该把第一个参数命名为
self以表示对象自身。 - 类的类方法,应该把第一个参数命名为
cls以表示该类自身。
表达式和语句
在Python之禅(可以使用import this查看)中有这么一句名言:“There should be one— and preferably only one —obvious way to do it.”,翻译成中文是“做一件事应该有而且最好只有一种确切的做法”,这句话传达的思想在PEP 8中也是无处不在的。
- 采用内联形式的否定词,而不要把否定词放在整个表达式的前面。例如
if a is not b就比if not a is b更容易让人理解。 - 不要用检查长度的方式来判断字符串、列表等是否为
None或者没有元素,应该用if not x这样的写法来检查它。 - 就算
if分支、for循环、except异常捕获等中只有一行代码,也不要将代码和if、for、except等写在一起,分开写才会让代码更清晰。 import语句总是放在文件开头的地方。- 引入模块的时候,
from math import sqrt比import math更好。 - 如果有多个
import语句,应该将其分为三部分,从上到下分别是Python标准模块、第三方模块和自定义模块,每个部分内部应该按照模块名称的字母表顺序来排列。
02 常见反爬策略及应对方案
-
构造合理的HTTP请求头。
-
Accept
-
User-Agent
-
Referer
-
Accept-Encoding
-
Accept-Language
-
-
检查网站生成的Cookie。
- 有用的插件:EditThisCookie
- 如何处理脚本动态生成的Cookie
-
抓取动态内容。
- Selenium + WebDriver
- Chrome / Firefox - Driver
-
限制爬取的速度。
-
处理表单中的隐藏域。
- 在读取到隐藏域之前不要提交表单
- 用RoboBrowser这样的工具辅助提交表单
-
处理表单中的验证码。
-
OCR(Tesseract) - 商业项目一般不考虑
-
专业识别平台 - 超级鹰 / 云打码
from hashlib import md5class ChaoClient(object):def __init__(self, username, password, soft_id):self.username = usernamepassword = password.encode('utf-8')self.password = md5(password).hexdigest()self.soft_id = soft_idself.base_params = {'user': self.username,'pass2': self.password,'softid': self.soft_id,}self.headers = {'Connection': 'Keep-Alive','User-Agent': 'Mozilla/4.0 (compatible; MSIE 8.0; Windows NT 5.1; Trident/4.0)',}def post_pic(self, im, codetype):params = {'codetype': codetype,}params.update(self.base_params)files = {'userfile': ('captcha.jpg', im)}r = requests.post('http://upload.chaojiying.net/Upload/Processing.php', data=params, files=files, headers=self.headers)return r.json()if __name__ == '__main__':client = ChaoClient('用户名', '密码', '软件ID')with open('captcha.jpg', 'rb') as file:print(client.post_pic(file, 1902))
-
-
绕开“陷阱”。
- 网页上有诱使爬虫爬取的爬取的隐藏链接(陷阱或蜜罐)
- 通过Selenium+WebDriver+Chrome判断链接是否可见或在可视区域
-
隐藏身份。
-
代理服务 - 快代理 / 讯代理 / 芝麻代理 / 蘑菇代理 / 云代理
-
洋葱路由 - 国内需要翻墙才能使用
Terminal window yum -y install toruseradd admin -d /home/adminpasswd adminchown -R admin:admin /home/adminchown -R admin:admin /var/run/tortor
-
03 分享几张学习路线图
今天逛了一个名为 Developer Roadmaps 的网站,上面就有好多的学习路线图。其中有一张关于 Python 的学习路线图还不错,分享给大家。如果用 Python 做工程化开发(后端开发、接口开发、应用开发等),这张图上的内容基本都是需要涉猎的;如果仅仅是将 Python 作为辅助工具,学习之前给大家整理的《从零开始学Python》的 20 节课就已经足够了。近期,我也在重置这 20 节课的内容,重置后的内容会标记为“2025版”,也希望在这个过程中听到大家的意见和建议。
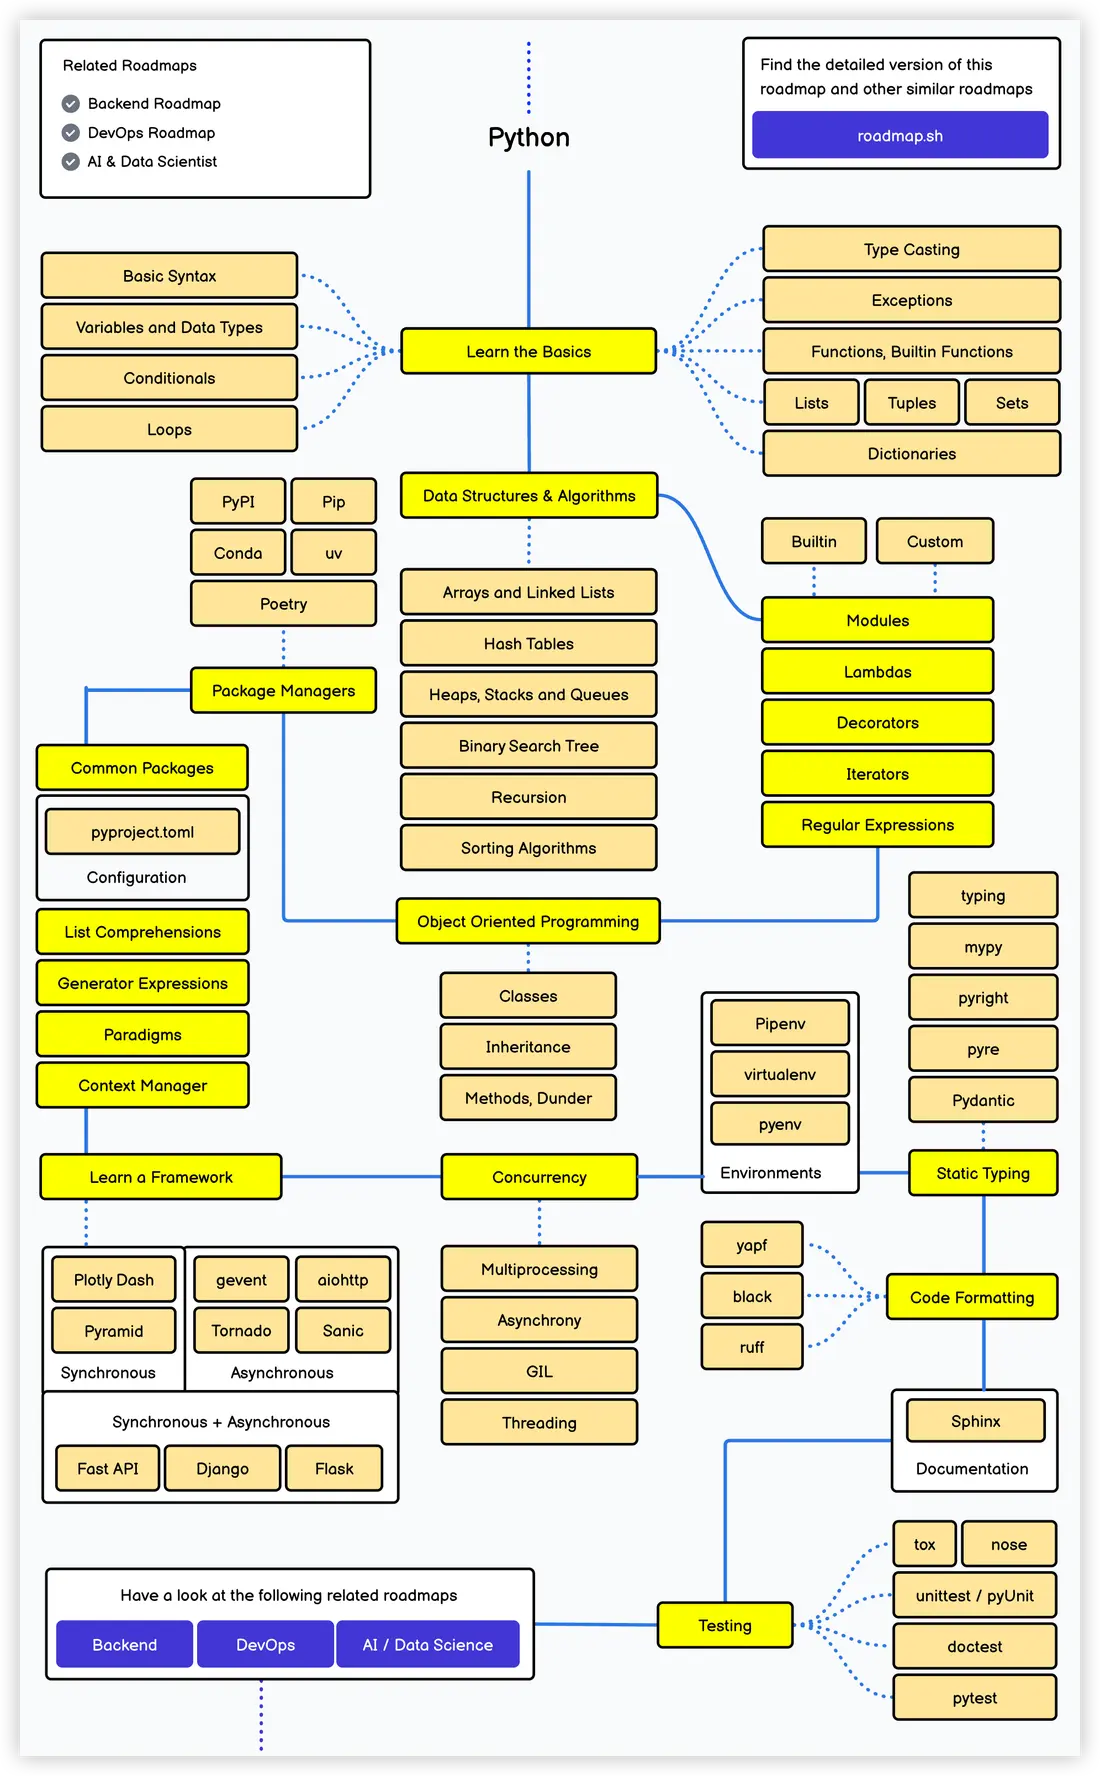
这里还有三个相关的学习路线图,分别是后端开发(Backend)、开发运维(DevOps)和数据科学(Data Science),后端开发的学习路线图如下所示,内容比较庞杂,核心的编程语言是 Java 或 Go。我个人不推荐大家用 Python 做后端开发,如果 Python 语言已经掌握得很好了,同时也具备了较多的计算机科学相关知识,可以尝试 AI 应用开发这个赛道,我相信你会有更多的收获。大家可以注意下用紫色勾选的项目,这些是作者推荐的选项,大部分也是我想推荐给后端开发者学习的内容。
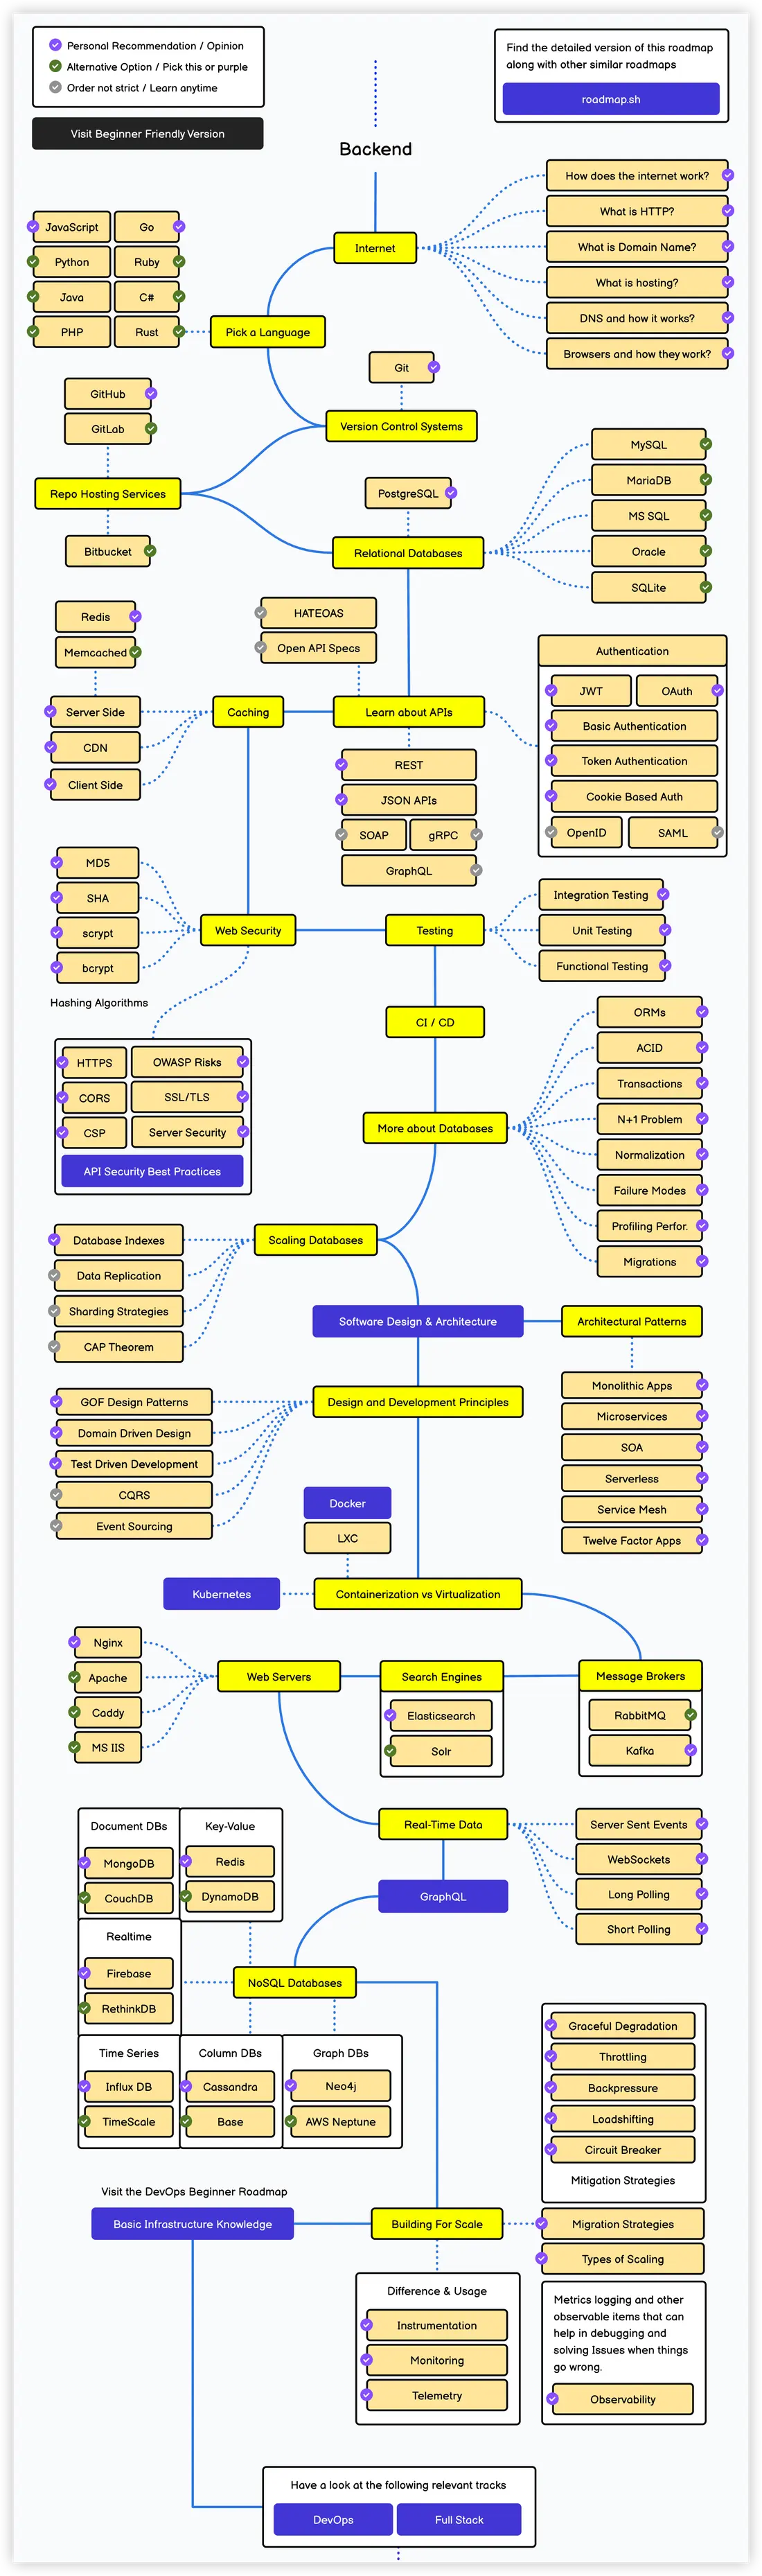
我们再看看开发运维的学习路线图,目前 DevOps 也是招聘市场的热门岗位,有兴趣的小伙伴可以关注下。
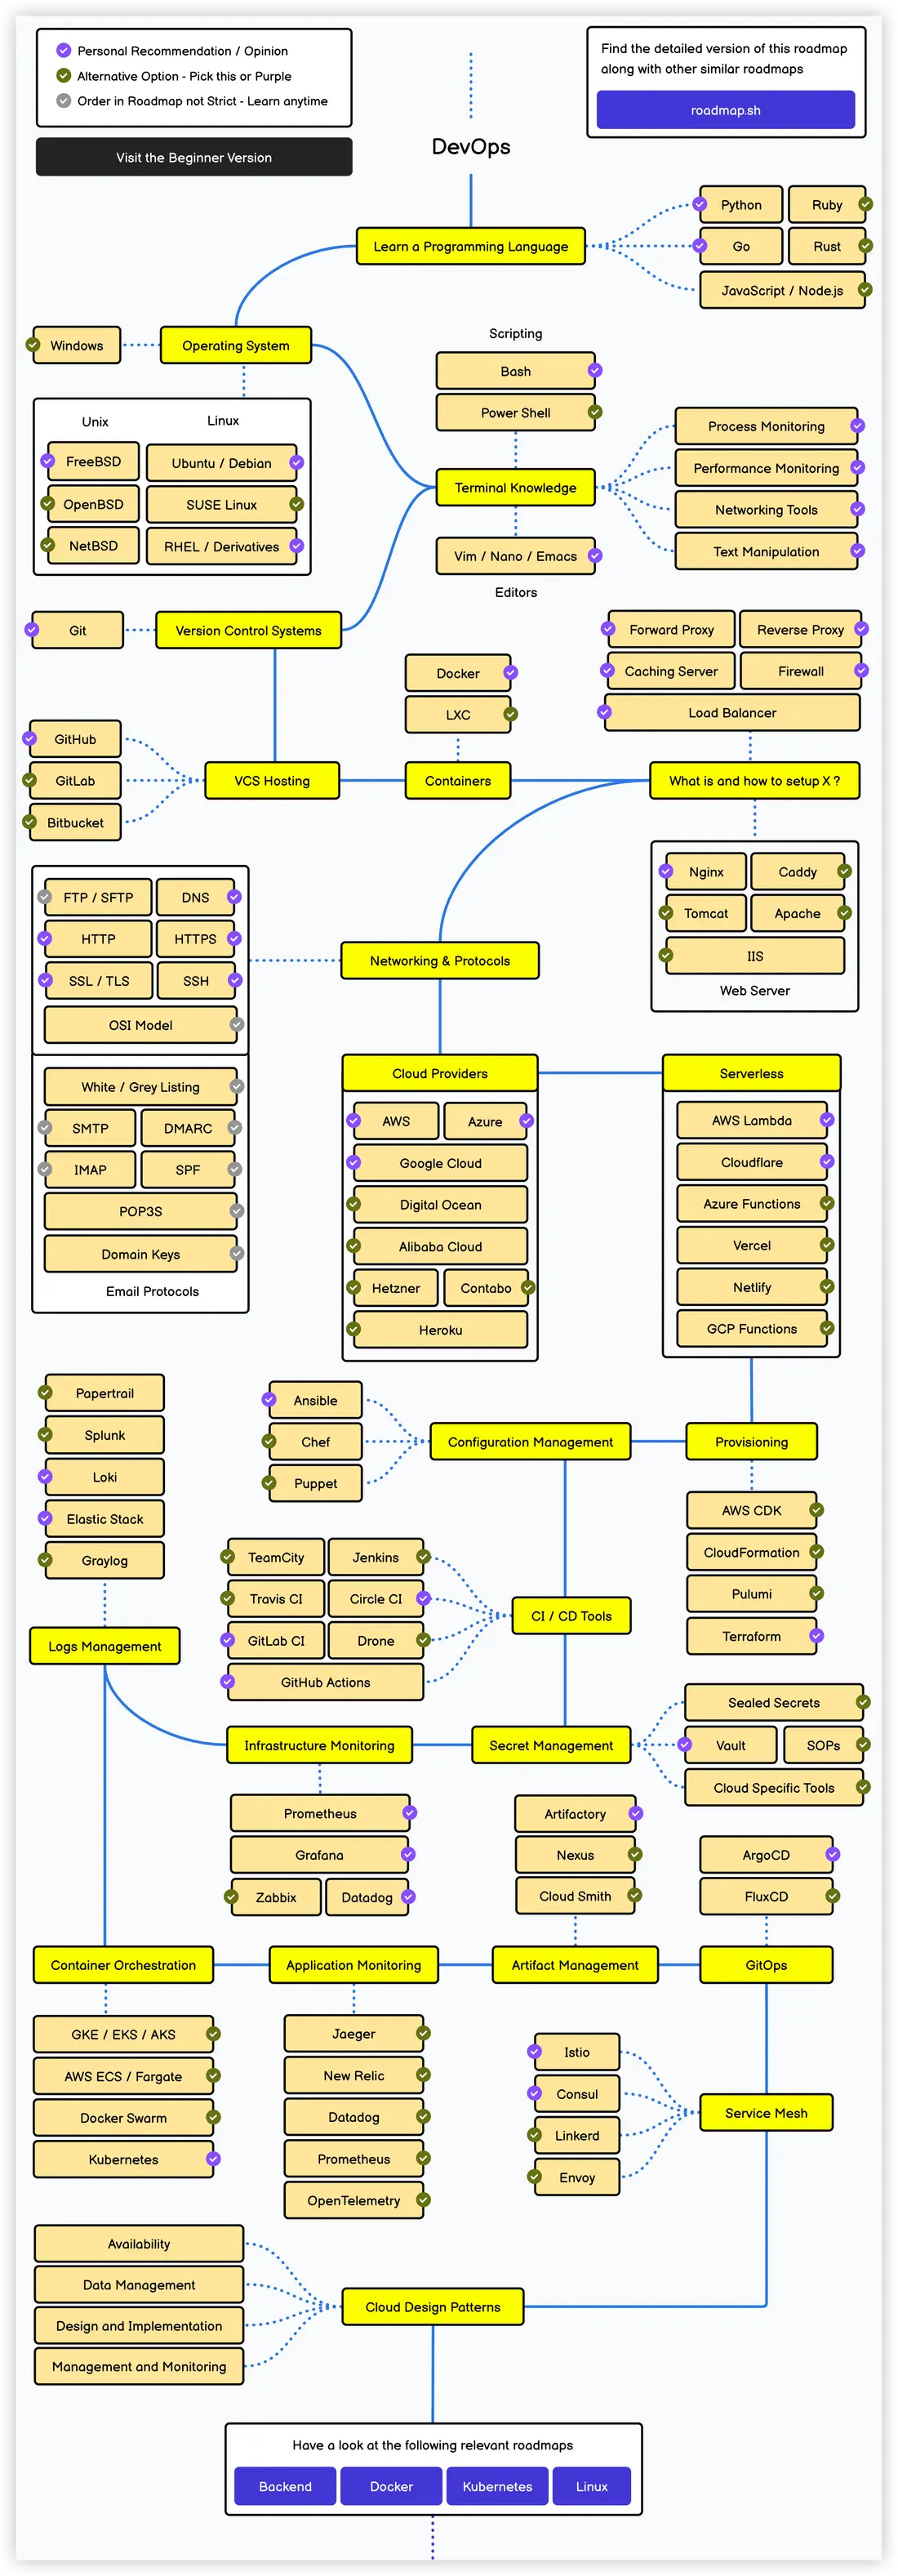
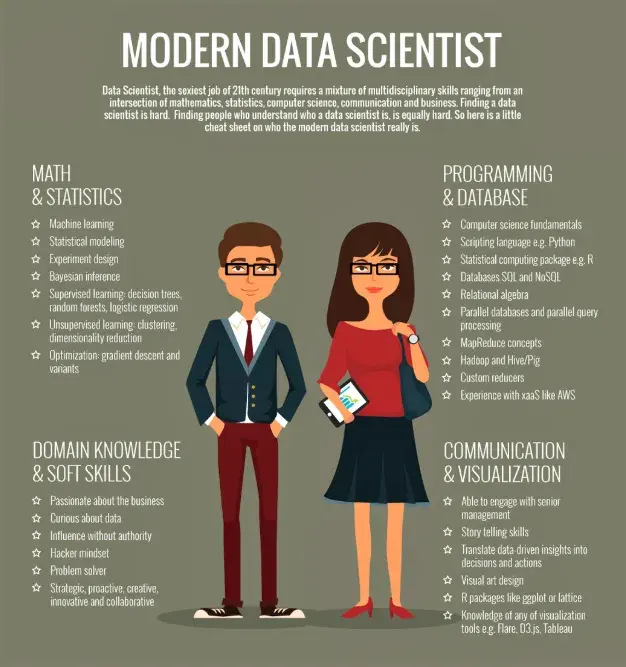
如果学过一些 Python 相关知识,想以此为基础转行做数据分析,可以看看下面这个学习路线图。需要说明的是,Python 仅仅是做数据分析的一个工具,要成为一个优秀的数据分析师需要有良好的数据思维,同时还要积累足够的业务知识,这样才能从数据中产生商业洞察,用数据优化产品、驱动业务,真正为决策提供强有力的支撑。
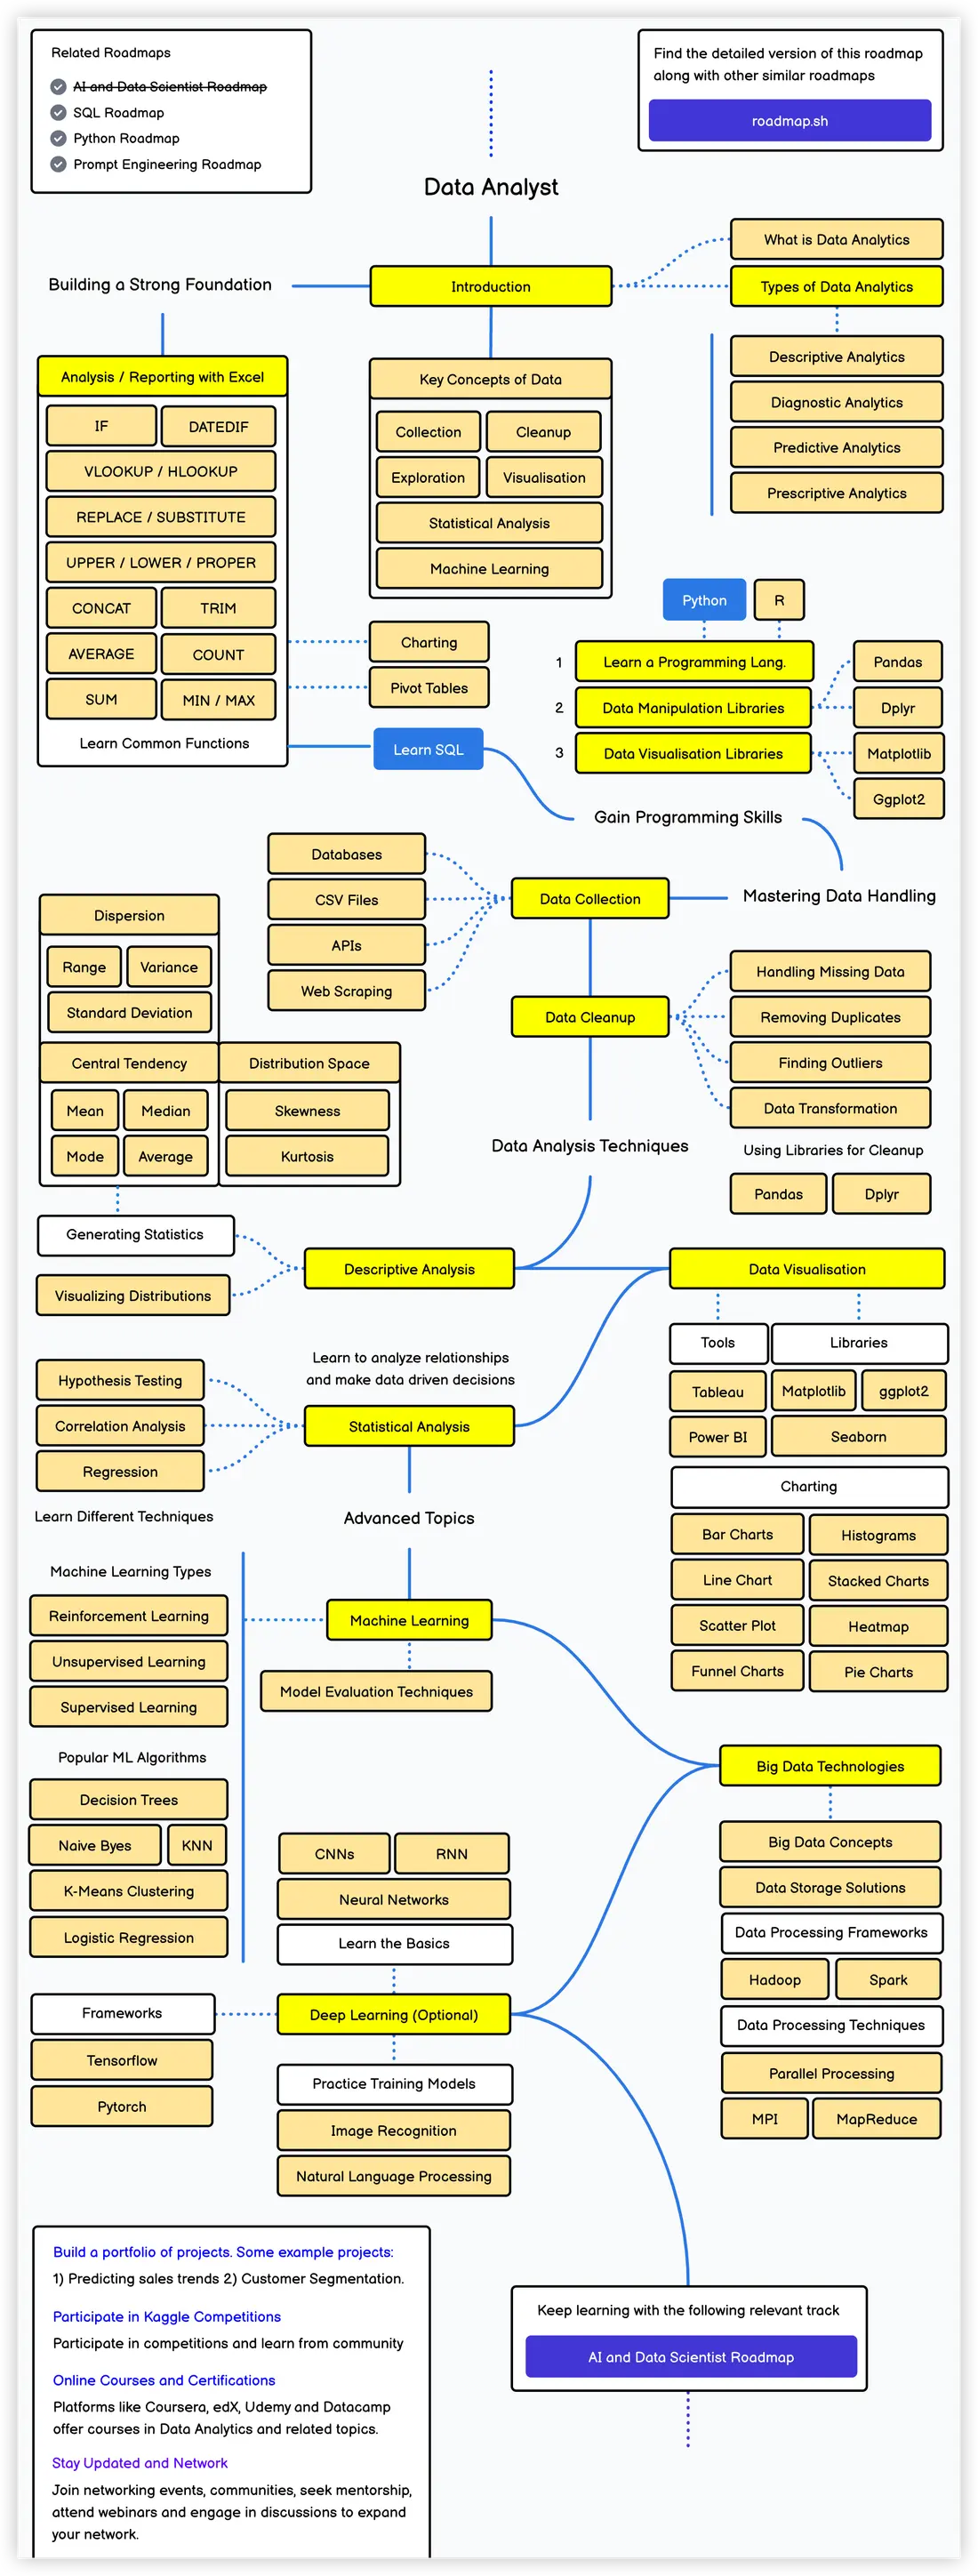
最后,再次提醒大家,想打卡学习的一定记得在评论区给我留言!如果想入坑数据科学(数据分析、数据挖掘、数据治理等)也可以给我留言,今年应该会持续输出相关的内容。
04 接口文档参考示例
-
用户登录 - POST
/api/login/开发者:骆昊
版本号:v1
最后修改时间:
接口说明:登录成功后,会生成或更新用户令牌(token)。
使用帮助:测试数据库中预设了四个可供使用的账号,如下表所示。
用户名 用户口令 角色 jackfrued 123456 管理员 wangdachui 123123 普通用户 hellokitty 123123 房地产经理人 wuzetian 123456 房东 请求参数:
参数名 类型 是否必填 参数位置 说明 username 字符串 是 消息体 用户名 password 字符串 是 消息体 用户口令 响应信息:
-
登录成功:
{"code": 30000,"message": "用户登录成功","token": "f83e0f624e2311e9af1f00163e02b646"} -
登录失败:
{"code": 30001,"message": "用户名或密码错误"}
-
-
发送短信验证码 - GET
/api/mobile_code/{国内手机号}/开发者:骆昊
版本号:v1
接口说明:给指定手机号发送短信验证码的接口,手机号必须是国内手机号,作为路径参数写到URL中。接口显示短信发送成功时,指定的手机号并不会收到短息,因为使用的三方短信平台赠送的测试短信已经用完了。
使用帮助:国内手机号暂不支持国际区号。
请求参数:暂无。
响应信息:
-
请求成功:
{"code": 10001,"msg": "短信验证码发送成功"} -
两次请求间隔小于60秒:
{"code": 10002,"msg": "请不要在60秒以内重复发送手机验证码"} -
手机号无效:
{"code": 10003,"msg": "请提供有效的手机号"} -
短信服务平台故障:
{"code": 10004,"msg": "短信服务暂时无法使用"}
-
-
获取所有省级行政单位 - GET
/api/districts/开发者:骆昊
版本号:v1
接口说明:暂无。
使用帮助:暂无。
请求参数:暂无。
响应信息:
[{"distid": 110000,"name": "北京市"},{"distid": 120000,"name": "天津市"}] -
获取指定行政单位详情及其管辖的行政单位 - GET
/api/districts/{行政单位编号}/开发者:骆昊
版本号:v1
接口说明:通过URL参数指定行政单位编号,如果行政单位编号为省级行政单位编号,则返回该省以及该省所辖市级行政单位的信息;如果行政单位编号为市级行政单位编号,则返回该市以及该市所辖区县的信息;如果行政单位编号为区县一级行政单位编号,则返回该区县的信息,下级行政单位
cities属性值为[]。使用帮助:数据库中除四川省外其他行政单位的“intro”数据都没有录入,该字段可能为空字符串。
请求参数:暂无。
响应信息:
{"distid": 510000,"name": "四川省","intro": "位于中国西南地区内陆,东连重庆,南邻云南、贵州,西接西藏,北界陕西、甘肃、青海,四川省总面积48.6万平方千米,省会成都。截至2018年底,四川省下辖18个省辖市,3个自治州,17个县级市,108个县,4个自治县,54个市辖区。","cities": [{"distid": 510100,"name": "成都市"},{"distid": 510300,"name": "自贡市"},{"distid": 510400,"name": "攀枝花市"}]} -
获取热门城市 - GET
/api/hotcities/开发者:骆昊
版本号:v1
接口说明:暂无。
使用帮助:暂无。
请求参数:暂无。
响应信息:
[{"distid": 110100,"name": "北京市"},{"distid": 120100,"name": "天津市"},{"distid": 130100,"name": "石家庄"}] -
分页获取房地产经理人信息 - GET
/api/agents/开发者:骆昊
版本号:v1
接口说明:经理人姓名按照前缀模糊匹配的方式进行处理;经理人服务星级是指经理人服务星级不得低于该星级;经理人是否持证只有0(未持证上岗)和1(持证上岗)两个选项。三个参数代表的筛选条件之间是而且的关系。返回结果为分页之后的房地产经理人信息。
使用帮助:暂无。
请求参数:
参数名 类型 是否必填 参数位置 说明 name 字符串 否 查询参数 经理人姓名 key 字符串 否 查询参数 经理人服务星级 cert 字符串 否 查询参数 经理人是否持证 page 整数 否 查询参数 页码,默认值为1 size 整数 否 查询参数 页面大小,默认值为5,最大值不超过50 响应信息:
{"count": 1,"next": null,"previous": null,"results": [{"agentid": 6,"estates": [{"estateid": 11,"name": "灵芝新村","hot": 20}],"name": "肖利丽","tel": "13040813886","servstar": 4,"realstar": 4,"profstar": 4,"certificated": false}]} -
新增房地产经理人 - POST
/api/agents/开发者:骆昊
版本号:v1
接口说明:暂无。
使用帮助:需要登录且拥有管理员权限,用户身份令牌在请求头中提供。
请求参数:
参数名 类型 是否必填 参数位置 说明 name 字符串 是 消息体 经理人姓名 tel 字符串 是 消息体 经理人手机 servstar 整数 否 消息体 默认值0 realstar 整数 否 消息体 默认值0 profstar 整数 否 消息体 默认值0 certificated 整数 否 消息体 默认值0 token 字符串 是 请求头 用户身份认证令牌 响应信息:
-
新增成功 - 状态码201:
{"agentid": 8,"estates": [],"name": "孙小美","tel": "13800991234","servstar": 0,"realstar": 0,"profstar": 0,"certificated": false} -
未提供身份认证信息 - 状态码401:
{"detail": "不正确的身份认证信息。"} -
当前用户没有操作权限 - 状态码403:
{"detail": "您没有执行该操作的权限。"}
-
-
编辑房地产经理人信息 - PUT
/api/agents/{房地产经理人编号}/开发者:骆昊
版本号:v1
接口说明:暂无。
使用帮助:需要登录且拥有管理员权限,用户身份令牌在请求头中提供。
请求参数:
参数名 类型 是否必填 参数位置 说明 name 字符串 是 消息体 经理人姓名 tel 字符串 是 消息体 经理人手机 servstar 整数 否 消息体 默认值0 realstar 整数 否 消息体 默认值0 profstar 整数 否 消息体 默认值0 certificated 整数 否 消息体 默认值0 token 字符串 是 请求头 用户身份认证令牌 响应信息:
- 更新成功 - 状态码200:
{"agentid": 1,"estates": [{"estateid": 1,"name": "今日家园","hot": 20},{"estateid": 2,"name": "翡翠园","hot": 30},{"estateid": 3,"name": "万科城市花园","hot": 22}],"name": "袁晓梦","tel": "158173555285","servstar": 5,"realstar": 4,"profstar": 3,"certificated": true}- 未提供身份认证信息 - 状态码403 - 与新增类同
- 当前用户没有操作权限 - 状态码403 - 与新增类同
-
删除房地产经理人 - DELETE
/api/agents/{房地产经理人编号}/开发者:骆昊
版本号:v1
接口说明:暂无。
使用说明:暂无。
请求参数:
参数名 类型 是否必填 参数位置 说明 token 字符串 是 请求头 用户身份认证令牌 响应信息:
- 删除成功 - 状态码204
- 未提供身份认证信息 - 状态码403 - 与新增类同
- 当前用户没有操作权限 - 状态码403 - 与新增类同
-
分页获取楼盘信息 - GET
/api/estates/开发者:骆昊
版本号:v1
接口说明:经理人姓名按照前缀模糊匹配的方式进行处理;经理人服务星级是指经理人服务星级不得低于该星级;经理人是否持证只有0(未持证上岗)和1(持证上岗)两个选项。三个参数代表的筛选条件之间是而且的关系。返回结果为分页之后的房地产经理人信息。
使用帮助:暂无。
请求参数:
参数名 类型 是否必填 参数位置 说明 name 字符串 否 查询参数 楼盘名(模糊匹配) dist 字符串 否 查询参数 楼盘所在地区编号 page 整数 否 查询参数 页码,默认值为1 size 整数 否 查询参数 页面大小,默认值为5,最大值不超过50 响应信息:
{"count": 16,"next": "https://120.77.222.217/api/estates/?page=2","previous": null,"results": [{"estateid": 6,"district": {"distid": 440303,"name": "罗湖区"},"agents": [{"agentid": 2,"name": "杨伟","tel": "13352939550","servstar": 3},{"agentid": 4,"name": "郭志鹏","tel": "13686810707","servstar": 4}],"name": "幸福里","hot": 300,"intro": ""}]} -
新增楼盘 - POST
/api/estates/
开发者:骆昊
版本号:v1
接口说明:暂无。
使用帮助:需要登录且拥有管理员权限,用户身份令牌在请求头中提供。
请求参数:
| 参数名 | 类型 | 是否必填 | 参数位置 | 说明 |
|---|---|---|---|---|
| name | 字符串 | 是 | 消息体 | 楼盘名称 |
| hot | 整数 | 否 | 消息体 | 楼盘热度,默认值0 |
| intro | 字符串 | 否 | 消息体 | 楼盘介绍,默认值空字符串 |
| distid | 整数 | 是 | 消息体 | 楼盘所在地区编号 |
| token | 字符串 | 是 | 请求头 | 用户身份认证令牌 |
响应信息:
-
新增成功 - 状态码201:
{"estateid": 17,"district": 510107,"name": "世纪锦苑","hot": 100,"intro": ""} -
未提供身份认证信息 - 状态码403:
{"detail": "请提供有效的身份认证信息"} -
当前用户没有操作权限 - 状态码403:
{"detail": "You do not have permission to perform this action."}
-
编辑楼盘信息 - PUT
/api/estates/{楼盘编号} -
删除楼盘信 - DELETE
/api/estates/{楼盘编号} -
获取所有户型信息 - GET
/api/housetypes/ -
新增户型 - POST
/api/housetypes/ -
编辑户型信息 - PUT
/api/housetypes/{户型编号} -
删除户型 - DELETE
/api/housetypes/{户型编号} -
分页获取房源信息 - GET
/api/houseinfos/开发者:骆昊
版本号:v1
接口说明:暂无。
使用帮助:暂无。
请求参数:
参数名 类型 是否必填 参数位置 说明 title 字符串 否 查询参数 房源标题关键词 dist 整数 否 查询参数 楼盘所在地区编号 min_price 整数 否 查询参数 价格区间下限 max_price 整数 否 查询参数 价格区间上限 type 整数 否 查询参数 户型编号 page 整数 否 查询参数 页码,默认值为1 size 整数 否 查询参数 页面大小,默认值为5,最大值不超过50 响应信息:
{"count": 7,"next": "http://localhost:8000/api/houseinfos/?dist=440303&page=2","previous": null,"results": []} -
查看房源详情 - GET
/api/houseinfos/{房源编号} -
新增房源 - POST
/api/houseinfos/ -
编辑房源信息 - PUT
/api/houseinfos/{房源编号} -
删除房源 - DELETE
/api/houseinfos/{房源编号} -
随机获取指定数量的房源标签 - GET
/api/tags/ -
分页查看房源标签 - GET
/api/tags/ -
新增房源标签 - POST
/api/tags/ -
删除房源标签 - DELETE
/api/tags/{房源编号} -
查看房源的图片 - GET
/api/houseinfos/{房源编号}/photos/ -
为房源添加图片 - POST
/api/houseinfos/{房源编号}/photos/ -
删除房源图片 - DELETE
/api/houseinfos/{房源编号}/photos/{图片编号}
05 那些年我们踩过的那些坑
坑1 - 整数比较的坑
在 Python 中一切都是对象,整数也是对象,在比较两个整数时有两个运算符==和is,它们的区别是:
is比较的是两个整数对象的id值是否相等,也就是比较两个引用是否代表了内存中同一个地址。==比较的是两个整数对象的内容是否相等,使用==时其实是调用了对象的__eq__()方法。
知道了is和==的区别之后,我们可以来看看下面的代码,了解Python中整数比较有哪些坑,以CPython解释器为例,大家先看看下面的代码。
def main(): x = y = -1 while True: x += 1 y += 1 if x is y: print('%d is %d' % (x, y)) else: print('Attention! %d is not %d' % (x, y)) break
x = y = 0 while True: x -= 1 y -= 1 if x is y: print('%d is %d' % (x, y)) else: print('Attention! %d is not %d' % (x, y)) break
if __name__ == '__main__': main()上面代码的部分运行结果如下图所示。这个结果是因为CPython出于性能优化的考虑,把频繁使用的整数对象用一个叫small_ints的对象池缓存起来造成的。small_ints缓存的整数值被设定为[-5, 256]这个区间,也就是说,如果使用CPython解释器,在任何引用这些整数的地方,都不需要重新创建int对象,而是直接引用缓存池中的对象。如果整数不在该范围内,那么即便两个整数的值相同,它们也是不同的对象。
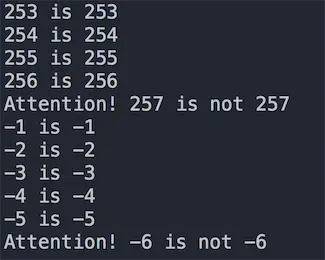
当然仅仅如此这个坑就不值一提了,如果你理解了上面的规则,我们就再看看下面的代码。
a = 257
def main(): b = 257 # 第6行 c = 257 # 第7行 print(b is c) # True print(a is b) # False print(a is c) # False
if __name__ == "__main__": main()程序的执行结果已经用注释写在代码上了。够坑吧!看上去a、b和c的值都是一样的,但是is运算的结果却不一样。为什么会出现这样的结果,首先我们来说说Python程序中的代码块。所谓代码块是程序的一个最小的基本执行单位,一个模块文件、一个函数体、一个类、交互式命令中的单行代码都叫做一个代码块。上面的代码由两个代码块构成,a = 257是一个代码块,main函数是另外一个代码块。CPython底层为了进一步提升性能还做了一个设定:对于同一个代码块中值不在small_ints缓存范围之内的整数,如果同一个代码块中已经存在一个值与其相同的整数对象,那么就直接引用该对象,否则创建新的int对象。需要大家注意的是,这条规则对数值型适用,但对字符串则需要考虑字符串的长度,这一点可以自行证明。
为了验证刚刚的结论,我们可以借用dis模块(听名字就知道是进行反汇编的模块)从字节码的角度来看看这段代码。如果不理解什么是字节码,可以先看看《谈谈 Python 程序的运行原理》这篇文章。可以先用import dis导入dis模块并按照如下所示的方式修改代码。
import dis
dis.dis(main)代码的执行结果如下图所示。可以看出代码第6行和第7行,也就是main函数中的257是从同一个位置加载的,因此是同一个对象;而代码第9行的a明显是从不同的地方加载的,因此引用的是不同的对象。
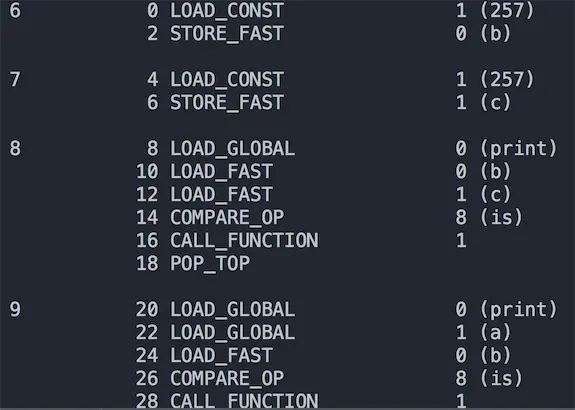
如果还想对这个问题进行进一步深挖,推荐大家阅读《Python整数对象实现原理》这篇文章。
坑2 - 嵌套列表的坑
Python中有一种内置的数据类型叫列表,它是一种容器,可以用来承载其他的对象(准确的说是其他对象的引用),列表中的对象可以称为列表的元素,很明显我们可以把列表作为列表中的元素,这就是所谓的嵌套列表。嵌套列表可以模拟出现实中的表格、矩阵、2D游戏的地图(如植物大战僵尸的花园)、棋盘(如国际象棋、黑白棋)等。但是在使用嵌套的列表时要小心,否则很可能遭遇非常尴尬的情况,下面是一个小例子。
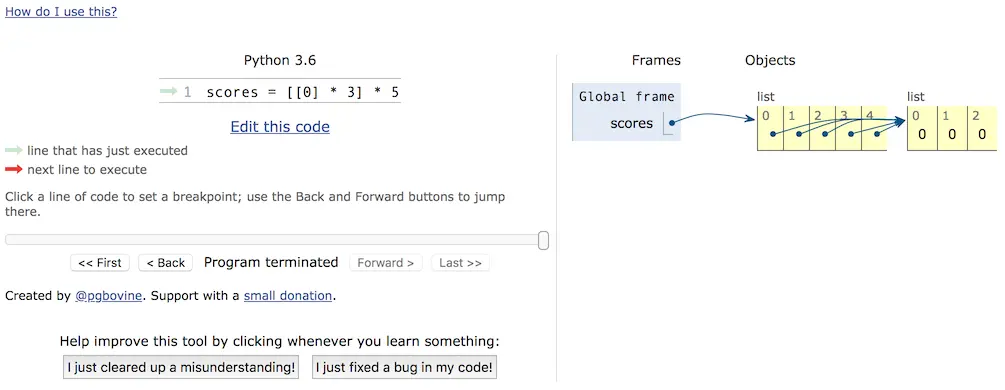
names = ['关羽', '张飞', '赵云', '马超', '黄忠']subjs = ['语文', '数学', '英语']scores = [[0] * 3] * 5for row, name in enumerate(names): print('请输入%s的成绩' % name) for col, subj in enumerate(subjs): scores[row][col] = float(input(subj + ': ')) print(scores)我们希望录入5个学生3门课程的成绩,于是定义了一个有5个元素的列表,而列表中的每个元素又是一个由3个元素构成的列表,这样一个列表的列表刚好跟一个表格是一致的,相当于有5行3列,接下来我们通过嵌套的for-in循环输入每个学生3门课程的成绩。程序执行完成后我们发现,每个学生3门课程的成绩是一模一样的,而且就是最后录入的那个学生的成绩。
要想把这个坑填平,我们首先要区分对象和对象的引用这两个概念,而要区分这两个概念,还得先说说内存中的栈和堆。我们经常会听人说起“堆栈”这个词,但实际上“堆”和“栈”是两个不同的概念。众所周知,一个程序运行时需要占用一些内存空间来存储数据和代码,那么这些内存从逻辑上又可以做进一步的划分。对底层语言(如C语言)有所了解的程序员大都知道,程序中可以使用的内存从逻辑上可以为五个部分,按照地址从高到低依次是:栈(stack)、堆(heap)、数据段(data segment)、只读数据段(static area)和代码段(code segment)。其中,栈用来存储局部、临时变量,以及函数调用时保存现场和恢复现场需要用到的数据,这部分内存在代码块开始执行时自动分配,代码块执行结束时自动释放,通常由编译器自动管理;堆的大小不固定,可以动态的分配和回收,因此如果程序中有大量的数据需要处理,这些数据通常都放在堆上,如果堆空间没有正确的被释放会引发内存泄露的问题,而像Python、Java等编程语言都使用了垃圾回收机制来实现自动化的内存管理(自动回收不再使用的堆空间)。所以下面的代码中,变量a并不是真正的对象,它是对象的引用,相当于记录了对象在堆空间的地址,通过这个地址我们可以访问到对应的对象;同理,变量b是列表容器的引用,它引用了堆空间上的列表容器,而列表容器中并没有保存真正的对象,它保存的也仅仅是对象的引用。
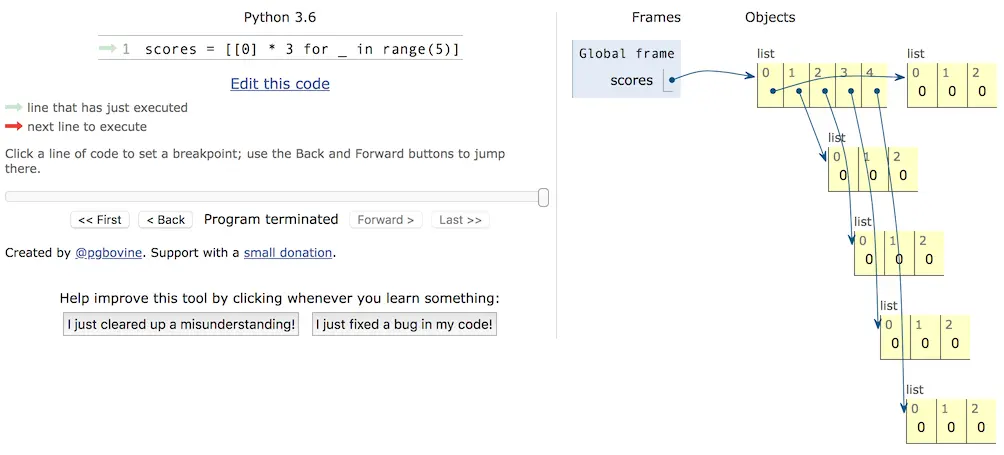
a = object()b = ['apple', 'pitaya', 'grape']知道了这一点,我们可以回过头看看刚才的程序,我们对列表进行[[0] * 3] * 5操作时,仅仅是将[0, 0, 0]这个列表的地址进行了复制,并没有创建新的列表对象,所以容器中虽然有5个元素,但是这5个元素引用了同一个列表对象,这一点可以通过id函数检查scores[0]和scores[1]的地址得到证实。所以正确的代码应该按照如下的方式进行修改。
names = ['关羽', '张飞', '赵云', '马超', '黄忠']subjs = ['语文', '数学', '英语']scores = [[]] * 5for row, name in enumerate(names): print('请输入%s的成绩' % name) scores[row] = [0] * 3 for col, subj in enumerate(subjs): scores[row][col] = float(input(subj + ': ')) print(scores)或者
names = ['关羽', '张飞', '赵云', '马超', '黄忠']subjs = ['语文', '数学', '英语']scores = [[0] * 3 for _ in range(5)]for row, name in enumerate(names): print('请输入%s的成绩' % name) scores[row] = [0] * 3 for col, subj in enumerate(subjs): scores[row][col] = float(input(subj + ': ')) print(scores)如果对内存的使用不是很理解,可以看看PythonTutor网站上提供的代码可视化执行功能,通过可视化执行,我们可以看到内存是如何分配的,从而避免在使用嵌套列表或者复制对象时可能遇到的坑。
坑3 - 访问修饰符的坑
用Python做过面向对象编程的人都知道,Python的类提供了两种访问控制权限,一种是公开,一种是私有(在属性或方法前加上双下划线)。而用惯了Java或C#这类编程语言的人都知道,类中的属性(数据抽象)通常都是私有的,其目的是为了将数据保护起来;而类中的方法(行为抽象)通常都是公开的,因为方法是对象向外界提供的服务。但是Python并没有从语法层面确保私有成员的私密性,因为它只是对类中所谓的私有成员进行了命名的变换,如果知道命名的规则照样可以直接访问私有成员,请看下面的代码。
class Student(object):
def __init__(self, name, age): self.__name = name self.__age = age
def __str__(self): return self.__name + ': ' + str(self.__age)
stu = Student('骆昊', 38)print(stu._Student__name)print(stu._Student__age)Python为什么要做出这样的设定呢?用一句广为流传的格言来解释这个问题:“We are all consenting adults here”(我们都是成年人)。这句话表达了很多Python程序员的一个共同观点,那就是开放比封闭要好,我们应该自己对自己的行为负责而不是从语言层面来限制对数据或方法的访问。
所以在Python中我们实在没有必要将类中的属性或方法用双下划线开头的命名处理成私有的成员,因为这并没有任何实际的意义。如果想对属性或方法进行保护,我们建议用单下划线开头的受保护成员,虽然它也不能真正保护这些属性或方法,但是它相当于给调用者一个暗示,让调用者知道这是不应该直接访问的属性或方法,而且这样做并不影响子类去继承这些东西。
需要提醒大家注意的是,Python类中的那些魔法方法,如__str__、__repr__等,这些方法并不是私有成员哦,虽然它们以双下划线开头,但是他们也是以双下划线结尾的,这种命名并不是私有成员的命名,这一点对初学者来说真的很坑。
06 如何快速驾驭 pandas 库
最近有小伙伴提到,Python 做数据分析的 pandas 库函数和方法实在太多,感觉学习和使用起来思路都非常混乱。之前回复过这个问题,今天把它更系统的整理一下,毕竟这个库是 Python 数据科学生态圈中扮演着极为重要的角色,虽然目前有很多 pandas 库的替代品(如:polars、cuDF等),但是使用方法跟 pandas 可以说是大同小异。
三个核心类
Pandas 库有三个最核心的类,其中最重要的是DataFrame类型,它是学习的重点,如下图所示。
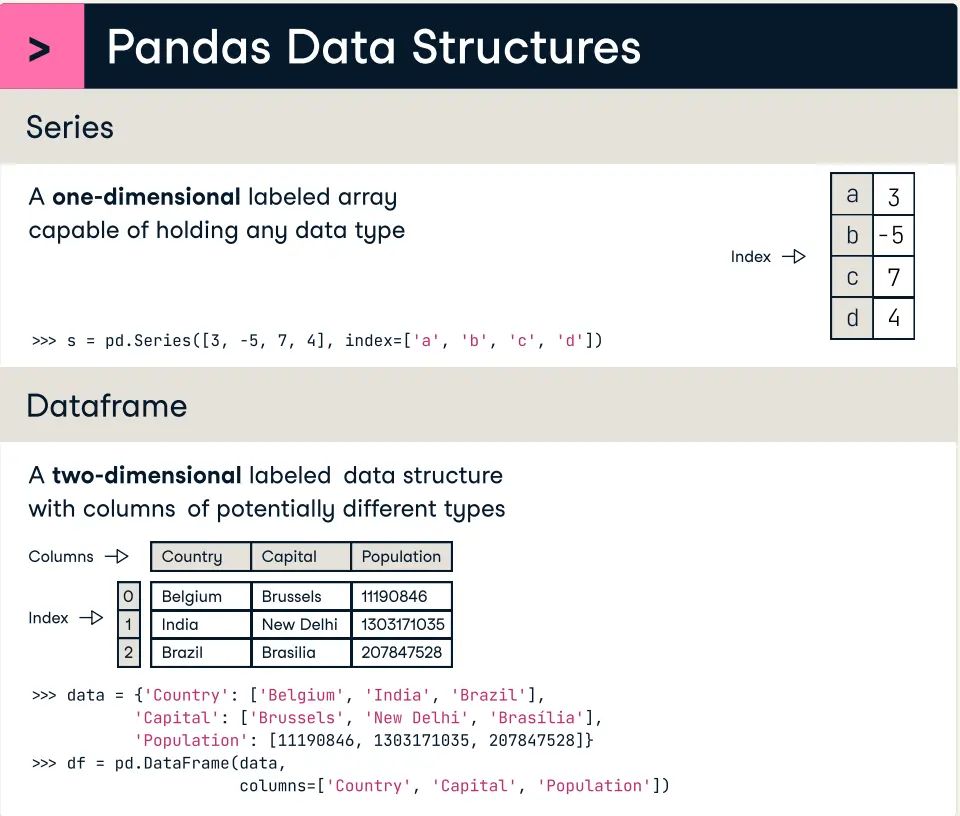
Series:表示一维数据,跟一维数组类似(带标签的数组),每个数据都有自己的索引(标签),可以通过索引访问数据。DataFrame:表示二维数据,类似于 Excel 电子表格,行和列都有自己的索引(标签),可以通过索引访问行、列、单元格。Index:表示索引,为Series和DataFrame提供索引服务,Index有很多的子类型,适用于需要不同类型的索引的场景。
数据分析流程
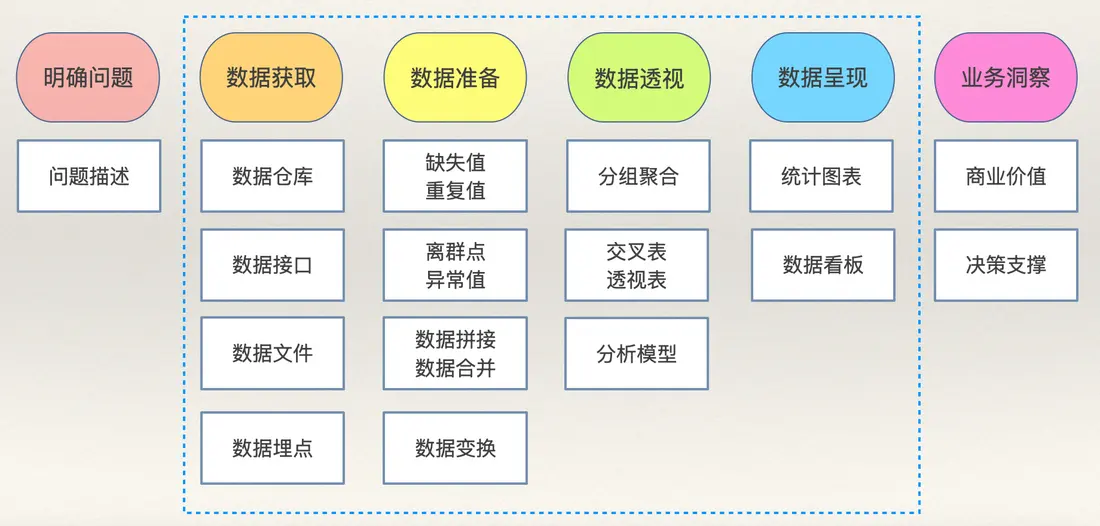
学习和使用 pandas 重点是DataFrame的应用,我们建议大家按照数据分析的流程来掌握对应的函数和方法,这样做往往会事半功倍。数据分析流程如下图所示,其中蓝色虚线圈中的部分就是可以通过 BI 工具(如:Power BI、Tableau等)或 Python 程序来完成的部分。
数据获取
数据获取也可以称为数据加载,其本质就是创建DataFrame对象,需要掌握以下几个函数:
- 从 CSV 文件加载数据。
pd.read_csv( filepath, # CSV文件路径(可以本地绝对路径或相对路径,也可以是一个URL) sep, # 字段分隔符(默认是逗号) header, # 表头在第几行 encoding, # 文件编码(默认utf-8) quotechar, # 包裹字符串的符号(默认是双引号) usecols, # 加载哪些列 index_col, # 指定索引列 dtype, # 指定列的数据类型 converters, # 指定列的数据转换器 nrows, # 加载多少行数据 skiprows, # 指定需要跳过的行 parse_dates, # 将哪些列解析为日期时间 date_format, # 日期格式 true_values, # 被视为布尔值True的值 false_values, # 被视为布尔值False的值 na_values, # 被视为空值的值 na_filter, # 是否检测空值标记 on_bad_lines, # 遇到有问题的行如何处理(可选项:'error'、'warn'、'skip') engine, # 指定底层引擎(例如:可以使用更快的Arrow引擎来处理体量更大的数据) iterator, # 是否开启迭代器模式(处理大数据时减少内存开销) chunksize, # 迭代器模式下每次加载数量的体量)- 从 Excel 文件加载数据。
pd.read_excel( io, # 工作簿文件的路径 sheet_name, # 工作表的名字 skip_footer, # 跳过末尾多少行)说明:
read_excel函数跟read_csv有很多作用相同的参数,这里就没有赘述了。从 Excel 文件中加载数据时,没有迭代器模式。
- 从数据库或数仓加载数据。
pd.read_sql( sql, # SQL查询或二维表的名字 con, # 数据库连接 parse_dates, # 指定需要解析成日期的列 index_col, # 指定索隐裂 columns, # 需要加载的列 chunksize, # 加载数据的体量 dtype, # 指定列的数据类型)- 其他创建
DataFrame对象的方式。
pd.DataFrame(data=[[95, 87], [66, 78], [92, 89]], index=[1001, 1002, 1003], columns=['Verbal', 'Math'])pd.DataFrame(data={'Verbal': [95, 66, 92], 'Math': [87, 78, 89]}, index=[1001, 1002, 1003])如果要对DataFrame中的数据或索引进行操作,需要掌握下面的运算和方法。
- 查看信息
df.info()- 查看前/后 N 行
df.head(10)df.tail(5)- 操作列
df['column_name']df.colume_name- 操作行
df.loc['row_index']df.iloc[0]- 操作单元格
df.at['row_index', 'column_name']df.iat[0, 0]- 删除行或列
df.drop( labels, # 要删除的行或列的索引 axis, # axis=0,labels表示行索引;axis=1,labels表示列索引 index, # 要删除的行的索引 columns, # 要删除的列的索引 inplace, # 是否就地删除(inplace=True,表示就地删除不返回新DataFrame对象))- 筛选数据
df.query(expr) # 通过表达式指定筛选条件df[bool_index] # 布尔索引- 随机抽样
df.sampe( n, # 样本容量 frac, # 抽样比例 replace, # 有放回或无放回抽样(默认值False) random_state, # 随机数种子(种子相同每次抽样的结果相同))- 重置索引
df.reset_index( level, # 对于多级索引指定重置哪一级的索引 drop, # 是否丢弃索引(drop=False表示索引会被处理成普通列) inplace, # 是否就地处理(要不要返回新的DataFrame对象))- 设置索引
df.set_index( keys, # 指定作为索引的列 drop, # 是否删除作为索引的列(默认值True) append, # 是否将指定列加入现有的索引(默认值False) inplace, # 是否就地处理(要不要返回新的DataFrame对象) verify_integrity, # 检查索引列是否存在重复值(默认值False))- 调整索引顺序
df.reindex()df[fancy_index] # 花式索引df.loc[facy_index] # 花式索引df.iloc[fancy_index] # 花式索引- 索引排序
df.sort_index( axis, # 确定行索引或列索引(默认值0) level, # 对于多级索引指定索引的级别 ascending, # 升序或降序(默认值True) inplace, # 是否就地排序 kind, # 排序算法(默认值'quicksort') na_position, # 空值放在最前还是最后(默认值'last') key, # 传入比较索引大小的函数(自定义比较规则))数据重塑
- 拼接(类似于 SQL 中的 union 操作)
pd.concat( objs, # 保存多个DataFrame对象的容器 axis, # 沿着哪个轴进行拼接 ignore_index, # 是否忽略原来的索引(默认值False))- 合并(类似于 SQL 中的 join 操作)
pd.merge( left, # 左表 right, # 右表 how, # 指定连表的方式(默认值'inner'表示内连接) on, # 指定连表字段(如果左右两表连表字段同名) left_on, # 指定左表的连表字段 right_on, # 指定右表的连表字段 left_index, # 是否使用左表的索引连表 right_index, # 是否使用右表的索引连表 suffixes, # 指定同名列的后缀(默认值('_x', '_y')))数据清洗
- 缺失值
# 甄别缺失值df.isna()df.notna()# 删除缺失值df.dropna( axis, # 删行或删列(默认值0) how, # 是否存在任意一个缺失值就删除(默认值'any') subset, # 只对哪些行或列删除空值 inplace, # 是否就地删除(要不要返回新的DataFrame对象))# 填充缺失值df.fillna( value, # 填充的值 method, # 填充空值的方法 inplace, # 是否就地填充(要不要返回新的DataFrame对象))# 使用插值算法插值df.interpolate( method, # 插值算法(默认值'linear'表示线性插值法) axis, # 沿着哪个轴插值 inplace, # 是否就地插值(要不要返回新的DataFrame对象))- 重复值
# 甄别重复值df.duplicated( subset, # 用于判断重复的列标签 keep, # 如何处理重复项(默认值'first'表示保留第一项))# 删除重复值df.drop_duplicates( subset, # 用于判断重复的列标签 keep, # 如何处理重复项(默认值'first'表示保留第一项) inplace, # 是否就地去重(默认值False))# 统计非重复值df.nunique(axis)- 异常值
异常值的处理重点在甄别,可以使用数值判定法、z-score 判定法、孤立森林等方法来进行甄别离群点,然后结合实际业务意义判定是不是异常值。对于异常值的处理,通常是替换或删除,删除可以用之前提到的drop方法删行或者删列。
# 替换异常值df.replace( to_replace, # 被替换的值 value, # 替换的值 inplace, # 是否就地替换(要不要返回新的DataFrame对象) regex, # 是否启动正则表达式替换(默认值False))- 预处理
预处理通常在Series对象上对数据进行操作,假设变量s是一个Series对象,具体的操作包括:
- 日期时间预处理
s.dt.year # 年s.dt.quarter # 季度s.dt.month # 月s.dt.day # 日s.dt.hour # 时s.dt.minute # 分s.dt.second # 秒s.dt.weekday # 星期几s.dt.to_period(freq) # 以特定频率转换s.dt.floor(freq) # 下取整s.dt.ceil(freq) # 上取整s.dt.round(freq) # 舍入s.dt.strftime(date_format) # 格式化s.dt.tz_localize(tz) # 时区本地化s.dt.tz_convert(tz) # 转换时区- 字符串预处理
s.str.lower() # 字符串变小写s.str.upper() # 字符串变大写s.str.title() # 字符串首字母大写# 字符串拆分s.str.split( pat, # 拆分字符或正则表达式 n, # 最大拆分次数 expand, # 是否将拆分后的内容展开成多个列(默认值False))# 从字符串中捕获内容s.str.extract( pat, # 正则表达式 flags, # 正则表达式处理标记 expand, # 是否将捕获内容展开成多个列(默认值True))s.str.isalpha() # 检查字符串是不是字母s.str.isnumeric() # 检查字符串是不是数值s.str.isalnum() # 检查字符串是不是字母数字s.str.isspace() # 检查字符串是不是空白字符s.str.startswith() # 检查字符串是否以指定内容开头s.str.endswith() # 检查字符串是否以指定内容结尾# 检查字符串是否跟正则表达式匹配s.str.match( pat, # 正则表达式 flags, # 正则表达式处理标记)# 检查字符串是否包含指定内容s.str.contains( pat, # 字符串或正则表达式 flags, # 正则表达式处理标记 regex, # 是否使用正则表达式(默认值True))# 替换s.str.replace( pat, # 被替换的内容(字符串或正则表达式) repl, # 替换的内容 n, # 最大替换次数(默认值-1表示全部替换) flags, # 正则表达式处理标记 regex, # 是否使用正则表达式(默认值True))s.str.strip() # 去掉字符串多余的空格s.str.join(sep) # 用指定的分隔符将内容拼接成字符串# 字符串拼接s.str.cat( others, # 拼接的内容 sep, # 分隔符 na_rep, # 空值的替代符)s.str.len() # 获得字符串长度# 查找子串的位置s.str.find( sub, # 子串 start, # 起始位置 end, # 结束位置)- 类别预处理
# 类别重排序s.cat.reorder_categories( new_categories, # 新的类别顺序 inplace, # 是否就地处理(默认值False))# 添加类别s.cat.add_categories( new_categories, # 要添加的新类别 inplace, # 是否就地处理(默认值False))# 移除类别s.cat.remove_categories( removals, # 要移除的类别 inplace, # 是否就地处理(默认值False))# 移除没有使用的类别s.cat.remove_unused_categories( inplace, # 是否就地处理(默认值False))# 类别重命名s.cat.rename_categories( new_categories, # 新的类别名称 inplace, # 是否就地处理(默认值False))- 二值化(虚拟变量)
pd.get_dummies( data, # 需要转换为虚拟变量的Series或DataFrame prefix, # 指定生成的虚拟变量列的前缀 prefix_sep, # 前缀和列名之间的分隔符 dummy_na, # 是否为空值(NaN)生成一个列(默认值False) columns, # 指定要转换的列名 drop_first, # 是否从生成的虚拟变量中删除第一个类别的列(默认值False))- 离散化(分箱)
pd.cut( x, # 要分割的输入数据(一维数据) bins, # 分割的区间数或具体的区间边界 right, # 区间是否包含右端点(默认值False) labels, # 指定每个区间的标签 retbins, # 是否返回分割的边界数组(默认值False) ordered, # 返回的类别是否是有序的(默认值True))pd.qcut( x, # 要分割的输入数据(一维数据) q, # 分割点的数量或具体的分位数 labels, # 指定每个区间的标签 retbins, # 是否返回分割的边界数组(默认值False))- 自定义转换
s.map(arg) # 对数据进行元素级别的转换和映射df.map(func) # 对数据进行元素级别的转换和映射# 通过指定函数对数据进行元素级别的转换s.apply( func, # 作用于每个元素的函数 convert_type, # 尝试将结果转换为最适合的类型(默认值True) args, # 传递给func的额外位置参数 kwargs, # 传递给func的额外关键字参数)# 通过指定函数对数据进行行级或列级的转换df.apply( func, # 作用域行或列的函数 axis, # 控制做行级还是列级转换 result_type, # 指定返回的类型('expand'表示扩展为列,'reduce'表示返回标量,'broadcast'表示广播为原始形状) args, # 传递给func的额外位置参数 kwargs, # 传递给func的额外关键字参数)s.transform(func) # 通过指定一个或多个函数对数据进行元素级别的转换df.transform(func) # 通过指定一个或多个函数对数据进行行级或列级转换数据透视
- 描述性统计信息
s.mean() # 均值s.median() # 中位数s.mode() # 众数s.max() # 最大值s.min() # 最小值s.var(ddof) # 方差(ddof代表自由度校正值)s.std(ddof) # 标准差(ddof代表自由度校正值)s.skew() # 偏态系数s.kurt() # 峰度系数- 相关性分析
df.cov() # 协方差df.corr(method) # 相关系数(默认'pearson'表示皮尔逊相关系数,可选值还有'kendall'和'spearman')- 排序和头部值
# 排序s.sort_values( asending, # 升序或降序(默认值True) inplace, # 是否就地排序(默认值False) kind, # 排序算法(默认值'quicksort') na_position, # 空值的位置(默认值'last') key, # 指定比较元素的规则(函数))# 排序df.sort_values( by, # 排序的依据 ascending, # 升序或降序(默认值True) inplace, # 是否就地排序(默认值False) kind, # 排序算法(默认值'quicksort') na_position, # 空值的位置(默认值'last') key, # 指定比较元素的规则(函数))# TopN元素(头部)s.nlargest( n, # 前N个最大值 keep, # 如何处理重复值(默认值'first'))# TopN元素(头部)df.nlargest( n, # 前N个最大值 columns, # 指定用于排序的列名 keep, # 如何处理重复值(默认值'first'))# TopN元素(尾部)s.nsmallest( n, # 前N个最小值 keep, # 如何处理重复值(默认值'first'))# TopN元素(尾部)df.nsmallest( n, # 前N个最小值 columns, # 指定用于排序的列名 keep, # 如何处理重复值(默认值'first'))- 分组聚合
df.groupby( by, # 指定用于分组的列名 level, # 对于多级索引指定用哪一级分组 as_index, # 是否将分组的列设置为索引(默认值True) sort, # 是否对分组的结果进行排序(默认值True) observed, # 只考虑在数据中实际出现的分组(默认值False)).aggregate( func, # 单个函数或函数列表 args, # 函数的可变参数 kwargs, # 函数的关键字参数)df.pivot( index, # 指定用作索引的列 columns, # 要作为新列的列 values, # 用于填充新DataFrame中的值的列)df.melt( id_vars, # 在转换过程中保持不变的列 value_vars, # 要转换为行的列 var_name, # 指定存储原列名的新列名 value_name, # 指定存储原数据值的新列名)- 透视表
pd.pivot_table( data, # DataFrame对象 values, # 需要聚合的列 index, # 分组数据的字段(行索引) columns, # 分组数据的字段(列索引) aggfunc, # 聚合函数(默认值'mean') fill_value, # 填充空值的值 margins, # 是否计算行列总计(默认值False) margins_name, # 总计列的名字(默认值'All') observed # 只考虑在数据中实际出现的分组(默认值False))- 交叉表
pd.crosstab( index, # 交叉表中的行变量 columns, # 交叉表中的列变量 values, # 用于填充交叉表的值(可选项) aggfunc, # 聚合函数(可选项) margins, # 是否计算行列总计(默认值False) margins_name, # 总计列的名字(默认值'All'))数据呈现
df.plot( figsize, # 图表尺寸(二元组) kind, # 图表类型 ax, # 绘图的坐标系 x, # 横轴数据 y, # 纵轴数据 title, # 图表标题 grid, # 是否绘制网格 legend, # 是否显示图例 xticks, # 横轴刻度 yticks, # 纵轴刻度 xlim, # 横轴取值范围 ylim, # 纵轴取值范围 xlabel, # 横轴标签 ylabel, # 纵轴标签 rot, # 轴标签旋转角度 fontsize, # 轴标签字体大小 colormap, # 颜色系列 stacked, # 是否绘制堆叠图(默认值False) colorbar, # 是否显示色彩条)plot方法最重要的参数是kind,它可以控制图表的类型,具体如下所示:
- 折线图:
kind='line' - 散点图:
kind='scatter' - 柱状图:
kind='bar' - 条状图(水平柱状图):
kind='barh' - 饼状图:
kind='pie' - 直方图:
kind='hist' - 箱线图:
kind='box' - 面积图:
kind='area' - 核密度估计图:
kind='kde'
总结
大家可以找一个数据集按照上面讲解的流程把这些最常用的类型、函数和方法过一遍,是不是印象就深刻一点了。更详细的内容还是推荐阅读我的专栏《基于Python的数据分析》或者观看B站上的视频《Python数据分析三剑客》。
07 使用Hexo搭建自己的博客
对于一个程序员来说,搭建一个属于自己的博客平台是非常有意义的事情。首先,博客可以记录自己的成长历程,也是对自己一段时间学习和工作的总结和沉淀;其他,通过博客可以营销自己,增强自己在互联网或行业内的影响力,为将来更好的职业生涯打一个坚实的基础。前几年有一本名为《软技能 - 代码之外的生存指南》的畅销书,我记得书中有这么一段话:“流行乐队的音乐才华可能并不比夜店驻场乐队高多少,他们为什么就可以在全世界巡回演出,创造一个又一个白金记录?……你的营销做得越好,你的才华才能表现得淋漓尽致。”
这里顺便啰嗦两句,在互联网如此发达的今天,我们应该如何营销自己呢?自我营销首先要从打造个人品牌做起,对于程序员来说,最容易去做好的一件事情还是搭建自己的博客。博客相当于是你在互联网上的一个基地,尤其是当你拥有了属于自己的独立博客后,你可以做很多自己想做的事情,既可以传达自己的思想,又可以提升自己的影响力,当然如果你的博客经营得非常好,你可以从中获利。当然,除了博客,直播、视频网站、投稿、写书、技术活动都是可选的自我营销方式。当然,做自我营销也需要持之以恒,三天打鱼两天晒网是很难有什么收获的。
Hexo概述
Hexo 是一个快速、简洁且高效的博客框架,它能够将 Markdown 文档渲染成漂亮的网页,这样我们就可以在很短的时间内迅速的创建出网站的静态内容,而 Markdown 格式对程序员来说相信并不陌生。要想使用Hexo来搭建自己的博客,我实在想不出有什么教程比官方文档更好,强烈建议大家阅读官方文档来了解 Hexo,下面我只做一个简要的使用说明。
说明:**Markdown **是一种轻量级标记语言,它允许人们使用易读易写的纯文本格式编写文档,同时也对图片、图表、数学公式提供了支持,可以用来书写电子书、软件文档等,同时也可以非常方便的转换为 HTML 页面或者是 PDF 文档。
要使用 Hexo,首先得确保计算机上已经安装了 node.js 环境和 git 环境,前者是一个能够在服务器端运行 JavaScript 代码的环境,后者是版本控制工具。安装 node.js 主要是为了使用它的包管理工具 npm,所以不需要先系统的学习 node.js 的知识;而安装 git 是为了利用版本控制系统克隆代码已经将博客项目托管到三方平台,如果想学习 git,最好的资料是官方网站上的 Git Pro 和《Git权威指南》。安装完成后,我们可以通过下面的命令来确认 node.js 环境以及它的包管理工具是否安装成功。
node --versionnpm --version可以通过下面的命令来检查是否安装了 git 环境。
git --version我们可以使用 npm 来安装 Hexo,npm 是 node.js 的包管理工具,跟 Python 的 pip 工具作用一样,可以用它来安装依赖库和三方工具。在第一次使用 npm 的时候,我们可以先将 npm 的下载源更换为国内的淘宝镜像,这样下载的速度会有非常显著的提升。
npm config set registry https://registry.npm.taobao.org接下来我们就通过 npm 来安装 Hexo,命令如下所示。
npm install -g hexo-cli安装成功后,就可以使用 Hexo 来创建属于自己的博客啦。
搭建博客
说明:以下内容基本上来自于 Hexo 的官方文档,推荐大家阅读官方文档。
我们先通过下面的命令来创建一个专门保存博客项目的文件夹,该命令会从 github 上克隆博客项目和默认的主题。
hexo init blog接下来我们进入这个文件夹并查看目录结构。
cd blogls -lRtotal 232-rw-r--r-- 1 Hao staff 1768 8 8 01:15 _config.ymldrwxr-xr-x 274 Hao staff 8768 8 8 01:19 node_modules-rw-r--r-- 1 Hao staff 109972 8 8 01:19 package-lock.json-rw-r--r-- 1 Hao staff 443 8 8 01:15 package.jsondrwxr-xr-x 5 Hao staff 160 8 8 01:15 scaffoldsdrwxr-xr-x 3 Hao staff 96 8 8 01:15 sourcedrwxr-xr-x 3 Hao staff 96 8 8 01:15 themes说明:Windows 环境命令行提示符中可以使用
dir命令查看目录结构。需要说明的是:_config.yml是博客项目的配置文件;package.json是项目的依赖项文件;scaffolds保存了 Markdown 文件的模板,也就是向新添加的 Markdown 文件中默认填充的内容;source目录下有一个名为_post的目录,我们稍后可以将编写好的 Markdown 文件放到该目录,这样就可以利用 Hexo 将 Markdown 文件处理成博客的静态页面,生成的静态页面将置于public目录下;themes文件夹保存了博客使用的主题。
然后我们通过下面的命令来安装项目所需的依赖项(package.json文件指明了这些依赖项)。
npm install做完上述的操作以后,我们已经可以直接通过下面的命令来生成博客。
hexo generate该命令也可以缩写为:
hexo g之前我们在安装依赖项的时候包括了一个名为hexo-server的依赖项,该依赖项可以帮助我们启动一个基于 node.js 的服务器来运行我们的博客项目,使用下面的命令即可启动服务器。
hexo server该命令也可以缩写为:
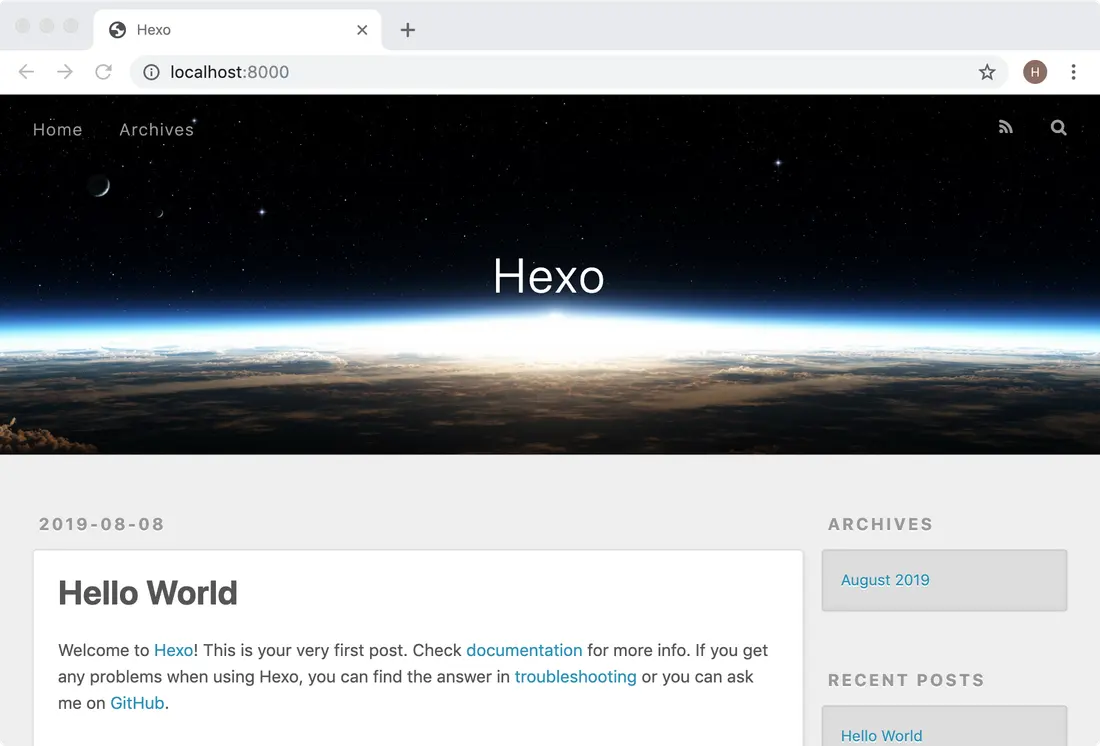
hexo sINFO Start processingINFO Hexo is running at http://localhost:4000 . Press Ctrl+C to stop.从运行命令的提示信息可以看到,服务器已经运转起并使用了 4000 端口,可以通过Ctrl+C来终止服务器的运行。如果要修改服务器使用的端口,可以在启动服务器的时候加上-p参数;如果希望服务器启动后,自动打开默认的浏览器访问服务器,可以使用-o参数,如下所示。
hexo s -p 8000 -o至此,我们已经可以看到 Hexo 在没有配置也没有加入自己的 Markdown 文件下生成的首页,如下图所示。
接下来我们修改博客的配置文件。
vim _config.yml# Hexo Configuration## Docs: https://hexo.io/docs/configuration.html## Source: https://github.com/hexojs/hexo/
# Sitetitle: 骆昊的技术专栏subtitle: 传道、授业、解惑,分享知识带来的快乐description:keywords:author: 骆昊language: zhtimezone:
# URL## If your site is put in a subdirectory, set url as 'http://yoursite.com/child' and root as '/child/'url: http://jackfrued.toproot: /permalink: :year/:month/:day/:title/permalink_defaults:
# Directorysource_dir: sourcepublic_dir: publictag_dir: tagsarchive_dir: archivescategory_dir: categoriescode_dir: downloads/codei18n_dir: :langskip_render:
# Writingnew_post_name: :title.md # File name of new postsdefault_layout: posttitlecase: false # Transform title into titlecaseexternal_link: true # Open external links in new tabfilename_case: 0render_drafts: falsepost_asset_folder: falserelative_link: falsefuture: truehighlight: enable: true line_number: true auto_detect: false tab_replace:
# Home page setting# path: Root path for your blogs index page. (default = '')# per_page: Posts displayed per page. (0 = disable pagination)# order_by: Posts order. (Order by date descending by default)index_generator: path: '' per_page: 10 order_by: -date
# Category & Tagdefault_category: uncategorizedcategory_map:tag_map:
# Date / Time format## Hexo uses Moment.js to parse and display date## You can customize the date format as defined in## http://momentjs.com/docs/#/displaying/format/date_format: YYYY-MM-DDtime_format: HH:mm:ss
# Pagination## Set per_page to 0 to disable paginationper_page: 10pagination_dir: page
# Extensions## Plugins: https://hexo.io/plugins/## Themes: https://hexo.io/themes/theme: landscape
# Deployment## Docs: https://hexo.io/docs/deployment.htmldeploy: type:下面是 YAML 文件中相关选项的说明。
| 参数 | 描述 |
|---|---|
title | 网站的标题 |
subtitle | 网站的副标题 |
description | 网站的描述 |
keywords | 网站的关键词,可以用逗号分隔多个关键词 |
author | 自己的名字 |
language | 网站使用的语言 |
timezone | 网站使用时区,默认使用电脑上设置的时区 |
url | 网址 |
root | 网站根目录 |
source_dir | 资源文件夹,这个文件夹用来存放内容,默认 source 目录 |
public_dir | 公共文件夹,这个文件夹用于存放生成的站点文件,默认 public 目录 |
tag_dir | 标签文件夹,默认 tags 目录 |
archive_dir | 归档文件夹,默认 archives 目录 |
category_dir | 分类文件夹,默认 categories 目录 |
auto_spacing | 在中文和英文之间加入空格,默认 false |
titlecase | 把标题转换为首字母大写,默认 false |
external_link | 在新标签中打开链接,默认 true |
relative_link | 把链接改为与根目录的相对位址,默认 false |
default_category | 默认分类 |
date_format | 日期格式,默认 YYYY-MM-DD |
time_format | 时间格式,默认 HH:mm |
per_page | 每页显示的文章数量 ,默认值 10,0 表示不使用分页 |
pagination_dir | 分页目录,默认为 page 目录 |
theme | 当前主题名称 |
deploy | 部署部分的设置 |
我们将编写好的 Markdown 文件可以拷贝到source/_posts目录,我们可以在每个 Markdown 文件的上方添加 Front-matter 来对文件的布局、标题、分类、标签、发布日期等信息加以说明。所谓 Front-matter,就是每个 Markdown 文件最上方以---分隔的区域,可以在Front-matter中设置以下内容。
| 参数 | 描述 | 默认值 |
|---|---|---|
layout | 布局 | |
title | 标题 | |
date | 建立日期 | 文件建立日期 |
updated | 更新日期 | 文件更新日期 |
comments | 开启文章的评论功能 | true |
tags | 标签(不适用于分页) | |
categories | 分类(不适用于分页) | |
permalink | 覆盖文章网址 |
例如:
---title: Python编程惯例categories:- Python基础tags:- Python- PEP8date: 2019-8-1---## Python惯例
“惯例”这个词指的是“习惯的做法,常规的办法,一贯的做法”,与这个词对应的英文单词叫“idiom”。由于Python跟其他很多编程语言在语法和使用上还是有比较显著的差别,因此作为一个Python开发者如果不能掌握这些惯例,就无法写出“Pythonic”的代码。下面我们总结了一些在Python开发中的惯用的代码。
1. 让代码既可以被导入又可以被执行。 if __name__ == '__main__':
2. 用下面的方式判断逻辑“真”或“假”。 if x: if not x:在完成上述工作后,我们可以通过下面的命令先清理之前生成的内容。
hexo clean接下来我们就可以用之前讲过的命令重新生成并运行博客项目。
hexo generatehexo server -p 8000 -o将博客托管到GitHub
我们可以利用 GitHub 网站提供的 Pages 服务来托管我们的博客。在 GitHub Pages 的首页上就有一个教程指导我们如何托管自己的网站,当然第一步得在 GitHub 上注册一个属于自己的账号,登录成功之后才能进行后续的操作。
-
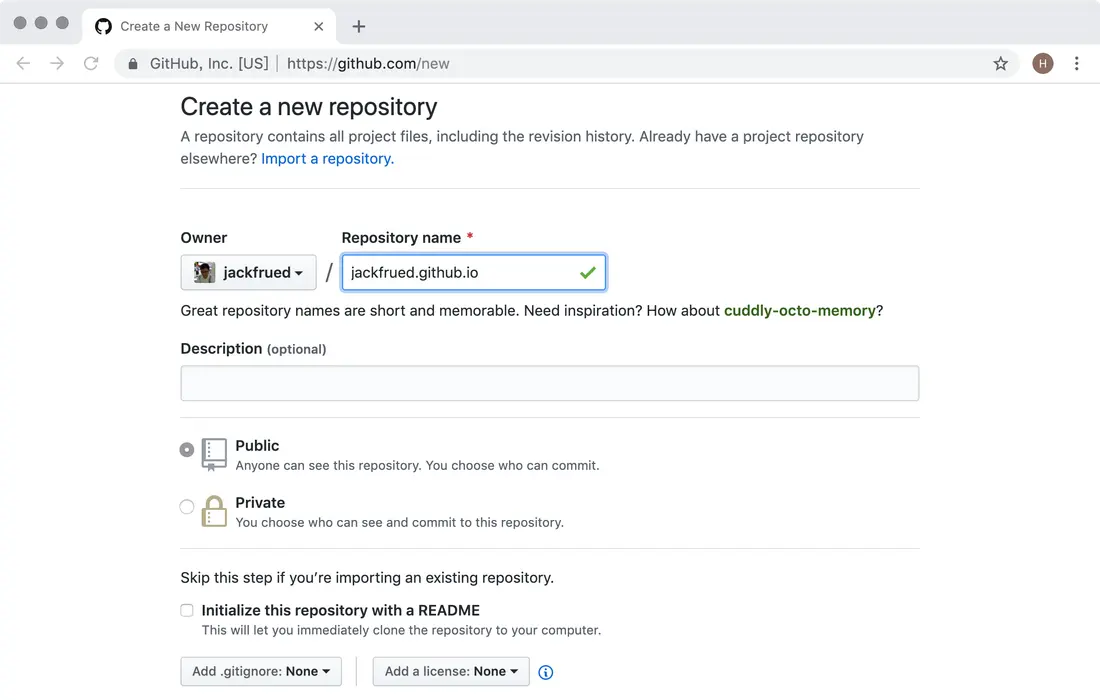
根据自己的用户名创建一个仓库,仓库一定要取名为“用户名.github.io”。例如:我在 GitHub 上的用户名是 jackfrued,那么我的托管博客项目的仓库一定要命名为 jackfrued.github.io。
-
修改博客项目的配置文件
_config.yml,配置使用 GitHub 来部署该博客项目。Terminal window vim _config.yml# 省略上面的内容# Deployment## Docs: https://hexo.io/docs/deployment.htmldeploy:type: gitrepo: https://github.com/jackfrued/jackfrued.github.io.gitbranch: master上面的配置中,type 指定了使用 git 进行项目部署,repo 指定了部署项目的 git 仓库的 URL,我们这里使用的是 HTTPS 的地址,如果之前配置过密钥对也可以使用 SSH 的地址,branch 指定了将代码同步到仓库中的哪一个分支,通常 master 分支就是发布项目最终工作成果的分支,也称为项目的主分支。
-
安装名为
hexo-deployer-git的部署器插件,通过该插件就能实现一键部署。Terminal window npm install hexo-deployer-git --save -
可以使用下面的命令来实现一键部署到 GitHub。
Terminal window hexo deploy -g或者
Terminal window hexo generate -d -
接下来在浏览器中输入 jackfrued.github.io 就能够看到自己的博客,现在全世界的人都可以通过这个 URL 来访问你的博客。大家是否注意到,访问你博客的这个 URL 就是刚才我们给仓库起的名字,因为你在GitHub上注册的用户名是独一无二的,所以这个域名也是全世界独一无二的。
将博客绑定到自己的域名
虽然我们已经通过 GitHub 提供的域名访问到了自己的博客,但是如果我们不愿意“寄人篱下”,我们在利用 GitHub Pages 提供的托管服务同时,也可以将博客绑定到自己专属的域名。如果暂时还没有购买域名,我们可以在提供域名购买服务的网站(如:万网、GoDaddy)上进行购买。
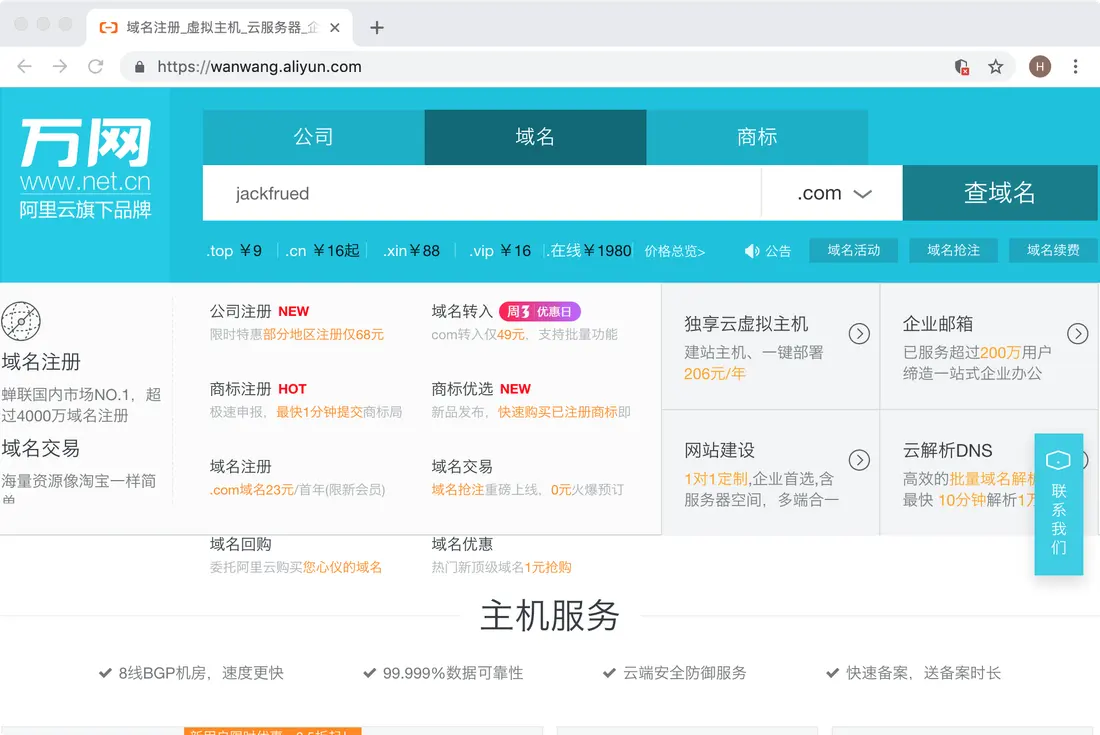
说明:目前国内对域名的管理日趋严格,在购买域名时需要填写一大堆的个人信息,进行实名认证后才能获得域名,这一点相信大家能够理解。
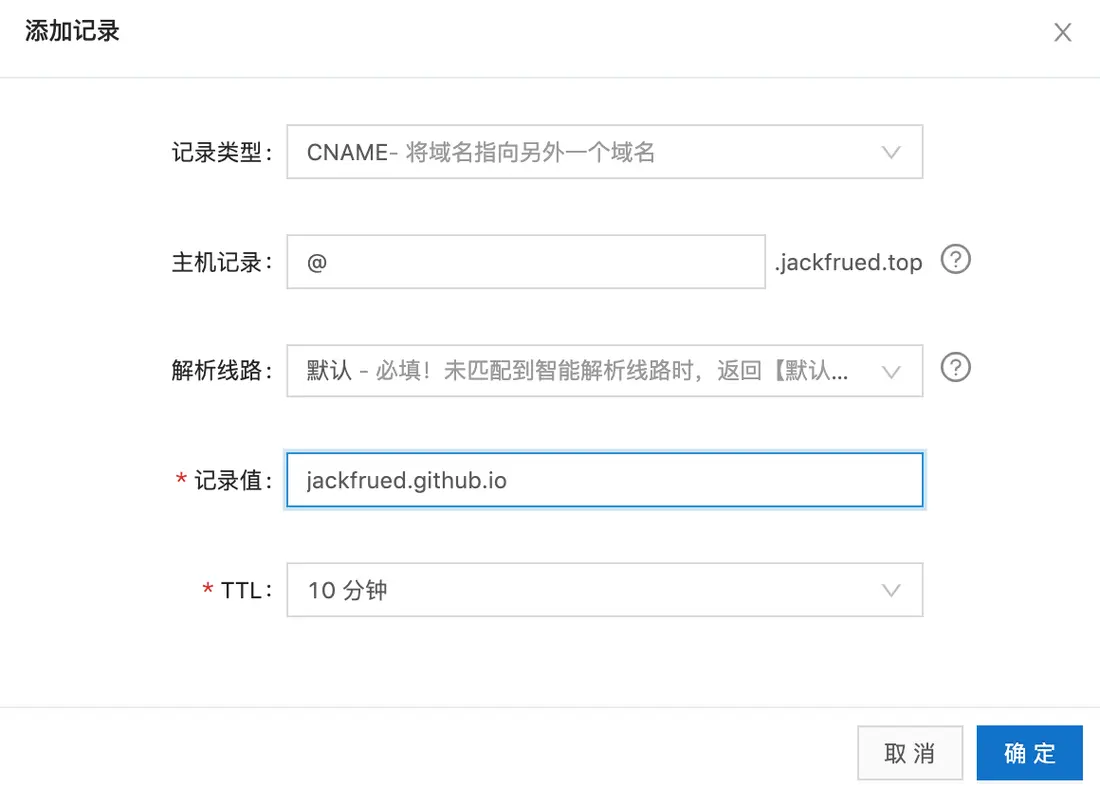
比如说,我现在已经购买了一个名为“jackfrued.top”的域名,如何让它跟“jackfrued.github.io”这个域名做一个绑定呢,我们可以利用阿里云控制台或者 DNSPod 来做一个域名解析服务。在域名解析平台登录成功后,可以添加或选择自己的域名来配置域名解析。点击“添加记录”按钮,创建一个类型为 CNAME 的域名解析,CNAME 类型的解析代表将一个域名解析到另一个域名,如下图所示。
完成这一步后,还不能马上通过自己的域名访问到博客项目,最后需要在博客项目的source目录下添加一个名为 CNAME 的文件(请注意这个文件的名字是全大写字母的),该文件的内容如下所示。
jackfrued.top可以清理一下之前生成的内容,然后将项目重新生成并发布到 GitHub 就大功告成了!现在我们已经拥有了独立域名的博客,希望大家可以利用它做些有意义的事情(记录自己的成长历程、分享自己的工作经验、提升个人的影响力)。
加油吧,程序员!
08 我为什么选择了Python
目前,Python 语言的发展势头在国内国外都是不可阻挡的,Python 凭借其简单优雅的语法,强大的生态圈从众多语言中脱颖而出,如今已经是稳坐编程语言排行榜前三的位置。国内很多 Python 开发者都是从 Java 开发者跨界过来的,我自己也不例外。我简单的跟大家交代一下,我为什么选择了 Python。
Python vs. Java
我们通过几个例子来比较一下,做同样的事情 Java 和 Python 的代码都是怎么写的。
例子1:在终端中输出“hello, world”。
Java 代码:
class Test {
public static void main(String[] args) { System.out.println("hello, world"); }}Python 代码:
print('hello, world')例子2:从1到100求和。
Java 代码:
class Test {
public static void main(String[] args) { int total = 0; for (int i = 1; i <= 100; i += 1) { total += i; } System.out.println(total); }}Python 代码:
print(sum(range(1, 101)))例子3:双色球随机选号。
Java 代码:
import java.util.List;import java.util.ArrayList;import java.util.Collections;
class Test {
/** * 产生[min, max)范围的随机整数 */ public static int randomInt(int min, int max) { return (int) (Math.random() * (max - min) + min); }
public static void main(String[] args) { // 初始化备选红色球 List<Integer> redBalls = new ArrayList<>(); for (int i = 1; i <= 33; ++i) { redBalls.add(i); } List<Integer> selectedBalls = new ArrayList<>(); // 选出六个红色球 for (int i = 0; i < 6; ++i) { selectedBalls.add(redBalls.remove(randomInt(0, redBalls.size()))); } // 对红色球进行排序 Collections.sort(selectedBalls); // 添加一个蓝色球 selectedBalls.add(randomInt(1, 17)); // 输出选中的随机号码 for (int i = 0; i < selectedBalls.size(); ++i) { System.out.printf("%02d ", selectedBalls.get(i)); if (i == selectedBalls.size() - 2) { System.out.print("| "); } } System.out.println(); }}Python 代码:
from random import randint, sample
# 初始化备选红色球red_balls = [x for x in range(1, 34)]# 选出六个红色球selected_balls = sample(red_balls, 6)# 对红色球进行排序selected_balls.sort()# 添加一个蓝色球selected_balls.append(randint(1, 16))# 输出选中的随机号码for index, ball in enumerate(selected_balls): print('%02d' % ball, end=' ') if index == len(selected_balls) - 2: print('|', end=' ')print()相信,看完这些例子后,你一定感受到了我选择了Python是有道理的。
09 一个小例子助你彻底理解协程
协程,可能是Python中最让初学者困惑的知识点之一,它也是Python中实现并发编程的一种重要方式。Python中可以使用多线程和多进程来实现并发,这两种方式相对来说是大家比较熟悉的。事实上,还有一种实现并发的方式叫做异步编程,而协程就是实现异步编程的必要方式。
所谓协程,可以简单的理解为多个相互协作的子程序。在同一个线程中,当一个子程序阻塞时,我们可以让程序马上从一个子程序切换到另一个子程序,从而避免CPU因程序阻塞而闲置,这样就可以提升CPU的利用率,相当于用一种协作的方式加速了程序的执行。所以,我们可以言简意赅的说:协程实现了协作式并发。
接下来用一个小例子帮助大家理解什么是协作式并发,先看看下面的代码。
import time
def display(num): time.sleep(1) print(num)
for num in range(10): display(num)上面这段代码相信大家很容看懂,程序会输出0到9的数字,每隔1秒中输出一个数字,因此整个程序的执行需要大约10秒时间。值得注意的是,因为没有使用多线程或多进程,程序中只有一个执行单元,而time.sleep(1)的休眠操作会让整个线程停滞1秒钟,对于上面的代码来说,在这段时间里面CPU是完全闲置的没有做什么事情。
我们再来看看使用协程会发生什么事情。从Python 3.5开始,使用协程实现协作式编发有了更为便捷的语法,我们可以使用async来定义异步函数,可以使用await让一个阻塞的子程序将CPU让给与它协作的子程序。在Python 3.7中,asyanc和await成为了正式的关键字,让开发者有一种喜大普奔的感觉。我们先看看如何定义一个异步函数。
import asyncio
async def display(num): await asyncio.sleep(1) print(num)接下来敲黑板说重点。异步函数不同于普通函数,调用普通函数会得到返回值,而调用异步函数会得到一个协程对象。我们需要将协程对象放到一个事件循环中才能达到与其他协程对象协作的效果,因为事件循环会负责处理子程序切换的操作,简单的说就是让阻塞的子程序让出CPU给可以执行的子程序。
我们先通过下面的列表生成式来代码10个协程对象,跟刚才在循环中调用display函数的道理一致。
coroutines = [display(num) for num in range(10)]通过下面的代码可以获取事件循环并将协程对象放入事件循环中。
loop = asyncio.get_event_loop()loop.run_until_complete(asyncio.wait(coroutines))loop.close()执行上面的代码会发现,10个分别会阻塞1秒钟的协程总共只阻塞了约1秒种的时间,这就说明协程对象一旦阻塞会将CPU让出而不是让CPU处于闲置状态,这样就大大的提升了CPU的利用率。而且我们还会注意到,0到9的数字并不是按照我们创建协程对象的顺序打印出来的,这正是我们想要的结果啊;另外,多次执行该程序会发现每次输出的结果都不太一样,这正是并发程序本身执行顺序不确定性造成的结果。
上面的例子来自于著名的“花书”(《Python高级并发编程》),为了让大家对协程的体会更加深刻,对原书的代码做了小的改动,这个例子虽然简单,但是它已经让你体会到了协作式并发的魅力。在商业项目中,如果需要使用协作式并发,还可以将系统默认的事件循环替换为uvloop提供的事件循环,这样会获得更好的性能,因为uvloop是基于著名的跨平台异步I/O库libuv实现的。另外,如果要做基于HTTP的网络编程,三方库aiohttp是不错的选择,它基于asyncio实现了异步的HTTP服务器和客户端。
10 用函数还是用复杂的表达式
Perl语言的原作者Larry Wall曾经说过,伟大的程序员都有三个优点:懒惰、暴躁和自负。乍一看这三个词语没有一个是褒义词,但在程序员的世界里,这三个词有不同的意义。首先,懒惰会促使程序员去写一些省事儿的程序来辅助自己或别人更好的完成工作,这样我们就无需做那些重复和繁琐的劳动;同理能够用3行代码解决的事情,我们也绝不会写出10行代码来。其次,暴躁会让程序员主动的去完成一些你还没有提出的工作,去优化自己的代码让它更有效率,能够3秒钟完成的任务,我们绝不能容忍1分钟的等待。最后,自负会促使程序员写出可靠无误的代码,我们写代码不是为了接受批评和指责,而是为了让其他人来膜拜。
那么接下来就有一个很有意思的问题值得探讨一下,我们需要一个程序从输入的三个数中找出最大的那个数。这个程序对任何会编程的人来说都是小菜一碟,甚至不会编程的人经过10分钟的学习也能搞定。下面是用来解决这个问题的Python代码。
a = int(input('a = '))b = int(input('b = '))c = int(input('c = '))if a > b: the_max = aelse: the_max = bif c > the_max: the_max = cprint('The max is:', the_max)但是我们刚才说了,程序员都是懒惰的,很多程序员都会使用三元条件运算符来改写上面的代码。
a = int(input('a = '))b = int(input('b = '))c = int(input('c = '))the_max = a if a > b else bthe_max = c if c > the_max else the_maxprint('The max is:', the_max)需要说明的是,Python在2.5版本以前是没有上面代码第4行和第5行中使用的三元条件运算符的,究其原因是Guido van Rossum(Python之父)认为三元条件运算符并不能帮助 Python变得更加简洁,于是那些习惯了在C/C++或Java中使用三元条件运算符(在这些语言中,三元条件运算符也称为“Elvis运算符”,因为?:放在一起很像著名摇滚歌手猫王Elvis的大背头)的程序员试着用and和or运算符的短路特性来模拟出三元操作符,于是在那个年代,上面的代码是这样写的。
a = int(input('a = '))b = int(input('b = '))c = int(input('c = '))the_max = a > b and a or bthe_max = c > the_max and c or the_maxprint('The max is:', the_max)但是这种做法在某些场景下是不能成立的,且看下面的代码。
a = 0b = -100# 下面的代码本来预期输出a的值,结果却得到了b的值# 因为a的值0在进行逻辑运算时会被视为False来处理print(True and a or b)# print(a if True else b)所以在Python 2.5以后引入了三元条件运算符来避免上面的风险(上面代码被注释掉的最后一句话)。那么,问题又来了,上面的代码还可以写得更简短吗?答案是肯定的。
a = int(input('a = '))b = int(input('b = '))c = int(input('c = '))print('The max is:', (a if a > b else b) if (a if a > b else b) > c else c)但是,这样做真的好吗?如此复杂的表达式是不是让代码变得晦涩了很多呢?我们发现,在实际开发中很多开发者都喜欢过度的使用某种语言的特性或语法糖,于是简单的多行代码变成了复杂的单行表达式,这样做真的好吗?这个问题我也不止一次的问过自己,现在我能给出的答案是下面的代码,使用辅助函数。
def the_max(x, y): return x if x > y else y
a = int(input('a = '))b = int(input('b = '))c = int(input('c = '))print('The max is:', the_max(the_max(a, b), c))上面的代码中,我定义了一个辅助函数the_max用来找出参数传入的两个值中较大的那一个,于是下面的输出语句可以通过两次调用the_max函数来找出三个数中的最大值,现在代码的可读性是不是好了很多。用辅助函数来替代复杂的表达式真的是一个不错的选择,关键是比较大小的逻辑转移到这个辅助函数后不仅可以反复调用它,而且还可以进行级联操作。
当然,很多语言中比较大小的函数根本没有必要自己来实现(通常都是内置函数),Python也是如此。Python内置的max函数利用了Python对可变参数的支持,允许一次性传入多个值或者一个迭代器并找出那个最大值,所以上面讨论的问题在Python中也就是一句话的事,但是从复杂表达式到使用辅助函数简化复杂表达式这个思想是非常值得玩味的,所以分享出来跟大家做一个交流。
a = int(input('a = '))b = int(input('b = '))c = int(input('c = '))print('The max is:', max(a, b, c))11 知乎问题回答
Python学习完基础语法知识后,如何进一步提高?
如果你已经完成了Python基础语法的学习,想要知道接下来如何提高,那么你得先问问自己你要用Python来做什么?目前学习Python后可能的就业方向包括以下几个领域,我把每个领域需要的技术作为了一个简单的关键词摘要。
说明:以下数据参考了主要的招聘门户网站以及职友集。
| 职位 | 所需技能 | 招聘需求量 |
|---|---|---|
| Python后端开发工程师 | Python基础 Django / Flask / Tornado / Sanic RESTful / 接口文档撰写 MySQL / Redis / MongoDB / ElasticSearch Linux / Git / Scrum / PyCharm | 一般 |
| Python爬虫开发工程师 | Python基础 常用标准库和三方库 Scrapy / PySpider Selenium / Appnium Redis / MongoDB / MySQL 前端 / HTTP(S) / 抓包工具 | 较少 |
| Python量化交易开发工程师 | Python基础 数据结构 / 算法 / 设计模式 NoSQL(KV数据库) 金融学(两融、期权、期货、股票) / 数字货币 | 一般 |
| Python数据分析工程师 / Python机器学习工程师 | 统计学专业 / 数学专业 / 计算机专业 Python基础 / 算法设计 SQL / NoSQL / Hive / Hadoop / Spark NumPy / Scikit-Learn / Pandas / Seaborn PyTorch / Tensorflow / OpenCV | 大 |
| Python自动化测试工程师 | Python基础 / 单元测试 / 软件测试基础 Linux / Shell / JIRA / 禅道 / Jenkins / CI / CD Selenium / Robot Framework / Appnium ab / sysbench / JMeter / LoadRunner / QTP | 大 |
| Python自动化运维工程师 | Python基础 / Linux / Shell Fabric / Ansible / Playbook Zabbix / Saltstack / Puppet Docker / paramiko | 大 |
| Python云平台开发工程师 | Python基础 OpenStack / CloudStack Ovirt / KVM Docker / K8S | 较少 |
如果弄清了自己将来要做的方向,就可以开始有针对性的学习了,下面给大家一个推荐书籍的清单。
-
入门读物
- 《Python基础教程》(Beginning Python From Novice to Professional)
- 《Python学习手册》(Learning Python)
- 《Python编程》(Programming Python)
- 《Python编程从入门到实践》(Python Crash Course)
- 《Python Cookbook》
-
进阶读物
- 《软件架构 - Python语言实现》(Software Architecture with Python)
- 《流畅的Python》(Fluent Python)
- 《Python设计模式》(Learning Python Design Patterns)
- 《Python高级编程》(Expert Python Programming)
- 《Python性能分析与优化》(Mastering Python High Performance)
-
数据库相关
- 《MySQL必知必会》(MySQL Crash Course)
- 《深入浅出MySQL - 数据库开发、优化与管理维护》
- 《MongoDB权威指南》(MongoDB: The Definitive Guide)
- 《Redis实战》(Redis in Action)
- 《Redis开发与运维》
-
Linux / Shell / Docker / 运维
- 《鸟哥的Linux私房菜》
- 《Linux命令行与shell脚本编程大全》(Linux Command Line and Shell Scripting Bible)
- 《Python自动化运维:技术与最佳实践》
- 《第一本Docker书》(The Docker Book)
- 《Docker经典实例》(Docker Cookbook)
-
Django / Flask / Tornado
-
《Django基础教程》(Tango with Django)
-
《轻量级Django》(Lightweight Django)
-
《精通Django》(Mastering Django: Core)
-
《Python Web开发:测试驱动方法》(Test-Driven Development with Python)
-
《Two Scoops of Django: Best Practice of Django 1.8》
-
《Flask Web开发:基于Python的Web应用开发实战》(Flask Web Development: Developing Web Applications with Python)
-
《深入理解Flask》(Mastering Flask)
-
《Introduction to Tornado》
-
-
爬虫开发
-
《用Python写网络爬虫》(Web Scraping with Python)
-
《精通Python爬虫框架Scrapy》(Learning Scrapy)
-
《Python网络数据采集》(Web Scraping with Python)
-
《Python爬虫开发与项目实战》
-
《Python 3网络爬虫开发实战》
-
-
数据分析
- 《利用Python进行数据分析》(Python for Data Analysis)
- 《Python数据科学手册》(Python Data Science Handbook)
- 《Python金融大数据分析》(Python for Finance)
- 《Python数据可视化编程实战》(Python Data Visualization Cookbook)
- 《Python数据处理》(Data Wrangling with Python)
-
机器学习
-
《Python机器学习基础教程》(Introduction to Machine Learning with Python)
-
《Python机器学习实践指南》(Python Machine Learning Blueprints)
-
《Python机器学习实践:测试驱动的开发方法》(Thoughtful Machine Learning with Python A Test Driven Approach)
-
《Python机器学习经典实例》(Python Machine Learning Cookbook)
-
《TensorFlow:实战Google深度学习框架》
-
-
其他书籍
- 《Pro Git》
- 《Selenium自动化测试 - 基于Python语言》(Learning Selenium Testing Tools with Python)
- 《Selenium自动化测试之道》
- 《Scrum敏捷软件开发》(Software Development using Scrum)
- 《高效团队开发 - 工具与方法》
当然学习编程,最重要的通过项目实战来提升自己的综合能力,Github上有大量的优质开源项目,其中不乏优质的Python项目。有一个名为“awesome-python-applications”的项目对这些优质的资源进行了归类并提供了传送门,大家可以了解下。如果自学能力不是那么强,可以通过网络上免费或者付费的视频课程来学习对应的知识;如果自律性没有那么强,那就只能建议花钱参加培训班了,因为花钱在有人监督的环境下学习对很多人来说确实是一个捷径,但是要记得:“师傅领进门,修行靠各人”。选择自己热爱的东西并全力以赴,不要盲目的跟风学习,这一点算是过来人的忠告吧。记得我自己刚开始进入软件开发这个行业时,有人跟我说过这么一句话,现在也分享出来与诸君共勉:“浮躁的人有两种:只观望而不学习的人,只学习而不坚持的人;浮躁的人都不是高手。”
12 用Canvas学习编程
在学习编程的过程中,我们经常需要编写、修改和优化代码。而 ChatGPT 的 Canvas 功能提供了一种高效、直观的方式来帮助我们更好地理解和提升代码能力。下面,我们就简单介绍一下如何利用 ChatGPT 的 Canvas 功能来学习和理解代码。
Canvas使用场景
1. 代码实时编辑与优化
Canvas 功能可以作为一个交互式代码编辑器,允许我们直接在其中编写代码,并实时修改和优化。当我们遇到代码问题时,可以在 Canvas 中提交代码,并请求 ChatGPT 提供优化建议。例如:
- 通过 ChatGPT 进行代码重构,使代码更简洁、易读。
- 让 ChatGPT 解释某段代码的逻辑,帮助理解复杂算法或设计模式。
- 在 Canvas 中迭代改进代码,提高运行效率或减少冗余代码。
2. 学习编程概念与示例
对于初学者来说,Canvas 也是一个很好的学习工具。你可以在 Canvas 中输入示例代码,并让 ChatGPT 解释其作用。例如:
- 学习基础语法,例如变量、循环、函数等。
- 通过示例代码学习数据结构和算法,如链表、排序算法等。
- 让 ChatGPT 提供代码示例,并逐行解释代码的运行方式。
3. 代码调试与错误修正
在编程过程中,错误是不可避免的。Canvas 可以帮助快速定位和修复错误。
- 将错误代码粘贴到 Canvas,让 ChatGPT 分析错误原因。
- 让 ChatGPT 提供修正方案,并解释错误发生的原因。
- 通过 Canvas 进行多次调试,逐步优化代码逻辑。
4. 代码注释与文档生成
编写清晰的注释和文档对于代码的可读性至关重要。Canvas 可以帮助我们快速生成代码注释和文档:
- 让 ChatGPT 为代码添加详细注释,方便后续维护和理解。
- 自动生成 API 文档,方便团队协作。
- 生成代码执行流程的简要说明,帮助快速掌握代码逻辑。
Canvas应用举例
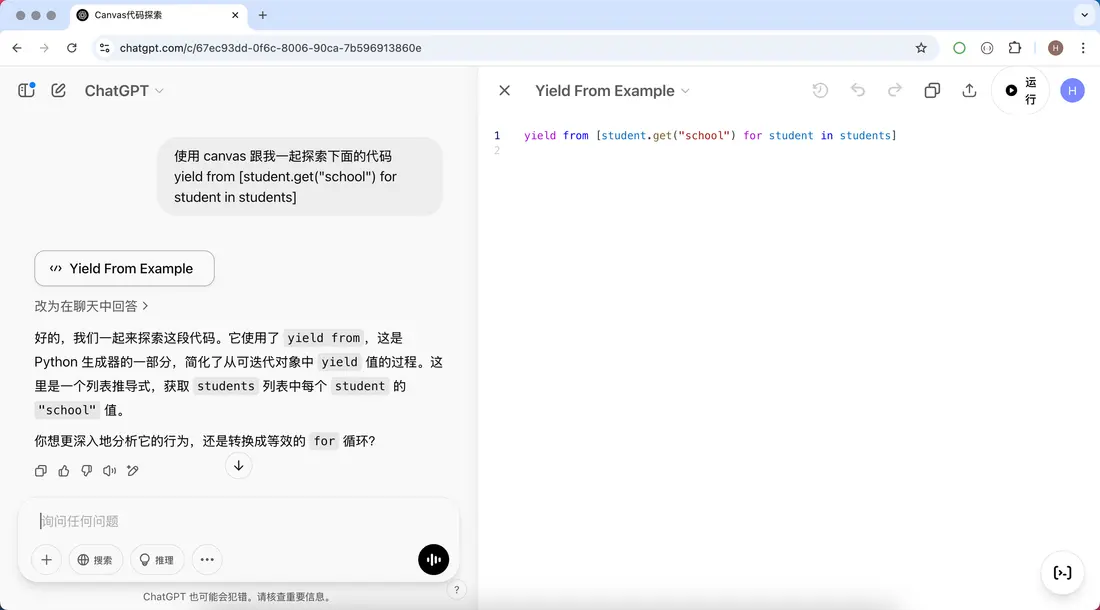
yield from [student.get("school") for student in students]在学习的 Python 语言的时候,假如你看到上面这段代码但并不理解它的意图,你可以使用如下所示的提示词跟 ChatGPT 开启对话,你甚至不用告诉它你用的什么编程语言,也不用交待这段代码的上下文。
使用 canvas 跟我一起探索下面的代码yield from [student.get("school") for student in students]如下图所示,ChatGPT 给出了关于上面代码的回复,右侧展开了 Canvas 并将我们的代码置于其中。
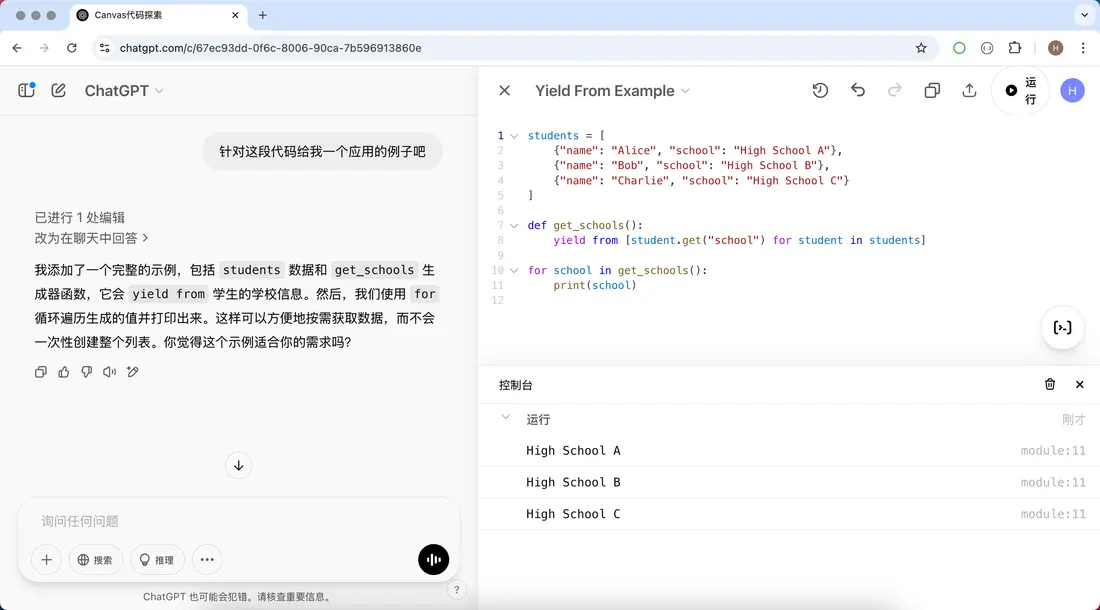
如果上面的回答还是没能帮你理解这段代码,我们可以让 ChatGPT 给出对应的例子,提示词如下。
针对这段代码给我一个应用的例子吧如下图所示,ChatGPT 已经帮我修改了 Canvas 中的代码,给出了一段完整的可运行的 Python 代码,我们可以点击 Canvas 上面的运行按钮来执行这段代码,Canvas 目前已经可以支持很多种编程语言,你熟悉的编程语言它应该也是熟悉的。
如果你理解了上面的操作,我们还可以继续提出疑问,如果"school"字段不存在,我们的代码改如何修改。
修改下上面的代码,让生成器排除掉没有学校(school)的学生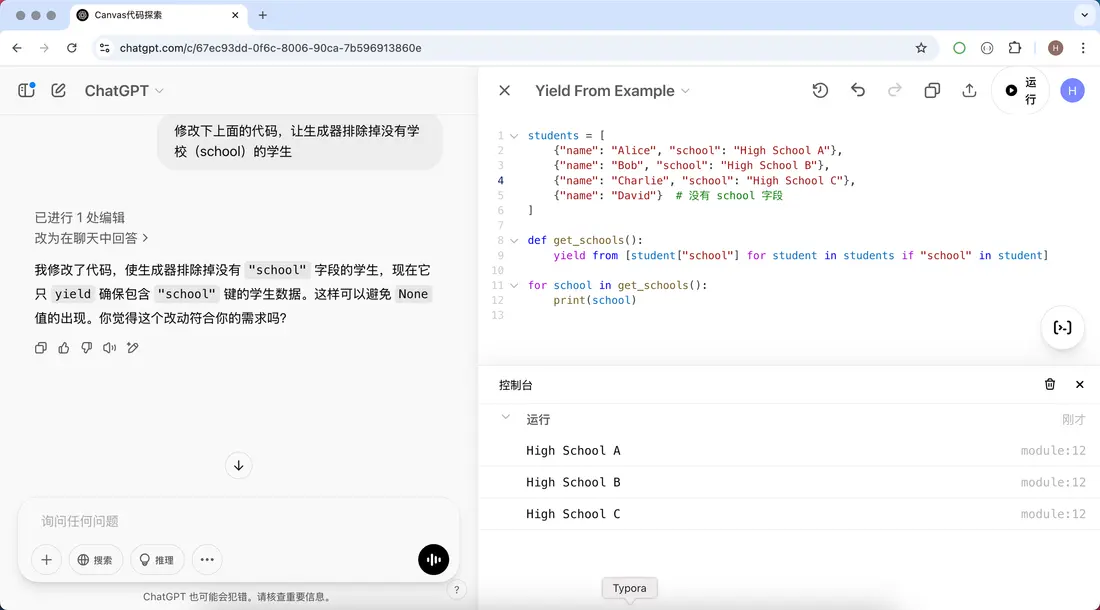
然后,我们再进一步根据我们实际的需要,让 ChatGPT 帮助我们修改代码。
如果我希望每个学校只出现一次,应该该如何修改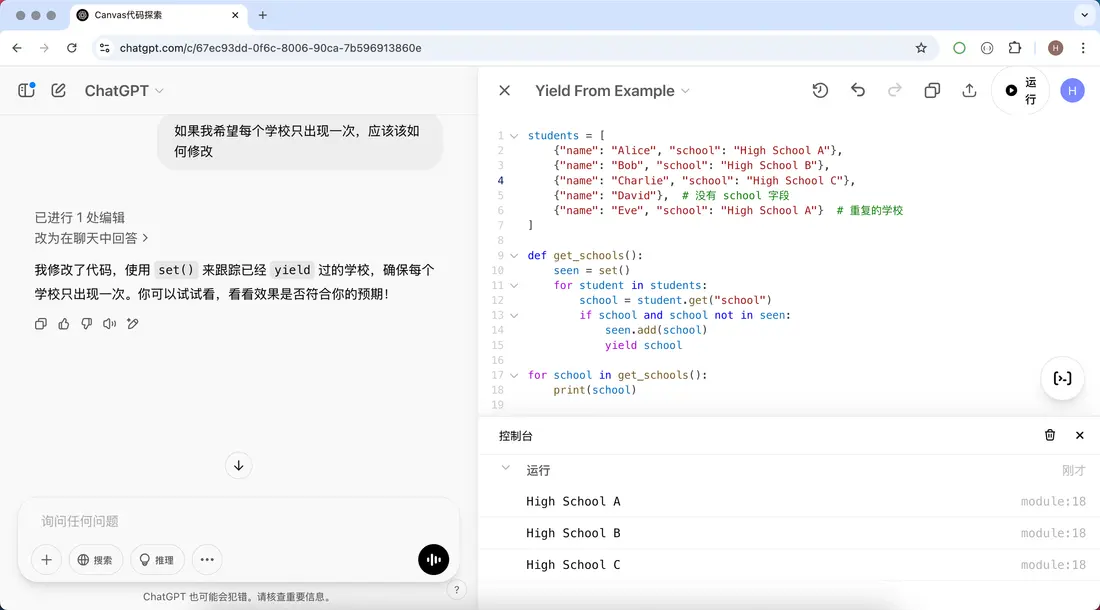
对于写 Python 的人来说,如果你认为 ChatGPT 生成的代码不够简洁、不够 Pythonic,我们可以继续提问。
上面的代码能够写得更加简洁和Pythonic吗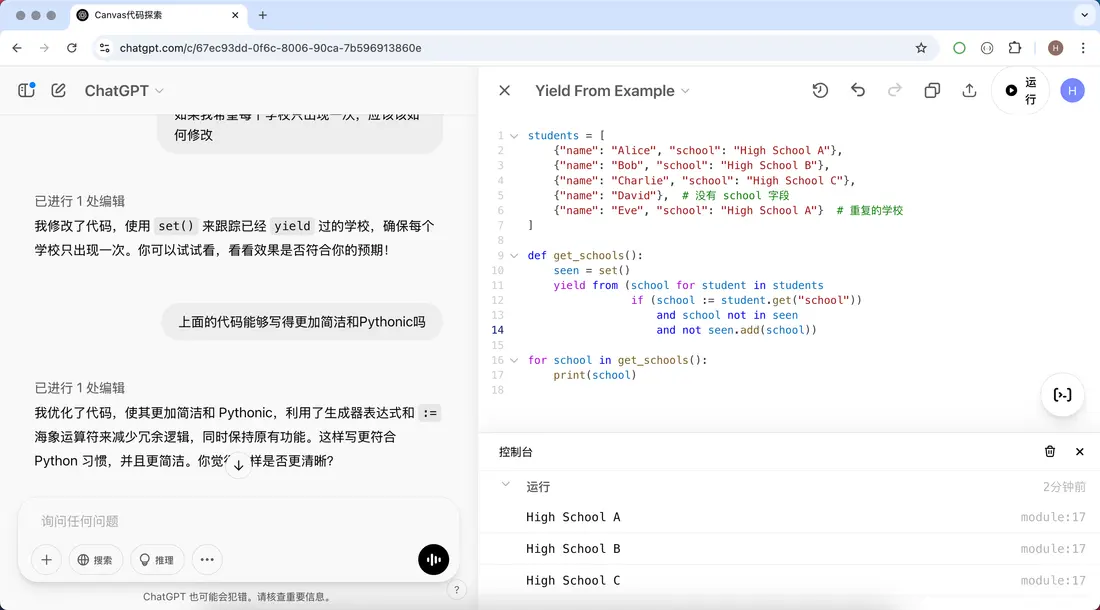
总结
ChatGPT 的 Canvas 功能不仅仅是一个代码编辑器,更是一个智能的编程助手。无论你是编程初学者,还是经验丰富的开发者,都可以通过 Canvas 提高代码理解和编写能力。通过不断实践和探索,你可以更高效地掌握编程技巧,并提升自身的技术水平。
13 Python编程惯例
“惯例”这个词指的是“习惯的做法,常规的办法,一贯的做法”,与这个词对应的英文单词叫“idiom”。由于Python跟其他很多编程语言在语法和使用上还是有比较显著的差别,因此作为一个Python开发者如果不能掌握这些惯例,就无法写出“Pythonic”的代码。下面我们总结了一些在Python开发中的惯用的代码。
-
让代码既可以被导入又可以被执行。
if __name__ == '__main__': -
用下面的方式判断逻辑“真”或“假”。
if x:if not x:好的代码:
name = 'jackfrued'fruits = ['apple', 'orange', 'grape']owners = {'1001': '骆昊', '1002': '王大锤'}if name and fruits and owners:print('I love fruits!')不好的代码:
name = 'jackfrued'fruits = ['apple', 'orange', 'grape']owners = {'1001': '骆昊', '1002': '王大锤'}if name != '' and len(fruits) > 0 and owners != {}:print('I love fruits!') -
善于使用in运算符。
if x in items: # 包含for x in items: # 迭代好的代码:
name = 'Hao LUO'if 'L' in name:print('The name has an L in it.')不好的代码:
name = 'Hao LUO'if name.find('L') != -1:print('This name has an L in it!') -
不使用临时变量交换两个值。
a, b = b, a -
用序列构建字符串。
好的代码:
chars = ['j', 'a', 'c', 'k', 'f', 'r', 'u', 'e', 'd']name = ''.join(chars)print(name) # jackfrued不好的代码:
chars = ['j', 'a', 'c', 'k', 'f', 'r', 'u', 'e', 'd']name = ''for char in chars:name += charprint(name) # jackfrued -
EAFP优于LBYL。
EAFP - Easier to Ask Forgiveness than Permission.
LBYL - Look Before You Leap.
好的代码:
d = {'x': '5'}try:value = int(d['x'])print(value)except (KeyError, TypeError, ValueError):value = None不好的代码:
d = {'x': '5'}if 'x' in d and isinstance(d['x'], str) \and d['x'].isdigit():value = int(d['x'])print(value)else:value = None -
使用enumerate进行迭代。
好的代码:
fruits = ['orange', 'grape', 'pitaya', 'blueberry']for index, fruit in enumerate(fruits):print(index, ':', fruit)不好的代码:
fruits = ['orange', 'grape', 'pitaya', 'blueberry']index = 0for fruit in fruits:print(index, ':', fruit)index += 1 -
用生成式生成列表。
好的代码:
data = [7, 20, 3, 15, 11]result = [num * 3 for num in data if num > 10]print(result) # [60, 45, 33]不好的代码:
data = [7, 20, 3, 15, 11]result = []for i in data:if i > 10:result.append(i * 3)print(result) # [60, 45, 33] -
用zip组合键和值来创建字典。
好的代码:
keys = ['1001', '1002', '1003']values = ['骆昊', '王大锤', '白元芳']d = dict(zip(keys, values))print(d)不好的代码:
keys = ['1001', '1002', '1003']values = ['骆昊', '王大锤', '白元芳']d = {}for i, key in enumerate(keys):d[key] = values[i]print(d)
说明:这篇文章的内容来自于网络,有兴趣的读者可以阅读原文。
14 Python参考书籍
入门读物
- 《Python基础教程》(Beginning Python From Novice to Professional)
- 《Python学习手册》(Learning Python)
- 《Python编程》(Programming Python)
- 《Python Cookbook》
- 《Python程序设计》(Python Programming: An Introduction to Computer Science)
- 《Modern Python Cookbook》
进阶读物
- 《Python核心编程》(Core Python Applications Programming)
- 《流畅的Python》(Fluent Python)
- 《Effective Python:编写高质量Python代码的59个有效方法》(Effective Python 59 Specific Ways to Write Better Python)
- 《Python设计模式》(Learning Python Design Patterns)
- 《Python高级编程》(Expert Python Programming)
- 《Python性能分析与优化》(Mastering Python High Performance)
Web框架
- 《Django基础教程》(Tango with Django)
- 《轻量级Django》(Lightweight Django)
- 《Python Web开发:测试驱动方法》(Test-Driven Development with Python)
- 《Web Development with Django Cookbook》
- 《Test-Driven Development with Django》
- 《Django Project Blueprints 》
- 《Flask Web开发:基于Python的Web应用开发实战》(Flask Web Development: Developing Web Applications with Python)
- 《深入理解Flask》(Mastering Flask)
数据采集
- 《用Python写网络爬虫》(Web Scraping with Python)
- 《精通Python爬虫框架Scrapy》(Learning Scrapy)
- 《Python网络数据采集》(Web Scraping with Python)
- 《Python爬虫开发与项目实战》
- 《Python 3网络爬虫开发实战》
数据分析
- 《利用Python进行数据分析》(Python for Data Analysis)
- 《Python数据科学手册》(Python Data Science Handbook)
- 《Python金融大数据分析》(Python for Finance)
- 《Python数据可视化编程实战》(Python Data Visualization Cookbook)
- 《Python数据处理》(Data Wrangling with Python)
机器学习
- 《Python机器学习基础教程》(Introduction to Machine Learning with Python)
- 《Python机器学习实践指南》(Python Machine Learning Blueprints)
- 《Python Machine Learning Case Studies》
- 《Python机器学习实践:测试驱动的开发方法》(Thoughtful Machine Learning with Python A Test Driven Approach)
- 《Python机器学习经典实例》(Python Machine Learning Cookbook)
- 《TensorFlow:实战Google深度学习框架》
15 Python容器类型使用小技巧
Python中提供了非常丰富的容器型数据类型,大家最为熟悉的有list、tuple、set、dict等。下面为大家分享一些使用这些类型的小技巧,希望帮助大家写出更加Pythonic的代码。
1. 从字典中取最大
假设字典对象对应的变量名为my_dict。
-
取出最大值
max(my_dict.values()) -
取值最大值的键
max(my_dict, key=my_dict.get) -
取出最大值的键和值
max(my_dict.items(), key=lambda x: x[1])或
import operatormax(my_dict.items(), key=operator.itemgetter(1))说明:上面用到了
operator模块的itemgetter函数,这个函数的的作用如下所示。在上面的代码中,itemgetter帮我们获取到了二元组中的第2个元素。def itemgetter(*items):if len(items) == 1:item = items[0]def g(obj):return obj[item]else:def g(obj):return tuple(obj[item] for item in items)return g
2. 统计列表元素出现次数
假设列表对象对应的变量名为my_list。
{x: my_list.count(x) for x in set(my_list)}或
from itertools import groupby
{key: len(list(group)) for key, group in groupby(sorted(my_list))}说明:
groupby函数会将相邻相同元素分到一个组中,所以先用sorted函数排序就是为了将相同的元素放到一起。
或
from collections import Counter
dict(Counter(my_list))3. 截断列表元素
假设列表对象对应的变量名为my_list,通常大家会想到用下面的方式来截断列表。
my_list = my_list[:i]my_list = my_list[j:]然而,更好的方式使用下面的操作,大家可以认真想想为什么。
del my_list[i:]del my_list[:j]4. 按最长列表实现zip操作
Python的内置函数zip可以产生一个生成器对象,该生成器对象将两个或多个可迭代对象的元素组装到一起,如下所示。
list(zip('abc', [1, 2, 3, 4]))执行上面的代码会得到一个如下所示的列表,相信大家也注意到了,列表中元素的个数是由zip函数中长度最小的可迭代对象决定的,所以下面的列表中只有3个元素。
[('a', 1), ('b', 2), ('c', 3)]如果希望由zip函数中长度最大的可迭代对象来决定最终迭代出的元素个数,可以试一试itertools模块的zip_longest函数,其用法如下所示。
from itertools import zip_longest
list(zip_longest('abc', [1, 2, 3, 4]))上面的代码创建出的列表对象如下所示。
[('a', 1), ('b', 2), ('c', 3), (None, 4)]5. 快速拷贝一个列表
如果希望快速拷贝一个列表对象,可以通过切片操作来实现,但是切片操作仅实现了浅拷贝,简单的说就是切片创建了新的列表对象,但是新列表中的元素是和之前的列表共享的。如果希望实现深拷贝,可以使用copy模块的deepcopy函数。
-
浅拷贝
thy_list = my_list[:]或
import copythy_list = copy.copy(my_list) -
深拷贝
import copythy_list = copy.deepcopy(my_list)
6. 对两个或多个列表对应元素进行操作
Python内置函数中的map函数可以对一个可迭代对象中的元素进行“映射”操作,这个函数在批量处理数据时非常有用。但是很多人都不知道,这个函数还可以作用于多个可迭代对象,通过传入的函数对多个可迭代对象中的对应元素进行处理,如下所示。
my_list = [11, 13, 15, 17]thy_list = [2, 4, 6, 8, 10]list(map(lambda x, y: x + y, my_list, thy_list))上面的操作会得到如下所示的列表。
[13, 17, 21, 25]当然,同样的操作也可以用zip函数配合列表生成式来完成。
my_list = [11, 13, 15, 17]thy_list = [2, 4, 6, 8, 10][x + y for x, y in zip(my_list, thy_list)]7. 处理列表中的空值和零值
假设列表对象对应的变量名为my_list,如果列表中有空值(None)和零值,我们可以用下面的方式去掉空值和零值。
list(filter(bool, my_list))对应的列表生成式语法如下所示。
[x for x in my_list if x]8. 从嵌套列表中抽取指定列
假设my_list是一个如下所示的嵌套列表,该嵌套列表可以用来表示数学上的矩阵,如果要取出矩阵第一列的元素构成一个列表,我们可以这样写。
my_list = [ [1, 1, 2, 2], [5, 6, 7, 8], [3, 3, 4, 4],]col1, *_ = zip(*my_list)list(col1)这里我们会得到一个如下所示的列表,刚好是矩阵的第一列。
[1, 5, 3]以此类推,如果想取出矩阵第二列的元素构成一个列表,可以用如下所示的方法。
_, col2, *_ = zip(*my_list)list(col2)至此,如果要实现矩阵的转置操作,我们也可以按照上面的思路写出下面的代码。
[list(x) for x in zip(*my_list)]经过上面的操作,我们会得到如下所示的列表。
[[1, 5, 3], [1, 6, 3], [2, 7, 4], [2, 8, 4]]16 Zen of Python(Python之禅)
- Beautiful is better than ugly. (优美比丑陋好)
- Explicit is better than implicit.(清晰比晦涩好)
- Simple is better than complex.(简单比复杂好)
- Complex is better than complicated.(复杂比错综复杂好)
- Flat is better than nested.(扁平比嵌套好)
- Sparse is better than dense.(稀疏比密集好)
- Readability counts.(可读性很重要)
- Special cases aren’t special enough to break the rules.(特殊情况也不应该违反这些规则)
- Although practicality beats purity.(但现实往往并不那么完美)
- Errors should never pass silently.(异常不应该被静默处理)
- Unless explicitly silenced.(除非你希望如此)
- In the face of ambiguity, refuse the temptation to guess.(遇到模棱两可的地方,不要胡乱猜测)
- There should be one— and preferably only one —obvious way to do it.(肯定有一种通常也是唯一一种最佳的解决方案)
- Although that way may not be obvious at first unless you’re Dutch.(虽然这种方案并不是显而易见的,因为你不是那个荷兰人1)
- Now is better than never.(现在开始做比不做好)
- Although never is often better than *right* now.(不做比盲目去做好2)
- If the implementation is hard to explain, it’s a bad idea.(如果一个实现方案难于理解,它通常不是一个好的方案)
- If the implementation is easy to explain, it may be a good idea.(如果一个实现方案易于理解,它很有可能是一个好的方案)
- Namespaces are one honking great idea — let’s do more of those!(命名空间非常有用,我们应当多加利用)
Footnotes
Python100天
已完结分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 301 天
部分内容可能已过时
评论