本篇目录
- 81 浅谈机器学习
- 82 k最近邻算法
- 83 决策树和随机森林
- 84 朴素贝叶斯算法
- 85 回归模型
- 86 K-Means聚类算法
- 87 集成学习算法
- 88 神经网络模型
- 89 自然语言处理入门
- 90 机器学习实战
目录里每一条都可以点开直达对应章节;右侧(移动端为悬浮按钮)的「文章目录」也会列出同一批标题。
81 浅谈机器学习
人工智能无疑是最近几年热度极高的一个词,从2016年谷歌 DeepMind 团队开发的 AlphaGo 围棋程序战胜人类顶尖棋手,到2017年基于 Transformer 架构的 NLP 模型发布,再到2023年 OpenAI 推出基于 GPT-4 的 ChatGPT 以及人工智能在医疗、自动驾驶等领域的深度应用,人工智能的热潮到达了自1956年达特茅斯会议以来前所未有的高度,可以说几乎每个人的生活都或多或少的受到了人工智能的影响。人工智能是计算机科学的一个重要分支,涉及计算机模拟智能行为的能力以及机器模仿人类智能行为的能力。研究人工智能的主要目标是开发出能够独立做出决策的系统,从而在医疗、工程、金融、教育、科研、公共服务等诸多领域帮助人类更高效的工作。人工智能的英文是“artificial intelligence”,因此通常被简称为 AI,人工智能包含了诸多的内容,我们经常说到的机器学习、深度学习、自然语言处理、计算机视觉、强化学习、数据挖掘、专家系统、工业机器人、自动驾驶等都属于人工智能的范畴。狭义的人工智能通常只能执行特定的任务,会聊天的人工智能通常不会开车,会开车的人工智能通常不会下棋;广义的人工智能需要具备通用智能,能够执行任何人类智能可以执行的任务;而更进一步的能够超越人类智能的人工智能,我们称之为超人工智能。
本课程我们主要探讨人工智能中的机器学习(Machine Learning)。机器学习是人工智能的一个子领域,关注如何通过数据和算法来使计算机系统从经验中学习并进行预测或决策。简单的说,机器学习是实现人工智能的一种方法,有很多 AI 系统都是通过机器学习技术开发的。在一些特定场景,人们也用数据挖掘(Data Mining)这个词来指代机器学习,所谓的数据挖掘就是从数据中提取有用的信息和知识,分析和解释数据中的模式和趋势,最终达成预测未来趋势和行为的目标。当然,我们在提到这两个词的时候,表达的侧重点还是有所区别,数据挖掘主要关注知识发现,而机器学习侧重于构建和优化预测模型。当下,还有一个非常热门的概念和研究领域叫深度学习(Deep Learning),它是机器学习的一个子领域,特别侧重于使用多层神经网络(深度神经网络)来进行数据处理和学习。深度学习在处理图像、语音和自然语言等复杂数据时表现出色,能够自动学习数据的层次化特征,从而降低人工干预的需求。当然,深度学习模型通常比传统的机器学习模型更复杂,且需要更多的数据和计算资源。
人工智能发展史
治学先治史,我们简单回顾一下人工智能发展史上的里程碑事件,对于比较久远的历史,我们只简单提一些重要的时间节点,我们把重点放在最近几年的重大事件上。
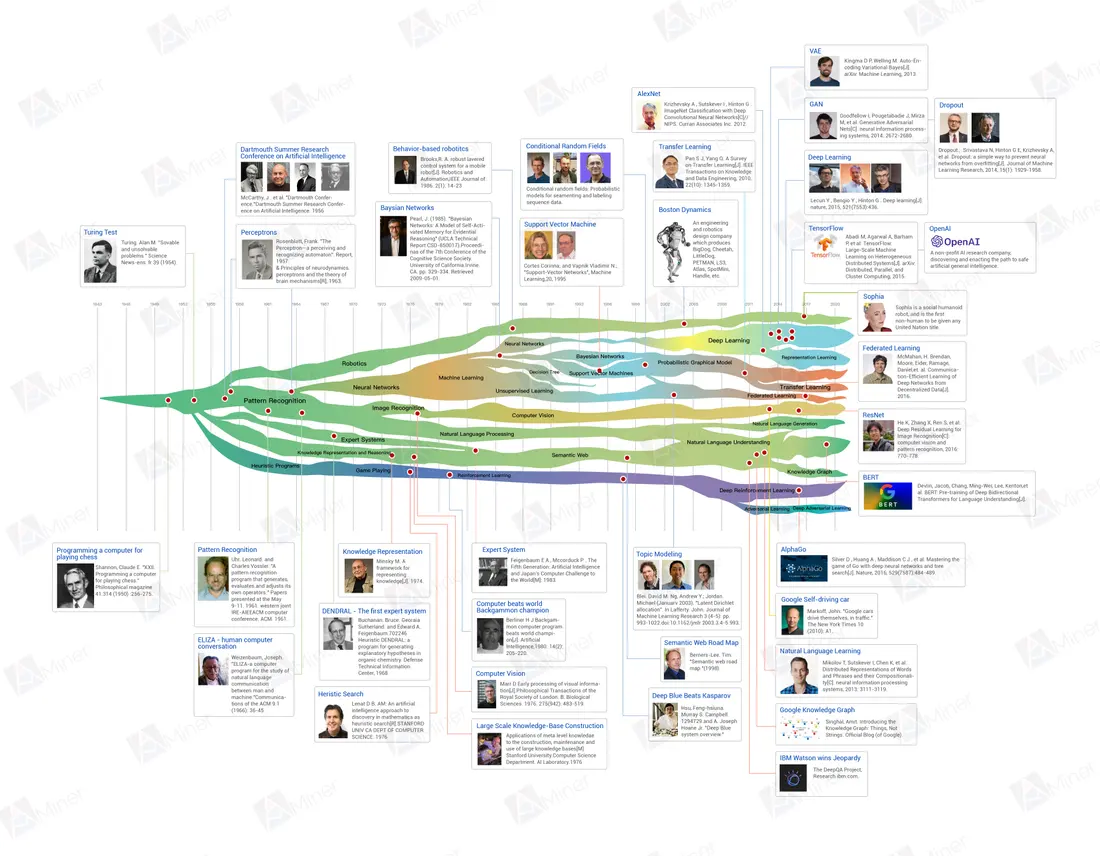
说明:上图来自于AMiner网站,按照该网站的要求,在引用上图需要引用下面的论文。需要高清原图的,也可以在该网站上获取。
Jie Tang, Jing Zhang, Limin Yao, Juanzi Li, Li Zhang, and Zhong Su. ArnetMiner: Extraction and Mining of Academic Social Networks. In Proceedings of the Fourteenth ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (SIGKDD’2008). pp.990-998.
- 1950年,艾伦·图灵发表了一篇划时代的论文,文中预言了创造出具有智能的机器的可能性并提出了著名的图灵测试。图灵测试旨在通过计算机与人类进行对话,如果计算机能够使人类无法区分回答问题的是机器还是人类,就认为该计算机具有智能。
- 1956年,达特茅斯会议召开,该会议被认为是人工智能的诞生标志。会议上约翰·麦卡锡、马文·明斯基、克劳德·香农等人提出了人工智能的研究议程。达特茅斯会议的几位主要参与者也被后人誉为“人工智能七侠”,包括约翰·麦卡锡、马文·明斯基、阿伦·纽厄尔、赫伯特·西蒙、克劳德·香农、奥利弗·塞尔弗里奇和内森·罗切斯特,他们为人工智能的发展奠定了基础,其中有五个人获得了图灵奖。
- 1957年,弗兰克·罗森布拉特提出了感知机模型,这是最早的神经网络模型之一,用于解决二分类问题。
- 1958年,约翰·麦卡锡开发了 LISP 编程语言,这种语言特别适合于符号处理,成为早期 AI 研究的主要编程语言。
- 1980年,卡内基梅隆大学为 DEC 公司设计了一个名为 XCON 的专家系统,每年为公司省下约四千万美元的开销。由于专家系统在 DEC 公司取得了巨大的成功,全世界有很多公司都开始研发和应用专家系统。
- 1982年,物理学家约翰·霍普菲尔德证明一种新型的神经网络(后被称为“Hopfield网络”)能够用一种全新的方式学习和处理信息。
- 1986年,杰弗里·辛顿及其团队提出了反向传播算法,解决了训练深层神经网络的难题,神经网络相关的方法论再次受到关注。这一突破使得神经网络在各类任务中表现优异,成为机器学习的重要工具。
- 1997年,IBM 开发的国际象棋程序 Deep Blue 战胜了国际象棋世界冠军传奇棋手卡斯帕罗夫。
- 2011年,IBM 开发的能够使用自然语言来回答问题的人工智能系统在综艺节目《危险边缘》中打败了最高奖金得主布拉德·鲁特尔和连胜纪录保持者肯·詹宁斯,赢得了100万美元的奖金。
- 2012年,杰弗里·辛顿和他的学生在 ImageNet 竞赛中使用深度卷积神经网络(CNN)获得了巨大成功,标志着深度学习的兴起。随后,深度学习在图像识别、语音识别、自然语言处理等领域取得了显著进展。
- 2016年,谷歌 DeepMind开发的 AlphaGo 战胜了围棋世界冠军李世乭,展示了深度学习和蒙特卡洛树搜索技术的强大能力。
- 2017年,谷歌的研究人员提出了 Transformer 模型,彻底改变了自然语言处理领域。Transformer 模型基于自注意力机制,大大提高了序列建模的效率和效果。后面的 BERT、GPT 等模型都是基于 Transformer 架构。
- 2018年,OpenAI 开发的 AI 系统 OpenAI Five 在多人在线战术竞技游戏《Dota 2》中击败了半专业和专业玩家团队。
- 2019年,OpenAI 发布了 GPT-2,一个具有15亿参数的语言模型,展示了生成高质量自然语言文本的能力。同年,DeepMind 开发的 AlphaStar 在实时战略游戏《星际争霸II》中击败了人类顶级选手。
- 2020年,OpenAI 发布了 GPT-3,一个具有1750亿参数的语言模型,是当时最大的语言模型,GPT-3 在生成自然语言文本、翻译、编写代码等任务中表现出色,推动了自然语言处理和生成模型的进一步发展。同年,DeepMind 的 AlphaFold 2 在蛋白质结构预测的 CASP 竞赛中取得了突破性成果,预测精度达到了实验级别,这一成就被认为是生物学领域的重大突破,有望推动药物研发和生物学研究的进步。
- 2021年,OpenAI 发布了 DALL-E,这个模型能够根据文本描述生成图像,展示了生成模型在多模态学习和图像生成中的潜力。同年,OpenAI 发布了 Codex,一个可以理解和生成代码的语言模型,是 Copilot 的核心技术。
- 2023年,OpenAI 推出了基于 GPT-4 的 ChatGPT,可以进行更自然、更流畅的对话。随后,国内外行业巨头纷纷入局大模型,各种各样的大模型应用遍地开花。
- 2024年,OpenAI 在 DALL-E 的基础上推出了 Sora,一个可以通过文本描述生成视频的人工智能模型。几天后,一家名为 Cognition AI 的初创公司推出了第一位 AI 软件工程师 Devin。
人工智能自图灵测试和达特茅斯会议以来,经历了多次的高潮和低谷。目前,受益于由于计算机运算和存储能力的飞速提升,从前很多难以实现的技术都成为了现实,而人工智能也又一次被推到了风口浪尖。从早期的专家系统到今天的大模型,AI 技术还在不断的演进和突破。无论是 AlphaGo 攻占了人类智慧的最后高地,还是自动驾驶技术的逐渐普及,又或是人工智能内容生成(AIGC)的广泛应用,你可以清楚的感受到,人工智能正在改变我们的生活。
什么是机器学习
人类通过记忆和归纳这两种方式进行学习,通过记忆可以积累单个事实,使用归纳可以从旧的事实推导出新的事实。机器学习是赋予机器从数据中学习知识的能力,这个过程并不需要人类的帮助(给出明确的规则),也就是说机器学习关注的是从数据中学习一种模式(pattern),即便数据本身存在问题(噪声),这也是机器学习算法和传统算法最根本的区别。传统的算法需要计算机被告知如何从复杂系统中找到答案,算法利用计算机的运算能力去寻找最佳结果。传统算法最大的缺点就是人类必须首先知道最佳的解决方案是什么,而机器学习算法并不需要人类告诉模型最佳解决方案,取而代之的是,我们提供和问题相关的示例数据。
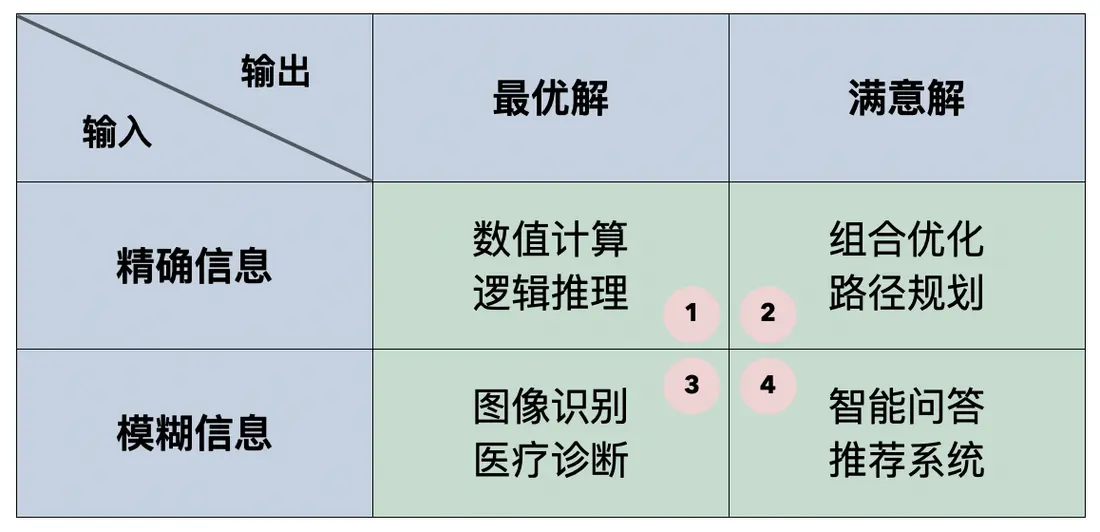
我们可以把需要计算机解决的问题分为四类,分类的依据一方面是输入是精确的还是模糊的,另一方面是输出是最优的还是满意的,我们可以制作出如下所示的表格。可以看出,传统算法擅长解决的只有第一类问题,而机器学习比较擅长解决第三类和第四类问题;第二类问题基本属于 NP 问题(非确定性多项式时间问题),包括旅行经销商问题、图着色问题、集合覆盖问题等,我们通常会采用启发式算法(如模拟退火算法、遗传算法等)或近似算法来解决这类问题,当然机器学习算法也可以为这类问题提供满意解。
当然,机器学习算法并非完美到无懈可击。在通过数据训练模型时,我们需要使用预处理和清洗后的数据,如果数据本身质量非常糟糕,我们也很难训练出一个好的模型,这也是我们经常说到的 GIGO(Garbage In Garbage Out)。如果要使用机器学习,我们还得确定变量之间是否存在某种关系,机器学习无法处理不存在任何关系的数据。大多数时候,机器学习模型输出的是一系列的数字和指标,需要人类解读这些数字和指标并做出决策,判定模型的好坏并决定模型如何在实际的业务场景中落地。通常,我们用来训练模型的数据会存在噪声数据(noisy data),很多机器学习模型对噪声都非常敏感,如果不能处理好这些噪声数据,我们就不太容易得到好的模型。
机器学习的应用领域
即使对于机器学习这个概念不那么熟悉,但是机器学习的成果已经广泛渗透到了生产生活的各个领域,下面的这些场景对于你来说一定不陌生。
场景1:搜索引擎会根据搜索和使用习惯,优化下一次搜索的结果。
场景2:电商网站会根据你的访问历史自动推荐你可能感兴趣的商品。
场景3:金融类产品会通过你最近的金融活动信息综合评定你的贷款申请。
场景4:视频和直播平台会自动识别图片和视频中有没有不和谐的内容。
场景5:智能家电和智能汽车会根据你的语音指令做出相应的动作。
简单的总结一下,机器学习可以应用到但不限于以下领域:
1. 图像识别与计算机视觉
计算机视觉(Computer Vision)是机器学习的一个重要应用领域,涉及到使机器能够理解和处理图像和视频数据。
- 人脸识别:通过深度学习模型识别图片中的人脸,如安全监控、手机解锁等。
- 自动驾驶:自动驾驶汽车使用计算机视觉来识别道路标志、行人、其他车辆、交通信号灯等,从而实现自主导航。
- 医疗影像分析:机器学习应用于X光片、MRI扫描和CT图像的分析,帮助医生发现疾病(如癌症、脑卒中等)。
- 图像分类与标注:自动为图像打标签,比如在社交媒体平台上自动识别图片中的物品和场景。
2. 自然语言处理(NLP)
自然语言处理是机器学习在文本和语音数据上的应用,目的是让计算机能够理解和生成自然语言。
- 语音识别:如智能助手(Siri、Google Assistant)通过语音识别技术将语音转换为文本。
- 机器翻译:Google翻译、百度翻译等应用,使用机器学习技术进行语言之间的自动翻译。
- 情感分析:分析社交媒体帖子、评论等文本数据的情感倾向(积极、消极、中立)。
- 文本生成:自动生成文章或新闻(如GPT系列),为用户提供文章自动写作、智能客服等功能。
- 聊天机器人:例如客服机器人,通过自然语言处理技术与用户进行对话。
3. 推荐系统
推荐系统利用用户行为数据来预测用户可能感兴趣的物品或服务。
- 电子商务:如亚马逊、淘宝等平台根据用户的浏览和购买记录推荐商品。
- 影视推荐:如Netflix、YouTube等根据用户观看历史推荐电影、视频和节目。
- 社交网络推荐:例如,Facebook和Twitter根据用户的兴趣推荐朋友、帖子或广告。
4. 金融领域
机器学习在金融领域的应用主要体现在风险管理、预测和自动化交易等方面。
- 信用评分:银行和金融机构利用机器学习模型评估借款人的信用风险。
- 欺诈检测:通过分析交易模式,机器学习模型能够检测到潜在的欺诈行为(如信用卡欺诈、洗钱行为)。
- 算法交易:利用机器学习算法进行股票和其他金融资产的自动化交易,实时根据市场数据进行决策。
- 投资组合管理:使用机器学习模型进行资产配置和投资组合优化。
5. 医疗健康
机器学习在医疗行业中被广泛应用,尤其是在疾病预测、个性化治疗和医疗图像分析等方面。
- 疾病预测:使用机器学习算法预测疾病的发生概率,例如糖尿病、心脏病等。
- 个性化医疗:基于患者的历史健康数据、基因数据等,机器学习可以帮助提供个性化的治疗方案。
- 药物发现:通过大数据分析,机器学习能够加速新药的发现过程,例如通过预测化合物的药效来筛选潜在药物。
- 健康监测:利用可穿戴设备(如智能手表、健康追踪器)收集的数据,机器学习可以监测健康状况并预测疾病风险。
6. 智能交通与自动驾驶
自动驾驶技术和智能交通系统都依赖于机器学习技术。
- 自动驾驶汽车:自动驾驶依赖于机器学习来识别周围环境(如行人、交通信号、其他车辆等),并作出决策。
- 交通预测:根据交通流量、天气、节假日等因素,机器学习可以预测路况、交通拥堵情况,优化路线规划。
- 车联网(V2X):车与车、车与基础设施之间的通信系统,利用机器学习进行数据分析和决策。
7. 智能家居与物联网
物联网(IoT)设备可以通过机器学习实现自动化和智能化操作。
- 智能家居:如智能音响(Amazon Echo、Google Home)和智能家电(智能空调、智能冰箱等),通过语音和传感器数据自动调整设备设置。
- 环境监控:基于机器学习的传感器数据分析,可以监测室内空气质量、温度等参数,并自动调节环境条件。
- 智能安防:监控摄像头通过人脸识别和行为识别技术,识别潜在的安全威胁。
8. 体育分析
机器学习也在体育领域得到应用,特别是在数据分析和比赛策略优化方面。
- 运动员表现分析:通过分析运动员的训练数据、比赛数据等,机器学习可以帮助教练制定个性化的训练计划。
- 比赛结果预测:通过历史数据和实时数据,机器学习可以预测比赛的结果、球队表现等。
- 虚拟体育教练:利用机器学习技术为运动员提供数据驱动的训练建议和反馈。
9. 制造与工业自动化
机器学习在工业和制造领域主要用于优化生产流程、提高效率和减少故障。
- 预测性维护:机器学习模型通过分析设备的历史数据,预测设备可能发生故障的时间,从而提前进行维护。
- 质量控制:通过对生产数据进行分析,机器学习可以自动识别生产过程中出现的质量问题。
- 自动化生产:机器学习可以帮助机器人根据环境和任务自动调节生产流程,提高生产效率和质量。
机器学习的分类
机器学习模型可以按照不同的标准进行分类,主要包括以下几种:
按照学习方式分类
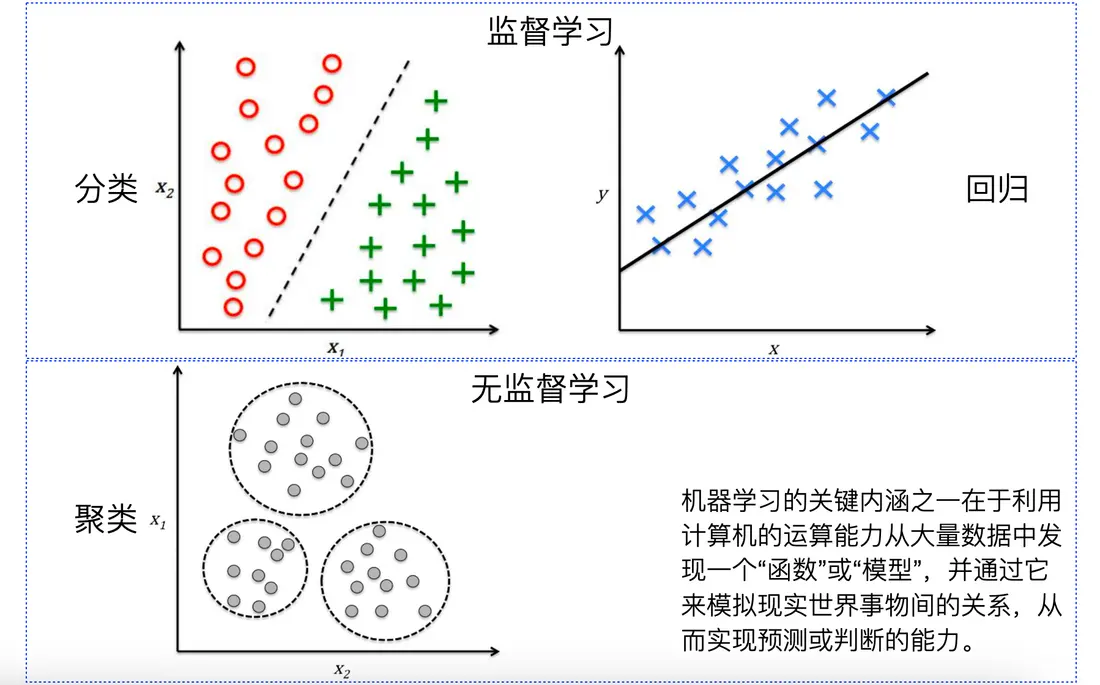
-
监督学习(Supervised Learning)
- 回归(Regression):用于预测连续值的模型,例如线性回归、Ridge 回归、Lasso 回归等。
- 分类(Classification):用于预测离散类别的模型,例如逻辑回归、支持向量机、决策树、随机森林、k近邻、朴素贝叶斯等。
-
无监督学习(Unsupervised Learning)
- 聚类(Clustering):用于将数据分组的模型,例如K均值聚类、层次聚类、DBSCAN 等。
- 降维(Dimensionality Reduction):用于减少特征数量的模型,例如主成分分析(PCA)、线性判别分析(LDA)、t分布随机近邻嵌入(t-SNE)等。
- 关联规则学习(Association Rule Learning):用于发现数据集中项之间关系的模型,例如 Apriori 算法、Eclat 算法等。
-
半监督学习(Semi-Supervised Learning)
- 结合了监督学习和无监督学习的方法,使用大量未标记的数据和少量标记的数据来构建模型。
-
强化学习(Reinforcement Learning)
- 基于奖励机制的学习方法,例如Q-Learning、深度Q网络(DQN)、策略梯度方法等。
按照模型的复杂度分类
- 线性模型(Linear Models):如线性回归、逻辑回归。
- 非线性模型(Non-linear Models):如带核函数的支持向量机(SVM with Kernel)、神经网络。
按照模型的结构分类
- 生成模型(Generative Models):可以生成新的数据点,如朴素贝叶斯、隐马尔可夫模型(HMM)。
- 判别模型(Discriminative Models):仅用于分类或回归,如逻辑回归、支持向量机。
如果不理解上面的分类也没有关系,后续的课程中我们会覆盖到上面说到的很多算法,我们会通过讲解算法的原理、适用场景、优缺点和代码实现来帮助大家掌握这些算法并将其应用于解决实际问题。
机器学习的步骤
机器学习的实施步骤通常分为多个阶段,从问题定义、数据准备到模型部署和维护,每个步骤都非常重要,具体如下所示。
-
定义问题。首先我们需要做业务理解,明确问题的性质和类型,这个会直接影响到后续的数据收集、特征工程、选择算法以及评估指标的确定。
-
数据收集。机器学习模型的训练需要大量的数据,这些数据可能包含结构化数据(数据库、Excel 电子表格等)、非结构化数据(文本、图像、音频、视频等)、其他类型的数据集。
-
数据清洗。数据清洗要确保数据质量高且适合模型训练,具体包括:缺失值和异常值处理、数据标准化和归一化、特殊编码、特征工程等。
-
数据划分。为了评估机器学习模型的泛化能力,需要将数据划分为训练集和测试集。除此以外,还可能使用交叉验证的方式将数据分成多个子集,每个子集轮流作为验证集,从而对模型的超参数进行调整。
-
模型选择。针对分类问题、回归问题、聚类问题、深度学习,我们选择的机器学习算法或模型是不一样的。
-
模型训练。使用训练集对模型进行训练,使模型能够学习到输入特征与目标之间的关系。此外,每个机器学习算法都有超参数,这些参数需要根据数据和任务来调优。
-
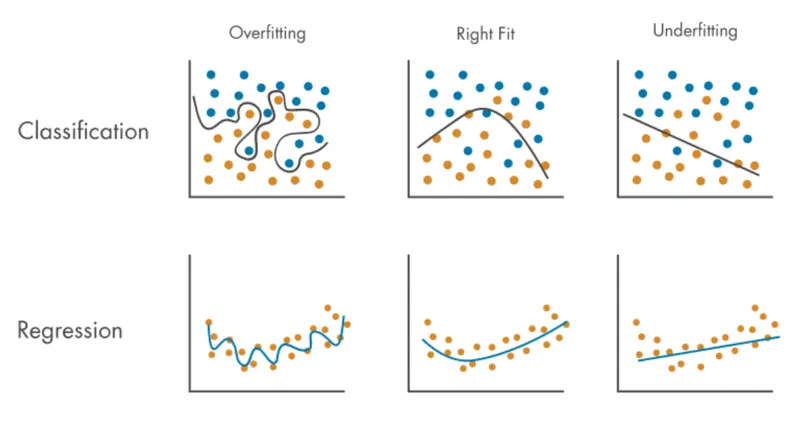
模型评估。模型评估主要的目标是确定模型在新数据(测试集)上的表现,确保模型没有出现过拟合(overfitting)或欠拟合(underfitting),如下图所示。欠拟合会导致模型的预测效果糟糕,而过拟合会导致模型缺乏泛化能力,即在测试集和新数据上表现欠佳。当然,为了提高模型的性能或适应性,可能还要通过正则化、集成学习、算法调整等方式进行调优。
-
模型部署。当你对模型的性能感到满意时,可以将模型部署到生产环境中,进行实时预测或批量预测。我们通过监控模型在实际应用中的表现,确保其持续保持较好的预测效果。如果模型性能下降,可能需要重新训练或调整。
-
模型维护。机器学习模型不是一成不变的,随着时间的推移,模型可能需要通过重新训练、增量学习等方式来维持其性能。
说明:如果对上面出现的概念不是很理解,可以先跳过去,我们会在遇到这些问题的时候展开讲解。
第一次机器学习
下面,我们用一个极为简单的例子带大家开启第一次机器学习之旅。当然,作为本课的第一个案例,我们并没有严格执行上面提到的机器学习的实施步骤,我们只想通过这个例子对机器学习有一个感性的认知,消除机器学习在很多人心中的“神秘感”。为了研究某城市某类消费者每月收入和每月网购支出的关系,我们收集到了50条样本数据(后面我们统称为历史数据),分别保存在两个列表中,如下所示。
# 每月收入x = [9558, 8835, 9313, 14990, 5564, 11227, 11806, 10242, 11999, 11630, 6906, 13850, 7483, 8090, 9465, 9938, 11414, 3200, 10731, 19880, 15500, 10343, 11100, 10020, 7587, 6120, 5386, 12038, 13360, 10885, 17010, 9247, 13050, 6691, 7890, 9070, 16899, 8975, 8650, 9100, 10990, 9184, 4811, 14890, 11313, 12547, 8300, 12400, 9853, 12890]# 每月网购支出y = [3171, 2183, 3091, 5928, 182, 4373, 5297, 3788, 5282, 4166, 1674, 5045, 1617, 1707, 3096, 3407, 4674, 361, 3599, 6584, 6356, 3859, 4519, 3352, 1634, 1032, 1106, 4951, 5309, 3800, 5672, 2901, 5439, 1478, 1424, 2777, 5682, 2554, 2117, 2845, 3867, 2962, 882, 5435, 4174, 4948, 2376, 4987, 3329, 5002]我们假设月收入和月网购支出都来自于正态总体,接下来我们可以通过计算皮尔逊相关系数来判定两组数据是否存在相关性,代码如下所示。如果对相关性和相关系数不理解,可以移步到我的《数据思维和统计思维》专栏看看。
import numpy as np
np.corrcoef(x, y)输出:
array([[1. , 0.94862936], [0.94862936, 1. ]])可以看出该城市该类人群的月收入和月网购支出之间存在强正相关性(相关系数为0.94862936)。当然,计算皮尔逊相关系数也可以使用 scipy 中的stats.pearsonr函数,该函数在计算相关系数的同时,还会给出统计检验的 P 值,我们可以根据 P 值来判定相关性是否显著,代码如下所示。
from scipy import stats
stats.pearsonr(x, y)输出:
PearsonRResult(statistic=0.9486293572644154, pvalue=1.2349851929268588e-25)上面,我们已经确认了月收入和月网购支出之间存在强相关性,那么一个很自然的想法就是通过某人的月收入来预测他的月网购支出,反过来当然也是可以的。为了做到这一点,可以充分利用我们收集到的历史数据,让计算机通过对数据的“学习”获得相应的知识,从而实现对未知状况的预测。我们可以将上述数据中的 称为自变量或特征(feature),将 称为因变量或目标值(target),机器学习的关键就是要通过历史数据掌握如何实现从特征到目标值的映射。
kNN算法
要通过月收入预测月网购支出,一个最朴素的想法就是将历史数据做成一个字典,月收入作为字典中的键,月网购支出作为对应的值,这样就可以通过查字典的方式通过收入查到支出,如下所示。
sample_data = {key: value for key, value in zip(x, y)}但是,输入的月收入未必在字典中对应的键,没有键就无法获取对应的值,这个时候我们可以找到跟输入的月收入最为接近的 k 个键,对这 k 个键对应的值求平均,用这个平均值作为对月网购支出的预测。这里的方法就是机器学习中最为简单的 k 最近邻算法(kNN),它是一种用于分类和回归的非参数统计方法,下面我们用原生 Python 代码来实现 kNN 算法,暂时不使用 NumPy、SciPy、Scikit-Learn 这样的三方库,主要帮助大家理解算法的原理。
import heapqimport statistics
def predict_by_knn(history_data, param_in, k=5): """用kNN算法做预测 :param history_data: 历史数据 :param param_in: 模型的输入 :param k: 邻居数量(默认值为5) :return: 模型的输出(预测值) """ neighbors = heapq.nsmallest(k, history_data, key=lambda x: (x - param_in) ** 2) return statistics.mean([history_data[neighbor] for neighbor in neighbors])上面的代码中,我们用 Python 中heapq模块的nsmallest来找到历史数据中最小的 k 个元素,通过该函数的key参数,我们界定了最小指的是跟输入的参数param_in误差最小,由于误差有正数和负数,所以通常都需要求平方或者取绝对值。对于算术平均值的计算,我们使用了 Python 中statistics模块的mean函数,对heapq和statistics模块不熟悉的可以看看 Python 的官方文档,此处不再赘述。接下来,我们用上面的函数来预测月网购支出,代码如下所示。
incomes = [1800, 3500, 5200, 6600, 13400, 17800, 20000, 30000]for income in incomes: print(f'月收入: {income:>5d}元, 月网购支出: {predict_by_knn(sample_data, income):>6.1f}元')输出:
月收入: 1800元, 月网购支出: 712.6元月收入: 3500元, 月网购支出: 712.6元月收入: 5200元, 月网购支出: 936.0元月收入: 6600元, 月网购支出: 1487.0元月收入: 13400元, 月网购支出: 5148.6元月收入: 17800元, 月网购支出: 6044.4元月收入: 20000元, 月网购支出: 6044.4元月收入: 30000元, 月网购支出: 6044.4元通过上面的输出,我们可以看出 kNN 算法的一个弊端,样本数据的缺失或者不均衡情况会导致预测结果非常糟糕。上面月收入17800元、20000元、30000元的网购支出预测值都是6044.4元,那是因为历史数据中月收入的最大值是19880,所以跟它们最近的 k 个邻居是完全相同的,所以从历史数据预测出的网购支出也是相同的;同理,月收入1800元跟月收入3500元的网购支出预测值也是相同的,因为跟1800元最近的 k 个邻居和跟3500元最近的 k 个邻居也是完全相同的。当然,上面我们给出的 kNN 算法实现还有其他的问题,大家应该不难发现predict_by_knn函数中,我们每次找寻最近的 k 个邻居时,都要将整个历史数据遍历一次,如果数据集体量非常大,那么这个地方就会产生很大的开销。
回归模型
我们换一种思路来预测网购支出,我们将月收入和月网购支出分别作为横纵坐标来绘制散点图。既然网购支出跟月收入之间存在强正相关,这就意味着可以找一条直线来拟合这些历史数据点,我们把这条直线的方程 称为回归方程或回归模型,如下图所示。
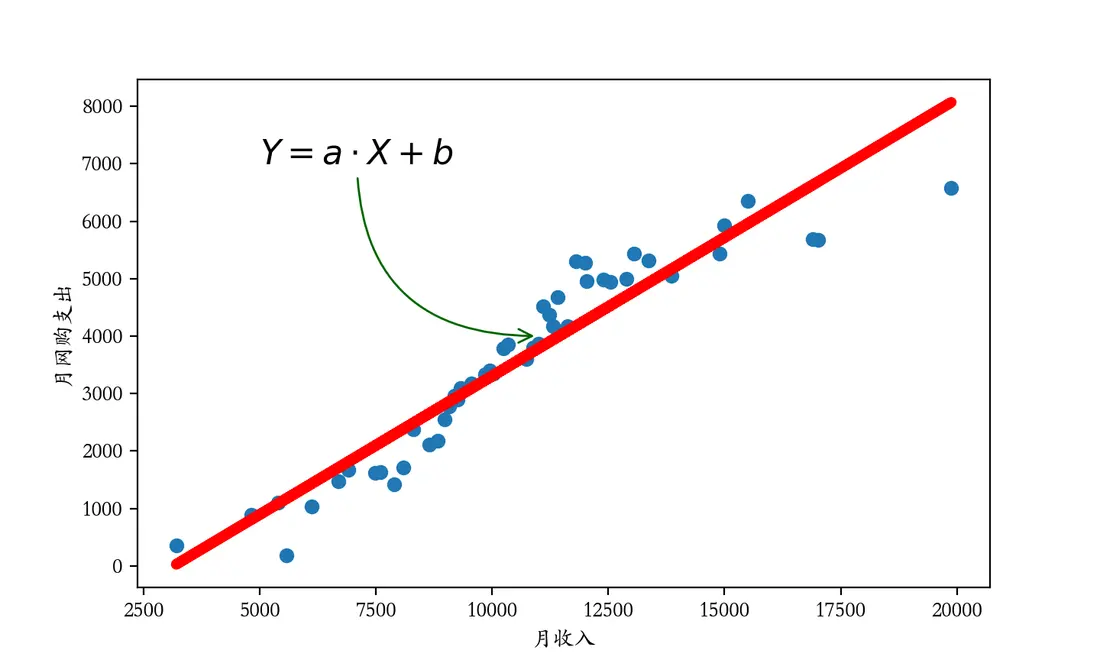
现在,我们的问题就变成了如何利用收集到的历史数据计算出回归模型的斜率 和截距 。为了评价回归模型的好坏,也就是我们计算出的斜率和截距是否理想,我们可以先定义评判标准,一个简单且直观的评判标准就是我们将月收入 带入回归模型,计算出月网购支出的预测值 ,预测值 和真实值 之间的误差越小,说明我们的回归模型越理想。之前我们提到过,计算误差的地方通常都需要取绝对值或者求平方,我们可以用误差平方的均值来作为评判标准,通常称之为均方误差(MSE),如下所示。
根据上面的公式,我们可以写出计算均方误差的函数,通常称之为损失函数。
import statistics
def get_loss(X_, y_, a_, b_): """损失函数 :param X_: 回归模型的自变量 :param y_: 回归模型的因变量 :param a_: 回归模型的斜率 :param b_: 回归模型的截距 :return: MSE(均方误差) """ y_hat = [a_ * x + b_ for x in X_] return statistics.mean([(v1 - v2) ** 2 for v1, v2 in zip(y_, y_hat)])能让 MSE 达到最小的 和 ,我们称之为回归方程的最小二乘解,接下来的工作就是要找到这个最小二乘解。简单的说,我们要将可能的 和 带入损失函数,看看什么样的 和 能让损失函数取到最小值。如果对 和 的取值一无所知,我们可以通过不断产生随机数的方式来寻找 和 ,这种方法称为蒙特卡洛模拟,通俗点说就是随机瞎蒙,代码如下所示。
import random
# 先将最小损失定义为一个很大的值min_loss, a, b = 1e12, 0, 0
for _ in range(100000): # 通过产生随机数的方式获得斜率和截距 _a, _b = random.random(), random.uniform(-2000, 2000) # 带入损失函数计算回归模型的MSE curr_loss = get_loss(x, y, _a, _b) if curr_loss < min_loss: # 找到更小的MSE就记为最小损失 min_loss = curr_loss # 记录下当前最小损失对应的a和b a, b = _a, _b
print(f'MSE = {min_loss}')print(f'{a = }, {b = }')上面的代码进行了100000次的模拟, 的值在 范围随机选择, 的值在 范围随机选择的,下面是在我的电脑上跑出来的结果。大家可以把自己蒙特卡罗模拟的结果分享到评论区,看看谁的运气更好,找到了让误差更小的 和 。
MSE = 270690.1419424315a = 0.4824040159203802, b = -1515.0162977046068对于数学知识比较丰富的小伙伴,我们可以将回归模型带入损失函数,由于 和 是已知的历史数据,那么损失函数其实是一个关于 和 的二元函数,如下所示。
根据微积分的极值定理,我们可以对 求偏导数,并令其等于0,这样我们就可以计算让 取到最小值的 和 分别是多少,即:
求解上面的方程组可以得到:
需要说明的是,如果回归模型本身比较复杂,不像线性模型 这么简单,可能没有办法像上面那样直接求解方程,而是要通过其他的方式来找寻极值点,这个我们会在后续的内容中会为大家讲解。回到刚才的问题,我们可以通过上面的公式计算出 和 的值,为了运算方便,下面直接使用了 NumPy 中的函数,因为 NumPy 中的运算都是矢量化的,通常不需要我们自己写循环结构,对 NumPy 不熟悉的小伙伴,可以移步到我的《基于Python的数据分析》专栏。
import numpy as np
x_bar, y_bar = np.mean(x), np.mean(y)a = np.dot((x - x_bar), (y - y_bar)) / np.sum((x - x_bar) ** 2)b = y_bar - a * x_barprint(f'{a = }, {b = }')输出:
a = 0.482084452824066, b = -1515.2028590756745事实上,NumPy 库中还有封装好的函数可以帮我们完成参数拟合,你可以使用linalg模块的lstsq函数来计算最小二乘解,也可以使用polyfit函数或Polynomial类型的fit方法来获得最小二乘解,代码如下所示。大家可以看看,跟上面求偏导数找极值点获得的结果是否相同。
a, b = np.polyfit(x, y, deg=1)print(f'{a = }, {b = }')或
from numpy.polynomial import Polynomial
b, a = Polynomial.fit(x, y, deg=1).convert().coefprint(f'{a = }, {b = }')说明:上面代码中的
deg参数代表多项式的最高次项是几次项,deg=1说明我们使用的是线性回归模型。
小结
首先,希望本篇内容能对大家了解机器学习有那么一点点帮助;其次,希望通过本章向大家传达一个理念,自己手撕机器学习的代码比直接调用三方库弄出一个结果来其实更有意思,它会让你对算法原理、应用场景、利弊情况等都有一个更好的认知。
82 k最近邻算法
k 最近邻算法(kNN)是一种用于分类和回归的非参数统计方法,由美国统计学家伊芙琳·费克斯和小约瑟夫·霍奇斯于 1951 年提出。kNN 算法的原理是从历史数据中找到 个跟新输入的实例最邻近的实例,根据它们中的多数所属的类别来对新实例进行分类或者输出新实例的目标值,这种算法我们在前面已经为大家做了简单的展示。与主流的机器学习算法不同,k 最近邻算法没有显式的学习训练过程,它用的是“近朱者赤,近墨者黑”这样一种简单朴素的思想来实现分类或回归。k 最近邻算法有两个关键问题,第一个是 值如何选择,即用多少个最近邻来判定新实例所属的类别或确定其目标值;第二个是如何判定两个实例是近还是远,这里就涉及到度量距离的问题。
距离的度量
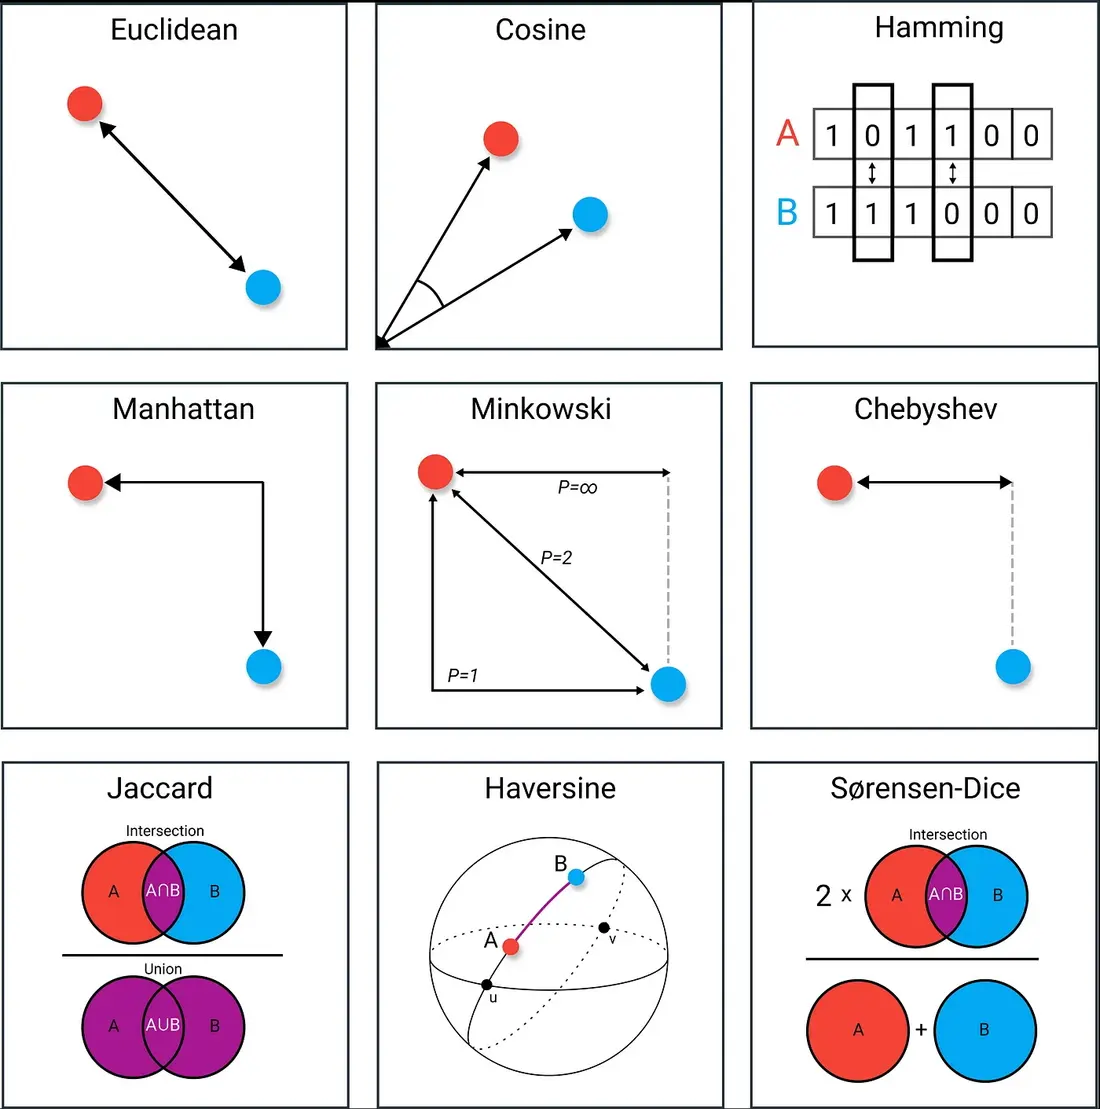
我们可以用距离(distance)来衡量特征空间中两个实例之间的相似度,常用的距离度量包括闵氏距离、马氏距离、余弦距离、编辑距离等。闵氏距离全称闵可夫斯基距离(Minkowski Distance),对于两个 维向量 和 ,它们之间的距离可以定义为:
其中, ,虽然 可以计算,但不再严格满足距离的定义,通常不被视为真正的距离。
当 时,闵氏距离即曼哈顿距离:
当 时,闵氏距离即欧几里得距离:
当 时,闵氏距离即切比雪夫距离:
其他的距离度量方式我们等用到的时候再为大家介绍。在使用 k 最近邻算法做分类时,我们的数据集通常都是数值型数据,此时直接使用欧几里得距离是一个不错的选择。
数据集介绍
接下来为大家隆重介绍一下我们后续会使用到的一个重要的数据集——鸢尾花数据集(iris dataset)。鸢尾花数据集是机器学习领域中最著名、最经典的数据集之一,由植物学家 Edgar S. Anderson 在加拿大魁北克加斯帕半岛采集,由英国统计学家 Ronald A. Fisher 于 1936 年在他的论文*《The Use of Multiple Measurements in Taxonomic Problems》*中首次引入,被广泛用于机器学习算法的入门和实验。
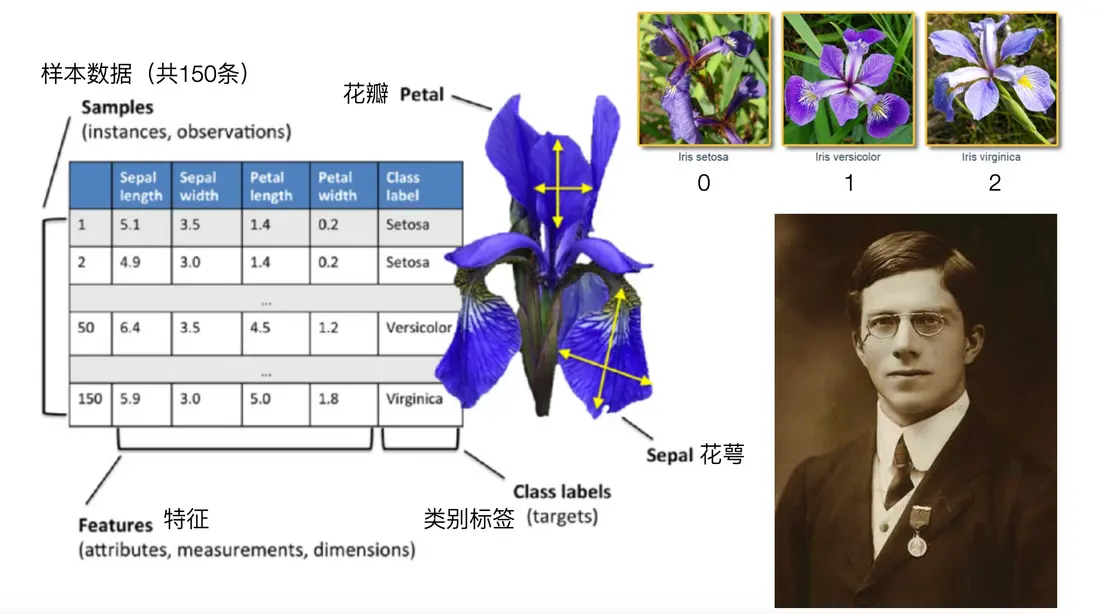
鸢尾花数据集共有 150 条样本,其中包含 3 种类型的鸢尾花,分别是山鸢尾(Iris setosa)、多彩鸢尾(Iris versicolor)和为吉尼亚鸢尾(Iris virginica),如上图所示,每种各有50条样本。样本数据包含了 4 个特征(features)和 1 个类别标签(class label),4 个特征分别是花萼长度(Sepal length)、花萼宽度(Sepal width)、花瓣长度(Petal length)、花瓣宽度(Petal width),都是以厘米为单位的正数,数据集中的类别标签有 0、1、2 三个值,对应上面提到的三种鸢尾花类型。
数据集的加载
我们可以通过著名的 Python 机器学习库 scikit-learn 来加载这个数据集,scikit-learn 包含了各种分类、回归、聚类算法,同时还提供了多层感知机、支持向量机、随机森林等模型,覆盖了从数据预处理、特征工程到模型训练、模型评估和参数调优等各项功能,如下图所示。我们推荐大家使用这个库来完成机器学习中的各种操作,scikit-learn 的官方网站上面还提供了用户指南、API 文档和案例等内容,有兴趣的读者可以自行访问。
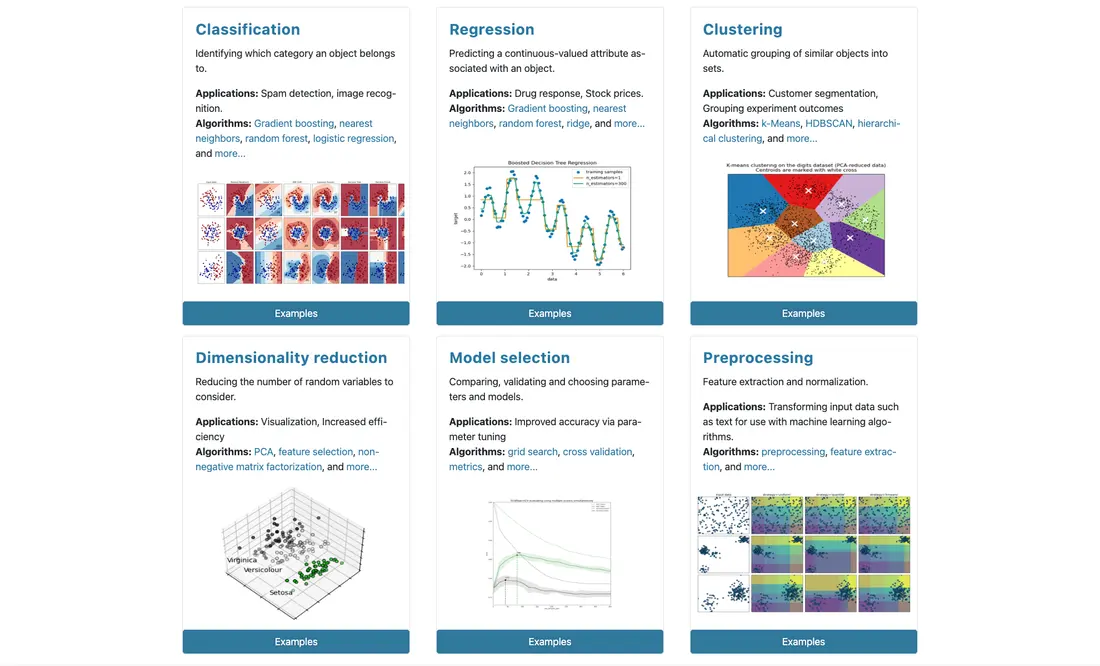
由于我们后续的课程基本都会用到这个库,大家可以先通过下面的命令安装这个库。
pip install scikit-learn如果你已经打开了 IPython 或 Jupyter 但尚未安装 scikit-learn,可以通过下面的魔法指令来安装这个库。
%pip install scikit-learn在安装完成之后,我们可以通过下面的代码加载鸢尾花数据集并查看该数据集的介绍。
from sklearn.datasets import load_iris
# 加载鸢尾花数据集iris = load_iris()# 查看数据集的介绍print(iris.DESCR)接下来,我们可以获得数据集中的特征和标签,代码如下所示。
# 特征(150行4列的二维数组,分别是花萼长、花萼宽、花瓣长、花瓣宽)X = iris.data# 标签(150个元素的一维数组,包含0、1、2三个值分别代表三种鸢尾花)y = iris.target如果希望更直观的查看鸢尾花数据集,我们可以用上面获得的特征和标签来创建一个 DataFrame 对象,有兴趣的读者可以自己试一试。
数据集的划分
通常,我们需要将原始数据划分成训练集和测试集,其中训练集是为了训练模型选择的数据,而测试集则是为了测试模型训练效果保留的数据。对于上面的鸢尾花数据集,我们可以选择 80% 的数据(120 条)作为训练集,保留 20% 的数据(30 条)作为测试集,下面的代码用 NumPy 实现了对数据集的划分。
# 将特征和标签堆叠到同一个数组中data = np.hstack((X, y.reshape(-1, 1)))# 通过随机乱序函数将原始数据打乱np.random.shuffle(data)# 选择80%的数据作为训练集train_size = int(y.size * 0.8)train, test = data[:train_size], data[train_size:]X_train, y_train = train[:, :-1], train[:, -1]X_test, y_test = test[:, :-1], test[:, -1]当然,更简便的划分数据集的方式是使用 scikit-learn 封装好的函数train_test_split,我们只需要传入特征和标签,指定好train_size或test_size就可以实现同样的操作。train_test_split函数返回一个四元组,四个元素分别代表用于训练的特征、用于训练的标签、用于测试的特征和用于测试的标签。
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)说明:上面代码中
train_test_split函数的random_state参数可以理解成随机数的种子,如果你使用跟我相同的随机数种子,那么我们划分的训练集和测试集也是完全相同的。
kNN分类的实现
下面我们先不用 scikit-learn 而是用基础的数据科学库 NumPy 和 SciPy 来实现 kNN 算法,这样做的目的是帮助大家更好的理解算法原理,在此基础上我们再感受 scikit-learn 的强大并明白其中类、函数、参数等为什么要如此设定。
基于NumPy的实现
k 最近邻算法需要计算距离,下面我们先设计计算两个数据点欧式距离的函数,代码如下所示。
import numpy as np
def euclidean_distance(u, v): """计算两个n维向量的欧式距离""" return np.sqrt(np.sum(np.abs(u - v) ** 2))接下来,我们设计根据邻居的标签为新数据生成标签的函数。
from scipy import stats
def make_label(X_train, y_train, X_one, k): """ 根据历史数据中k个最近邻为新数据生成标签 :param X_train: 训练集中的特征 :param y_train: 训练集中的标签 :param X_one: 待预测的样本(新数据)特征 :param k: 邻居的数量 :return: 为待预测样本生成的标签(邻居标签的众数) """ # 计算x跟每个训练样本的距离 distes = [euclidean_distance(X_one, X_i) for X_i in X_train] # 通过一次划分找到k个最小距离对应的索引并获取到相应的标签 labels = y_train[np.argpartition(distes, k - 1)[:k]] # 获取标签的众数 return stats.mode(labels).mode说明:
np.partition函数可以对数组进行一次划分,将 k 个比较小的元素放在数组的左边,n - k 个比较大的元素放在数组的右边,跟快速排序算法中做一次划分操作的效果是一样的。上面代码中的np.argpartition函数是把 k 个较小元素的索引放在数组的左边,这样经过[:k]切片操作和对y_train的花式索引运算,就可以获得 k 个跟新数据距离较小的样本对应的标签。最后,我们通过 scipy 库的 stats 模块的mode函数可以获得标签的众数,并用它作为我们给新数据预测的类别标签。
在完成上述准备工作后,用 k 最近邻做预测的函数就呼之欲出了,代码如下所示。
def predict_by_knn(X_train, y_train, X_new, k=5): """ KNN算法 :param X_train: 训练集中的特征 :param y_train: 训练集中的标签 :param X_new: 待预测的样本构成的数组 :param k: 邻居的数量(默认值为5) :return: 保存预测结果(标签)的数组 """ return np.array([make_label(X_train, y_train, X, k) for X in X_new])我们用上面准备好的鸢尾花数据的训练集和测试集来做实验,看看我们的predict_by_knn函数能否很好的运转起来。下面代码中的y_pred是我们通过函数预测的30条鸢尾花的类型,我们跟y_test做一个比较,就可以看到我们的预测效果。
y_pred = predict_by_knn(X_train, y_train, X_test)y_pred == y_test我这里的输出是:
array([ True, True, True, True, True, True, True, True, True, True, True, True, True, True, True, True, False, True, True, True, True, True, True, True, True, True, True, True, True, True])输出的结果中有一个False,这表示预测的标签跟真实的标签并不相同,是一个错误的预测结果,也就是说我们预测的准确率为 ,即96.67%。当然,如果你划分训练集和测试集时跟我指定的random_state参数不相同,这里得到的结果可能会跟我不同。
基于scikit-learn的实现
使用 scikit-learn 来实现 kNN 算法就要简单许多了,我们基本上只需要做三个动作就可以得到想要的结果,代码如下所示。
from sklearn.neighbors import KNeighborsClassifier
# 创建模型model = KNeighborsClassifier()# 训练模型model.fit(X_train, y_train)# 预测结果y_pred = model.predict(X_test)我们来看看输出的结果,是不是跟我们自己手撕的代码完全一致。
y_pred == y_test输出:
array([ True, True, True, True, True, True, True, True, True, True, True, True, True, True, True, True, False, True, True, True, True, True, True, True, True, True, True, True, True, True])当然,scikit-learn 库考虑到的东西肯定比我们自己手撕的代码丰富得多,例如我们想知道模型预测的准确率(accuracy),可以使用下面的函数。
model.score(X_test, y_test)输出:
0.9666666666666667模型评估
当然,评价一个分类器的预测效果是否良好,不能只简单的看一下准确率,因为在类别不平衡的情况下,准确率很可能会误导你的判断。例如,我们的测试数据中维吉尼亚鸢尾花的样本数量非常小,那么即便我们的模型根本无法判断维吉尼亚鸢尾花,模型也会表现出很高的准确率。所以,我们还要考察查准率(精确率)、查全率(召回率)、F1 分数等指标,而混淆矩阵则是用于详细展示分类模型性能的工具,适用于二分类和多分类任务,二分类问题的混淆矩阵如下所示。
| 预测为正类(Positive) | 预测为负类(Negative) | |
|---|---|---|
| 实际为正类(Positive) | True Positive(TP) | False Negative(FN) |
| 实际为负类(Negative) | False Positive(FP) | True Negative(TN) |
我们举一个例子来说明如何使用混淆矩阵并计算出分类模型的评估指标。假设某种医学检测系统的目标预测是否患有某种疾病,类别“正类”表示“患病”,类别“负类”表示“未患病”,1000个样本的测试结果如下所示。
| 预测为患病 | 预测为未患病 | |
|---|---|---|
| 实际为患病 | 80(TP) | 20(FN) |
| 实际为未患病 | 30(FP) | 870(TN) |
- 准确率(Accuracy)。
上面的例子,模型预测的准确率为: 。
- 精确率(Precesion)。精确率用于衡量在所有被预测为正类的样本中,实际上属于正类的比例,通常也被称为查准率。
上面的例子,模型预测的精确率为: 。
- 召回率(Recall)。召回率用于衡量在所有实际为正类的样本中,被模型正确预测为正类的比例,通常也被称为查全率或真正例率(True Positive Rate)。
上面的例子,模型预测的召回率为: 。
- F1 分数(F1 Score)。F1 分数是精确率和召回率的调和平均数,它在精确率和召回率之间寻求一个平衡,尤其适用于在两者之间有权衡的情况。
上面的例子,模型预测的F1 分数为: 。
- 特异度(Specificity)和假正例率(False Positive Rate,简称 FPR)。特异度用于衡量的是在所有实际为负类的样本中,被模型正确预测为负类的比例,类似于召回率,只不过针对的是负类样本。
上面的例子,模型预测的特异度为: 。
-
ROC 和 AUC。
-
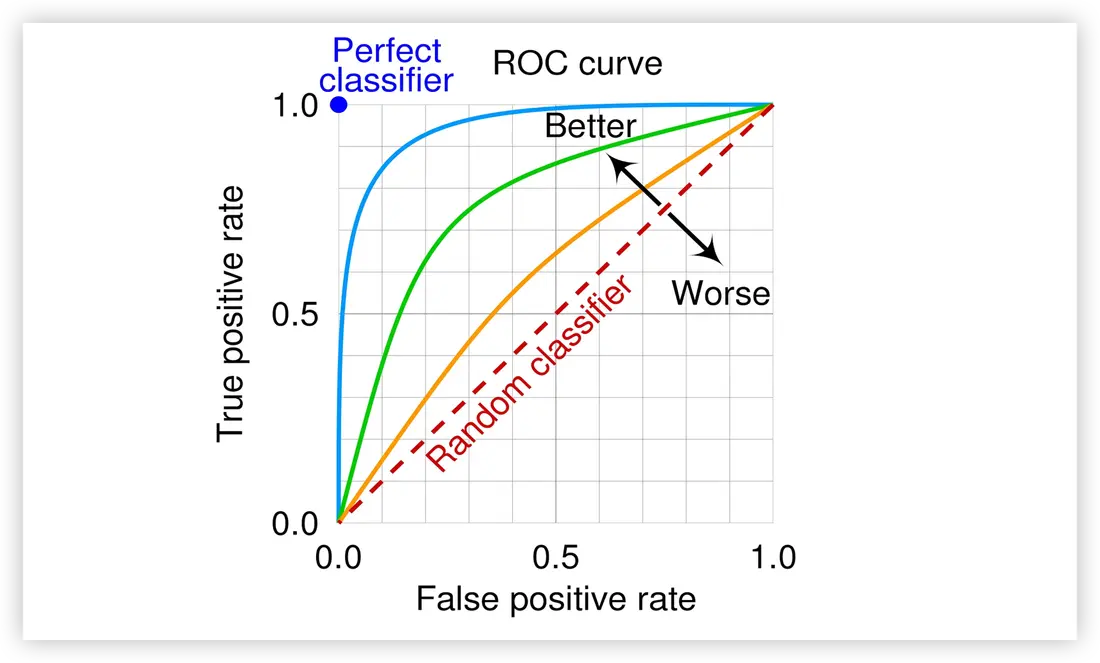
ROC(Receiver Operating Characteristic Curve)绘制了召回率与假正例率的关系,如下图所示。
-
AUC(Area Under the Curve)是 ROC 曲线下的面积,衡量模型区分正类和负类的能力。AUC 值的范围是 ,值越接近 1,表示模型区分正负类的能力越强。0.5 < AUC < 1,说明我们的模型优于随机猜测,只要这个分类器(模型)妥善设置阈值的话,就有预测价值。AUC = 0.5,说明我们的模型跟随机猜测一样,模型没有预测价值。AUC < 0.5,模型比随机猜测还差,但只要总能反向预测,它的实际效果就优于随机猜测。
-
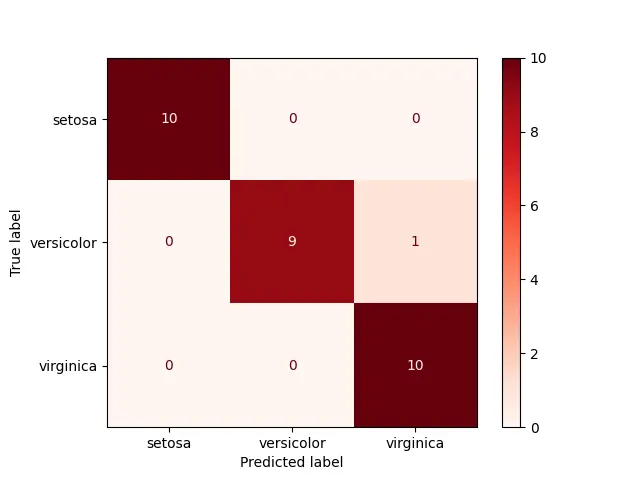
对于多分类问题,混淆矩阵的行数和列数都等于类别数,混淆矩阵是一个方阵,也就是说如果有 个类别,那么混淆矩阵就是一个 的方阵。根据上面我们得到的鸢尾花数据集的预测结果,我们先输出真实值和预测值,然后制作对应的混淆矩阵,如下所示。
print(y_test)print(y_pred)输出:
[0 0 0 0 0 2 1 0 2 1 1 0 1 1 2 0 1 2 2 0 2 2 2 1 0 2 2 1 1 1][0 0 0 0 0 2 1 0 2 1 1 0 1 1 2 0 2 2 2 0 2 2 2 1 0 2 2 1 1 1]| 预测为类别0(山鸢尾) | 预测为类别1(多彩鸢尾) | 预测为类别2(为吉尼亚鸢尾) | |
|---|---|---|---|
| 实际为类别0(山鸢尾) | 10 | 0 | 0 |
| 实际为类别1(多彩鸢尾) | 0 | 9 | 1 |
| 实际为类别2(吉尼亚鸢尾) | 0 | 0 | 10 |
我们可以用 scikit-learn 中的confusion_matrix和classification_report函数来输出混淆矩阵和评估报告,代码如下所示。
from sklearn.metrics import classification_report, confusion_matrix
# 输出分类模型混淆矩阵print('混淆矩阵: ')print(confusion_matrix(y_test, y_pred))# 输出分类模型评估报告print('评估报告: ')print(classification_report(y_test, y_pred))输出:
混淆矩阵:[[10 0 0] [ 0 9 1] [ 0 0 10]]评估报告: precision recall f1-score support
0 1.00 1.00 1.00 10 1 1.00 0.90 0.95 10 2 0.91 1.00 0.95 10
accuracy 0.97 30 macro avg 0.97 0.97 0.97 30weighted avg 0.97 0.97 0.97 30如果希望用可视化的方式输出混淆矩阵,可以使用如下所示的代码。
import matplotlib.pyplot as pltfrom sklearn.metrics import ConfusionMatrixDisplay
# 创建混淆矩阵显示对象cm_display_obj = ConfusionMatrixDisplay(confusion_matrix(y_test, y_pred), display_labels=iris.target_names)# 绘制并显示混淆矩阵cm_display_obj.plot(cmap=plt.cm.Reds)plt.show()说明:其中的
iris.target_names就是类别标签0、1、2对应的三种鸢尾花的英文名。
对于二分类问题,如果想要绘制出 ROC 曲线并显示 AUC 值,可以使用如下所示的代码。
from sklearn.metrics import roc_curve, aucfrom sklearn.metrics import RocCurveDisplay
# 手动构造一组真实值和对应的预测值y_test_ex = np.array([0, 0, 0, 1, 1, 0, 1, 1, 1, 0])y_pred_ex = np.array([1, 0, 0, 1, 1, 0, 1, 1, 0, 1])# 通过roc_curve函数计算出FPR(假正例率)和TPR(真正例率)fpr, tpr, _ = roc_curve(y_test_ex, y_pred_ex)# 通过auc函数计算出AUC值并通过RocCurveDisplay类绘制图形RocCurveDisplay(fpr=fpr, tpr=tpr, roc_auc=auc(fpr, tpr)).plot()plt.show()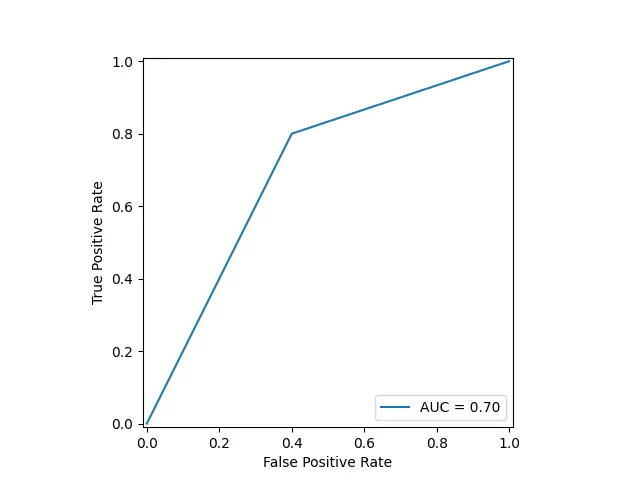
参数调优
之前我们说过,kNN 算法有两个关键问题,一是距离的度量,二是 k 值的选择。我们使用 scikit-learn 的KNeighborsClassifier创建分类器模型时,可以对模型的超参数进行设置,这里有几个比较重要的参数:
n_neighbors:近邻的数量,就是 kNN 算法中 k 的值。weights:可以选择uniform或distance,前者表示所有样本的权重相同,后者表示距离越近权重越高,默认值是uniform。当然,我们也可以通过传入自定义的函数来确定每个样本的权重。algorithm:有auto、ball_tree、kd_tree、brute四个选项,默认值为auto。其中ball_tree是一种树形结构,基于球体划分的方法将数据点分配到层次化的树结构中,在高维数据和稀疏数据场景下有较好的性能;kd_tree也是一种树形结构,通过选择一个维度将空间划分为若干个子区域再进行搜索,从而避免跟所有的邻居进行比较,对于低维度和空间分布均匀的数据,后者有较好的效果,在高维空间中会遇到的维度灾难问题;auto选项是根据输入数据的维度自动选择ball_tree或kd_tree;brute选项则是使用暴力搜索算法(穷举法),再处理小数据集时,它是一个简单且有效的选择。leaf_size:使用ball_tree或kd_tree算法时,该参数用于限制树结构叶子节点最大样本数量,默认值为30,该参数会影响树的构建和节点查找的性能。p:闵可夫斯基距离公式中的p,默认值为2,计算欧氏距离。
我们可以使用网格搜索(Grid Search)和交叉验证(Cross Validation)的方式对模型的超参数进行调整,评估模型的泛化能力,提升模型的预测效果。网格搜索就是通过穷举法遍历给定的超参数空间,找到最优的超参数组合;交叉验证则是将训练集分成多个子集,通过在不同的训练集和验证集上进行多次训练和评估,对模型的预测效果进行综合评判。K-Fold交叉验证是最常用的交叉验证方法,通过将数据集划分为 K 个子集,每次选取其中一个子集作为验证集,剩下的 K-1 个子集作为训练集,对每个子集重复这个过程,完成 K 次训练和评估并将平均值作为模型的最终性能评估,如下图所示。
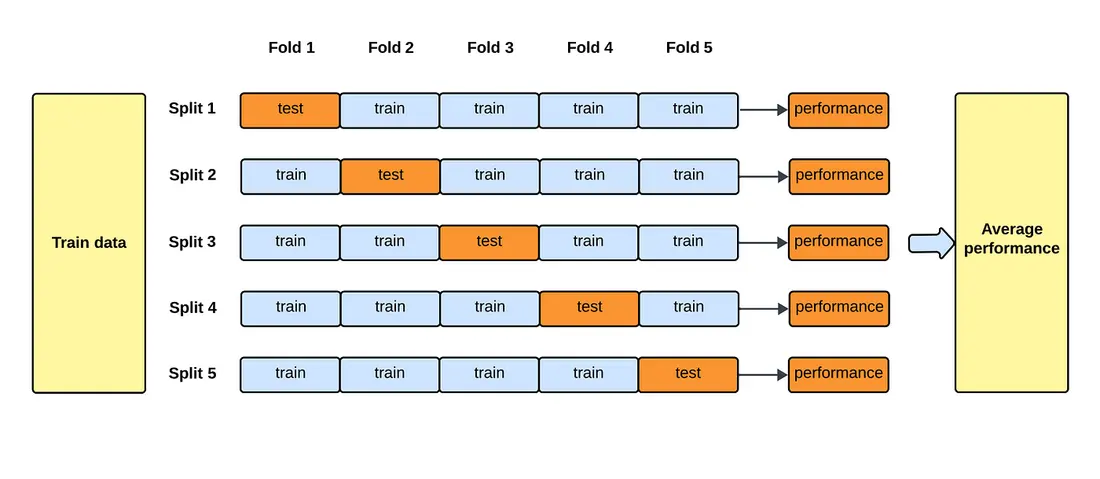
下面的代码了 scikit-learn 库中的GridSearchCV来做网格搜索和交叉验证,通过这种方式找到针对鸢尾花数据集实施 kNN 算法的最优参数。
from sklearn.model_selection import GridSearchCV
# 网格搜索交叉验证gs = GridSearchCV( estimator=KNeighborsClassifier(), param_grid={ 'n_neighbors': [1, 3, 5, 7, 9, 11, 13, 15], 'weights': ['uniform', 'distance'], 'p': [1, 2] }, cv=5)gs.fit(X_train, y_train)可以通过下面的代码获得最优参数及其评分。
print('最优参数:', gs.best_params_)print('评分:', gs.best_score_)输出:
最优参数: {'n_neighbors': 5, 'p': 2, 'weights': 'uniform'}评分: 0.9666666666666666如果需要使用训练好的最优模型进行预测,可以按照如下所示的代码进行操作。
gs.predict(X_test)kNN回归
kNN 算法通常用于解决分类问题,当然它也可以用于解决回归问题,其基本思想也是通过找出跟新实例最近的 k 个邻居,然后根据这 k 个邻居的标签(在回归问题中我们通常称之为目标值)来预测新实例的目标值。由于我们需要预测的不是类别标签而是一个数值,所以通常会使用平均或加权平均的方式来处理 k 个邻居的目标值,从而获得对新实例目标值的预测。让我们回到上一课用月收入预测网购支出的那个例子,然后使用 scikit-learn 中的KNeighborsRegressor来构建回归模型,我们先做一些准备工作,代码如下所示。
# 每月收入incomes = np.array([ 9558, 8835, 9313, 14990, 5564, 11227, 11806, 10242, 11999, 11630, 6906, 13850, 7483, 8090, 9465, 9938, 11414, 3200, 10731, 19880, 15500, 10343, 11100, 10020, 7587, 6120, 5386, 12038, 13360, 10885, 17010, 9247, 13050, 6691, 7890, 9070, 16899, 8975, 8650, 9100, 10990, 9184, 4811, 14890, 11313, 12547, 8300, 12400, 9853, 12890])# 每月网购支出outcomes = np.array([ 3171, 2183, 3091, 5928, 182, 4373, 5297, 3788, 5282, 4166, 1674, 5045, 1617, 1707, 3096, 3407, 4674, 361, 3599, 6584, 6356, 3859, 4519, 3352, 1634, 1032, 1106, 4951, 5309, 3800, 5672, 2901, 5439, 1478, 1424, 2777, 5682, 2554, 2117, 2845, 3867, 2962, 882, 5435, 4174, 4948, 2376, 4987, 3329, 5002])X = np.sort(incomes).reshape(-1, 1) # 将收入排序后处理成二维数组y = outcomes[np.argsort(incomes)] # 将网购支出按照收入进行排序说明:即便只有一个特征,我们也需要将自变量处理二维数组的形式,因为我们训练模型时使用的
fit方法并不能接受一维数组作为它的第一个参数。这里提前对 X 和 y 排序是为了待会绘制散点图和折线图的时候根据 X 的值从小到大依次绘制。
接下来,我们创建 kNN 回归模型。
from sklearn.neighbors import KNeighborsRegressor
# 创建模型model = KNeighborsRegressor()# 训练模型model.fit(X, y)# 预测结果y_pred = model.predict(X)上面我们直接用所有的历史数据进行模型训练,然后通过绘制下面的图形来看看预测效果到底如何。
# 原始数据散点图plt.scatter(X, y, color='navy')# 预测结果折线图plt.plot(X, y_pred, color='coral')plt.show()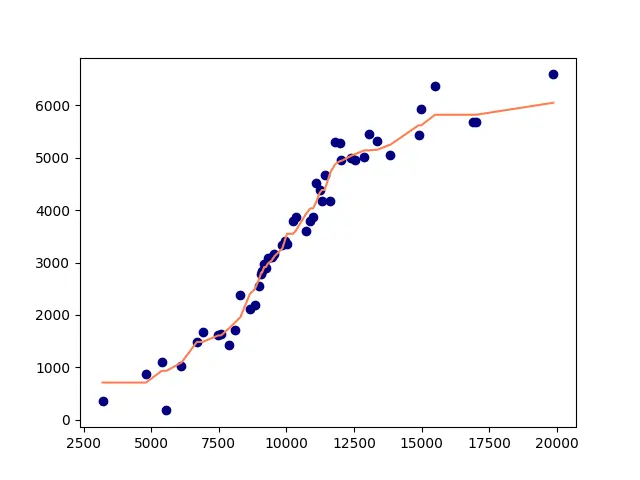
kNN 回归模型计算复杂度较高,而且对噪声数据非常敏感,在很多时候它可能并不是一个很好的选择。当然,如何评估一个回归模型的效果,这个问题我们留到后续的章节再为大家进行讲解。
总结
kNN 算法是一种简单但不失强大的机器学习算法,适用于小数据集上的分类和回归任务,它的优点是简单易懂,没有显示的训练过程,不依赖于对数据分布的假设,可以适应复杂的数据模式。当然,kNN 算法的缺点也非常明显,最大的问题在于计算效率,所以在数据集较大时可能并不是最好的选择。除此以外,kNN 算法对噪声非常敏感,同时预测结果依赖于 k 的取值和样本是否均衡(各个类别的样本数量是否大致相等),k 值过小可能导致过拟合,k值过大又可能导致欠拟合,而不均衡的样本可能会导致类别偏倚(Class Imbalance Bias),也就是说,如果大部分训练样本都属于类别 A,而类别 B 样本较少,那么在分类时,KNN 更容易将测试样本预测为类别 A。
83 决策树和随机森林
决策树(Decision Tree)是一种基于树结构的监督学习算法,可用于分类和回归任务。它通过将数据集逐步分割成不同的子集,直到满足某些停止条件,以此实现预测目标。我们生活中做决策的时候也会用到类似的方法,例如某位女生约见相亲对象的决策方法就可以绘制成如下所示的决策树。
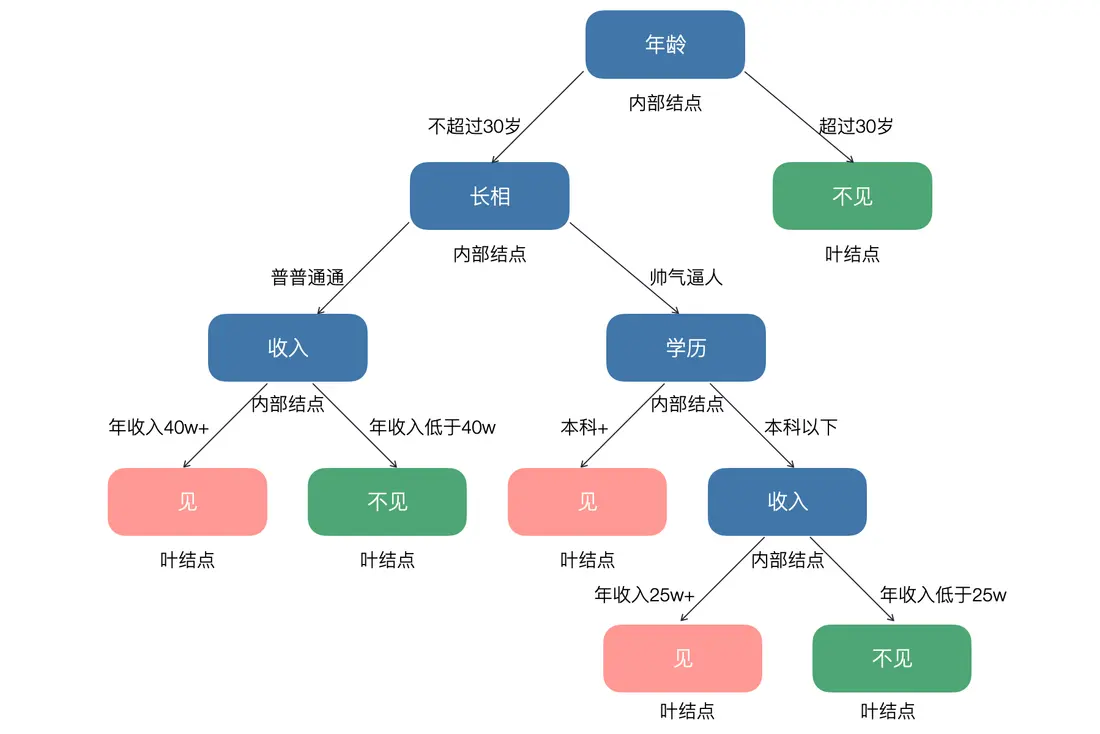
说明:上图仅用于帮助大家理解什么是决策树,无不良引导,也不代表本人的爱情观和婚姻观。
如果具备一定的编程常识,你会发现用决策树做预测的过程相当于是执行了一系列的if...else...结构;如果你对概率论的知识更熟悉,那么决策树的构建也可以视为计算以特征空间为前提的条件概率的过程。决策树中的结点可以分为两类:内部结点(上图中蓝色的结点)和叶结点(上图中红色和绿色的结点),其中内部结点对应样本特征属性测试(特征分割条件),而叶结点代表决策的结果(分类标签或回归目标值)。决策树可以用于解决分类问题和回归问题,本章我们仍然把重点放在分类问题上。
决策树的构建
特征选择
训练决策树模型有三个核心的步骤:特征选择、决策树构建和决策树剪枝。特征选择决定了使用哪些特征来做判断,在训练数据集中,每个样本的属性可能有很多个,不同属性的作用有大有小。特征选择的作用就是筛选出跟分类结果相关性较高的特征,也就是分类能力较强的特征,这样的特征要出现在决策树靠上的位置。如果一个特征能够使得分类后的分支结点尽可能属于同一类别,即该结点有着较高的纯度(purity),那么该特征对数据集而言就具备较强的分类能力。这里就产生了第一个问题,我们应该按照什么样的标准来选择分类能力强的特征?在决策树模型中,我们有三种方式来选择分类能力强的特征,分别是:信息增益(information gain)、信息增益比(gain ratio)和基尼指数(Gini index)。
要讲清楚信息增益,我们得先介绍信息熵(information entropy)这个概念。1948年,克劳德·香农(Claude Shannon)在他的著名论文《通信的数学原理》中提出了“信息熵”的概念,它解决了信息的度量问题,量化出了信息的价值。“熵”原本是热力学领域的概念,它反映的是系统的混乱程度,熵越大,系统的混乱程度就越高。在信息论中,熵可以看作随机变量(数据集)不确定性的度量,熵越大,变量(数据)的不确定性就越大,那么要确定它所需要获取的信息量也就越大;熵越低,数据的纯度就越高,不确定性就越小。
例如,甲、乙两人参加一个射击比赛,如果从历史成绩来看,甲的胜率是100%,那么我们很容易接受甲会获胜这个结果;如果从历史成绩来看,甲的胜率是50%,那么我们就难以确定到底谁会获胜。克劳德·香农提出可以用下面的公式来描述这种不确定性:
其中, 代表数据集, 代表类别的总数, 表示数据集中第 类样本的比例(概率)。我们用 和 来分别表示甲获胜和乙获胜,很显然,当 , 时, ,不确定性最大;当 , 时, ,不确定性最小;当 , 时, 。
很显然,知道的信息越多,随机变量(数据集)的不确定性就越小。这些信息,可以是直接针对我们想了解的随机事件的信息,也可以是和我们关心的随机事件相关的其他事件的信息。在数学上可以严格的证明这些相关的信息也能够降低或消除不确定性,为此我们定义条件熵,它表示在给定特征 的条件下,数据集 的不确定性。条件熵的公式如下所示:
上面的公式中,我们让 取得特征 所有可能的取值,其中 代表特征 取值为 的样本子集, 代表权重,即特征取值为 的样本比例。可以证明 ,也就是说多了特征 的信息之后,数据集 的不确定性下降了。当然,还要注意等号成立的情况,也就是说增加了特征 的信息,但是 的不确定没有下降,也就是说我们获取的信息与要研究的内容没有关系。
有了上面的铺垫,接下来我们就可以给出信息增益的定义,它是在得到特征 的信息后,数据集 的不确定性减少的程度。换句话说,信息增益是一种描述数据集确定性增加的量,特征的信息增益越大,特征的分类能力就越强,在给定该特征后数据集的确定性就越大。信息增益可以通过下面的数学公式直观的描述:
计算信息熵和信息增益的函数如下所示:
import numpy as np
def entropy(y): """ 计算信息熵 :param y: 数据集的目标值 :return: 信息熵 """ _, counts = np.unique(y, return_counts=True) prob = counts / y.size return -np.sum(prob * np.log2(prob))
def info_gain(x, y): """ 计算信息增益 :param x: 给定的特征 :param y: 数据集的目标值 :return: 信息增益 """ values, counts = np.unique(x, return_counts=True) new_entropy = 0 for i, value in enumerate(values): prob = counts[i] / x.size new_entropy += prob * entropy(y[x == value]) return entropy(y) - new_entropy经典决策树算法中的 ID3 算法就是基于信息增益进行特征选择的,我们仍然以鸢尾花数据集为例,将数据集拆分为训练集和测试集,在训练集上计算出原始的信息熵以及引入四个特征(花萼长度、花萼宽度、花瓣长度、花瓣宽度)后的信息增益分别是多少,代码如下所示。
from sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_split
iris = load_iris()X, y = iris.data, iris.targetX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)print(f'H(D) = {entropy(y_train)}')print(f'g(D,A0) = {info_gain(X_train[:, 0], y_train)}')print(f'g(D,A1) = {info_gain(X_train[:, 1], y_train)}')print(f'g(D,A2) = {info_gain(X_train[:, 2], y_train)}')print(f'g(D,A3) = {info_gain(X_train[:, 3], y_train)}')输出:
H(D) = 1.584962500721156g(D,A0) = 0.9430813063736728g(D,A1) = 0.5692093930591595g(D,A2) = 1.4475439590905472g(D,A3) = 1.4420095891994646注意:如果在划分训练集和测试集的时候,
train_test_split函数的random_state参数跟我上面的代码不同,那么这里的运算结果可能会存在差异。
根据上面的输出我们可以得知,花瓣长度(对应上面的A2)这个特征信息增益最高,也就是说使用花瓣长度这个特征分类能力最强,分类后的数据集纯度最高。需要注意的是,当某个特征取值较多时,该特征的信息增益计算结果就会比较大,所以使用信息增益选择特征时,会偏向于取值较多的特征。为了解决这个问题,我们可以计算信息增益比,它的定义如下所示:
其中, , 表示特征 的取值个数,简单的说 就是特征 的信息熵,而信息增益比就是特征 的信息增益和特征 的信息熵的比值。我们用下面的函数来计算信息增益比,调用该函数可以输出四个特征对应的信息增益比。
def info_gain_ratio(x, y): """ 计算信息增益比 :param x: 给定的特征 :param y: 数据集的目标值 :return: 信息增益比 """ return info_gain(x, y) / entropy(x)
print(f'R(D,A0) = {info_gain_ratio(X_train[:, 0], y_train)}')print(f'R(D,A1) = {info_gain_ratio(X_train[:, 1], y_train)}')print(f'R(D,A2) = {info_gain_ratio(X_train[:, 2], y_train)}')print(f'R(D,A3) = {info_gain_ratio(X_train[:, 3], y_train)}')输出:
R(D,A0) = 0.19687406476459068R(D,A1) = 0.14319788821311977R(D,A2) = 0.28837763858461984R(D,A3) = 0.35550822529855447注意:如果在划分训练集和测试集的时候,
train_test_split函数的random_state参数跟我上面的代码不同,那么这里的运算结果可能会存在差异。
根据上面的输出我们可以得知,花瓣宽度(对应上面的A3)这个特征信息增益比最高,也就是说这个特征能够完成一次良好的数据划分,可以作为我们构建决策树的根结点。当然,构建决策树不可能只做一次划分,我们可以在划分后的数据集上继续计算信息增益比来选择新的划分特征,重复这一过程直到满足一定的条件就可以构造出一棵完整的决策树模型。在经典决策树算法中,C4.5 算法就是基于信息增益比进行特征选择的。
除了上面讲到的信息增益和信息增益比,基尼指数也是非常好的特征选择方法,它可以用于评价数据集的纯度。基尼指数也叫基尼不纯度(Gini impurity),它的取值在0到1之间,数据集纯度越高,基尼指数越靠近0,数据集纯度越低,基尼指数越靠近1。如果数据集有 个类别,样本属于第 个类别的概率为 ,那么数据集的基尼指数可以通过下面的公式进行计算:
例如鸢尾花数据集中,三种鸢尾花的样本数量都是50条,那么整个数据集的基尼指数为:
如果三种鸢尾花的样本数量分别为100条、25条、25条,那么整个数据集的基尼指数为:
如果三种鸢尾花的样本数量分别为140条、5条、5条,那么整个数据集的基尼指数为:
可以看出,随着数据集纯度越来越高,基尼指数的值越来越小。如果数据集 根据特征 划分为 个部分,那么在给定特征 的前提条件下,数据集的基尼指数可以定义为:
根据上面的公式,我们可以设计出如下所示的计算基尼指数的函数,大家可以对照上面的公式看看是否能够理解下面的代码,或者通过调用下面的函数看看鸢尾花数据集的哪个特征可以对原始数据集或者训练集做出最好的划分。经典决策树算法中的 CART 算法就是基于基尼指数进行特征选择的。
def gini_index(y): """ 计算基尼指数 :param y: 数据集的目标值 :return: 基尼指数 """ _, counts = np.unique(y, return_counts=True) return 1 - np.sum((counts / y.size) ** 2)
def gini_with_feature(x, y): """ 计算给定特征后的基尼指数 :param x: 给定的特征 :param y: 数据集的目标值 :return: 给定特征后的基尼指数 """ values, counts = np.unique(x, return_counts=True) gini = 0 for value in values: prob = x[x == value].size / x.size gini += prob * gini_index(y[x == value]) return gini
print(f'G(D) = {gini_index(y_train)}')print(f'G(D,A0) = {gini_with_feature(X_train[:, 0], y_train)}')print(f'G(D,A1) = {gini_with_feature(X_train[:, 1], y_train)}')print(f'G(D,A2) = {gini_with_feature(X_train[:, 2], y_train)}')print(f'G(D,A3) = {gini_with_feature(X_train[:, 3], y_train)}')输出:
G(D,A0) = 0.29187830687830685G(D,A1) = 0.44222582972582963G(D,A2) = 0.06081349206349207G(D,A3) = 0.06249999999999998数据分裂
构建决策树的过程是一个递归的过程,通过上面介绍的方法选定特征后就要进行数据分裂,简单的说就是根据该特征将数据集分成两个或多个子集(两个子集对应二叉树,多个子集对应多叉树),每个子集对应于特征的不同取值。接下来,我们对每个子集重复特征选择和数据分裂的动作,直到满足停止条件。停止条件对于递归过程非常重要,同时可以避免生成过于复杂的树结构。常见的停止条件包括:
- 树达到预设的深度。
- 当前结点的样本数量少于预设的阈值。
- 结点上所有样本属于同一个类别。
- 信息增益或Gini指数的变动低于某个阈值。
说明:如果大家有编写树结构的经验,上面的过程应该很容易理解。当然,对递归(recursion)、二叉树(binary tree)、多叉树(multi-way tree)不熟悉的小伙伴也可以随便找本讲数据结构的书来看看,相关的知识并不复杂,我们这里就不进行赘述了。
在数据分裂的过程中,还有一个值得关注的问题就是特征连续值和缺失值的处理。对于连续值,可以通过遍历特征所有可能的取值,找到切分点 让切分后的子集在信息增益比或基尼指数方面达到最优,在数据分裂时以 将数据划分为 和 两个子集,其中 包含特征值小于等于 的样本, 包含特征值大于 的样本。对于缺失值,C4.5 算法采用了加权分配的方式进行处理,当选择一个特征进行分裂时,该特征存在缺失值的样本会被分配到每个子集,但是不同的子集中该样本被赋予的权重是不一样的,这个权重会根据该特征在各个类别中的比例进行计算。CART 算法在处理缺失值时,通常会为每个特征创建一个默认分支。对于存在缺失值的样本,CART 算法会将它们引导到默认分支进行处理,在计算基尼指数时,CART 算法可以选择是否将缺失值的样本纳入计算。
树的剪枝
对于一棵较为复杂的决策树进行剪枝是很有必要的,剪枝可以减少树结构的复杂性,同时也避免了过拟合的风险。常用的剪枝策略包括:
- 后剪枝(post-pruning)。后剪枝顾名思义是在决策树构建完成后,通过评估和移除一些不必要的分支来简化树结构。后剪枝的过程通常从叶结点开始,至底向上评估每个结点,看看将其替换为叶结点(将该结点及其子树剪掉)是否能提高模型的性能(在验证集上的预测效果)。这种方式在减少过拟合风险的同时,还能够较好的保留对数据的拟合能力,但是计算量较大,而且如果没有合适的验证集,剪枝效果就会受到影响。
- 预剪枝(pre-pruning)。预剪枝顾名思义是在构建决策树的过程中动态决定是否停止分裂某个结点。通过在分裂前评估当前结点是否应该继续分裂,可以避免生成过于复杂的树,上面我们提到了几种常用的停止条件。预剪枝策略在决策树构建阶段就减少了不必要的分裂,从而降低了模型的复杂性,但是可能存在欠拟合的风险,因为过早停止分裂可能会遗漏潜在的重要决策规则。
实现决策树模型
我们可以使用 scikit-learn 中tree模块的DecisionTreeClassifier和DecisionTreeRegressor来实现用于分类和回归的决策树,这里我们重点讨论用于解决分类问题的决策树模型,有兴趣的读者可以自行研究用于解决回归问题的决策树模型。
from sklearn.tree import DecisionTreeClassifier
# 创建模型model = DecisionTreeClassifier()# 训练模型model.fit(X_train, y_train)# 预测结果y_pred = model.predict(X_test)下面,我们对比一下预测值和真实值并看看模型的评估报告。
from sklearn.metrics import classification_report
print(y_test)print(y_pred)print(classification_report(y_test, y_pred))输出:
[0 0 0 0 0 2 1 0 2 1 1 0 1 1 2 0 1 2 2 0 2 2 2 1 0 2 2 1 1 1][0 0 0 0 0 2 1 0 2 1 1 0 1 1 2 0 1 2 2 0 2 2 2 1 0 2 2 1 2 1] precision recall f1-score support
0 1.00 1.00 1.00 10 1 1.00 0.90 0.95 10 2 0.91 1.00 0.95 10
accuracy 0.97 30 macro avg 0.97 0.97 0.97 30weighted avg 0.97 0.97 0.97 30说明:大家运行上面的代码看到的输出可能跟我这里并不相同,因为在创建
DecisionTreeClassifier时有一个控制随机性的参数random_state,如果为该参数提供一个确定的整数值,就可以确保你的运行结果是可重复的。
我们可以通过下面的代码来可视化决策树,相信可视化的方式会帮助大家对决策树模型有一个更好的理解。
import matplotlib.pyplot as pltfrom sklearn.tree import plot_tree
plt.figure(figsize=(12, 10))plot_tree( decision_tree=model, # 决策树模型 feature_names=iris.feature_names, # 特征的名称 class_names=iris.target_names, # 标签的名称 filled=True # 用颜色填充)plt.show()输出:
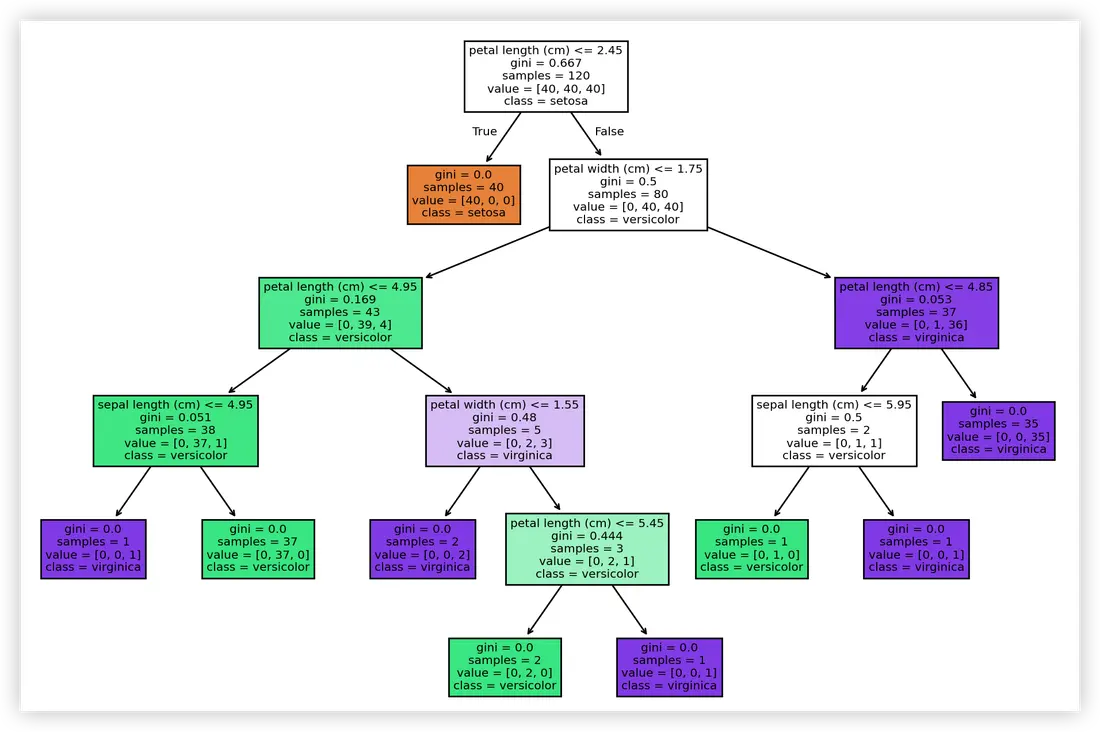
注意:上图中树的根结点的基尼指数跟我们之前计算的数据集的基尼指数完全一致。
我们调整一下DecisionTreeClassifier的参数重新创建决策树并对模型进行可视化。
# 创建模型model = DecisionTreeClassifier( criterion='entropy', ccp_alpha=0.01,
)# 训练模型model.fit(X_train, y_train)# 可视化plt.figure(figsize=(12, 10))plot_tree( decision_tree=model, # 决策树模型 feature_names=iris.feature_names, # 特征的名称 class_names=iris.target_names, # 标签的名称 filled=True # 用颜色填充)plt.show()输出:
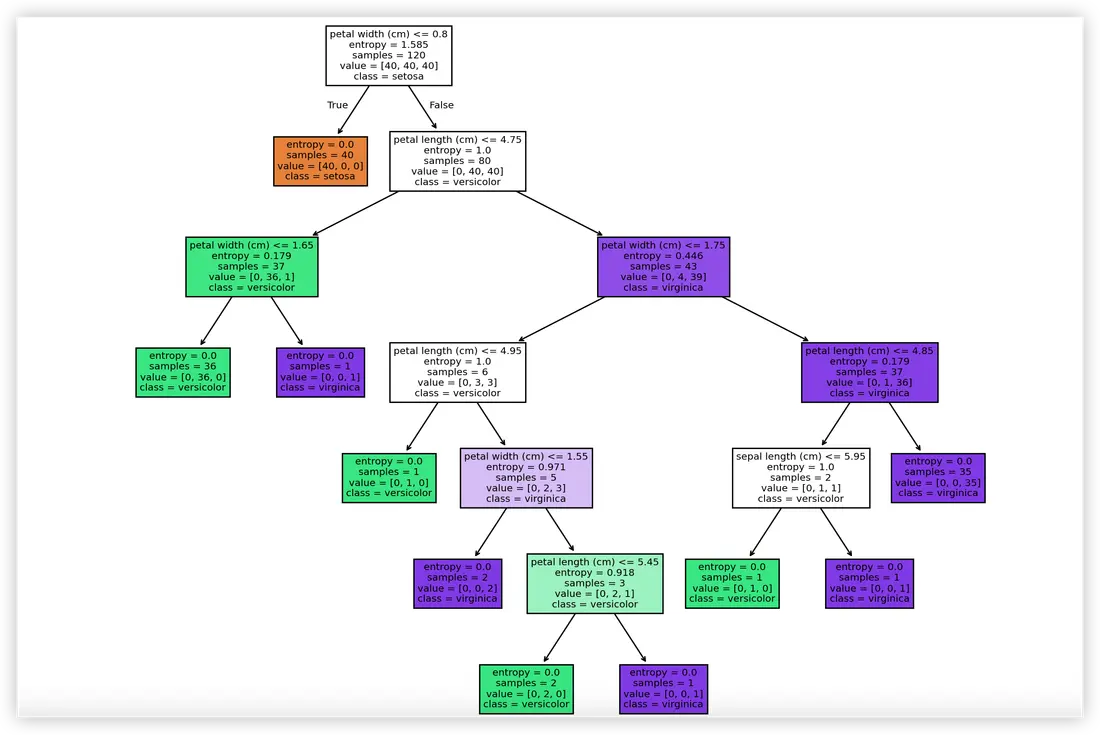
注意:上图中树的根结点的信息熵跟我们之前计算的数据集的信息熵完全一致。
由此可见,创建DecisionTreeClassifier对象时参数不同,生成的决策树也会存在差异。DecisionTreeClassifier构造函数的参数就是决策树模型的超参数,其中有几个非常重要的超参数:
criterion:特征选择(数据分裂质量评估)的标准,可以选择'gini'或'entropy',前者代表基尼指数,也是默认值,后者代表信息增益。max_depth:树的最大深度,默认值为None,如果不设置该参数,会存在过拟合风险。min_samples_split:一个内部结点再次分裂所需的最小样本数,默认值为2。这个参数可以设置为整数表示最小样本数,也可以设置为浮点数,表示占总样本数的比例。min_samples_leaf:叶结点所需的最小样本数,默认值为1。将该参数设置为较大的值可以平滑模型,降低过拟合风险。这个参数也可以设置为整数或浮点数,道理同上。max_features:用于最佳分裂的特征数,默认值为None。这个参数可以设置为整数,表示选择固定数量的特征;可以设置为浮点数,表示选择特征的比例;可以设置为字符串,'auto'和'sqrt'表示将总的特征数量求平方根,用平方根的值作为选择特征的数量,'log2'表示将总的特征数量求对数,用对数值作为选择特征的数量。class_weight:指定类别的权重,用于处理类别不平衡问题,默认值为None。可以用字典的方式手动设置每个类别的权重,也可以使用'balanced'让模型自动调整。splitter:选择分裂结点的策略,默认值为'best',表示最佳分裂,还有一个取值是'random',表示随机分裂。max_leaf_nodes:限制叶结点的最大数量,可以防止树结构过于复杂。min_impurity_decrease:结点分裂所需的最小不纯度降低值,任何结点只有在不纯度减少超过此值时才会进行分裂。ccp_alpha:成本复杂度剪枝中的参数值。这个参数用于控制后剪枝中成本复杂度计算公式中的值。较小的值允许更复杂的树,而较大的值倾向于选择更简单的树。通过调整,可以找到一个最佳的复杂度和误差之间的平衡点。
我们可以通过之前讲到的网格搜索和交叉验证的方式来对超参数进行调优,有兴趣的读者可以参考下面的代码。
from sklearn.model_selection import GridSearchCV
gs = GridSearchCV( estimator=DecisionTreeClassifier(), param_grid={ 'criterion': ['gini', 'entropy'], 'max_depth': np.arange(5, 10), 'max_features': [None, 'sqrt', 'log2'], 'min_samples_leaf': np.arange(1, 11), 'max_leaf_nodes': np.arange(5, 15) }, cv=5)gs.fit(X_train, y_train)随机森林概述
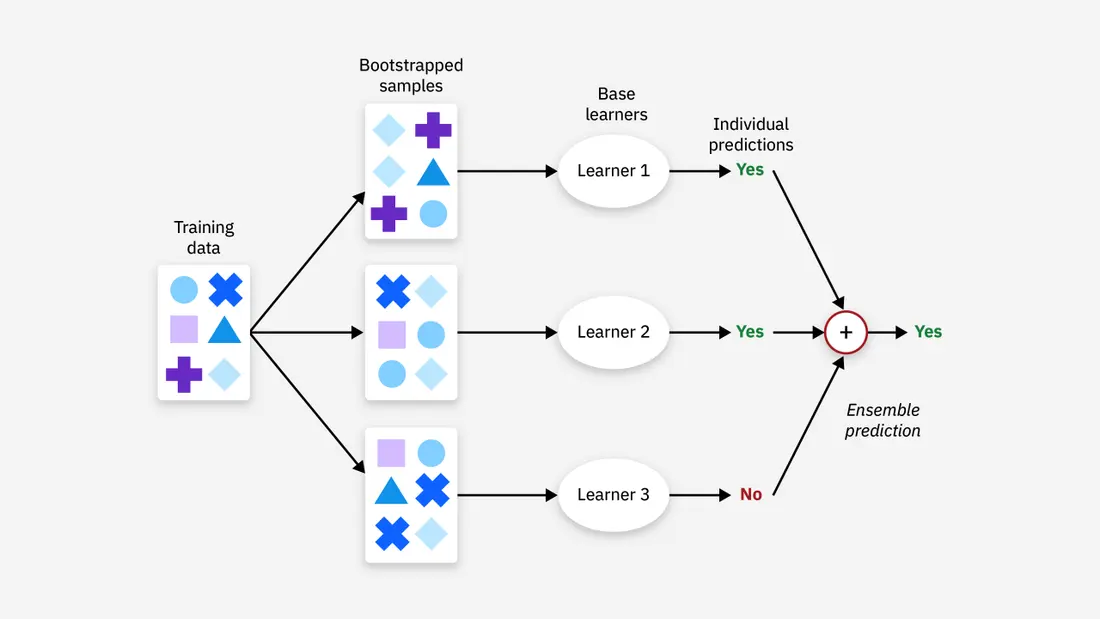
随机森林是基于决策树的集成学习算法,所谓集成学习就是通过组合多个模型的预测结果来提高整体模型的性能,其核心思想就是多个模型的组合往往比单个模型更有效,通过不同的模型捕捉到数据的不同特征,从而降低模型的过拟合风险(提升模型的泛化能力)。随机森林通过构建多个决策树并将它们的预测结果进行投票(分类)或平均(回归),来提高模型的准确性和鲁棒性,如下图所示。
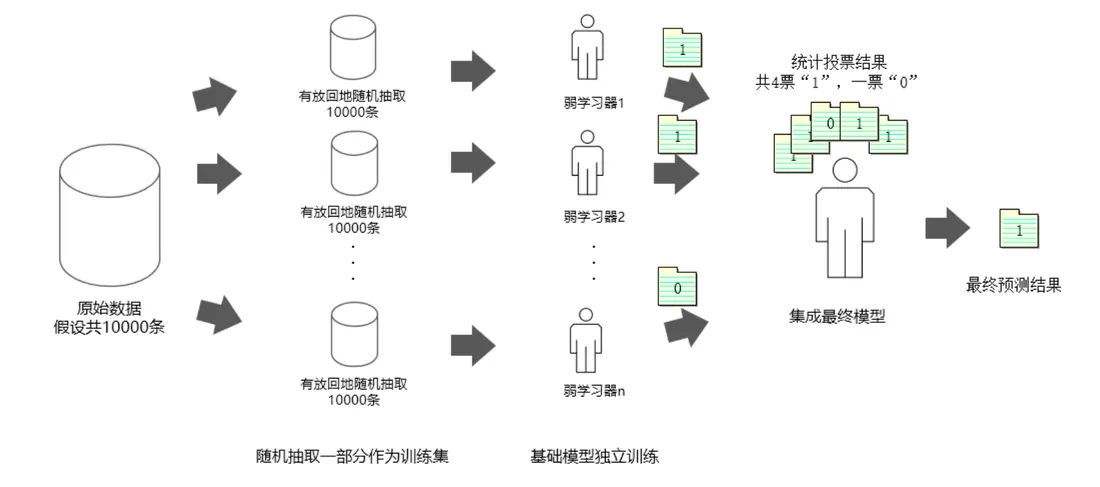
随机森林的基本工作流程如下:
- Bootstrap 抽样:从原始训练数据集中随机抽取若干个样本(有放回抽样),形成多个不同的子集,每个子集用于训练一棵决策树。
- 构建决策树:对于每棵树在进行结点分裂时,不必考虑所有特征,而是随机选择一部分特征实现数据分裂。通过这种方式,随机森林增加了模型的多样性,减少了树之间的相关性。
- 集成学习:对于分类任务,随机森林通过投票的方式(即多数表决)来决定最终分类的结果;对于回归任务,通常可以对每棵树的预测结果求均值作为最终的预测结果。
随机森林的主要优点体现在:
- 通过集成多个决策树,能够有效提高模型的准确性。
- 由于引入了随机性,随机森林通常比单棵决策树更不容易过拟合。
- 随机森林可以提供特征的重要性评分,帮助理解模型。
- 能够处理大规模数据集和高维数据。
当然,因为要构建多个决策树,随机森林模型通常比较复杂,在训练模型时对计算资源、内存资源和时间成本的消耗都是更大的。我们可以通过 scikit-learn 库ensemble模块的RandomForestClassifier类来构造随机森林模型,这里我们仍然使用网格搜索交叉验证的方式来对超参数进行调优,代码如下所示。
from sklearn.ensemble import RandomForestClassifier
gs = GridSearchCV( estimator=RandomForestClassifier(n_jobs=-1), param_grid={ 'n_estimators': [50, 100, 150], 'criterion': ['gini', 'entropy'], 'max_depth': np.arange(5, 10), 'max_features': ['sqrt', 'log2'], 'min_samples_leaf': np.arange(1, 11), 'max_leaf_nodes': np.arange(5, 15) }, cv=5)gs.fit(X_train, y_train)提示:上面的代码可能会运行非常长的时间。
随机森林模型的超参数很多跟决策树类似,需要说明的有以下几个超参数:
estimator:森林中树的数量,简单的说就是用多少个决策树来构造森林。更多的树通常会带来更好的预测效果,但也会增加计算成本。boostrap:是否使用 Bootstrap 抽样,默认值为True,表示在构建每棵树时使用有放回抽样。n_jobs:用于并行运行的任务数,默认值为None,表示使用单个处理器核心;设置为-1,则可以使用所有可用的处理器核心。
总结
决策树是简单有效且易于理解的预测模型,适用于分类和回归任务,但容易发生过拟合且对噪声数据敏感;随机森林通过集成多个决策树提高了泛化能力且对噪声数据不敏感,适合解决复杂问题。在解决实际问题时,可以根据具体场景选择合适的模型,通过调节相关超参数来获得最佳效果,二者的对比如下表所示:
| 属性 | 决策树 | 随机森林 |
|---|---|---|
| 模型复杂度 | 简单 | 较复杂 |
| 抗过拟合能力 | 差 | 强 |
| 计算效率 | 高 | 较低 |
| 结果稳定性 | 易受单一数据变化影响 | 稳定 |
| 适用场景 | 数据较少、简单问题 | 数据较多、复杂问题 |
84 朴素贝叶斯算法
我们继续为大家介绍解决分类任务的算法,本章介绍一种概率模型贝叶斯分类器。贝叶斯分类器是一类分类算法的总称,这类算法均以贝叶斯定理为基础,因而统称为贝叶斯分类器。在介绍贝叶斯定理之前,我们先讲一个故事:从 2015 年到 2020 年期间,某位李姓女士凭借自己对航班是否会延误的分析,购买了大约 900 次飞机延误险并获得延误赔偿,累计获得理赔金高达 300 多万元,真可谓“航班延误,发家致富”。当然,这套骚操作本身不是我们探讨的重点,我们的问题是:李女士是怎么决定要不要购买延误险的呢?航班延误最主要的原因就是天气(包括起飞地和降落地的天气)、机场(起飞机场和降落机场)和航司,由于李女士有过航空服务类工作的经历,有获得机场和航司相关数据的途径(天气数据相对更容易获取),集齐相关的数据再利用贝叶斯定理,她可以能够计算出当前航班延误的概率并决定是否购买延误险。接下来,李女士通过虚构不同身份购票并大量投保(每个身份购买 30 到 40 份延误险),这样一旦航班延误,她就可以向保险公司进行索赔。那么,我们要探讨的就是贝叶斯定理是如何利用现有数据计算出航班延误的概率。
贝叶斯定理
贝叶斯定理是概率论中的一个重要定理,它描述了如何从主观经验或已知事实出发,通过收集到的样本数据(证据)来更新对事件发生概率的认知(信念)。贝叶斯定理的数学表达式为:
其中, 是事件 发生的先验概率,我们可以理解为已知事实或主观经验(主观概率); 是在事件 发生的条件下事件 发生的 条件概率,通常也称之为似然性(likelihood), 是事件 发生的(全)概率,这两个概率可以通过我们收集到的样本数据(证据)获得; 是在事件 发生的条件下事件 发生的条件概率,即收集到样本数据后对事件 发生概率的重新认知,称之为后验概率。贝叶斯定理告诉我们一个重要的事实:可以从已知的事实或主观经验出发,通过收集到的证据来更新我们对某个事件发生概率的认知,简单的说就是可以通过已知的事实和收集的证据来推断出未知的真相。
回到上面李女士购买飞机延误险的例子,假设本次航班是从成都双流国际机场飞往北京首都国际机场,执飞的航空公司是四川航空,起飞地天气为雨天(小雨),温度为8°C,东北风2级,降落地天气为晴天,温度4°C,西北风2级。为了更简单的让大家理解贝叶斯定理,我们对这里的条件稍作简化,只保留天气中的降水信息,暂不考虑温度和风速等其他因素,对应到上面的贝叶斯定理有:
上面公式等号左边就是李女士想知道的当前航班延误的概率,等号右边的部分其实就是历史数据和当前信息,计算这个概率的关键在于计算出似然性,即 到底是多少,那么这个条件概率又该如何计算呢?
朴素贝叶斯
朴素贝叶斯算法是基于贝叶斯定理和特征条件独立性假设的分类算法,因其简单高效而受到广泛应用。朴素贝叶斯算法的关键在于“朴素”二字,就是刚才我们说到特征条件独立性假设,条件独立性假设是说用于分类的特征在类确定的条件下都是独立的,该假设使得朴素贝叶斯的学习成为可能。
假设我们有一个特征集合 和一个类别 ,朴素贝叶斯算法假设:
这个假设大大简化了计算复杂性,使得我们可以只计算每个特征在给定类别下的概率,而不需要考虑特征之间的相互作用,对应到上面购买飞机延误险的例子,我们可以用下面的方式来计算似然性:
算法原理
训练阶段
在训练阶段,朴素贝叶斯算法首先需要计算每个类别的先验概率和每个特征在各个类别下的条件概率。
- 计算先验概率:
其中, 表示类别, 是类别 的样本数量, 是总的样本容量。
- 计算条件概率:
其中, 是在类别 中,特征 出现的次数。
预测阶段
在预测阶段,给定一个待分类样本 ,朴素贝叶斯算法通过以下步骤来计算其属于每个类别的后验概率:
上面的公式中, 对应到每个类别都是一个常量,可以忽略掉它,再结合独立性假设有:
这样,我们可以选择具有最高后验概率的类别作为预测结果。
代码实现
我们还是以鸢尾花数据集为例,按照上面的讲解的原理,用 NumPy 来实现一个朴素贝叶斯分类器,我们还是从加载数据开始,代码如下所示。
from sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_split
iris = load_iris()X, y = iris.data, iris.targetX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)训练阶段我们要获得类别标签和对应的先验概率,此外还要计算出似然性,似然性的计算用到了上面提到的“朴素”假设,我们对鸢尾花连续的特征值进行了简单的离散化处理(大家先不考虑这种处理方式是否合理),代码如下所示。
import numpy as npimport pandas as pd
def naive_bayes_fit(X, y): """ :param X: 样本特征 :param Y: 样本标签 :returns: 二元组 - (先验概率, 似然性) """ # 计算先验概率 clazz_labels, clazz_counts = np.unique(y, return_counts=True) prior_probs = pd.Series({k: v / y.size for k, v in zip(clazz_labels, clazz_counts)}) # 拷贝数组创建副本 X = np.copy(X) # 保存似然性计算结果的字典 likelihoods = {} for j in range(X.shape[1]): # 对特征的循环 # 对特征进行等宽分箱(离散化处理) X[:, j] = pd.cut(X[:, j], bins=5, labels=np.arange(1, 6)) for i in prior_probs.index: # 按标签类别拆分数据并统计每个特征值出现的频次 x_prime = X[y == i, j] x_values, x_counts = np.unique(x_prime, return_counts=True) for k, value in enumerate(x_values): # 对不同特征值的循环 # 计算似然性并保存在字典中(字典的键是一个三元组 - (标签, 特征序号, 特征值)) likelihoods[(i, j, value)] = x_counts[k] / x_prime.size return prior_probs, likelihoods调用上面的函数,我们可以得到一个二元组,解包之后分别是类别标签 对应的先验概率和在类别 中,第 个特征取到某个值value(上面的代码中,我们用 pandas 的cut函数对特征值分箱,value的取值为1 到5)的似然性,前者是一个Series对象,后者是一个dict对象,如下所示:
p_ci, p_x_ci = naive_bayes_fit(X_train, y_train)print('先验概率: ', p_ci, sep='\n')print('似然性: ', p_x_ci, sep='\n')输出:
先验概率:0 0.3333331 0.3333332 0.333333dtype: float64似然性:{(0, 0, 1.0): 0.525, (0, 0, 2.0): 0.45, (0, 0, 3.0): 0.025, (1, 0, 1.0): 0.05, (1, 0, 2.0): 0.375, (1, 0, 3.0): 0.425, (1, 0, 4.0): 0.15, (2, 0, 1.0): 0.025, (2, 0, 2.0): 0.025, (2, 0, 3.0): 0.45, (2, 0, 4.0): 0.3, (2, 0, 5.0): 0.2, (0, 1, 1.0): 0.025, (0, 1, 3.0): 0.325, (0, 1, 4.0): 0.45, (0, 1, 5.0): 0.2, (1, 1, 1.0): 0.175, (1, 1, 2.0): 0.325, (1, 1, 3.0): 0.475, (1, 1, 4.0): 0.025, (2, 1, 1.0): 0.025, (2, 1, 2.0): 0.35, (2, 1, 3.0): 0.525, (2, 1, 4.0): 0.05, (2, 1, 5.0): 0.05, (0, 2, 1.0): 1.0, (1, 2, 2.0): 0.025, (1, 2, 3.0): 0.525, (1, 2, 4.0): 0.45, (2, 2, 4.0): 0.525, (2, 2, 5.0): 0.475, (0, 3, 1.0): 0.975, (0, 3, 2.0): 0.025, (1, 3, 2.0): 0.125, (1, 3, 3.0): 0.75, (1, 3, 4.0): 0.125, (2, 3, 3.0): 0.05, (2, 3, 4.0): 0.525, (2, 3, 5.0): 0.425}说明:字典中的第一个元素
(0, 0, 1.0): 0.525表示标签为0,第0个特征(花萼长度)取值为1.0的似然性为0.525;最后一个元素(2, 3, 5.0): 0.425表示标签为2,第3个特征(花瓣宽度)取值为5.0的似然性为0.425。
预测阶段我们利用上面函数得到的先验概率和似然性计算后验概率,然后根据后验概率的最大值为样本赋予预测的类别标签。
def naive_bayes_predict(X, p_ci, p_x_ci): """ 朴素贝叶斯分类器预测 :param X: 样本特征 :param p_ci: 先验概率 :param p_x_ci: 似然性 :return: 预测的标签 """ # 对特征进行等宽分箱(离散化处理) X = np.copy(X) for j in range(X.shape[1]): X[:, j] = pd.cut(X[:, j], bins=5, labels=np.arange(1, 6)) # 保存每个样本对应每个类别后验概率的二维数组 results = np.zeros((X.shape[0], p_ci.size)) clazz_labels = p_ci.index.values for k in range(X.shape[0]): for i, label in enumerate(clazz_labels): # 获得先验概率(训练的结果) prob = p_ci.loc[label] # 计算获得特征数据后的后验概率 for j in range(X.shape[1]): # 如果没有对应的似然性就取值为0 prob *= p_x_ci.get((i, j, X[k, j]), 0) results[k, i] = prob # 根据每个样本对应类别最大的概率选择预测标签 return clazz_labels[results.argmax(axis=1)]将上面的函数作用于测试集进行预测,比较预测值和真实值,如下所示。
y_pred = naive_bayes_predict(X_test, p_ci, p_x_ci)y_pred == y_test输出:
array([ True, True, True, True, True, True, True, True, True, True, True, True, True, True, True, True, True, True, False, True, True, True, True, True, True, True, False, True, True, True])上面两个函数希望能帮助大家理解朴素贝叶斯的工作原理,实际工作中我们还是推荐大家使用 scikit-learn 库的navie_bayes模块封装的类来创建朴素贝叶斯模型,该模块下有五个朴素贝叶斯算法的变体,每种变体针对不同类型的数据和特征分布,对应的五种朴素贝叶斯分类器分别是:BernoulliNB、CategoricalNB、ComplementNB、GaussianNB和MultinomialNB,它们之间的差别如下表所示:
| 分类器 | 特征类型 | 主要假设 |
|---|---|---|
BernoulliNB | 二元特征 | 特征服从 Bernoulli 分布 |
CategoricalNB | 类别特征 | 特征服从多项式分布,常用于处理类别数据 |
ComplementNB | 计数特征 | 利用补集概率,常用于处理不平衡数据集 |
GaussianNB | 连续特征 | 特征服从高斯分布 |
MultinomialNB | 计数特征 | 特征服从多项式分布,常用于文本分类 |
对于鸢尾花数据集,由于其特征是连续值,我们可以用GaussianNB来创建模型,代码如下所示。
from sklearn.naive_bayes import GaussianNB
model = GaussianNB()model.fit(X_train, y_train)y_pred = model.predict(X_test)我们看看模型评估的结果。
from sklearn.metrics import classification_report
print(classification_report(y_test, y_pred))输出:
precision recall f1-score support
0 1.00 1.00 1.00 10 1 0.91 1.00 0.95 10 2 1.00 0.90 0.95 10
accuracy 0.97 30 macro avg 0.97 0.97 0.97 30weighted avg 0.97 0.97 0.97 30如果想看看朴素贝叶斯模型给每个样本对应到每个标签给出的概率值,可以使用下面的代码。
model.predict_proba(X_test).round(2)输出:
array([[1. , 0. , 0. ], [1. , 0. , 0. ], [1. , 0. , 0. ], [1. , 0. , 0. ], [1. , 0. , 0. ], [0. , 0. , 1. ], [0. , 1. , 0. ], [1. , 0. , 0. ], [0. , 0. , 1. ], [0. , 0.98, 0.02], [0. , 1. , 0. ], [1. , 0. , 0. ], [0. , 1. , 0. ], [0. , 1. , 0. ], [0. , 0. , 1. ], [1. , 0. , 0. ], [0. , 0.93, 0.07], [0. , 0. , 1. ], [0. , 0.02, 0.98], [1. , 0. , 0. ], [0. , 0.22, 0.78], [0. , 0. , 1. ], [0. , 0. , 1. ], [0. , 0.92, 0.08], [1. , 0. , 0. ], [0. , 0. , 1. ], [0. , 0.54, 0.46], [0. , 1. , 0. ], [0. , 1. , 0. ], [0. , 0.81, 0.19]])算法优缺点
朴素贝叶斯算法的优缺包括:
- 逻辑简单容易实现,适合大规模数据集。
- 运算开销较小。预测需要用到的概率在训练阶段都已经准好了,当新数据来了之后,只需要获取对应的概率值并进行简单的运算就能获得预测的结果。
- 受噪声和无关属性影响小。
当然,由于做了“特征相互独立”这个假设,朴素贝叶斯算法的缺点也相当明显,因为在实际应用中,特征之间很难做到完全独立,尤其是维度很高的数据,如果特征之间的相关性较大,那么分类的效果就会变得很差。为了解决这个问题,在朴素贝叶斯算法的基础上又衍生出了一些新的方法,包括:半朴素贝叶斯(One Dependent Estimator)、AODE(Averaged One Dependent Estimator)、K 依赖朴素贝叶斯、朴素贝叶斯网络、高斯混合朴素贝叶斯等,有兴趣的读者可以自行了解。
总结
朴素贝叶斯算法在多个领域有广泛应用,以下是一些常见的应用场景:
- 文本分类:如垃圾邮件检测、情感分析等。
- 推荐系统:根据用户行为和喜好进行个性化推荐。
- 医药诊断:根据症状预测疾病。
85 回归模型
回归模型是机器学习和统计学中的一种基本模型,用于预测连续型输出变量。简单的说,给定一组输入变量(自变量)和对应的输出变量(因变量),回归模型旨在找到输入变量和输出变量之间的映射关系。回归模型的形式可能比较简单,但它确包含了机器学习中最主要的建模思想。通常,我们建立回归模型主要有两个目标:
- 描述数据之间的关系。我们之前讲过机器学习的关键就是要通过历史数据掌握如何从特征映射到目标值,这个过程不需要我们事先设置任何的规则,而是让机器通过对历史数据的学习来获得。回归模型可以帮助我们通过模型表达输入和输出之间的关系。
- 对未知数据做出预测。通过学习到的映射关系,模型可以对新的输入数据进行预测。
回归模型的应用非常广泛,我们为大家举几个具体的例子:
- 零售行业。全球最大的电商平台亚马逊(Amazon)会根据历史销量、商品属性(价格、折扣、品牌、类别等)、时间特征(季节、工作日、节假日等)、外部因素(天气、社媒等)等特征创建回归模型预测未来一段时间内不同商品的需求量。在促销活动期间,会使用多元回归结合交互项来分析促销对销量的影响。
- 汽车行业。为了优化电池的充电策略,延长电池的使用寿命,为电车用户提供更准确的电量预警,特斯拉(Tesla)使用回归模型,通过电池充放电次数、环境温度、放电深度、电池物理参数等建立回归模型,预测电池的剩余寿命。
- 房地产行业。美国最大的在线房地产平台 Zillow 曾经使用回归模型帮助用户评估房屋的价值,通过房屋的面积、房龄、地理位置、房屋类型、社区安全等级、学校评分等对房屋的市场价格做出预测。
回归模型的分类
根据模型的复杂程度和假设,回归模型可以分为以下几类:
- 线性回归(Linear Regression):假设输入变量和输出变量之间是线性关系。
一元线性回归:建立一个因变量与单个自变量之间线性关系的模型。
其中, 是目标变量(因变量), 是输入变量(自变量), 是截距,表示 时的预测值, 是回归系数(斜率),表示输入变量对输出变量影响的大小, 是误差项,用于表示数据中的随机噪声或无法解释的部分。
多元线性回归:建立一个因变量与多个自变量之间线性关系的模型。
上面的公式也可以用向量的形式简化表示为:
其中, 是包含截距的输入向量, 是模型参数(包括截距 和回归系数 ), 是误差项。
- 多项式回归(Polynomial Regression):引入高阶特征,使模型能拟合更复杂的非线性关系,属于线性模型的扩展,因为因为它对参数 的求解仍然是线性形式,如下面所示的二次关系:
-
非线性回归(Nonlinear Regression):非线性回归完全放弃了线性假设,模型形式可以是任意非线性函数。
-
岭回归(Ridge Regression)、套索回归(Lasso Regression)、弹性网络回归(Elastic Net Regression):在线性回归基础上加入正则化项,用于处理过拟合、多重共线性和特征筛选问题。
-
逻辑回归(Logistic Regression):逻辑回归虽然名字中带“回归”,但实际上是用于分类问题的模型。它通过 Sigmoid 函数将线性组合的输入值映射到区间 ,表示分类概率,适用于二分类问题;也可以扩展为 Softmax 回归,解决多分类问题。
回归系数的计算
建立回归模型的关键是找到最佳的回归系数 ,所谓最佳回归系数是指让模型对数据的拟合效果达到最好的模型参数,即能够最小化模型的预测值 与实际观测值 之间差异的模型参数。为此,我们先定义如下所示的损失函数。
其中, 表示样本容量,代入回归模型,有:
如果用矩阵形式表示,有:
其中, 是目标值的向量,大小为 , 是特征矩阵,大小为 , 是回归系数的向量,大小为 。
通过最小化损失函数 ,我们可以得到线性回归模型的解析解。对 求导并令其为 0,有:
整理后得到:
对于矩阵 不满秩的情况,可以通过添加正则化项的方式使得矩阵可逆,如下所示,这个就是线性回归的解析解。
说明:如果你对这里提到的正则化不理解可以先放放,后面我们再来讨论这个问题。
上述方法适用于小规模数据集,当数据体量不大(样本和特征数量较少)时,计算效率是没有问题的。对于大规模数据集或更为复杂的优化问题,我们可以使用梯度下降法,通过迭代更新参数来逐步逼近最优解。梯度下降法的目标也是最小化损失函数,该方法通过计算梯度方向进行参数更新。梯度是一个向量,包含了目标函数在各个参数方向上的偏导数。对于上面的损失函数 ,梯度可以表示为:
梯度下降法通过以下更新规则来更新参数 :
其中, 是学习率(step size),通常是一个较小的正数,用于控制每次更新的幅度。如果学习率 选择得当,梯度下降法将收敛到目标函数的局部最小值。如果学习率过大,可能导致震荡不收敛;如果学习率过小,则收敛的速度缓慢,需要更多次的迭代。
新数据集介绍
之前介绍的鸢尾花数据集并不适合讲解回归模型,为此我们引入另一个经典的汽车 MPG 数据集。汽车 MPG 数据集最初由美国汽车协会提供,我们可以通过该数据集预测车辆的燃油效率,即每加仑燃料行驶的里程(Miles Per Gallon, MPG)。需要注意的是,scikit-learn 库没有内置该数据集,我们可以直接从 UCI 机器学习仓库 网站下载数据集,也可以通过执行下面的代码联网加载该数据集。
import sslimport pandas as pd
ssl._create_default_https_context = ssl._create_unverified_contextdf = pd.read_csv('https://archive.ics.uci.edu/static/public/9/data.csv')df.info()输出:
<class 'pandas.core.frame.DataFrame'>RangeIndex: 398 entries, 0 to 397Data columns (total 9 columns): # Column Non-Null Count Dtype--- ------ -------------- ----- 0 car_name 398 non-null object 1 cylinders 398 non-null int64 2 displacement 398 non-null float64 3 horsepower 392 non-null float64 4 weight 398 non-null int64 5 acceleration 398 non-null float64 6 model_year 398 non-null int64 7 origin 398 non-null int64 8 mpg 398 non-null float64dtypes: float64(4), int64(4), object(1)memory usage: 28.1+ KB根据上面的输出,我们简单介绍下数据集的九个属性,前面八个都是输入变量(第一个暂不使用),最后一个是输出变量,具体如下表所示。
| 属性名称 | 描述 |
|---|---|
| car_name | 汽车的名称,字符串,这个属性对建模暂时没有帮助 |
| cylinders | 气缸数量,整数 |
| displacement | 发动机排量(立方英寸),浮点数 |
| horsepower | 马力,浮点数,有空值需要提前处理 |
| weight | 汽车重量(磅),整数 |
| acceleration | 加速(0 - 60 mph所需时间),浮点数 |
| model_year | 模型年份(1970年 - 1982年),这里用的是两位的年份 |
| origin | 汽车来源(1 = 美国, 2 = 欧洲, 3 = 日本),这里的1、2、3应该视为三种类别而不是整数 |
| mpg | 车辆的燃油效率,每加仑行驶的里程(目标变量) |
我们先删除car_name这个暂时用不上的属性,然后使用DataFrame对象的corr方法检查输入变量(特征)与输出变量(目标值)之间是否存在相关性。通过相关性分析我们可以选择相关性强的特征,剔除掉那些与目标值相关性较弱的特征,这有助于减少模型的复杂性和过拟合的风险。在多元回归中,多重共线性(即输入变量之间高度相关)可能会影响回归系数的估计,导致模型不稳定。可以通过计算特征之间的相关性和方差膨胀因子(VIF)等来检测共线性问题。
# 删除指定的列df.drop(columns=['car_name'], inplace=True)# 计算相关系数矩阵df.corr()说明:
DataFrame对象的corr方法默认计算皮尔逊相关系数,皮尔逊相关系数适合来自于正态总体的连续值,对于等级数据之间相关性的判定,可以通过修改method参数为spearmean或kendall来计算斯皮尔曼秩相关或肯德尔系数。当然,连续值也可以通过分箱操作处理成等级数据,然后再进行相关性的判定。
在使用该数据集建模之前,我们需要做一些准备工作,首先处理掉horsepower字段的空值,然后将origin字段处理成独热编码(One-Hot Encoding)。独热编码是一种用于处理分类变量的常见编码方式,通常分类数据(如性别、颜色、季节等)无法直接输入机器学习模型进行训练,因为大多数算法只能处理数值数据。独热编码通过将每个分类变量转换为若干个新的二元特征(0或 1)来表示,从而使得这些变量可以输入到机器学习模型中。假设我们有一个叫“颜色”的特征列,可能的取值有红色、绿色和蓝色,我们可以将其通过独热编码转换成三个二元特征,如下表所示:
| 红色 | 绿色 | 蓝色 |
|---|---|---|
| 1 | 0 | 0 |
| 0 | 1 | 0 |
| 0 | 0 | 1 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
说明:我们也可以只保留绿色和蓝色两个列,如果两个列的取值都为
0,那么说明我们的颜色是红色。
独热编码方法简单直观,容易理解和实现。对于无序类别独热编码是非常有效的,因为它不会引入任何虚假的顺序关系,处理后的数据类型是数值型的,很多机器学习算法都能很好的处理。当然,如果类别特征有大量不同的类别取值,独热编码会生成大量的新特征,可能导致数据的维度大幅增加,从而影响计算性能和存储效率,尤其是在数据中有很多稀疏类别时。
下面的代码实现了对数据的预处理。
# 删除有缺失值的样本df.dropna(inplace=True)# 将origin字段处理为类别类型df['origin'] = df['origin'].astype('category')# 将origin字段处理为独热编码df = pd.get_dummies(df, columns=['origin'], drop_first=True)df输出:
cylinders displacement horsepower weight ... model_year mpg origin_2 origin_30 8 307.0 130.0 3504 ... 70 18.0 False False1 8 350.0 165.0 3693 ... 70 15.0 False False2 8 318.0 150.0 3436 ... 70 18.0 False False3 8 304.0 150.0 3433 ... 70 16.0 False False4 8 302.0 140.0 3449 ... 70 17.0 False False.. ... ... ... ... ... ... ... ... ...393 4 140.0 86.0 2790 ... 82 27.0 False False394 4 97.0 52.0 2130 ... 82 44.0 True False395 4 135.0 84.0 2295 ... 82 32.0 False False396 4 120.0 79.0 2625 ... 82 28.0 False False397 4 119.0 82.0 2720 ... 82 31.0 False False
[392 rows x 9 columns]说明:上面调用 pandas 的
get_dummies函数将origin列处理成了独热编码,由于将drop_first参数设置为True,所以原来的取值1、2、3只保留了两个列,分别叫origin_2和origin_3。Scikit-learn 库中preprocessing模块的OneHotEncoder也支持将类别特征处理成独热编码。
接下来,我们还是将数据集拆分为训练集和测试集,代码如下所示。
from sklearn.model_selection import train_test_split
X, y = df.drop(columns='mpg').values, df['mpg'].valuesX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)线性回归代码实现
我们首先使用 scikit-learn 库linear_model模块的LinearRegression来创建线性回归模型,LinearRegression使用最小二乘法计算回归模型的参数,代码如下所示。
from sklearn.linear_model import LinearRegression
model = LinearRegression()model.fit(X_train, y_train)y_pred = model.predict(X_test)如果想查看线性回归模型的参数(回归系数和截距),可以通过下面的代码来实现。
print('回归系数:', model.coef_)print('截距:', model.intercept_)输出:
回归系数: [-0.70865621 0.03138774 -0.03034065 -0.0064137 0.06224274 0.82866534 3.20888265 3.68252848]截距: -21.685482718950933回归模型的评估
回归模型的预测效果到底如何,我们可以通过下面的指标对其进行评估。
- 均方误差(Mean Squared Error, MSE)。MSE 是回归模型最常用的评估指标之一,定义为预测值与真实值误差的平方平均值。
- 均方根误差(Root Mean Squared Error, RMSE)。RMSE 是 MSE 的平方根形式,用于更直观地衡量误差的实际尺度(单位与目标变量一致)。
- 平均绝对误差(Mean Absolute Error, MAE)。MAE 是另一个常用的误差度量指标,定义为预测值与真实值误差的绝对值平均值。
- 决定系数(R-Squared, )。 是一个相对指标,用于衡量模型对数据的拟合程度,其值越接近 1 越好。 的计算公式为:
其中, 为残差平方和; 为总平方和,如下图所示。
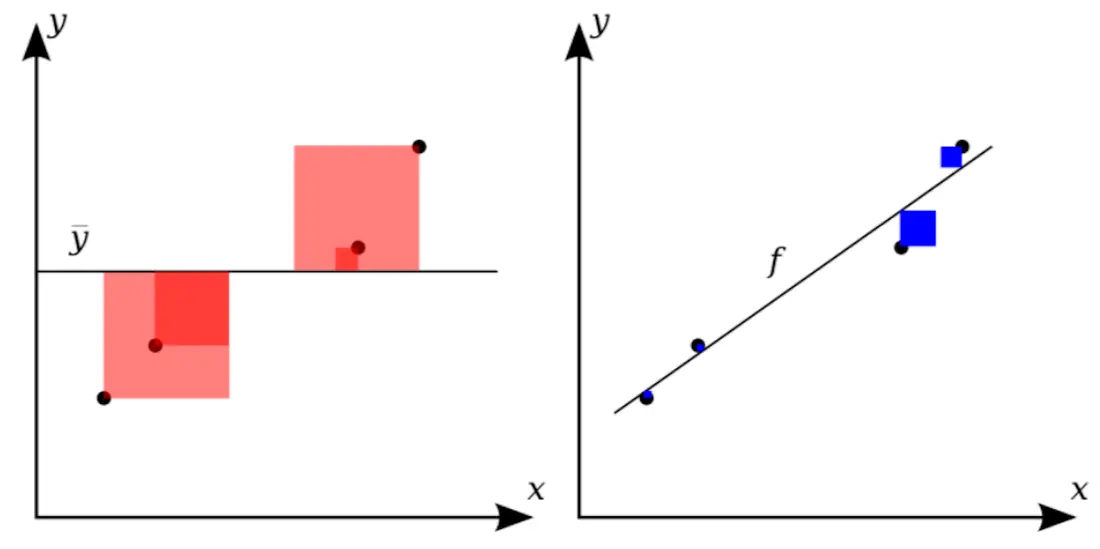
上图左边红色正方形的面积之和就是总平方和,右边蓝色正方形的面积之和就是残差平方和,很显然,模型拟合的效果越好,残差平方和除以总平方和的值就越接近 0, 的值就越接近 1。通常 时,我们认为模型的拟合效果已经很不错了。
可以使用 scikit-learn 中封装好的函数计算出均方误差、平均绝对误差和 的值,代码如下所示。
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
mse = mean_squared_error(y_test, y_pred)mae = mean_absolute_error(y_test, y_pred)r2 = r2_score(y_test, y_pred)
print(f'均方误差: {mse:.4f}')print(f'平均绝对误差: {mae:.4f}')print(f'决定系数: {r2:.4f}')输出:
均方误差: 13.1215平均绝对误差: 2.8571决定系数: 0.7848引入正则化项
岭回归是在线性回归的基础上引入 正则化项,目的是防止模型过拟合,尤其是当特征数较多或特征之间存在共线性时。岭回归的损失函数如下所示:
其中, 正则化项 会惩罚较大的回归系数,相当于缩小了回归系数的大小,但不会使系数为 0(即不会进行特征选择)。可以通过 scikit-learn 库linear_model模块的Ridge类实现岭回归,代码如下所示。
from sklearn.linear_model import Ridge
model = Ridge()model.fit(X_train, y_train)y_pred = model.predict(X_test)print('回归系数:', model.coef_)print('截距:', model.intercept_)mse = mean_squared_error(y_test, y_pred)r2 = r2_score(y_test, y_pred)print(f'均方误差: {mse:.4f}')print(f'决定系数: {r2:.4f}')输出:
回归系数: [-0.68868217 0.03023126 -0.0291811 -0.00642523 0.06312298 0.82583962 3.04105754 3.49988826]截距: -21.390402697674855均方误差: 12.9604决定系数: 0.7874套索回归引入 正则化项,不仅防止过拟合,还具有特征选择的功,特别适用于高维数据。套索回归的损失函数如下所示:
其中, 正则化项 会将某些不重要的回归系数缩减为 0,从而实现特征选择。可以通过 scikit-learn 库linear_model模块的Lasso类实现套索回归,代码如下所示。
from sklearn.linear_model import Lasso
model = Lasso()model.fit(X_train, y_train)y_pred = model.predict(X_test)print('回归系数:', model.coef_)print('截距:', model.intercept_)mse = mean_squared_error(y_test, y_pred)r2 = r2_score(y_test, y_pred)print(f'均方误差: {mse:.4f}')print(f'决定系数: {r2:.4f}')输出:
回归系数: [-0.00000000e+00 4.46821248e-04 -1.22830326e-02 -6.29725191e-03 0.00000000e+00 6.91590631e-01 0.00000000e+00 0.00000000e+00]截距: -9.109888229245005均方误差: 11.1035决定系数: 0.8179注意:上面代码运行结果中的回归系数,有四个特征的回归系数被设置为 0,相当于从 8 个特征中选出了 4 个重要的特征。模型的拟合效果是优于之间的回归模型的,这一点从均方误差和决定系数可以看出。
弹性网络回归结合了岭回归和套索回归的优点,通过同时引入 和 正则化项,适用于高维数据且特征之间存在相关的情况,其损失函数如下所示:
其中, 是控制 和 正则化的权重比例。
线性回归另一种实现
上面我们提到过,除了最小二乘法我们还可以使用梯度下降法来求解回归模型的参数,scikit-learn 库linear_model模块的SGDRegressor就使用了这种方法,SGD 就是 Stochastic Gradient Descent 的缩写。随机梯度下降每次迭代只使用一个随机样本来计算梯度,计算速度快,适合大规模数据集,而且可以跳出局部最优解。需要注意的是它的学习率,如果学习率设置得不合理,它的收敛性可能会发生波动,通常需要使用学习率衰减策略来促进收敛。此外,随机梯度下降对特征的尺度非常敏感,通常需要在训练之前对特征进行标准化或归一化处理,完整的代码如下所示。
from sklearn.linear_model import SGDRegressorfrom sklearn.preprocessing import StandardScaler
# 对特征进行选择和标准化处理scaler = StandardScaler()scaled_X = scaler.fit_transform(X[:, [1, 2, 3, 5]])# 重新拆分训练集和测试集X_train, X_test, y_train, y_test = train_test_split(scaled_X, y, train_size=0.8, random_state=3)
# 模型的创建、训练和预测model = SGDRegressor()model.fit(X_train, y_train)y_pred = model.predict(X_test)print('回归系数:', model.coef_)print('截距:', model.intercept_)
# 模型评估mse = mean_squared_error(y_test, y_pred)r2 = r2_score(y_test, y_pred)print(f'均方误差: {mse:.4f}')print(f'决定系数: {r2:.4f}')输出:
回归系数: [-0.25027084 -0.41349219 -4.9559786 2.83009217]截距: [23.48707219]均方误差: 11.3853决定系数: 0.8133这里,我们还需要强调一下SGDRegressor构造函数几个重要的参数,也是回归模型比较重要的超参数,如下所示:
-
loss:指定优化目标(损失函数),默认值为'squared_error'(最小二乘法),其他可以选择的值有:'huber'、'epsilon_insensitive'和'squared_epsilon_insensitive',其中'huber'适用于对异常值更鲁棒的回归模型。 -
penalty:指定正则化方法,用于防止过拟合,默认为'l2'(L2 正则化),其他可以选择的值有:'l1'(L1正则化)、'elasticnet'(弹性网络,L1 和 L2 的组合)、None(不使用正则化)。 -
alpha:正则化强度的系数,控制正则化项的权重,默认值为0.0001。较大的alpha值会加重正则化的影响,从而限制模型复杂度;较小的值会让模型更关注训练数据的拟合。 -
l1_ratio:当penalty='elasticnet'时,控制 L1 和 L2 正则化之间的权重,默认值为0.15,取值范围为[0, 1](0表示完全使用 L2,1表示完全使用 L1)。 -
tol:优化算法的容差,即判断收敛的阈值,默认值为1e-3。当目标函数的改变量小于tol时,训练会提前终止;如果希望训练更加精确,可以适当降低tol。 -
learning_rate:指定学习率的调节策略,默认值为'constant',表示使用固定学习率,具体的值由eta0指定;其他可选项包括:'optimal':基于公式eta = 1.0 / (alpha * (t + t0))自动调整。'invscaling':按eta = eta0 / pow(t, power_t)缩放学习率。'adaptive':动态调整,误差减少时保持当前学习率,否则减小学习率。
-
eta0:初始学习率,默认值为0.01,当learning_rate='constant'或其他策略使用时,eta0决定了初始更新步长。 -
power_t:当learning_rate='invscaling'时,控制学习率衰减速度,默认值为0.25。较小的值会让学习率下降得更慢,从而更长时间地关注全局优化。 -
early_stopping:是否启用早停机制,默认值为False。如果设置为True,模型会根据验证集性能自动停止训练,防止过拟合。 -
validation_fraction:指定用作验证集的训练数据比例,默认值为0.1。当early_stopping=True时,该参数会起作用。 -
max_iter:训练的最大迭代次数,默认值为1000。当数据较大或学习率较小时,可能需要增加迭代次数以保证收敛。 -
shuffle:是否在每个迭代轮次开始时打乱训练数据,默认值为True,表示打乱数据。打乱数据有助于提高模型的泛化能力。 -
warm_start:是否使用上次训练的参数继续训练,默认值为False。当设置为True时,可以在已有模型的基础上进一步优化。 -
verbose:控制训练过程的日志输出,默认值为0,可以设置为更高值以观察训练进度。
多项式回归
有的时候,我们关心的自变量和因变量之间并不是简单的线性关系,例如广告投入与销售额增长的关系、设备的使用时间与故障率之间的关系等。除此以外,如果数据中存在明显的拐点或者要通过简单的公式来近似某些复杂的现象,线性回归模型可能并不能满足这样的需求,这个时候我们就需要建立多项式回归模型。
下面我们用一个简单的例子对多项式回归加以说明,我们先生成一组数据点并绘制出对应的散点图,代码如下所示。
import numpy as npimport matplotlib.pyplot as plt
x = np.linspace(0, 6, 150)y = x ** 2 - 4 * x + 3 + np.random.normal(1, 1, 150)plt.scatter(x, y)plt.show()输出:
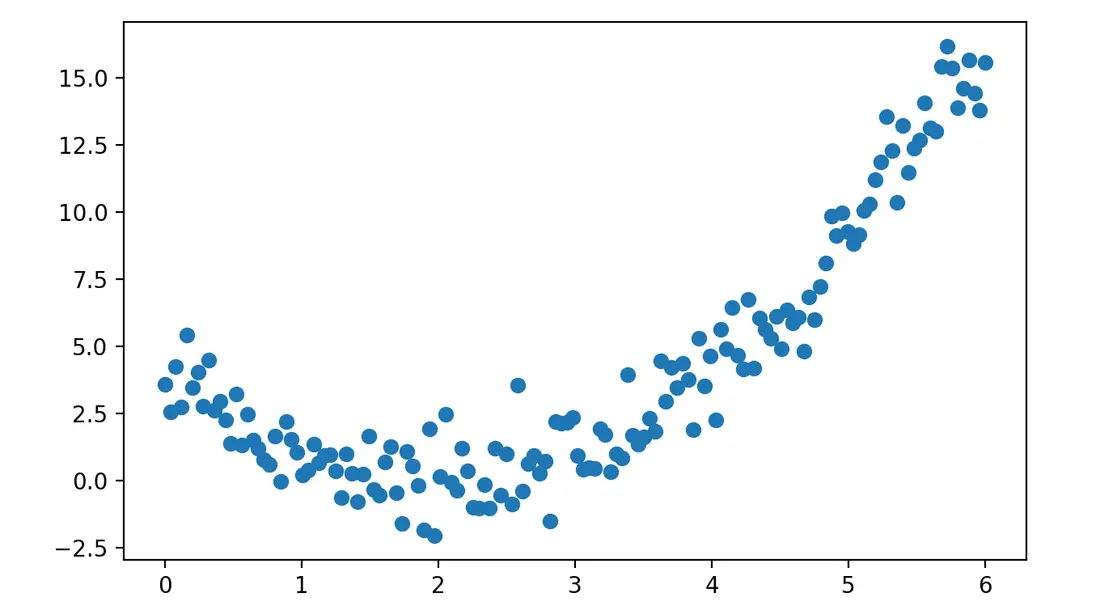
显然,这样的一组数据点是很难通过线性模型进行拟合的,下面的代码可以证明这一点。
x_ = x.reshape(-1, 1)
model = LinearRegression()model.fit(x_, y)a, b = model.coef_[0], model.intercept_y_pred = a * x + bplt.scatter(x, y)plt.plot(x, y_pred, color='r')plt.show()输出:
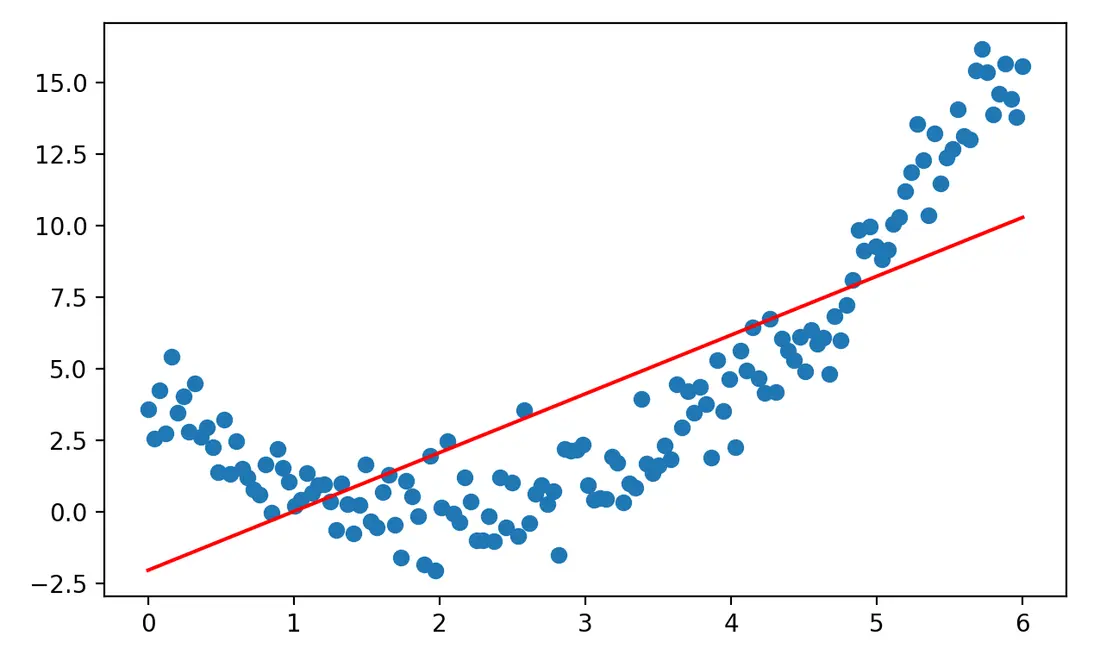
很显然,这是一个欠拟合的结果。我们再看看 的值:
r2 = r2_score(y, y_pred)print(f'决定系数: {r2:.4f}')输出:
决定系数: 0.5933Scikit-learn 库preprocessing模块中的PolynomialFeatures类可以将原始特征扩展为多项式特征,从而将线性模型转换为具有高次项的模型。创建PolynomialFeatures对象时有几个重要的参数:
degree:设置多项式的最高次项。例如,degree=3会生成包含一次项、二次项和三次项的特征。interaction_only:默认值为False,如果设置为True,则只生成交互项(如 ),不生成单独的高次项(如 、 )。include_bias:默认值为True,表示包括常数项(通常为 1),设置为False则不包括常数项。
下面我们通过代码来演示如何通过PolynomialFeatures类进行特征预处理,实现多项式回归。
from sklearn.preprocessing import PolynomialFeatures
poly = PolynomialFeatures(degree=2)x_ = poly.fit_transform(x_)
model = LinearRegression()model.fit(x_, y)y_pred = model.predict(x_)r2 = r2_score(y, y_pred)print(f'决定系数: {r2:.4f}')输出:
决定系数: 0.9497通过特征预处理引入了高次项之后,模型拟合的效果得到了明显的改善。如果希望只对一部分特征添加高次项,可以使用 scikit-learn 库compose模块的ColumnTransformer来定义处理规则,有兴趣的读者可以自行研究。需要注意的是,多项式回归时随着高次项的引入,模型发生过拟合的风险增加会大大增加,尤其在数据量较小时;另一方面,高次项的值可能会导致特征范围变得很大,要考虑对特征进行标准化处理。
逻辑回归
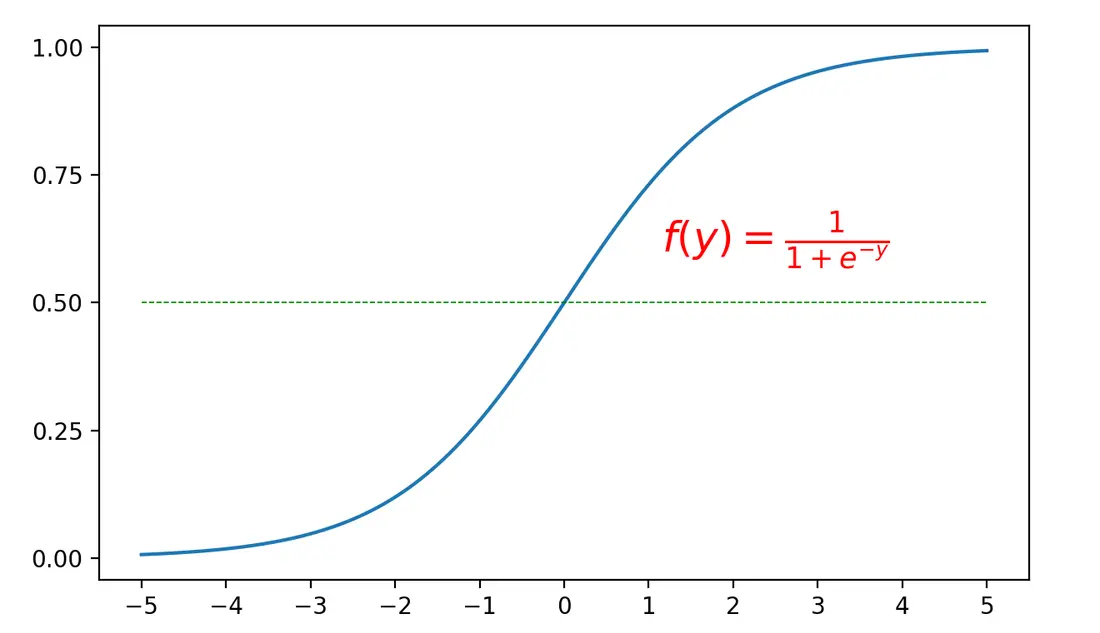
逻辑回归尽管名字中含有“回归”,但逻辑回归实际上是一种分类算法,用于处理二分类问题,例如电子邮件是不是垃圾邮件、用户是否会点击广告、信用卡客户是否存在违约风险等。逻辑回归的核心思想是通过 Sigmoid 函数将线性回归的输出映射到区间,作为对分类概率的预测。Sigmoid 函数的曲线如下图所示。
下面,我们用 scikit-learn 库datasets模块提供的make_classification函数生成一组模拟数据, 通过逻辑回归来构建分类预测模型,代码如下所示。
from sklearn.datasets import make_classificationfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import classification_report
# 生成1000条样本数据,每个样本包含6个特征X, y = make_classification(n_samples=1000, n_features=6, random_state=3)# 将1000条样本数据拆分为训练集和测试集X_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)
# 创建和训练逻辑回归模型model = LogisticRegression()model.fit(X_train, y_train)
# 对测试集进行预测并评估y_pred = model.predict(X_test)print(classification_report(y_test, y_pred))输出:
precision recall f1-score support
0 0.95 0.93 0.94 104 1 0.93 0.95 0.94 96
accuracy 0.94 200 macro avg 0.94 0.94 0.94 200weighted avg 0.94 0.94 0.94 200这里,我们再强调一下LogisticRegression构造函数几个重要的参数,也是逻辑回归模型比较重要的超参数,如下所示:
penalty:指定正则化类型,用于控制模型复杂度,防止过拟合,默认值为l2。C:正则化强度的倒数,默认值为1.0。较小的C值会加强正则化(更多限制模型复杂度),较大的C值会减弱正则化(更注重拟合训练数据)。solver:指定优化算法,默认值为lbfgs,可选值包括:'newton-cg'、'lbfgs'、'sag'、'saga':支持 L2 和无正则化。'liblinear':支持 L1 和 L2 正则化,适用于小型数据集。'saga':支持 L1、L2 和 ElasticNet,适用于大规模数据。
multi_class:指定多分类问题的处理方式,默认值为'auto',根据数据选择'ovr'或'multinomial',前者表示一对多策略,适合二分类或多分类的基础情况,后者表示多项式回归策略,适用于多分类问题,需与'lbfgs'、'sag'或'saga'搭配使用。fit_intercept:是否计算截距(偏置项),默认值为True。class_weight:类别权重,处理类别不平衡问题,默认值为None,设置为'balanced'可以根据类别频率自动调整权重。
说明:逻辑回归有些超参数跟我们之前讲的
SGDRegressor是类似的,此处不再进行赘述。
总结
回归模型是一种统计分析方法,用于建立自变量与因变量之间的关系。它通过拟合数据来预测目标变量的值,在经济学、工程、医学等领域有着广泛的应用,可以帮助决策者进行数据驱动的预测和分析。
86 K-Means聚类算法
聚类(Clustering)是数据挖掘和机器学习中的一种重要技术,用于将数据集中的样本划分为多个相似的组或类别。这种方法在许多领域得到了广泛应用,例如:
- 电商行业:根据用户行为数据,将消费者分为不同的群体(高消费用户、高活跃用户、流失风险用户、价格敏感用户等)以制定有针对性的运营策略,实现更精准的广告投放,代表性的企业包括阿里巴巴、亚马逊(Amazon)等。
- 金融行业:各大银行通过聚类算法分析用户的信用记录、收入水平、消费行为等数据,将用户分为不同的风险群体,对于高风险群体需要更严格的信用审核,而低风险群体可以享受更优惠的贷款利率或信用额度。
- 医疗行业:通过分析患者的健康数据(如病史、基因数据、生活习惯等),将患者分为不同健康风险群体,提高疾病预测的准确性,推动了精准医疗的发展,代表性的公司如强生(Johnson & Johnson)、辉瑞(Pfizer)等。
- 社交媒体:通过分析用户的好友关系、兴趣爱好、社交互动等数据,将用户划分为不同的社交圈,用于推荐好友、定制个性化内容以及优化了平台上的信息流推荐系统。
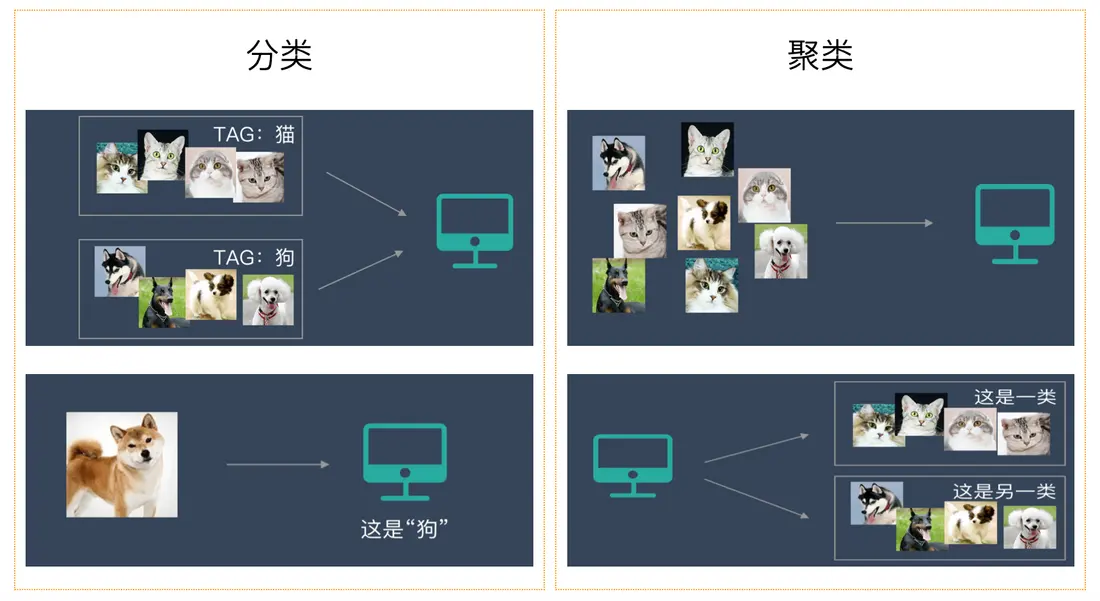
聚类是一种无监督学习,因为它不需要预先定义的标签,只是根据数据特征去学习,通过度量特征相似度或者距离,然后把已知的数据集划分成若干个不同的类别。与分类不同,聚类任务的目标是发现数据内在的结构。聚类算法大体上可以分为:基于距离的聚类、基于密度的聚类、层次聚类、谱聚类等。如果你还分不清楚聚类和分类到底有什么区别,相信下面的图可以帮到你。
算法原理
下面我们重点为大家介绍名为 K-Means 的聚类算法。K-Means 是一种基于原型的分区聚类方法,其目标是将数据集划分为K个簇,并使每个簇内的数据点尽可能相似。K-Means 算法的实施步骤如下所示:
- 初始化簇中心:随机选择K个样本作为初始簇中心,簇中心通常也称为质心。
- 分配样本到最近的质心:计算每个样本与所有质心的距离,将样本分配到最近的簇。
- 更新质心:计算每个簇的所有样本的均值,并将其作为新的质心。
- 重复步骤2和步骤3,直到质心收敛或达到预设的迭代次数。
数学描述
我们将上面的算法原理用数学语言进行描述。对于给定的数据集 ,K-Means 算法的目标是最小化目标函数(总误差平方和)。目标函数如下所示:
其中, 是簇的数量, 表示第 个簇中的样本集合, 是第 个簇的中心, 是数据点。因为这个问题属于 NP 困难组合优化问题,所以在实际求解时我们会采用迭代的方式来寻求满意解。
首先随机选择 个点作为初始质心 ,对于每个数据点 ,计算到每个质心的距离,选择距离最近的质心,即:
更新质心为簇中所有点的均值,即:
重复上面两个动作,直到质心不再变化或变化小于某个阈值,这就确保了算法的收敛性。
代码实现
下面我们用 Python 代码实现 K-Means 聚类,我们先暂时不使用 scikit-learn 库,主要帮助大家理解算法的工作原理。
import numpy as np
def distance(u, v, p=2): """计算两个向量的距离""" return np.sum(np.abs(u - v) ** p) ** (1 / p)
def init_centroids(X, k): """随机选择k个质心""" index = np.random.choice(np.arange(len(X)), k, replace=False) return X[index]
def closest_centroid(sample, centroids): """找到跟样本最近的质心""" distances = [distance(sample, centroid) for i, centroid in enumerate(centroids)] return np.argmin(distances)
def build_clusters(X, centroids): """根据质心将数据分成簇""" clusters = [[] for _ in range(len(centroids))] for i, sample in enumerate(X): centroid_index = closest_centroid(sample, centroids) clusters[centroid_index].append(i) return clusters
def update_centroids(X, clusters): """更新质心的位置""" return np.array([np.mean(X[cluster], axis=0) for cluster in clusters])
def make_label(X, clusters): """生成标签""" labels = np.zeros(len(X)) for i, cluster in enumerate(clusters): for j in cluster: labels[j] = i return labels
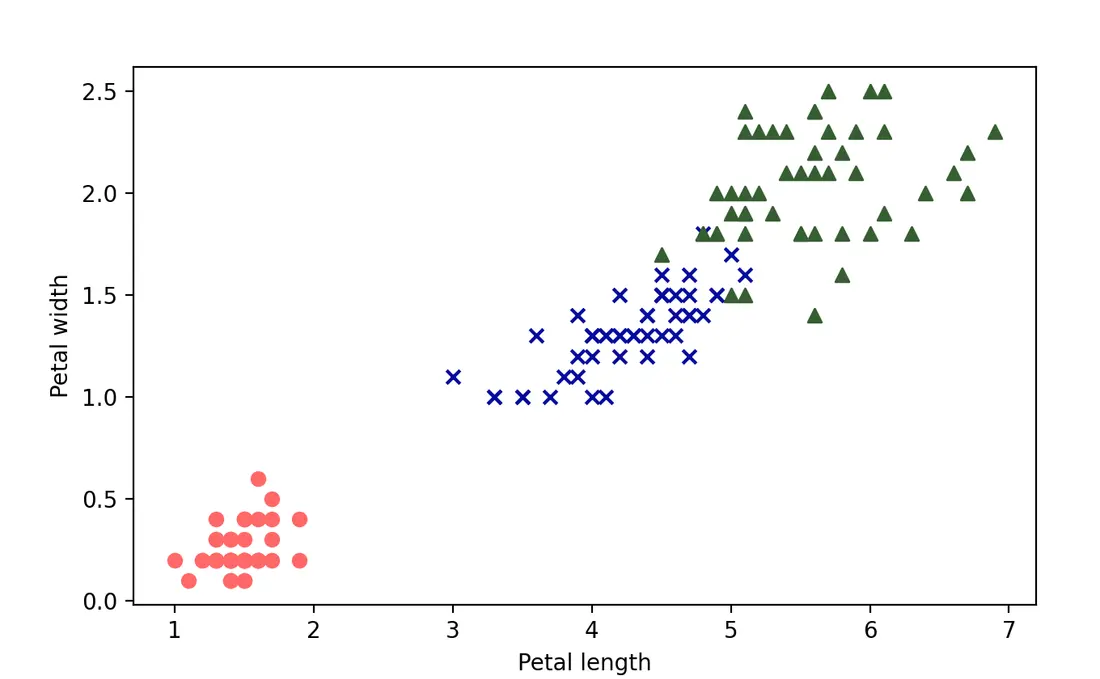
def kmeans(X, *, k, max_iter=1000, tol=1e-4): """KMeans聚类""" # 随机选择k个质心 centroids = init_centroids(X, k) # 通过不断的迭代对数据进行划分 for _ in range(max_iter): # 通过质心将数据划分到不同的簇 clusters = build_clusters(X, centroids) # 重新计算新的质心的位置 new_centroids = update_centroids(X, clusters) # 如果质心几乎没有变化就提前终止迭代 if np.allclose(new_centroids, centroids, rtol=tol): break # 记录新的质心的位置 centroids = new_centroids # 给数据生成标签 return make_label(X, clusters), centroids我们仍然以鸢尾花数据集为例,看看我们自己实现的kmeans函数能否为将三种鸢尾花划分为三个不同的类别。由于是无监督学习,这里我们直接把整个数据集带入kmeans函数,代码如下所示。
from sklearn.datasets import load_iris
iris = load_iris()X, y = iris.data, iris.targetlabels, centers = kmeans(X, k=3)这里,千万不要直接拿y_pred和y进行比较,我们之前说过,聚类算法并不知道数据对应的标签,它只是根据特征将数据划分为不同的类别,这里输出的0、1、2 并不直接对应到山鸢尾、多彩鸢尾和为吉尼亚鸢尾。我们可以用可视化的方式来看看预测的结果,代码如下所示:
import matplotlib.pyplot as plt
colors = ['#FF6969', '#050C9C', '#365E32']markers = ['o', 'x', '^']
plt.figure(dpi=200)for i in range(len(centers)): samples = X[labels == i] print(markers[i]) plt.scatter(samples[:, 2], samples[:, 3], marker=markers[i], color=colors[i]) plt.scatter(centers[i, 2], centers[i, 3], marker='*', color='r', s=120)
plt.xlabel('Petal length')plt.ylabel('Petal width')plt.show()输出:
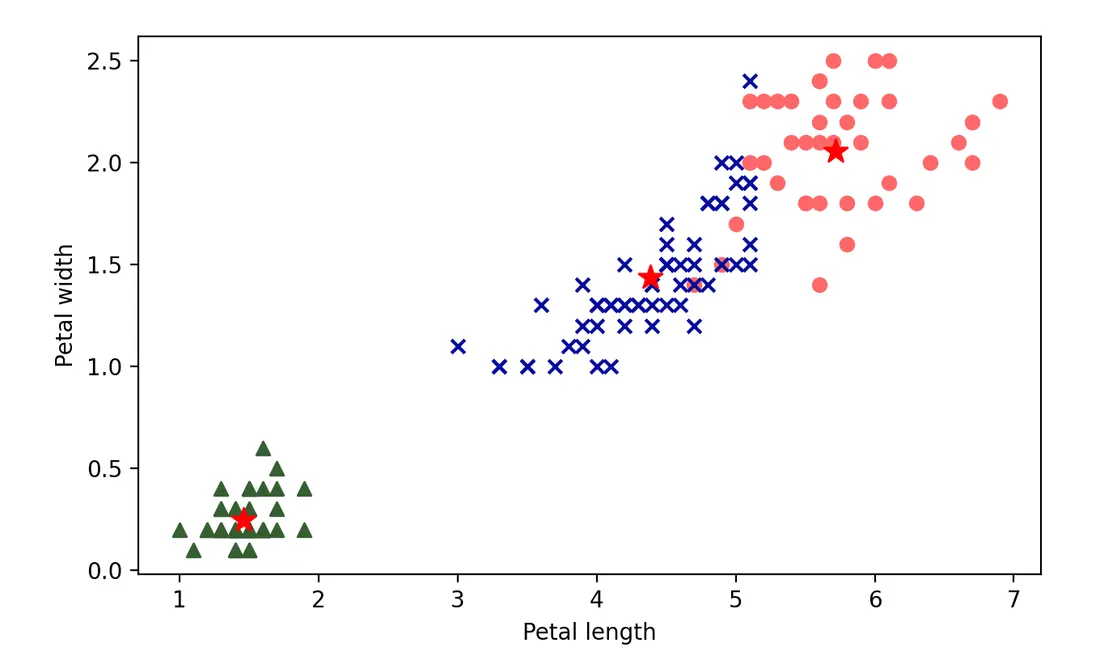
我们用原始数据重新输出,跟上面的图做一个对比,代码如下所示。
import matplotlib.pyplot as plt
colors = ['#FF6969', '#050C9C', '#365E32']markers = ['o', 'x', '^']
plt.figure(dpi=200)for i in range(len(centers)): samples = X[y == i] plt.scatter(samples[:, 2], samples[:, 3], marker=markers[i], color=colors[i])
plt.xlabel('Petal length')plt.ylabel('Petal width')plt.show()输出:
直接使用 scikit-learn 库cluster模块的KMeans类实现 K-Means 聚类是更好的选择,代码如下所示。
from sklearn.cluster import KMeans
# 创建KMeans对象km_cluster = KMeans( n_clusters=3, # k值(簇的数量) max_iter=30, # 最大迭代次数 n_init=10, # 初始质心选择尝试次数 init='k-means++', # 初始质心选择算法 algorithm='elkan', # 是否使用三角不等式优化 tol=1e-4, # 质心变化容忍度 random_state=3 # 随机数种子)# 训练模型km_cluster.fit(X)print(km_cluster.labels_) # 分簇的标签print(km_cluster.cluster_centers_) # 各个质心的位置print(km_cluster.inertia_) # 样本到质心的距离平方和下面我们对KMeans类的几个超参数加以说明:
n_clusters:指定聚类的簇数,即 值,默认值为8。max_iter:最大迭代次数,默认值为300,控制每次初始化中 K-Means 迭代的最大步数。init:初始化质心的方法,默认值为'k-means++',表示从数据中多次随机选取 K 个质心,每次都计算这一次选中的中心点之间的距离,然后取距离最大的一组作为初始化中心点,推荐大家使用这个值;如果设置为'random'则随机选择初始质心。n_init:和上面的参数配合,指定算法运行的初始化次数,默认值为10。algorithm:K-Means 的计算算法,默认值为'lloyd'。还有一个可选的值为'elkan',表示基于三角不等式的优化算法,适用于 K 值较大的情况,计算效率较高。tol:容忍度,控制算法的收敛精度,默认值为1e-4。如果数据集较大时,可适当增大此值以加快收敛速度。
总结
K-Means 是一种经典的聚类算法,它的优点包括实现简单,算法收敛速度快;缺点是结果不稳定(跟初始值设定有关系),无法解决样本不均衡的问题,容易收敛到局部最优解,受噪声数据影响较大。如果你想通过可视化的方式理解聚类的过程,我们给大家推荐一个名为 Naftali 的人的博客,该网站上提供了可视化的方式展示 K-Means 和 DBSCAN 聚类(一种基于密度的聚类算法),如下图所示。
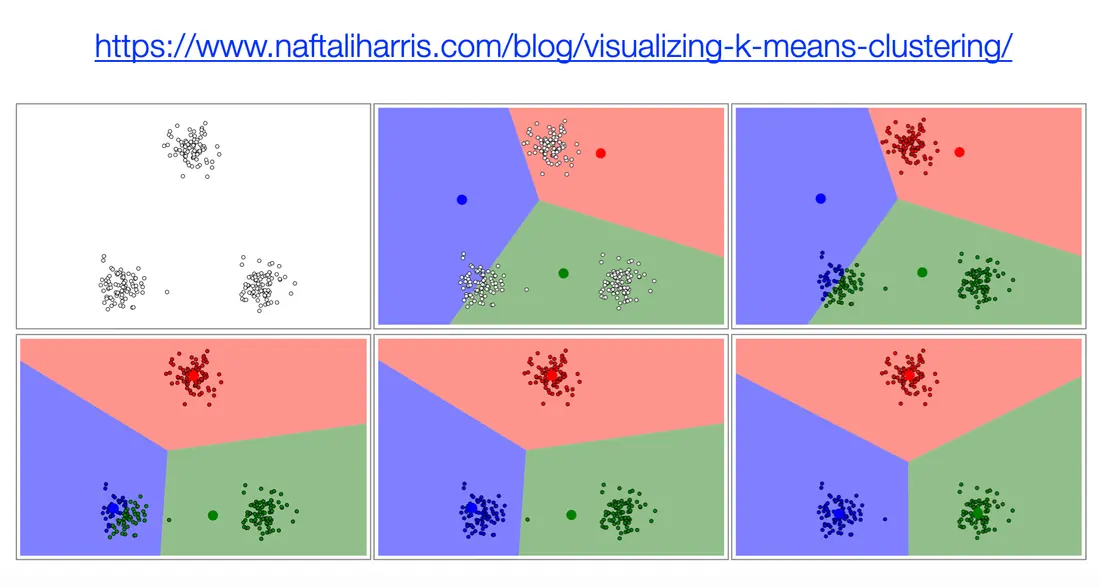
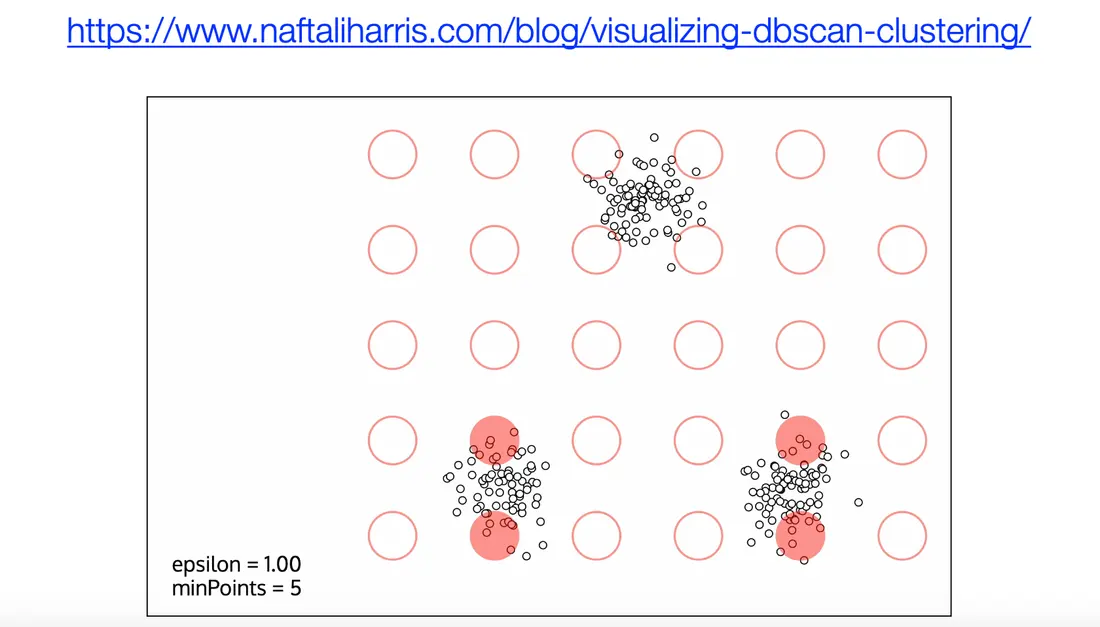
87 集成学习算法
之前的章节,我们主要为大家介绍了机器学习中的单模型。事实上,将多个单模型组合成一个综合模型的方式早已成为现代机器学习模型采用的主流方法,这种方法被称为集成学习(ensemble learning)。集成学习的目标是通过多个弱学习器(分类效果略优于随机猜测的模型,如果太强容易导致过拟合)的组合来构建强学习器,从而克服单一模型可能存在的局限性,获得比单一模型更好的泛化能力,通常用于需要高精度预测的场景。
算法分类
集成学习算法主要分为以下几类:
-
Bagging:通过从训练数据中随机抽样生成多个数据子集,在这些子集上训练多个模型,并将它们的结果进行结合。这种集成学习的原理如下图所示,最典型的例子就是我们之前讲过的随机森林。
-
Boosting:通过迭代训练多个模型,在每一轮训练时,重点关注前一轮预测错误的样本。每个新模型的训练目标是弥补前一轮模型的不足。这种集成学习的原理如下图所示,经典的算法有 AdaBoost、Gradient Boosting 和 XGBoost。
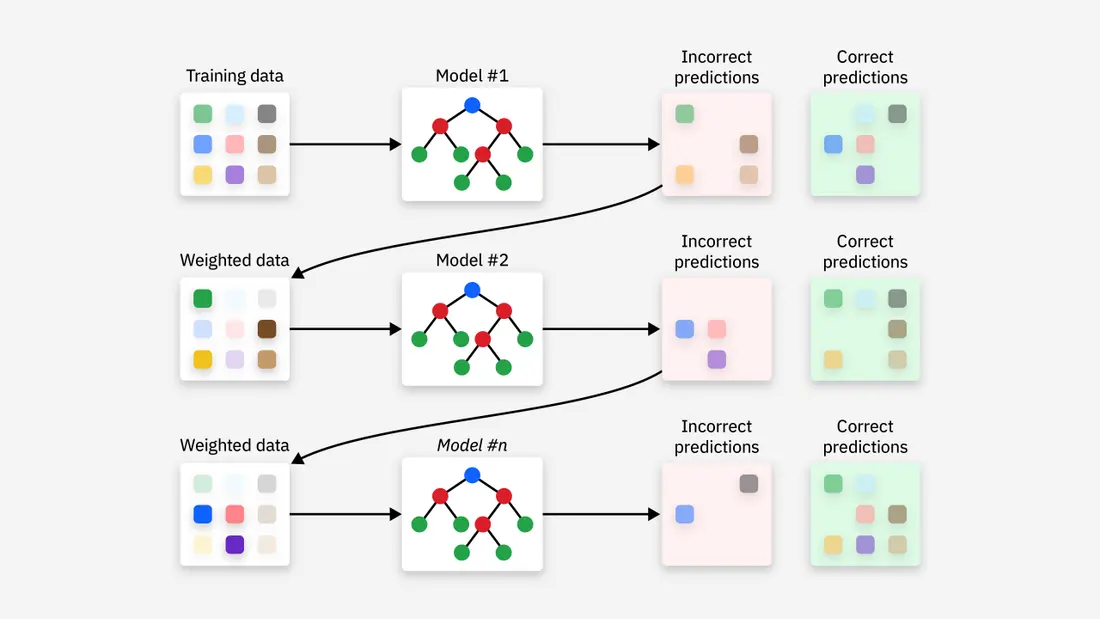
Boosting的基本原理是:初始时对所有样本赋予相同的权重;训练第一个模型时,错误分类的样本权重会增加;训练下一个模型时,重点关注之前模型错误分类的样本;最终将所有模型的结果加权组合(表现好的模型会有更高的权重),得到最终的输出。简单的说,Boosting 就是串行的训练一系列弱分类器,使得被先前弱分类器分类错误的样本在后续得到更多关注,最后将这些分类器组合成最优强分类器的过程。
-
Stacking:通过训练多个模型,将它们的预测结果作为新特征输入到另一个模型(通常称为“二级模型”)中,用“二级模型”来做最终的预测,原理如下图所示。
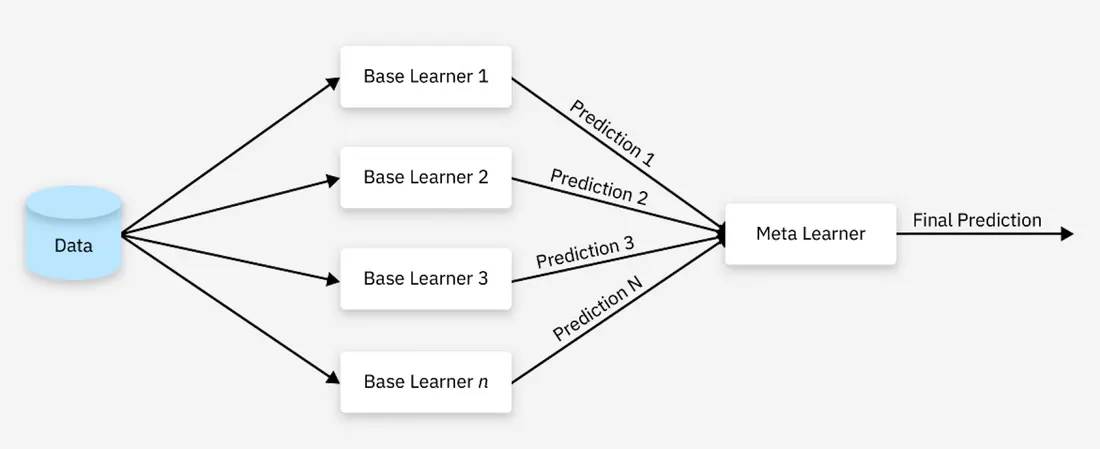
AdaBoost
AdaBoost(Adaptive Boosting)由 Yoav Freund 和 Robert Schapire 于 1996 年提出,是一种经典的集成学习算法,通常将其翻译为自适应提升算法。AdaBoost 的做法非常朴素,一是提高前一轮被弱分类器分类错误的样本的权重,二是对多个弱分类器进行线性组合,提高分类效果好的弱分类器的权重;它的自适应体现在会根据前一轮模型的错误调整样本的权重。
AdaBoost 算法的训练过程是逐步迭代的,关键步骤如下:
- 初始化样本权重:给每个训练样本分配一个相等的初始权重。对于 个样本,初始权重为:
这里, 表示第 个样本的权重,初始时权重相等。
- 训练弱学习器:在每一轮迭代中,AdaBoost 会根据当前样本的权重训练一个弱分类器(例如决策树桩,即深度为 1 的决策树)。弱分类器的目标是最小化加权误差。对于第 轮训练得到的分类器模型(弱学习器) ,计算其加权误差:
其中, 是第 个样本的真实标签, 是第 轮模型 对第 个样本 给出的预测结果(取值为 1 或 -1), 是指示函数,当样本 被错误分类时函数取值为 1,否则函数取值为 0。
- 更新分类器权重:计算第 轮分类器模型的权重 ,并用它来更新每个样本的权重。分类器权重 的计算公式为:
当分类器的误差较低时, 的值较大,说明该分类器的权重较大。
- 更新样本权重:根据当前分类器的表现,更新样本的权重。误分类样本的权重会增加,正确分类样本的权重会减少。样本权重的更新公式为:
-
归一化权重:对所有样本的权重进行归一化,使得所有样本的权重和为 1。
-
最终分类器:AdaBoost 的最终分类器是所有弱学习器的加权组合,预测时通过加权投票来决定最终类别:
其中, 是符号函数,其定义如下所示:
例如,有 3 个弱学习器 、 、 ,它们的输出分别是+1、-1和+1,对应的权重是 、 、 ,那么加权和为:
由于加权和0.4为正,符号函数会输出+1,表示最终预测类别为正类。
我们还是以鸢尾花数据集为例,应用 AdaBoost 集成学习算法来构建分类模型,完整的代码如下所示。
from sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.tree import DecisionTreeClassifierfrom sklearn.ensemble import AdaBoostClassifierfrom sklearn.metrics import classification_report
# 数据集的加载和划分iris = load_iris()X, y = iris.data, iris.targetX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)
# 初始化弱分类器(决策树桩)base_estimator = DecisionTreeClassifier(max_depth=1)# 初始化 AdaBoost 分类器model = AdaBoostClassifier(base_estimator, n_estimators=50)# 训练模型model.fit(X_train, y_train)# 预测结果y_pred = model.predict(X_test)
# 输出评估报告print(classification_report(y_test, y_pred))输出:
precision recall f1-score support
0 1.00 1.00 1.00 10 1 0.90 0.90 0.90 10 2 0.90 0.90 0.90 10
accuracy 0.93 30 macro avg 0.93 0.93 0.93 30weighted avg 0.93 0.93 0.93 30这里需要注意几个超参数的设置:
n_estimators:指定要训练的基学习器(弱分类器)的数量,默认值为 50。learning_rate:控制每个基学习器在最终模型中的贡献大小,即学习率,默认值为 1.0。algorithm:决定 AdaBoost 的训练算法。AdaBoost 主要有两种训练模式:'SAMME':用于多类分类问题的算法,采用加法模型。'SAMME.R':基于 Real AdaBoost 的算法,用于加权的二分类和多分类问题,使用了一个加权的重新采样策略。
base_estimator:基学习器,默认值为None,表示使用max_depth=1的DecisionTreeClassifier作为基学习器。所以,上面代码中创建AdaBoostClassifier对象的两个参数都可以省略,因为它们刚好都是默认值。
增大 n_estimators 可以提高模型的性能,但可能会导致过拟合;增大 learning_rate 则可以加速训练,但可能会导致模型不稳定。通常需要通过交叉验证来找到最佳的 n_estimators 和 learning_rate 的组合。对于大多数问题,DecisionTreeClassifier(max_depth=1) 是常见的选择,但如果数据较为复杂,可以考虑其他基学习器,如SVC、LogisticRegression等。
GBDT
GBDT(Gradient Boosting Decision Trees)也是一种强大的集成学习算法,相较于 AdaBoost,GBDT 系列的模型应用得更加广泛。GBDT 基于梯度提升(Gradient Boosting)的思想,结合了决策树的优势,通过一系列的弱分类器(决策树)逐步改进模型,每次训练时通过减少前一个模型的误差(拟合残差)来提高模型的预测性能。
GBDT 使用梯度下降的方式来最小化损失函数。对于回归任务,损失函数通常是均方误差(MSE);对于分类任务,常用的损失函数是对数损失(Log Loss)。下面我们以二分类任务为例,为大家讲解算法的原理。
- 损失函数。在分类任务中,通常使用对数似然损失函数,对于二分类问题,损失函数如下所示:
其中, 是实际标签( ,表示类别 0 或 1), 是模型预测的样本 属于类别 1 的概率。由于 GBDT 是基于梯度提升算法的,因此在每一轮的更新中,我们将通过梯度下降法来优化这个损失函数。
- 梯度计算。为了使用梯度提升,我们需要计算损失函数关于当前模型预测的梯度。令当前模型的输出为 ,即预测函数。根据对数损失函数, 是通过模型输出 转换得到的概率,通常使用 Sigmoid 函数,有:
计算损失函数对 的梯度时,我们得到:
即梯度为 ,这个值告诉我们当前模型的预测 与真实标签 之间的差距。
-
模型更新。每一轮的更新都包括两步:
- 计算残差:在每一轮迭代中,我们计算当前模型的残差,即 ,表示每个样本的误差。
- 拟合残差:使用新的基学习器(通常是决策树)来拟合这些残差。在分类任务中,我们训练的决策树并不是拟合真实标签,而是拟合残差,即拟合当前模型的预测误差。
更新规则为:
其中, 是第 轮模型的输出; 是第 轮训练出的弱学习器(通常是决策树),它预测当前模型的残差; 是学习率,控制每棵树的贡献大小。通过这样逐步拟合残差,最终生成的模型 就是一个由多棵决策树组成的强学习器。
对于多分类任务,我们需要将损失函数和梯度计算做相应的扩展。常用的多分类损失函数是多项式对数损失,对于每个类别 ,损失函数可以表示为:
其中, 是类别总数, 是目标类别 的指示函数, 是样本 属于类别 的预测概率。
我们还是以鸢尾花数据集为例,应用 AdaBoost 集成学习算法来构建分类模型,完整的代码如下所示。
from sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.ensemble import GradientBoostingClassifierfrom sklearn.metrics import classification_report
# 数据集的加载和划分iris = load_iris()X, y = iris.data, iris.targetX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)
# 初始化 GBDT 分类器model = GradientBoostingClassifier(n_estimators=32)# 训练模型model.fit(X_train, y_train)# 预测结果y_pred = model.predict(X_test)
# 输出评估报告print(classification_report(y_test, y_pred))输出:
precision recall f1-score support
0 1.00 1.00 1.00 10 1 1.00 1.00 1.00 10 2 1.00 1.00 1.00 10
accuracy 1.00 30 macro avg 1.00 1.00 1.00 30weighted avg 1.00 1.00 1.00 30我们还是讲一讲GradientBoostingClassifier几个重要的超参数:
loss:指定用于分类任务的损失函数,默认值为deviance,表示使用对数损失函数。也可以选择exponential,表示使用指数损失函数(AdaBoost 的损失函数)。learning_rate:控制每棵树对最终预测结果的影响程度,默认值为 0.1。较小的学习率通常会带来更好的泛化能力,但需要更多的弱分类器(即更多的树)来拟合训练数据;如果学习率设置得太大,则可能会导致模型欠拟合。n_estimators:指定要训练的基学习器(通常是决策树)的数量,默认值为 100。subsample:控制每棵树训练时使用的数据比例,默认值为 1.0(即使用所有数据)。通过设置小于 1 的值,可以在训练每棵树时随机选择部分样本,从而增加模型的随机性减少过拟合。通常情况下,0.8 或 0.9 是不错的选择。criterion:用于控制分裂时的分裂标准,默认值为'friedman_mse'。该参数决定了如何选择每个节点的最佳划分方式,可选的值有:'friedman_mse':这个准则是基于均方误差(MSE)的一个改进版本,旨在减小对不平衡数据的敏感性,并且在一些实际任务中,能够比传统的 MSE 产生更好的结果。'mse':使用传统的均方误差(MSE)来评估每个分裂点的质量,MSE 越小,说明当前节点的分裂越好。在分类任务中,使用'friedman_mse'往往能取得更好的效果。'mae':使用平均绝对误差(MAE)来评估分裂的质量,MAE 对异常值不那么敏感,但在实际应用中通常较少使用。
validation_fraction:用于指定训练过程中的验证集比例,用于执行早期停止(early stopping),避免过拟合。该参数可与n_iter_no_change配合使用,在验证集上评估性能,当连续若干轮没有改进时,提前停止训练。
除了上面提到的超参数外,还有一些跟决策树类似的超参数,此处就不再进行赘述了。需要注意的是,增加 n_estimators(树的数量)时,通常需要减小 learning_rate以防过拟合;调整决策树的max_depth和min_samples_split也可以减小树的复杂度来防止过拟合;用好subsample和early_stopping参数也可以达成类似的效果。建议大家通过网格搜索交叉验证的方式,结合模型的训练误差和验证误差来寻找最佳参数组合。
XGBoost
从算法精度、速度和泛化能力等性能指标来看GBDT,仍然有较大的优化空间。XGBoost(eXtreme Gradient Boosting)正是一种基于 GBDT 的顶级梯度提升模型,由陈天奇在其论文《XGBoost: A Scalable Tree Boosting System》中提出。相较于 GBDT,从算法精度上看,XGBoost 通过将损失函数展开到二阶导数,使得梯度提升树模型更能逼近其真实损失;从算法速度上看,XGBoost 使用了加权分位数 sketch 和稀疏感知算法这两个技巧,通过缓存优化和模型并行来提高算法速度;从算法泛化能力上来看,通过对损失函数加入正则化项、加性模型中设置缩减率和列抽样等方法,来防止模型过拟合。因为上述原因,XGBoost 不论在学术界、工业界和竞赛圈都很受欢迎,有着广泛的应用。关于 XGBoost 的细节,有兴趣的读者可以阅读陈天奇的论文,此处不进行展开介绍。
我们可以下面的方式来使用 XGBoost,首先安装依赖项。
pip install xgboost下面的代码为大家展示了如何使用 XGBoost。
import matplotlib.pyplot as pltimport xgboost as xgbfrom sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import classification_report
# 数据集的加载和划分iris = load_iris()X, y = iris.data, iris.targetX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)
# 将数据处理成数据集格式DMatrix格式dm_train = xgb.DMatrix(X_train, y_train)dm_test = xgb.DMatrix(X_test)
# 设置模型参数params = { 'booster': 'gbtree', # 用于训练的基学习器类型 'objective': 'multi:softmax', # 指定模型的损失函数 'num_class': 3, # 类别的数量 'gamma': 0.1, # 控制每次分裂的最小损失函数减少量 'max_depth': 6, # 决策树最大深度 'lambda': 2, # L2正则化权重 'subsample': 0.8, # 控制每棵树训练时随机选取的样本比例 'colsample_bytree': 0.8, # 用于控制每棵树或每个节点的特征选择比例 'eta': 0.001, # 学习率 'seed': 10, # 设置随机数生成器的种子 'nthread': 16, # 指定了训练时并行使用的线程数}
# 训练模型model = xgb.train(params, dm_train, num_boost_round=200)# 预测结果y_pred = model.predict(dm_test)
# 输出模型评估报告print(classification_report(y_test, y_pred))
# 绘制特征重要性评分xgb.plot_importance(model)plt.grid(False)plt.show()输出的特征重要性如下图所示。
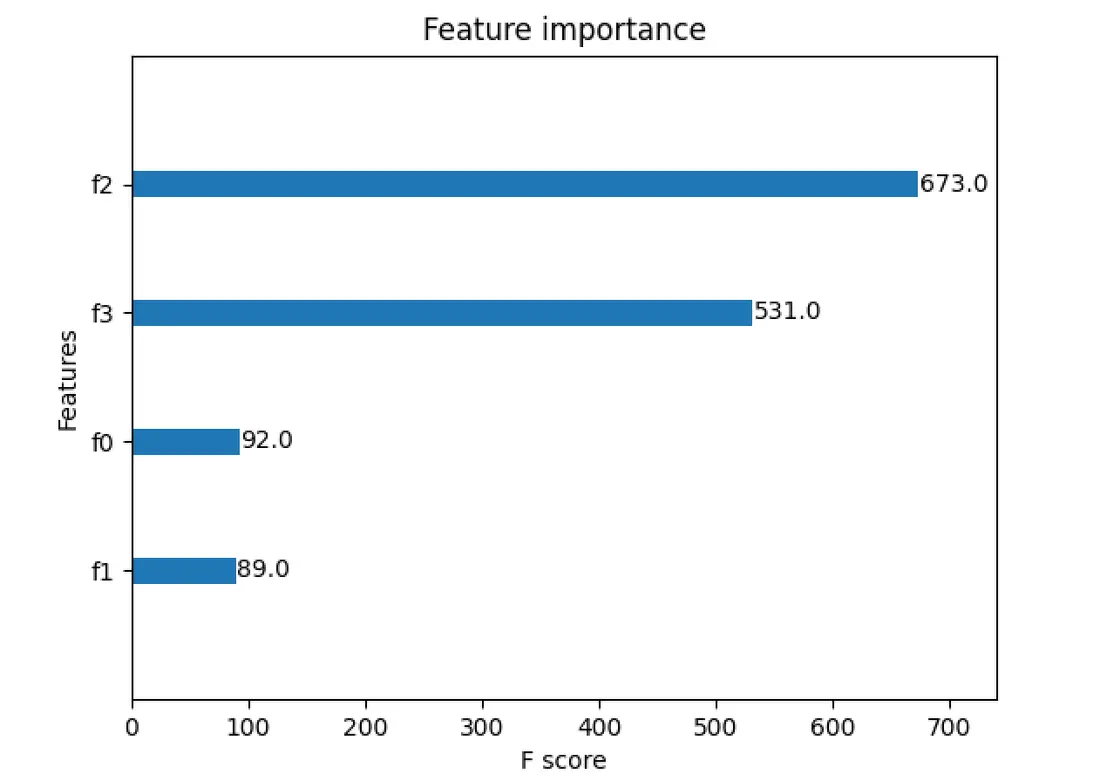
我们再说说这个 XGBoost 的模型参数, 先看看上面代码中的param字典,有几个参数需要详细说明一下。
booster:指定用于训练的基学习器类型,默认值为'gbtree',表示使用传统的决策树作为基学习器;其他的选项包括'gblinear'和'dart',前者表示使用线性回归或逻辑回归,后者也是基于决策树的模型,但具有丢弃树的机制,降低过拟合风险。通常'gbtree'适用于大多数问题,尤其涉及到非线性关系;'dart'适用于复杂数据集,尤其是在出现过拟合时。如果数据集较小或线性关系较强,可以尝试使用'gblinear'。objective:指定模型的损失函数(优化目标),常见的选项包括:'reg:squarederror':回归任务中的均方误差(MSE),用于回归任务。'reg:logistic':回归任务中的逻辑回归,通常用于二分类任务。'binary:logistic':二分类任务中的逻辑回归,输出概率值。'binary:logitraw':二分类任务中的逻辑回归,输出未经过 Sigmoid 处理的原始值。'multi:softmax':多分类任务,输出为每个类别的最大概率。'multi:softprob':多分类任务,输出为每个类别的概率分布。
eta/learning_rate:XGBoost 中的学习率,默认值为 0.3,推荐将初始值设置为 0.01 到 0.1。alpha和lambda:前者控制 L1 正则化项(Lasso)的强度,默认为0;后者控制 L2 正则化项(Ridge)的强度,默认为1。scale_pos_weight:用于处理类别不平衡问题,尤其是二分类问题。在类别严重不平衡的情况下,通过调整这个参数来加大少数类的权重,使得模型更关注少数类样本,默认值为 1。gamma:用来控制每次分裂的最小损失函数减少量,该参数控制树的生长,越大的gamma会使得树更小,减小过拟合的风险,默认值为 0,意味着模型不会受到分裂的限制,树会尽可能深,直到节点中没有足够的样本。num_class:用于多分类任务的参数,表示类别的数量。对于二分类任务,无需设置该参数。colsample_bytree/colsample_bylevel/colsample_bynode:控制在每棵树、每一层、每个节点上采样特征的比例。这些参数用于控制模型的复杂度。较小的值会增加模型的随机性,从而防止过拟合;较大的值则意味着每棵树使用更多的特征,可能导致过拟合。colsample_bytree:每棵树使用的特征比例(默认为 1.0)。colsample_bylevel:每一层使用的特征比例(默认为 1.0)。colsample_bynode:每个节点使用的特征比例(默认为 1.0)。
除了param字典提供的模型参数外,train函数还有几个参数也值得注意,它们也是模型的超参数。
num_boost_round:树的训练轮数,设置较小的learning_rate并增加训练轮数可以提高模型的稳定性。early_stopping_rounds:用于实现早期停止机制。当指定轮次的训练中,验证集上的损失函数不再减少时,训练会自动停止,避免过拟合。feval:设置用户自定义的评估函数,这种方式允许用户灵活地使用任何适合特定任务的评估指标,需要注意的是评估函数有两个参数,一个表示模型预测值(NumPy 的ndarray对象),一个是训练数据(XGBoost 的DMatrix对象);函数返回一个二元组(name, value),其中name是评估指标的名称,value是指标的值。obj:设置用户自定义的目标函数,目标函数用于计算每一步的梯度和二阶导数,从而指导模型的优化过程,有兴趣的读者可以自行研究。evals:用于指定一个或多个验证集,其值是包含一个或多个(data, label)元组的列表,每个元组代表一个评估数据集,数据集需要是DMatrix对象。在训练过程中,XGBoost 会在每一轮迭代后评估验证集上的性能,通常用于监控训练过程中的过拟合或调整超参数。eval_results:存储在训练过程中计算的所有评估结果,通常传入一个字典。verbose_eval:控制训练过程中评估结果的输出频率,可以设置为一个整数,表示多少轮迭代输出一次评估结果,也可以设置为True或False,表示每轮都输出或不输出任何评估结果。xgb_model:用于加载之前训练好的模型,以便从中断点继续训练。你可以指定一个xgb_model文件或者传入一个Booster对象。callbacks:在训练过程中添加自定义的回调函数,回调函数可以在每一轮迭代时提供额外的控制,如自动停止训练、调整学习。
LightGBM
LightGBM(Light Gradient Boosting Machine)是微软于2017年开源的一款顶级 Boosting 算法框架,虽然本质仍然是 GBDT 算法,但被设计用于大规模数据集的处理,特别是在需要高效率和低内存消耗的场景下。就 GBDT 系列算法性能而言,XGBoost 已经非常高效了,但并非没有缺陷。LightGBM 就是一种针对 XGBoost 缺陷的改进版本,通过直方图算法(通过将连续特征分箱)、单边梯度抽样(GOSS,通过采样方法在训练过程中保留梯度较大的样本,减少计算量)、互斥特征捆绑(EFB,将一些互斥特征做组合,减少特征空间的维度)和 leaf-wise 生长策略(优先对当前叶子节点进行分裂来扩展树的深度)四个方法,使得 GBDT 算法系统更轻便、更高效,能够做到又快又准。当然,在较小的数据集上,LightGBM 的优势并不明显,而且不管是 XGBoost 还是 LightGBM,模型的可解释性都是一个问题,超参数调优的难度也是比较大的。
这里,我们不再使用更多的篇幅去讲解 LightGBM 的细节,感兴趣的小伙伴可以直接访问 LightGBM 的官方文档。我们直接通过代码带大家简单感受一下如何使用 LightGBM,首先还是需要通过下面的命令完成安装。
pip install lightgbm我们仍然使用鸢尾花数据集来训练模型,代码如下所示。
import lightgbm as lgbimport numpy as npfrom sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import classification_report
# 加载和划分数据集iris = load_iris()X, y = iris.data, iris.targetX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)
# 将数据转化为 LightGBM 的数据格式train_data = lgb.Dataset(X_train, label=y_train)test_data = lgb.Dataset(X_test, label=y_test, reference=train_data)
# 设置模型参数params = { 'objective': 'multiclass', # 多分类问题 'num_class': 3, # 类别数量 'metric': 'multi_logloss', # 多分类对数损失函数 'boosting_type': 'gbdt', # 使用梯度提升树算法 'num_leaves': 31, # 叶子节点数 'learning_rate': 0.05, # 学习率 'feature_fraction': 0.75, # 每次训练时随机选择特征的比例 'early_stopping_rounds': 10 # 连续多少论没有性能提升就停止迭代}# 模型训练model = lgb.train(params=params, train_set=train_data, num_boost_round=200, valid_sets=[test_data])# 模型预测y_pred = model.predict(X_test, num_iteration=model.best_iteration)# 将预测结果处理成标签y_pred_max = np.argmax(y_pred, axis=1)
# 查看模型评估报告print(classification_report(y_test, y_pred_max))这里还是简单为大家讲讲模型的超参数,更多的细节大家可以参考官方文档。
objective:设置优化目标函数(损失函数),可选值有:'regression':回归任务。'binary':二分类任务。'multiclass':多分类任务。'multiclassova':多分类任务,使用一对多的策略。'rank_xendcg'、'lambdarank':排名任务。
metric:评估模型性能的指标,可选值有:'l2'、'mean_squared_error':回归任务中的均方误差。'binary_error':二分类错误率。'multi_logloss':多分类对数损失。'auc':二分类任务中的 AUC。'precision'、'recall'、'f1':精度、召回率、F1分数。
boosting_type:设置提升类型,可选值有:'gbdt':传统的梯度提升树。'dart':具有随机丢弃树机制来防止过拟合的决策树。'goss':通过单边梯度抽样来加速训练。'rf':随机森林。
num_leaves/max_depth:决策树的叶子节点数 / 决策树的最大深度,控制树的复杂度。lambda_l1/lambda_l2:L1 和 L2 正则化参数,用于控制模型的复杂度,防止过拟合。max_bin: 用于分割连续特征(数据分箱)的最大箱子数。feature_fraction:每次训练时随机选择特征的比例。early_stopping_rounds: 设置评估指标在连续多少轮迭代中没有改进时,训练会提前停止。
总结
集成学习通过结合多个模型来减少模型的偏差和方差,通常能获得比单一模型更好的预测效果。由于集成学习通常结合多个基础模型,它能够有效降低单一模型可能存在的过拟合问题,也能够处理异常数据和噪声数据,比单一模型更加稳定。当然,集成学习也存在计算开销大、模型可解释性差、超参数调优复杂等问题。除了 XGBoost 和 LightGBM 之外,还有一个因处理类别特征而闻名的 Boosting 算法叫做 CatBoost,三者都是 GBDT 系列算法的佼佼者。虽然目前“大力出奇迹”的深度学习大行其道,但是以 XGBoost、LightGBM 和 CatBoost 为代表的 Boosting 算法仍然有广阔的应用场景,即便是在非结构化数据(文本、语音、图像、视频)的建模上也是有用武之地的。
88 神经网络模型
在人类的大脑中,神经元(neuron)是负责信息传递和处理的单元,神经元通过化学信号和电信号进行交流,这是人类记忆、感觉、运动等功能的基础。神经元包含了轴突(axon)和树突(dendrite),树突负责接收信号,轴突负责发送信号,此外细胞体也是神经元的重要部分,起到整合和传递信息的作用。神经元之间的连接通过突触(synapse)传递化学信号或电信号来实现,一个神经元可能会与成千上万个神经元连接,构成错综复杂的神经网络。人在刚出生时,大脑中有约 860 亿神经元,大部分神经元是不会再生的,所以这个数字会随着年龄的增长而略为减少。新生儿的大脑拥有数量极其庞大的突触连接,为未来的学习和适应奠定基础。
很多科普文章都宣传神经网络模型是模拟人脑神经元的计算模型,通过多层神经元连接来完成复杂的非线性映射,但是没有证据表明大脑的学习机制与神经网络模型机制相同。虽然神经网络这个术语来自于神经生物学,深度学习中的一些概念也是从人类对大脑的理解中汲取灵感而形成的,但是对新手来说,如果认为神经网络与神经生物学存在某种联系,只会让人变得更加困惑。
基本构成
神经网络一般由多个层组成,通常包括输入层、隐藏层和输出层。每层中的神经元与前一层的神经元相连接,通过权重调整和激活函数的作用,逐层传递和处理数据,最终完成复杂数据的特征提取和学习。
- 输入层:输入层神经元接收输入数据,每个神经元通常对应一个输入特征。输入层的任务是将输入数据传递给下一层的神经元。
- 隐藏层:隐藏层是网络的核心部分,负责对数据进行特征提取和处理。隐藏层可以有一层或多层,每层的神经元通过权重和激活函数来进行数据处理。深度神经网络通常会包含多层隐藏层,这样能够提取数据中的高阶特征。
- 输出层:输出层负责将隐藏层的结果转换为最终输出。输出层的激活函数通常与问题类型有关,例如二分类任务可能用 Sigmoid 函数以获得概率,而回归任务则可能直接输出数值。
- 神经元:每个神经元都接收来自前一层神经元的输入,进行加权求和,再通过激活函数计算输出。
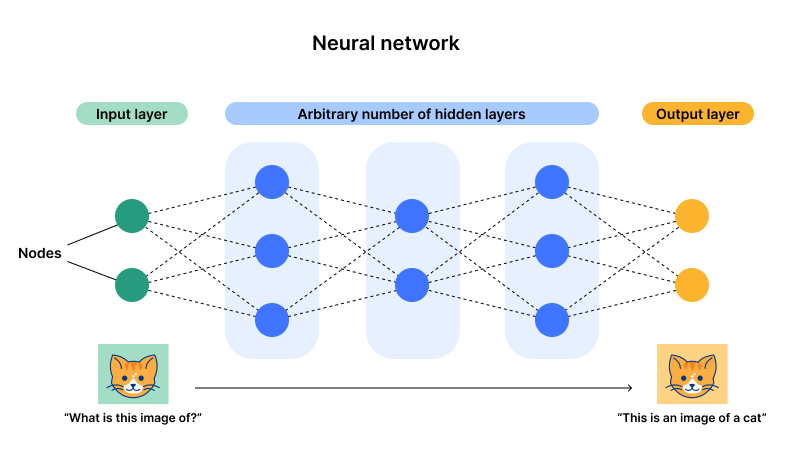
神经网络的训练过程通常通过反向传播算法(Backpropagation)和梯度下降法来优化权重,以减少预测误差。深度神经网络通过多层非线性转换能够学习到更加复杂的特征表示,因此在许多任务中表现优异。
工作原理
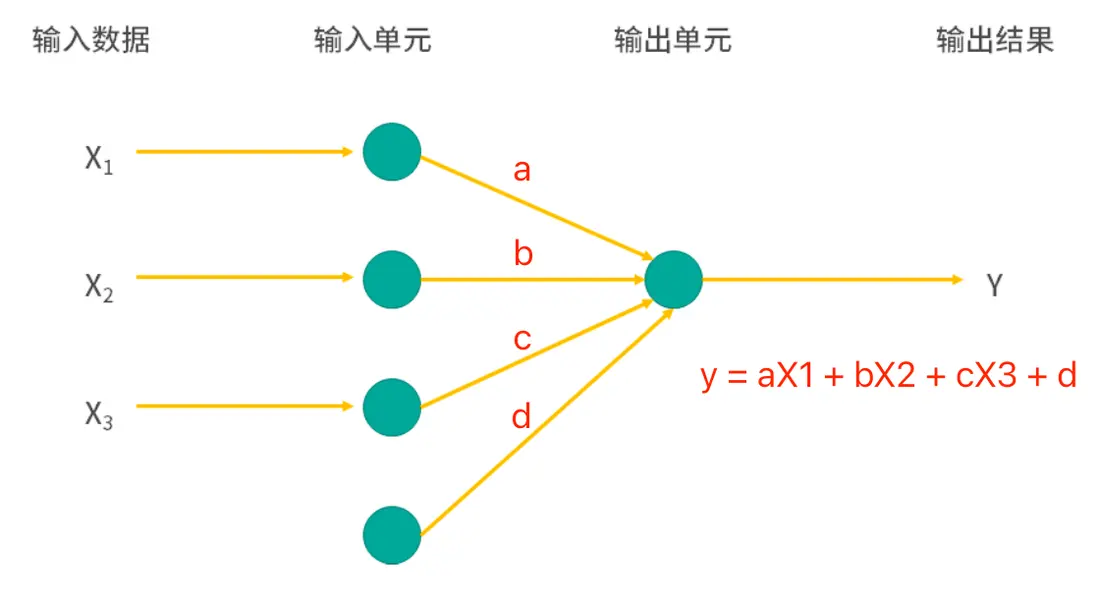
我们先设计一个最简单的神经网络模型,它只有一层输入和一层输出,该模型会根据输入( )去预测输出( ),而输出又满足下面的公式:
其中, 都是模型的参数(权重和偏置),那么我们的神经网络模型应该是如下图所示的结构。
大家可能已经发现,这个最简单的神经网络模型跟线性回归根本没有区别,但是我们在输入层和输出层中间再加上一个隐藏层又会怎样呢?看看下面的图,是不是已经有一点“网络”的味道了,加入的隐藏层可以处理非线性关系,而且隐藏层可以有多个,层与层之间连接的方式可以是全连接或部分连接,甚至可以出现环形结构。上面我们也说过,引入非线性能够让模型学习到更加复杂的特征表示,这也是神经网络模型在很多任务中表现优异的原因。
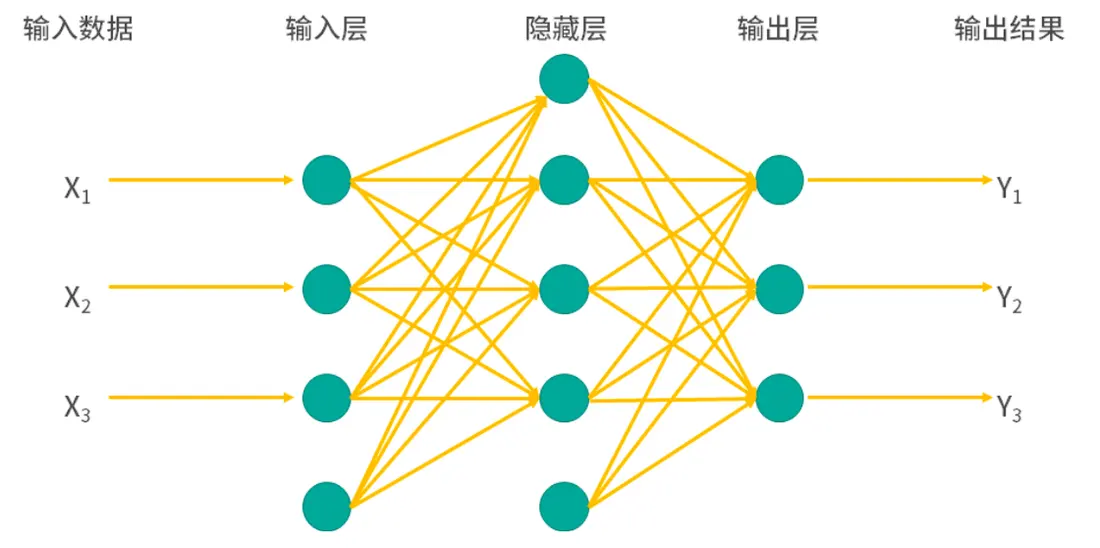
接下来,我们看看神经网络的工作原理。每个神经元的计算过程可以表示为:
其中, 是输入特征, 是与输入对应的权重; 是偏置项; 是激活函数,通常是非线性函数,如 Sigmoid、ReLU、Tanh 等。激活函数一个方面是引入非线性变换,增加了神经网络的表达能力,使得它可以模拟任意复杂的函数关系;另一方面,在训练神经网络时会使用反向传播来更新权重,激活函数的非线性属性使得梯度传递更有效,让神经网络收敛得更快,提高训练效率。下面我们对常用的激活函数做一个简要的介绍。
- Sigmoid 函数
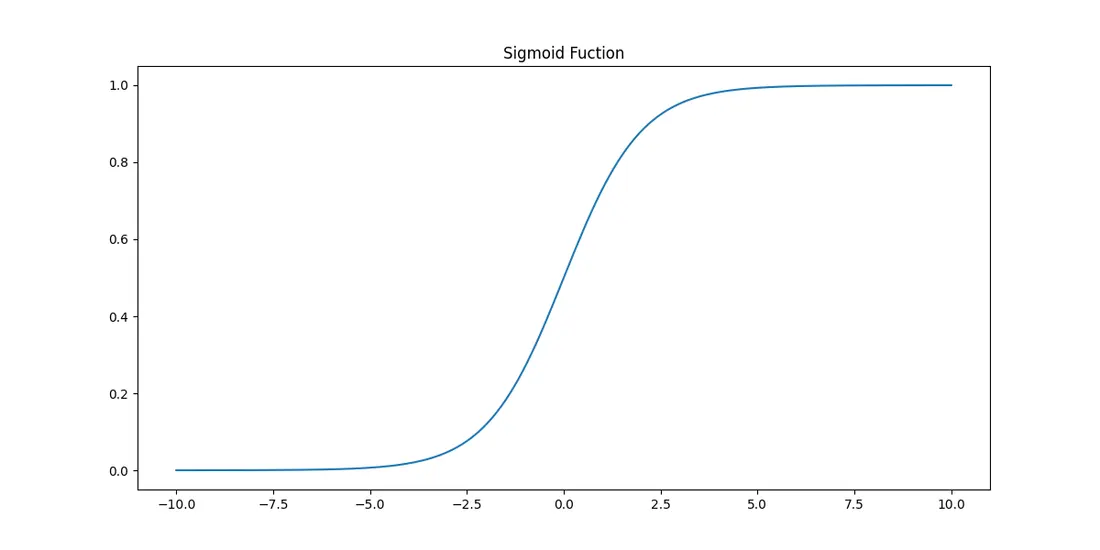
- 特点:Sigmoid 函数将输入值映射到 的范围内,呈现出平滑的 S 型曲线。
- 优点:特别适用于概率预测,因为输出在 之间,可以理解为概率值。
- 缺点:对于较大的正值或负值,梯度会变得很小,导致梯度消失问题,从而影响深层网络的训练。除此以外,由于输出非零中心,这会导致梯度更新不对称,可能使得收敛变慢。
- Tanh 函数(双曲正切函数)
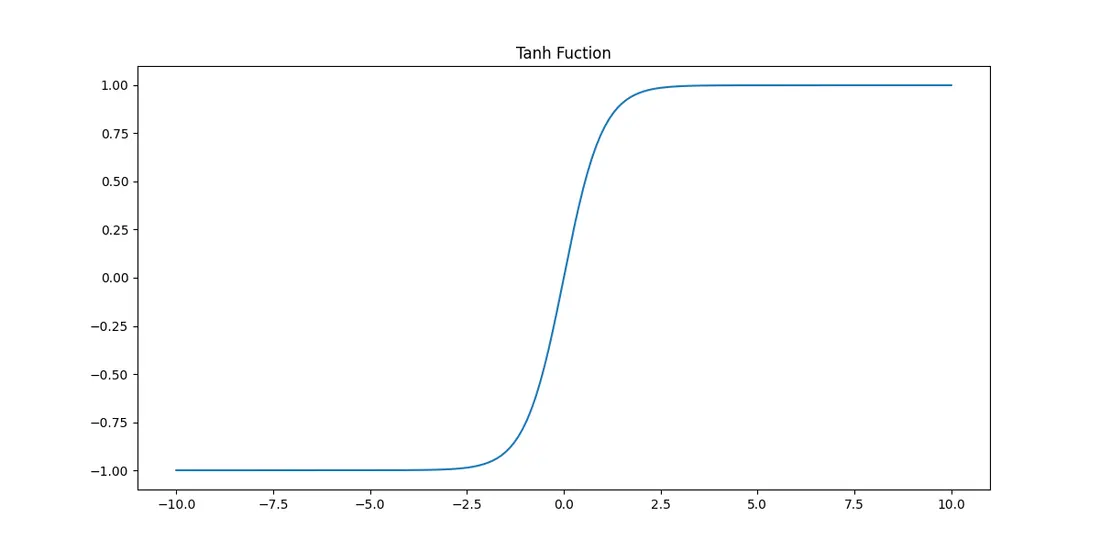
- 特点:Tanh 函数将输入映射到 的范围内,也是 S 型曲线,但中心对称。
- 优点:与 Sigmoid 类似,但输出在 之间,这样的零中心输出使得梯度更新更对称,更适合用于深层网络。
- 缺点:在极值附近,梯度仍会趋向于零,导致梯度消失问题。
- ReLU 函数(Rectified Linear Unit)
- 特点:ReLU 将输入小于零的部分设为零,而大于零的部分保持不变,因此其输出范围是 。
- 优点:计算简单,有效避免了梯度消失问题,因此被广泛应用于深层网络。能够保持稀疏性,许多神经元的输出为零,有利于网络简化计算。
- 缺点:当输入为负数时,ReLU 的梯度为零。若输入长期为负数,神经元可能“死亡”并停止更新。
- Leaky ReLU 函数
- 特点:Leaky ReLU 是对 ReLU 的改进,它为输入小于零的部分引入了一个小的负斜率(通常取值 ),使得梯度不为零。
- 优点:通过允许负值的输出,避免了死神经元问题,使得网络更健壮。
- 缺点:虽然 Leaky ReLU 能缓解死神经元问题,但其负值斜率的选择对网络性能会有一些影响,且对模型的非线性表示能力没有显著提升。
在一个包含多个层的神经网络中,信息会一层一层的进行传递。假设第 层的输出是 ,按照上面神经元计算公式,有:
其中, 是第 层的权重矩阵, 是是第 层的输出, 是第 层的偏置项, 是激活函数。神经网络最终的输出是通过最后一层的激活函数得到的,这个过程叫做前向传播(forward-propagation)。
对于神经网络模型来说,还有一个极其重要的操作就是通过计算损失函数相对于每个权重和偏置的梯度来更新神经网络的参数(权重和偏置),这一过程通常称为反向传播(back-propagation)。反向传播有两个要点,一个是损失函数,一个是梯度下降法,前者用于衡量预测值与真实值之间的差距,常用的损失函数有均方误差(回归任务)和交叉熵损失函数(分类任务),后者通过更新参数 (权重和偏置),使得损失函数最小化,即:
其中, 是学习率, 是损失函数相对于参数的梯度,跟我们讲解回归模型时使用的方法是一致的。
代码实现
根据上面讲到的神经网络模型的原理,要自己写一个简单的神经网络模型也并不困难。当然,我们也可以用 scikit-learn 库neural_network 模块来构建神经网络模型。下面,我们仍然以鸢尾花数据集为例,为大家展示神经网络模型的构建和预测效果。
from sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.neural_network import MLPClassifierfrom sklearn.metrics import classification_report
# 加载和划分数据集iris = load_iris()X, y = iris.data, iris.targetX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)
# 创建多层感知机分类器模型model = MLPClassifier( solver='lbfgs', # 优化模型参数的求解器 learning_rate='adaptive', # 学习率的调节方式为自适应 activation='relu', # 隐藏层中神经元的激活函数 hidden_layer_sizes=(1, ) # 每一层神经元的数量)# 训练和预测model.fit(X_train, y_train)y_pred = model.predict(X_test)
# 查看模型评估报告print(classification_report(y_test, y_pred))输出:
precision recall f1-score support
0 1.00 0.10 0.18 10 1 0.00 0.00 0.00 10 2 0.34 1.00 0.51 10
accuracy 0.37 30 macro avg 0.45 0.37 0.23 30weighted avg 0.45 0.37 0.23 30注意:由于创建
MLPClassifier时没有指定random_state参数,所以代码每次执行的结果可能并不相同。
模型的预测准确率只有0.37,大家对这个结果是不是感觉到非常失望,我们煞费苦心构建的模型预测效果竟然如此拉胯。别紧张,上面代码中我们创建神经网络模型时,hidden_layer_sizes参数设置的是(1, ),它表示我们的网络只有 1 个隐藏层,而且隐藏层只有 1 个神经元,这个神经元承受了太多(它真的,我哭死)。接下俩,我们需要增加隐藏层和神经元的数量,让模型可以更好的学习特征和目标之间的映射关系,这样预测的效果就会好起来。下面,我们将hidden_layer_sizes参数调整为(32, 32, 32),即模型有三个隐藏层,每层有 32 个神经元,再来看看代码执行的结果。
from sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.neural_network import MLPClassifierfrom sklearn.metrics import classification_report
# 加载和划分数据集iris = load_iris()X, y = iris.data, iris.targetX_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3)
# 创建多层感知机分类器模型model = MLPClassifier( solver='lbfgs', # 优化模型参数的求解器 learning_rate='adaptive', # 学习率的调节方式为自适应 activation='relu', # 隐藏层中神经元的激活函数 hidden_layer_sizes=(32, 32, 32) # 每一层神经元的数量)# 训练和预测model.fit(X_train, y_train)y_pred = model.predict(X_test)
# 查看模型评估报告print(classification_report(y_test, y_pred))说明:大家可以试着运行上面的代码,看看有没有获得更好的结果。当然,模型准确率为 1 也未必就值得高兴,因为你可能训练了一个过拟合的模型。无论如何,大家可以试着重新设置
hidden_layer_sizes参数,看看会得到怎样的结果。
下面,我们还是对MLPClassifier几个比较重要的超参数做一个说明。
hidden_layer_sizes:指定神经网络中每一层的神经元数目,元组类型,默认值为(100, ),表示只有一个隐藏层,包含 100 个神经元。该超参数可以改变网络的结构和容量,层数越多,神经元数目越多,模型的表示能力就越强,但也存在过拟合风险。activation:隐藏层中神经元的激活函数,默认值为relu,表示使用 ReLU 激活函数。激活函数决定了网络每一层的输出形态,一般来说,'relu'是训练深度网络时的首选,因为它能够缓解梯度消失问题,并且训练速度较快,可选值包括:'identity':线性激活函数,即 ,通常不推荐使用。'logistic'/'tanh'/'relu':Sigmoid / 双曲正切 / ReLU 激活函数。
solver:用来优化模型参数的求解器(优化算法)。常用的优化算法有:'lbfgs':拟牛顿法(Limited-memory Broyden-Fletcher-Goldfarb-Shanno),这种方法计算复杂度较高,但对小数据集表现较好。'sgd':随机梯度下降(Stochastic Gradient Descent),适用于大规模数据集,在训练时会随机选取小批量数据进行更新。'adam':自适应矩估计(Adaptive Moment Estimation),默认值,适用于大多数情况且计算效率较高。
alpha:L2 正则化项(也称为权重衰减),控制神经网络的复杂度,默认值为0.0001。batch_size:每次迭代所用的样本批量大小,默认值为'auto',根据样本数量自动决定批量大小。较小的批量会使训练更加不稳定,但有助于避免陷入局部最优解;较大的批量则可以加速训练,但可能导致内存不足。learning_rate:学习率的调节方式,影响模型在每次迭代时调整权重的步长,默认值为'constant',表示学习率保持不变。其他可选的值有'invscaling'和'adaptive',前者表示学习率随着迭代次数的增加而逐步减小,后者表示学习率会根据当前梯度变化自动调整,当梯度更新较小时学习率会增加,当梯度较大时学习率会减小。learning_rate_init:初始学习率,默认值为0.001。max_iter:最大迭代次数,控制训练过程中优化算法的最大迭代次数,默认值为200。若达到最大迭代次数后模型仍未收敛,训练将停止。这对于防止过长时间训练是有用的,但过小的值可能会导致训练中止太早,导致欠拟合。tol:训练过程中的优化容忍度,决定了当目标函数变化小于该值时训练停止,默认值为0.0001。较小的tol会导致更长的训练时间,较大的tol可能会提前停止训练。
除了 scikit-learn 库,我们还可以使用 TensorFlow、PyTorch、MXNet 等三方库来实现神经网络模型,这些库很多都支持 GPU(图形处理单元) 或 TPU(张量处理单元) 加速,而且内置很多深度网络模型(如卷积神经网络、循环神经网络、生成对抗网络等)以及相应的优化器,相较于 scikit-learn,这些库可能是更好的选择。对此感兴趣的小伙伴,可以看看下面的代码,我们用 PyTorch 构建了神经网络模型来解决鸢尾花分类问题。
import torchimport torch.nn as nnimport torch.optim as optimfrom sklearn import datasetsfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalerfrom sklearn.metrics import accuracy_score, classification_report
# 加载鸢尾花数据集iris = datasets.load_iris()X, y = iris.data, iris.target
# 数据预处理(标准化)scaler = StandardScaler()X_scaled = scaler.fit_transform(X)
# 划分训练集和测试集X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, train_size=0.8, random_state=3)# 将数组转换为PyTorch张量X_train_tensor, X_test_tensor, y_train_tensor, y_test_tensor = ( torch.tensor(X_train, dtype=torch.float32), torch.tensor(X_test, dtype=torch.float32), torch.tensor(y_train, dtype=torch.long), torch.tensor(y_test, dtype=torch.long))
class IrisNN(nn.Module): """鸢尾花神经网络模型"""
def __init__(self): """初始化方法""" # 调用父类构造器 super(IrisNN, self).__init__() # 输入层到隐藏层(4个特征到32个神经元全连接) self.fc1 = nn.Linear(4, 32) # 隐藏层到输出层(32个神经元到3个输出全连接) self.fc2 = nn.Linear(32, 3)
def forward(self, x): """前向传播""" # 隐藏层使用ReLU激活函数 x = torch.relu(self.fc1(x)) x = self.fc2(x) return x
# 创建模型实例model = IrisNN()# 定义损失函数(交叉熵损失函数)loss_function = nn.CrossEntropyLoss()# 使用Adam优化器(大多数任务表现较好)optimizer = optim.Adam(model.parameters(), lr=0.001)
# 训练模型(迭代256个轮次)for _ in range(256): model.train() # 清除上一次的梯度 optimizer.zero_grad() # 计算输出 output = model(X_train_tensor) # 计算损失 loss = loss_function(output, y_train_tensor) # 反向传播 loss.backward() # 更新权重 optimizer.step()
# 评估模型model.eval()with torch.no_grad(): output = model(X_test_tensor) # 获取预测得分最大值的索引(预测标签) _, y_pred_tensor = torch.max(output, 1) # 计算并输出预测准确率 print(f'Accuracy: {accuracy_score(y_test_tensor, y_pred_tensor):.2%}') # 输出分类模型评估报告 print(classification_report(y_test_tensor, y_pred_tensor))说明:如果还没有安装 PyTorch 库,可以使用命令
pip install torch进行安装。
我们也可以通过神经网络模型来处理回归任务,这里仍然以之前讲回归模型时使用过的“汽车 MPG 数据集”为例,演示如何通过构造神经网络模型解决回归任务,完整的代码如下所示。
import ssl
import pandas as pdimport torchimport torch.nn as nnimport torch.optim as optimfrom sklearn.metrics import mean_squared_error, r2_scorefrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScaler
ssl._create_default_https_context = ssl._create_unverified_context
def load_prep_data(): """加载准备数据""" df = pd.read_csv('https://archive.ics.uci.edu/static/public/9/data.csv') # 对特征进行清洗 df.drop(columns=['car_name'], inplace=True) df.dropna(inplace=True) df['origin'] = df['origin'].astype('category') df = pd.get_dummies(df, columns=['origin'], drop_first=True).astype('f8') # 对特征进行缩放 scaler = StandardScaler() return scaler.fit_transform(df.drop(columns='mpg').values), df['mpg'].values
class MLPRegressor(nn.Module): """神经网络模型"""
def __init__(self, n): super(MLPRegressor, self).__init__() self.fc1 = nn.Linear(n, 64) self.fc2 = nn.Linear(64, 64) self.fc3 = nn.Linear(64, 1)
def forward(self, x): x = torch.relu(self.fc1(x)) x = torch.relu(self.fc2(x)) x = self.fc3(x) return x
def main(): # 加载和准备数据集 X, y = load_prep_data() # 划分训练集和测试集 X_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=3) # 将数据转为PyTorch的Tensor X_train_tensor, X_test_tensor, y_train_tensor, y_test_tensor = ( torch.tensor(X_train, dtype=torch.float32), torch.tensor(X_test, dtype=torch.float32), torch.tensor(y_train, dtype=torch.float32).view(-1, 1), torch.tensor(y_test, dtype=torch.float32).view(-1, 1) )
# 实例化神经网络模型 model = MLPRegressor(X_train.shape[1]) # 指定损失函数(均方误差) criterion = nn.MSELoss() # 指定优化器(Adam优化器) optimizer = optim.Adam(model.parameters(), lr=0.001)
# 模型训练 epochs = 256 for epoch in range(epochs): # 前向传播 y_pred_tensor = model(X_train_tensor) loss = criterion(y_pred_tensor, y_train_tensor) # 反向传播 optimizer.zero_grad() loss.backward() optimizer.step()
if (epoch + 1) % 16 == 0: print(f'Epoch [{epoch + 1} / {epochs}], Loss: {loss.item():.4f}')
# 模型评估 model.eval() with torch.no_grad(): y_pred = model(X_test_tensor) test_loss = mean_squared_error(y_test, y_pred.numpy()) r2 = r2_score(y_test, y_pred.numpy()) print(f'Test MSE: {test_loss:.4f}') print(f'Test R2: {r2:.4f}')
if __name__ == '__main__': main()输出:
Epoch [16 / 256], Loss: 588.2971Epoch [32 / 256], Loss: 530.0340Epoch [48 / 256], Loss: 429.9081Epoch [64 / 256], Loss: 286.5121Epoch [80 / 256], Loss: 133.6717Epoch [96 / 256], Loss: 44.3843Epoch [112 / 256], Loss: 30.3168Epoch [128 / 256], Loss: 24.0182Epoch [144 / 256], Loss: 19.5326Epoch [160 / 256], Loss: 16.4941Epoch [176 / 256], Loss: 14.2642Epoch [192 / 256], Loss: 12.5515Epoch [208 / 256], Loss: 11.2248Epoch [224 / 256], Loss: 10.1825Epoch [240 / 256], Loss: 9.3600Epoch [256 / 256], Loss: 8.7116Test MSE: 8.7226Test R2: 0.8569通过上面的输出可以看到,随着神经网络模型不断的前向传播和反向传播,损失变得越来越小,模型的拟合变得越来越好。在预测的时候,我们利用训练得到的模型参数进行一次正向传播,就完成了从特征到目标值的映射,评估回归模型的两个指标 MSE 和 看起来还不错哟。目前,神经网络被广泛应用于模式识别、图像处理、语音识别等领域,是深度学习中最核心的技术。对深度学习有兴趣的读者,可以关注我的另一个项目“深度学习就是大力出奇迹”,目前该项目仍然在创作更新中。
模型优缺点
神经网络模型最可爱的一点就是可以像搭积木一样不断的扩展模型边界,对于模型内部具体的运行则不需要加以太多的干涉。神经网络能够学习和拟合非常复杂的映射关系,能够根据输入数据自动调整其结构和参数,因此具有较强的适应性。当面临不同类型的数据或任务时,神经网络可以通过调整网络的结构(层数、节点数等)来适应不同的需求,只要数据量足够大、算力足够强,最终都会得到一个不错的结果,表现常常优于传统的机器学习算法,这就是我们常说的“大力出奇迹”。此外,大家耳熟能详的深度学习一词中的“深度”二字,指的就是神经网络模型的层次具备了足够的深度,我们也通常把这样的神经网络称为深度神经网络(DNN)。
神经网络模型就像一个黑盒子,你给它数据它告诉你结果,至于为什么会出现这样的结果却缺乏可解释性。所以,在很多对模型的解释性要求非常高的场景(如信用评级、金融风控等),我们可能没有办法使用神经网络模型。再者,神经网络特别是深度神经网络需要大量的计算资源来训练,尤其是在处理高维数据时,训练时间和所需的计算资源可能非常庞大,需要强大的硬件支持,如高性能的图形处理单元(GPU)或专用硬件(TPU)。最后,也是我个人觉得神经网络模型最坑的一点是超参数调优过于困难,网络的层数、每层神经元的数量、学习率、激活函数的选择等都可能影响模型的性能,如果没有强大的计算资源作为支撑,很难完成超参数的调优,个人和小公司基本就被劝退了。
总结
神经网络模型使用了与传统机器学习算法不同的方式从海量数据中学习知识,尽管模型缺乏可解释性,但不能否认它在图像、语音和自然语言处理等多个领域已经取得了显著的成绩。当然,训练神经网络模型需要消耗大量的资源,在应用神经网络模型时建议权衡其优缺点,并根据具体的任务需求选择合适的模型和训练方法。对于那些数据量较小、需要可解释性或计算资源有限的场景,我们建议考虑使用传统的机器学习算法或者其他更轻量级的模型。
89 自然语言处理入门
自然语言处理(Natural Language Processing,NLP)是计算机科学和人工智能领域中的一个重要分支,旨在使计算机能够理解、生成和与人类语言进行交互。NLP 的应用场景广泛,包括文本分类、情感分析、机器翻译、语音识别、聊天机器人等。随着深度学习的迅猛发展,NLP 的研究也逐渐由传统的机器学习方法转向深度学习方法。经典的 NLP 方法依赖于特征工程和模型设计,而现代的深度学习方法则更多地依赖于数据驱动和自动特征学习。
词袋模型
词袋模型(Bag of Words)是 NLP 中最简单的文本表示方法之一,它将文本中的每个单词看作一个“词袋”,忽略了单词的顺序和语法,只考虑每个单词出现的频率。简单来说,词袋模型通过将文本转换为词频向量(TF)来表示文本。构造词袋模型有两个非常简单的步骤:
- 构建词汇表:首先扫描所有文档,列出文本中所有的单词(重复的单词只保留一项),形成一个词汇表。
- 文本向量化:将每个文档中的单词映射到词汇表中,并统计每个单词的出现次数,形成文档的向量表示。
例如,有三个文档分别是:
I love programming.I love machine learning.I love apple.
那么,构造词汇表将得到:['I', 'love', 'programming', 'machine', 'learning', 'apple']。然后,将每个文档转换为词频向量,分别是:
[1, 1, 1, 0, 0, 0][1, 1, 0, 1, 1, 0][1, 1, 0, 0, 0, 1]
Scikit-learn 库提供了构建词词袋模型的类CountVectorizer,使用的方法如下所示。
from sklearn.feature_extraction.text import CountVectorizer
# 文档列表documents = [ 'I love programming.', 'I love machine learning.', 'I love apple.']
# 创建词袋模型cv = CountVectorizer()X = cv.fit_transform(documents)
# 输出词汇表和词频向量print('词汇表:\n', cv.get_feature_names_out())print('词频向量:\n', X.toarray())输出:
词汇表: ['apple' 'learning' 'love' 'machine' 'programming']词频向量:[[0 0 1 0 1] [0 1 1 1 0] [1 0 1 0 0]]注意:上面的词汇表中没有单词
'I',因为这个单词被认为是停用词而忽略不计了。所谓停用词通常是指特定语言中高频出现但对文本分析任务贡献较小的词语。
对于中文文档,需要利用三方库jieba进行中文分词处理,先将句子拆分为词,然后再构造词频向量,代码如下所示。
import jiebafrom sklearn.feature_extraction.text import CountVectorizer
# 文档列表documents = [ '我在四川大学读书', '四川大学是四川最好的大学', '大学校园里面有很多学生',]
# 创建词袋模型并指定分词函数cv = CountVectorizer( tokenizer=lambda x: jieba.cut(x), token_pattern=None)X = cv.fit_transform(documents)
# 输出词汇表和词频向量print('词汇表:\n', cv.get_feature_names_out())print('词频向量:\n', X.toarray())说明:如果尚未安装中文分词库,可以通过命令
pip install jieba进行安装。
输出:
词汇表: ['四川' '四川大学' '在' '大学' '大学校园' '学生' '很多' '我' '是' '最好' '有' '的' '读书' '里面']词频向量: [[0 1 1 0 0 0 0 1 0 0 0 0 1 0] [1 1 0 1 0 0 0 0 1 1 0 1 0 0] [0 0 0 0 1 1 1 0 0 0 1 0 0 1]]如果想去掉中文中常见的停用词,可以在创建CountVectorizer对象时指定stop_words参数,我们可以从中文停用词文件中加载停用词清单,代码如下所示。
import jiebafrom sklearn.feature_extraction.text import CountVectorizer
with open('哈工大停用词表.txt') as file_obj: stop_words_list = file_obj.read().split('\n')
# 文档列表documents = [ '我在四川大学读书', '四川大学是四川最好的大学', '大学校园里面有很多学生',]
# 创建词袋模型并指定分词函数cv = CountVectorizer( tokenizer=lambda x: jieba.lcut(x), token_pattern=None, stop_words=stop_words_list)X = cv.fit_transform(documents)
# 输出词汇表和词频向量print('词汇表:\n', cv.get_feature_names_out())print('词频向量:\n', X.toarray())说明:上面用到的中文停用词文件可以点击传送门获得。
输出:
词汇表: ['四川' '四川大学' '大学' '大学校园' '学生' '很多' '最好' '读书' '里面']词频向量: [[0 1 0 0 0 0 0 1 0] [1 1 1 0 0 0 1 0 0] [0 0 0 1 1 1 0 0 1]]词向量
与词袋模型不同,词向量(Word Embedding)将每个单词映射到一个稠密的向量空间中,从而使计算机能够理解和处理文本数据。这些向量通过捕捉单词之间的语义和上下文关系,可以让模型更好地进行词义匹配和语义分析。例如,单词'king'和'queen'之间的关系、单词'cat'和'dog'之间的关系等在向量空间中应当有所体现。
常见的词向量模型有:
- Word2Vec:通过浅层神经网络训练来学习词向量,分为两种架构:CBOW (Continuous Bag Of Words)和 Skip-Gram。
- CBOW 模型的核心思想是:给定一个上下文词汇,预测中心词,即通过上下文中的词汇来预测目标词汇,上下文的顺序不重要,因为词袋是一个集合,而集合没有顺序的概念。假设你有一个句子”The cat sits on the mat.”,如果目标是预测 “sits” 这个词,那么 CBOW 会使用上下文词汇”The”、“cat”、“on”、“the”、“mat”来预测”sits”。在训练过程中,CBOW 会根据上下文中的词来调整 “sits” 的词向量,使得在上下文环境下该词能够更准确地表示语义。通过这种方式,CBOW 学习到的是一个词汇的上下文相关的表示。
- 与 CBOW 相反,Skip-Gram 模型的核心思想是:给定一个目标词,预测该词的上下文词汇。即通过一个中心词来预测其周围的词汇。假设我们还是以句子”The cat sits on the mat.”为例,目标词是”sits”。在 Skip-Gram 模型中,系统会用”sits”来预测它的上下文词汇,即”The”、“cat”、“on”、“the”、“mat”。Skip-Gram 模型会通过训练,使得”sits”的词向量能最大化其在训练数据中与上下文词的关联度。
- GloVe:基于词频矩阵的分解,能够捕捉到词汇的全局统计信息,由斯坦福大学的研究团队在2014年提出。GloVe 的词向量可以用于多种自然语言处理任务,如文本分类、情感分析、机器翻译等。它为后续的深度学习模型提供了有效的输入特征。
下面,我们简单讲一下词向量学习的基本思路,主要有三个核心要素:
-
输入和目标:假设我们使用 Word2Vec 模型(CBOW 或 Skip-Gram),目标是通过一个单词(中心词)或上下文词来学习词向量。在 Skip-Gram 中,给定一个单词,目标是预测其上下文中的单词;在 CBOW 中,给定上下文单词,目标是预测中心词。
-
神经网络模型:Word2Vec 通过一个简单的神经网络来学习词向量,输入层是每个单词对应的独热编码;隐藏层是一个低维的稠密向量(即词向量),它在训练过程中通过反向传播逐渐优化;输出层是目标单词的概率分布,如下图所示。
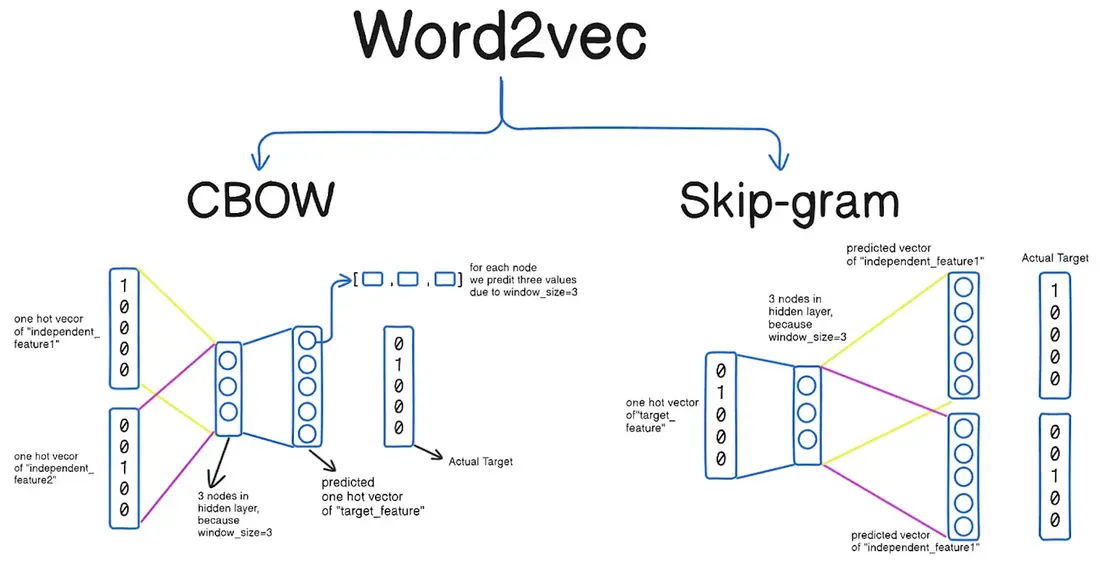
-
训练过程:通过上下文和目标单词的共现信息,模型根据每个单词的上下文调整词向量,使得语义上相似的词向量距离更近。训练过程中,神经网络通过最小化误差(即预测的词与实际词之间的差距)来调整词向量,使得能够准确预测词汇之间的联系。
词向量的维度通常是一个超参数,需要根据实际情况来选择。通常,常见的维度范围为 50 到 300 之间,但有时可以更高或更低。较低的维度可能无法捕捉到词汇的丰富语义信息,但会减少计算复杂度,适用于训练数据比较少或对精度要求不高的场景;较高的维度可以捕捉更多的语义特征,适用于大规模数据集,但计算成本也会增加。
一旦词向量被训练出来,它们就能捕捉到词汇之间的多种关系。最常见的方式是通过计算词向量之间的距离或相似度来理解它们的关系。计算两个词向量之间的余弦相似度是最常用的方式,余弦相似度的公式我们之前提到过,如下所示。
其中, 和 是两个词的词向量, 是向量的点积运算, 和 是它们的模长。余弦相似度的值介于 -1 到 1 之间,值越大表示两个词越相似,越小则表示越不相似。
另一方面,我们可以研究词向量的空间关系并完成一些有趣的运算。例如,如果我们想知道'king'(国王)和'queen'(王后)之间的关系,可以通过这样的方式来探索:
这个式子表示,'king'去掉'man'(男人)的部分,再加上'woman'(女人)的部分,得到的结果约等于'queen'。这样的运算可以捕捉到性别上的相似性。此外,利用词向量我们还可以进行聚类分析、词义消歧(通过上下文和相似度判断词在特定场景中的意思)、文本分类、情感分析等操作。
我们用下面的代码为大家展示词向量的构建以及词与词相似性的度量,这里需要安装一个名为gensim的三方库。
pip install gensim此外,我们还需要提前加载训练模型的语料库,这里我用的是 Hugging Face 提供了的 datasets 库,通过它能够加载多种公开数据集,包括一些常用的语料库。当然,你也可以选择像nltk这样专门用于自然语言处理的工具包来下载语料库。如果还没有安装datasets库,需要使用下面的命令进行安装。
pip install datasets我们先加载 IMDB 数据集,它是一个广泛使用的文本分类数据集,尤其在情感分析和自然语言处理领域中。IMDB 数据集包含大量电影评论,标注了每条评论的情感倾向(这里我们暂时用不到)。IMDB 数据集通常包含 50000 条评论,其中 25000 条用于训练,25000 条用于测试。每条评论都是观众对电影的评价,内容有长有短,我们就用它来作为训练模型的语料库。
import re
from datasets import load_datasetfrom gensim.models import Word2Vecfrom sklearn.metrics.pairwise import cosine_similarity
# 加载 IMDB 数据集imdb = load_dataset('imdb')# 直接将 50000 条评论用作语料temp = [imdb['unsupervised'][i]['text'] for i in range(50000)]# 用正则表达式对评论文本进行简单处理corpus = [re.sub(r'[^\w\s]', '', x) for x in temp]
# 预处理语料库(英文分词)sentences = [sentence.lower().split() for sentence in corpus]# 训练 Word2Vec 模型# sentences - 输入语料库(句子构成的列表,每个句子是一个或多个单词的列表)# vector_size - 词向量的维度(维度越高能够表示的信息越多)# windows - 上下文窗口大小(模型在训练时使用的上下文单词的范围)# min_count - 忽略频率低于此值的单词(过滤掉在语料库中出现次数较少的单词)# workers - 训练时使用的 CPU 核心数量# seed - 随机数种子(用于初始化模型的权重)model = Word2Vec(sentences, vector_size=100, window=10, min_count=2, workers=4, seed=3)
# 通过模型获取 king 和 queen 的词向量king_vec, queen_vec = model.wv['king'], model.wv['queen']
# 计算两个词向量的余弦相似度cos_similarity = cosine_similarity([king_vec], [queen_vec])print(f'king 和 queen 的余弦相似度: {cos_similarity[0, 0]:.2f}')
# 通过词向量进行推理(king - man + woman ≈ queen)man_vec, woman_vec = model.wv['man'], model.wv['woman']result_vec = king_vec - man_vec + woman_vec# 查找与计算结果最相似的三个词similar_words = model.wv.similar_by_vector(result_vec, topn=3)print(f'跟 king - man + woman 最相似的词:\n {similar_words}')
# 查找与 dog 最相似的五个词dog_similar_words = model.wv.most_similar('dog', topn=5)print(f'跟 dog 最相似的词:\n {dog_similar_words}')输出:
king 和 queen 的余弦相似度: 0.43跟 king - man + woman 最相似的词: [('queen', 0.7126370668411255), ('princess', 0.6760246753692627), ('mary', 0.5891180038452148)]跟 dog 最相似的词: [('cat', 0.7801533937454224), ('sheep', 0.6783771514892578), ('pet', 0.6658452749252319), ('doll', 0.655034065246582), ('dude', 0.6548768877983093)]从代码的输出可以看出,跟'king' - 'man' + 'woman'最相似的词就是'queen'和'princess'(公主、王妃),另外一个单词是女孩子的名字。跟'dog'(狗)最相似的单词有:'cat'(猫)、'sheep'(绵羊)、'pet'(宠物)、'doll'(玩偶)和'dude'(家伙)。
NPLM和RNN
Word2Vec 虽然已经帮助我们掌握了词与词之间的联系,但是由于无法捕捉长距离依赖(超出上下文窗口的词汇)和无法处理未知词(训练中没有出现的词汇)等问题,无法让 NLP 在具体的下游任务中实现突破和应用落地。随着对 Word2Vec 局限性的认识,研究者提出了 NPLM(神经网络语言模型),采用神经网络结构来预测单词序列中的下一个词。与传统的语言模型不同,NPLM 通过神经网络(通常是前馈神经网络)来处理整个单词序列,而不仅仅是局部的上下文信息,从而能够建模更为复杂的语言结构,其结构如下图所示。
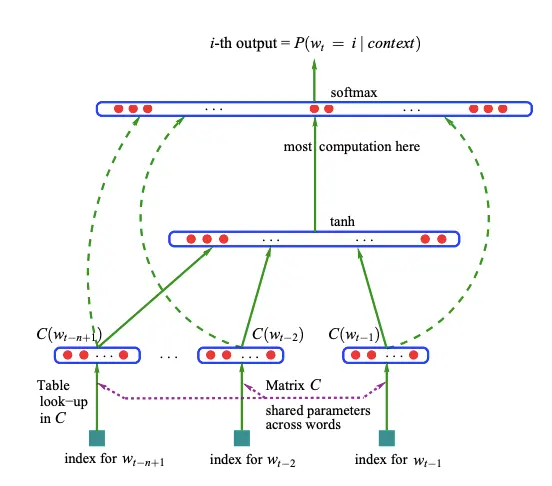
当然,NPLM 模型也存在无法有效捕捉长期依赖关系的问题,为此,研究者又提出了 RNN(循环神经网络)模型。RNN 是一种能够处理序列数据的神经网络,它的关键特性是能够将前一时刻的隐藏状态传递到下一时刻,从而在时间维度上建立联系。RNN 在训练时能够捕捉文本中的时序依赖关系,并且不局限于固定长度的上下文窗口。RNN 在每个时间步依赖于当前输入和上一时刻的隐藏状态,能够有效捕捉序列数据中的时间依赖性,通过反向传播算法更新权重,如下图所示。
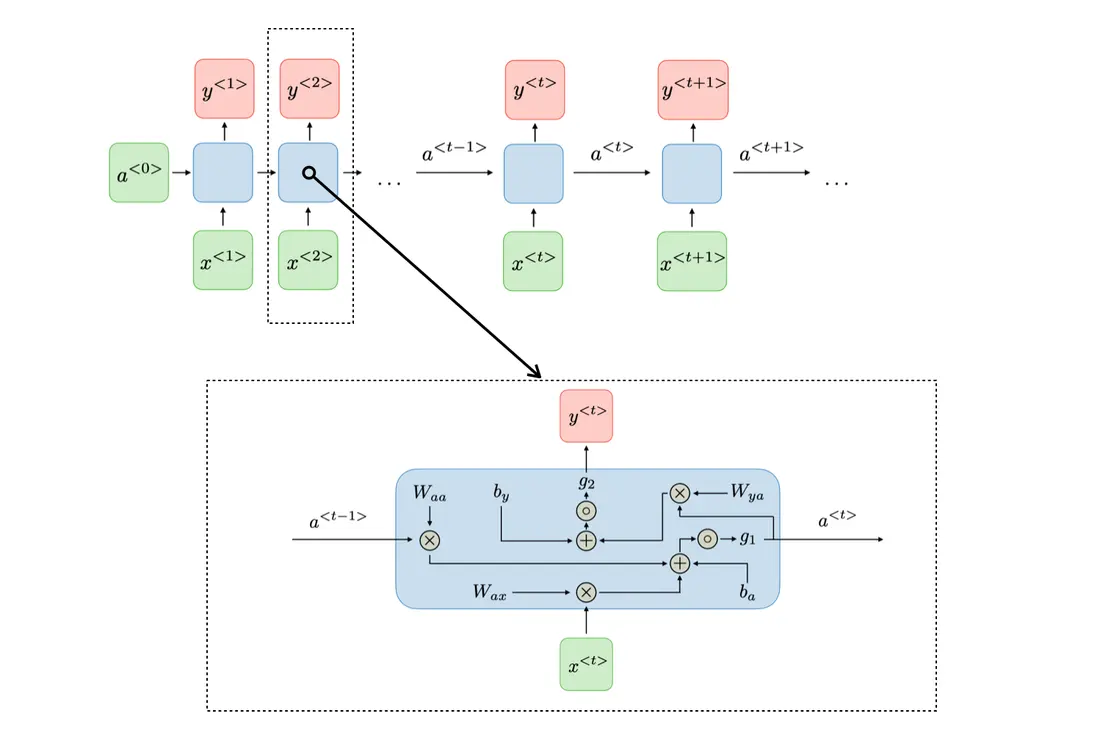
为了解决传统 RNN 中的梯度消失和梯度爆炸问题,研究人员又提出了长短期记忆(LSTM) 和门控循环单元(GRU)等改进算法。LSTM 和 GRU 都引入了门控机制,允许模型控制信息的流动和遗忘,从而有效防止了梯度消失问题,可以捕捉长时间序列的依赖关系。但是,LSTM 和 GRU 仍然存在计算效率低、训练速度慢的问题,且无法进行并行化训练的问题。
Seq2Seq
起初,研究人员尝试用一个独立的 RNN 来解决机器翻译、文本摘要、语音识别等 NLP 任务,但是发现效果并不理想。主要原因是 RNN 在同时处理输入和输出序列时,既要负责编码又要负责解码,所以很容易出现信息损失。后来,谷歌提出了 Seq2Seq 模型,核心思想是通过学习输入与输出序列之间的映射关系,从而实现序列到序列的转换。Seq2Seq 模型通常包含一个编码器和一个解码器,编码器通常由 RNN 或其变体构成(LSTM、GRU等)构成,其主要任务是读取输入序列并将其转换成上下文向量,上下文向量包含了整个输入序列的语义信息,并作为解码器生成输出的基础;解码器通常也是由 RNN 或其变体构成,其主要任务是根据上下文向量生成目标序列。Seq2Seq 模型的结构如下图所示。
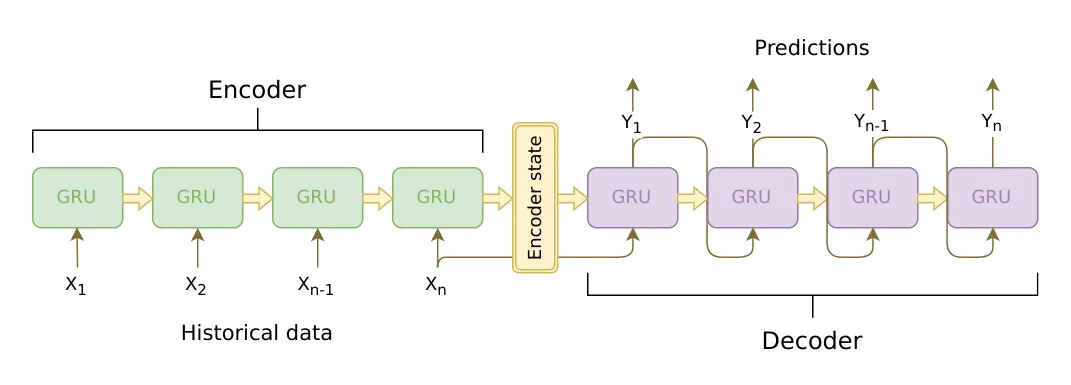
简单的 Seq2Seq 模型将整个输入序列的信息压缩到一个固定大小的上下文向量中,这可能导致信息丢失,尤其是在处理长序列时。注意力机制是 Seq2Seq 模型的一个重要扩展,通过在每个解码步骤中动态的对编码器输出的不同部分进行加权求和,允许解码器在生成每个词时能够关注输入序列中的相关部分。这样,模型能够根据当前的解码需求自动“聚焦”在输入的某个子部分,而不是依赖于一个固定大小的上下文向量。
Transformer
为了进一步克服 LSTM、GRU 等模型在长序列建模中的局限,2017 年谷歌大脑(Google Brain)团队的 Vaswani 等人在其论文 Attention Is All You Need 中提出了 Transformer 架构,这个架构迅速成为 NLP 领域的主流方法,彻底改变了这个领域的生态,大名鼎鼎的 GPT 和 BERT 都是基于 Transformer 架构的。Transformer 的核心是自注意力机制(Self-Attention),它能够为输入序列中的每个元素分配不同的权重,从而更好的捕捉序列内部的依赖关系。此外,Transformer 摒弃了 RNN 和 LSTM 中的循环结构,采用了全新的编码器-解码器架构,这种设计使得模型可以并行处理输入数据,进一步加速训练的过程。除了 NLP 领域,Transformer 在计算机视觉、语音识别等领域也取得了显著的成果。
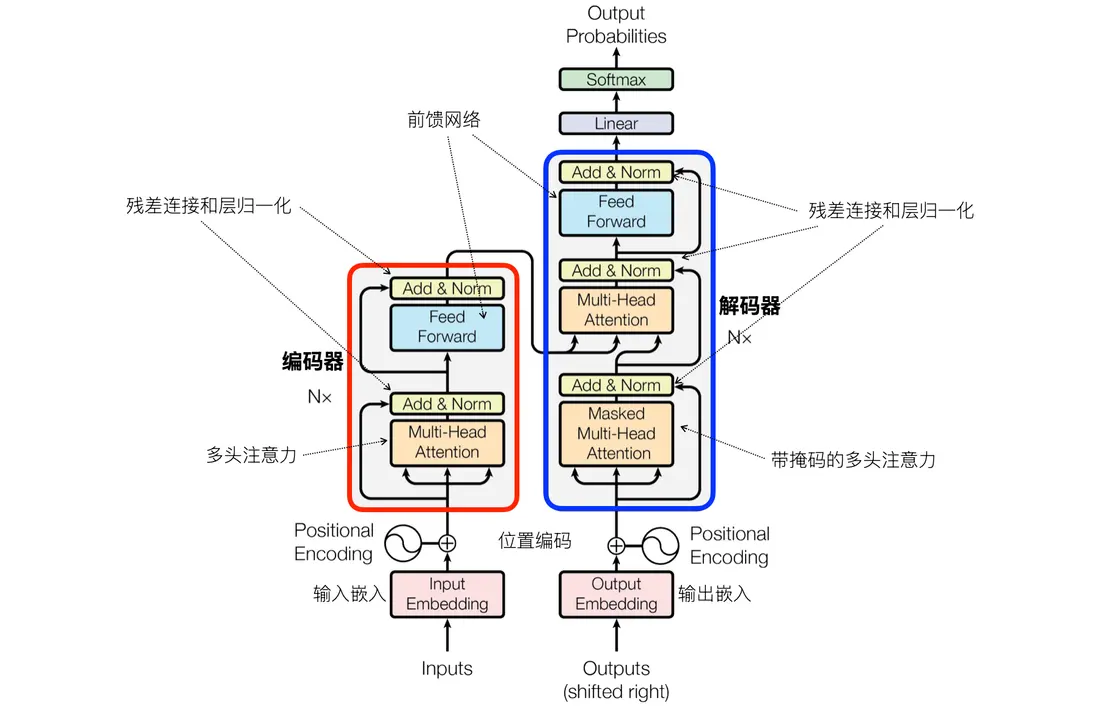
Transformer 架构如上图所示,它也是一个编码器-解码器结构,图左边部分红框中是堆叠的 N 组编码器,右边部分蓝框中是堆叠的 N 组解码器。编码器负责处理输入序列并将其转化为一个上下文相关的表示,解码器则根据编码器的输出生成目标序列(例如翻译任务中的目标语言)。下面,我们先简单说一下编码器和解码器的构成。
- 编码器:每个编码器都包括多头注意力机制、前馈神经网络、残差连接和层归一化。
- 解码器:解码器结构类似编码器,但在自注意力层和编码器-解码器注意力层之间引入了额外的层,以便处理编码器输出的上下文信息。
我们再来展开说说 Transformer 的核心组件,如下所示。
-
嵌入层(输入嵌入和输出嵌入):与传统的词向量方法(如 Word2Vec 或 GloVe)类似,Transformer 的输入首先需要通过词嵌入层将离散的单词映射为稠密的向量。
-
位置编码:由于 Transformer 不像 RNN 或 LSTM 那样处理序列中的时序信息,因此需要通过位置编码(Positional Encoding)来注入词序信息。位置编码的形式通常是一个与词嵌入大小相同的向量,每个维度编码了该词在序列中的位置信息。常见的做法是使用正弦和余弦函数来构造这些位置编码。
-
自注意力机制:允许模型在每个时间步根据输入序列中的所有其他词来计算每个词的表示。这样每个词都能关注到序列中其他位置的信息,而不依赖于输入的顺序。自注意力机制的原理是:对每个输入的词,通过嵌入层计算三个向量,分别是:查询向量(Q)、键向量(K)、值向量(V)。
-
查询向量:用来查询其他词信息的向量,它代表我们关注的内容,每个输入词都会有一个对应的查询向量。
-
键向量:根据输入序列中每个元素生成的一个向量,它与查询向量进行对比,计算每个词与其他词的注意力分数,这个分数决定了当前词和其他词的相关性,计算公式如下,其中, 是键向量的维度,这里除以 的操作是为了防止点积值过大。
- 值向量:实际的信息载体。在计算出注意力分数后,通过加权和运算得到的就是每个词的最终表示,这个最终表示是该词的上下文相关的向量,反映了该词在上下文中的重要性。
这里,我们得到的某个词的最终表示,不仅仅是它自身的语义,还包含了它与其他词的关系和上下文信息。
-
多头注意力:在标准的自注意力机制中,Q、K、V 向量都是通过同一个线性变换得到的,但这可能会限制信息的捕获。多头注意力通过使用多个并行的注意力头来解决这个问题,每个头使用不同的线性变换来捕捉不同的特征或关系。
-
前馈神经网络:为每个词提供非线性的变换,提取更高级别的特征,增强模型的能力。
-
残差连接和层归一化:Transformer 中广泛使用了残差连接(将输入直接加到输出上)和层归一化(对每个样本的各个特征进行标准化),这些技术有助于避免训练过程中梯度消失并加速训练。
总结
从传统的基于规则、基于统计的方法到深度学习和 Transformer 架构,研究人员一直没有停下对 NLP 探索的脚本,即便经历了人工智能的几次寒冬。随着 GPT 和 BERT 的出现,再到今天各种大模型在不同领域得到广泛应用,计算机已经能够理解和生成几乎所有语言的精髓并顺利的通过“图灵测试”。这一切不仅改变了我们与机器的互动方式,更为信息的获取、理解和交流开辟了崭新的天地,语言的力量永不止步!
90 机器学习实战
本章我们通过经典的“泰坦尼克号生存预测”项目为大家讲解机器学习的完整应用,该项目来自于全球知名的数据科学竞赛平台Kaggle。该平台是数据科学、机器学习、人工智能领域的重要社区之一,为数据科学家和算法工程师提供了一个实践、分享和竞争的空间。无论是新手还是经验丰富的专家,Kaggle 都能为其提供丰富的资源和挑战,通过平台提供的数据集、竞赛、课程等资源,用户可以根据自身的需求提升相关的数据科学技能并与全球的数据科学家互动。
泰坦尼克号生存预测项目是 Kaggle 上最著名的入门级机器学习项目之一。该项目要求你根据乘客的基本信息(如年龄、性别、舱位、登船地等)预测他们是否能够在泰坦尼克号沉船事件中幸存下来,属于典型的分类任务。我们可以在 Kaggle 网站的 Competitions 搜索到名为“Titanic - Machine Learning from Disaster”的项目,点击进入可以看到项目的背景介绍并找到下载数据文件train.csv和test.csv的链接,显然前者是训练集(包含特征和标签)而后者是测试集(只有特征)。我们可以下载数据文件到本地并训练模型,然后再提交自己的预测结果;当然,如果愿意也可以在线创建 Notebook 文件并编写和运行代码。
数据探索
我们首先加载训练模型的数据,假设数据文件保存在当面路径下名为data的目录中,代码如下所示。
import numpy as npimport pandas as pd
df = pd.read_csv('data/train.csv', index_col='PassengerId')df.head(5)输出:
Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin EmbarkedPassengerId1 0 3 Braund, ... male 22.0 1 0 A/5 ... 7.2500 NaN S2 1 1 Cumings, ... female 38.0 1 0 PC ... 71.2833 C85 C3 1 3 Heikkinen, ... female 26.0 0 0 STON/O2 ... 7.9250 NaN S4 1 1 Futrelle, ... female 35.0 1 0 113803 ... 53.1000 C123 S5 0 3 Allen, ... male 35.0 0 0 373450 ... 8.0500 NaN S注意:加载数据的时候,我们直接将 PassengerID (乘客编号)列处理成了行索引。
下面的数据字典对DataFrame每个列的含义进行了说明。
| 列名 | 含义 | 说明 |
|---|---|---|
Survived | 是否幸存 | 目标类别(1表示幸存,0表示遇难) |
Pclass | 舱位等级 | 整数,取值为1、2、3,表示三种不同的等级 |
Name | 乘客姓名 | 字符串 |
Sex | 性别 | 字符串,male为男性,female为女性 |
Age | 年龄 | 浮点数 |
SibSp | 平辈亲属登船人数 | 整数,包括兄弟、姐妹、配偶总共登船的人数 |
Parch | 父母小孩登船人数 | 整数 |
Ticket | 船票号 | 字符串 |
Fare | 船票价格 | 浮点数 |
Cabin | 客舱号 | 字符串 |
Embarked | 登船港口 | 字符串,C表示瑟堡,Q表示皇后镇、S表示南安普顿 |
我们对数据进行可视化操,通过统计图表实训对数据的初步探索,代码如下所示。
import matplotlib.pyplot as plt
# 修改配置添加中文字体plt.rcParams['font.sans-serif'].insert(0, 'SimHei')plt.rcParams['axes.unicode_minus'] = False
# 定制画布plt.figure(figsize=(16, 12), dpi=200)
# 遇难和获救人数分布plt.subplot(3, 4, 1)ser = df.Survived.value_counts()ser.plot(kind='bar', color=['#BE3144', '#3A7D44'])plt.xticks(rotation=0)plt.title('图1.获救情况分布')plt.ylabel('人数')plt.xlabel('')for i, v in enumerate(ser): plt.text(i, v, v, ha='center')
# 客舱等级人数分布plt.subplot(3, 4, 2)ser = df.Pclass.value_counts().sort_index()ser.plot(kind='bar', color=['#FA4032', '#FA812F', '#FAB12F'])plt.xticks(rotation=0)plt.ylabel('人数')plt.xlabel('')plt.title('图2.客舱等级分布')for i, v in enumerate(ser): plt.text(i, v, v, ha='center')
# 性别人数分布plt.subplot(3, 4, 3)ser = df.Sex.value_counts()ser.plot(kind='bar', color=['#16404D', '#D84040'])plt.xticks(rotation=0)plt.ylabel('人数')plt.xlabel('')plt.title('图3.性别分布')for i, v in enumerate(ser): plt.text(i, v, v, ha='center')
# 登船港口人数分布plt.subplot(3, 4, 4)ser = df.Embarked.value_counts()ser.plot(kind='bar', color=['#FA4032', '#FA812F', '#FAB12F'])plt.xticks(rotation=0)plt.ylabel('人数')plt.xlabel('')plt.title('图4.登船港口分布')for i, v in enumerate(ser): plt.text(i, v, v, ha='center')
# 乘客年龄箱线图plt.subplot(3, 4, 5)df.Age.plot(kind='box', showmeans=True, notch=True)plt.title('图5.乘客年龄情况')
# 船票价格箱线图plt.subplot(3, 4, 6)df.Fare.plot(kind='box', showmeans=True, notch=True)plt.title('图6.船票价格情况')
# 不同客舱等级遇难和幸存人数分布plt.subplot(3, 4, (7, 8))s0 = df[df.Survived == 0].Pclass.value_counts()s1 = df[df.Survived == 1].Pclass.value_counts()temp = pd.DataFrame({'遇难': s0, '幸存': s1})pcts = temp.div(temp.sum(axis=1), axis=0)temp.plot(ax=plt.gca(), kind='bar', stacked=True, color=['#BE3144', '#3A7D44'])for i, idx in enumerate(temp.index): plt.text(i, temp.at[idx, '遇难'] // 2, f'{pcts.at[idx, "遇难"]:.2%}', ha='center', va='center') plt.text(i, temp.at[idx, '遇难'] + temp.at[idx, '幸存'] // 2, f'{pcts.at[idx, "幸存"]:.2%}', ha='center', va='center')plt.xticks(rotation=0)plt.xlabel('')plt.title('图7.不同客舱等级幸存情况')
# 不同性别遇难和幸存人数分布plt.subplot(3, 4, (9, 10))s0 = df[df.Survived == 0].Sex.value_counts()s1 = df[df.Survived == 1].Sex.value_counts()temp = pd.DataFrame({'遇难': s0, '幸存': s1})pcts = temp.div(temp.sum(axis=1), axis=0)temp.plot(ax=plt.gca(), kind='bar', stacked=True, color=['#BE3144', '#3A7D44'])for i, idx in enumerate(temp.index): plt.text(i, temp.at[idx, '遇难'] // 2, f'{pcts.at[idx, "遇难"]:.2%}', ha='center', va='center') plt.text(i, temp.at[idx, '遇难'] + temp.at[idx, '幸存'] // 2, f'{pcts.at[idx, "幸存"]:.2%}', ha='center', va='center')plt.xticks(rotation=0)plt.xlabel('')plt.title('图8.不同性别幸存情况')
# 不同登船港口遇难和幸存人数分布plt.subplot(3, 4, (11, 12))s0 = df[df.Survived == 0].Embarked.value_counts()s1 = df[df.Survived == 1].Embarked.value_counts()temp = pd.DataFrame({'遇难': s0, '幸存': s1})pcts = temp.div(temp.sum(axis=1), axis=0)temp.plot(ax=plt.gca(), kind='bar', stacked=True, color=['#BE3144', '#3A7D44'])for i, idx in enumerate(temp.index): plt.text(i, temp.at[idx, '遇难'] // 2, f'{pcts.at[idx, "遇难"]:.2%}', ha='center', va='center') plt.text(i, temp.at[idx, '遇难'] + temp.at[idx, '幸存'] // 2, f'{pcts.at[idx, "幸存"]:.2%}', ha='center', va='center')plt.xticks(rotation=0)plt.xlabel('')plt.title('图9.不同登船港口幸存情况')
plt.show()输出:
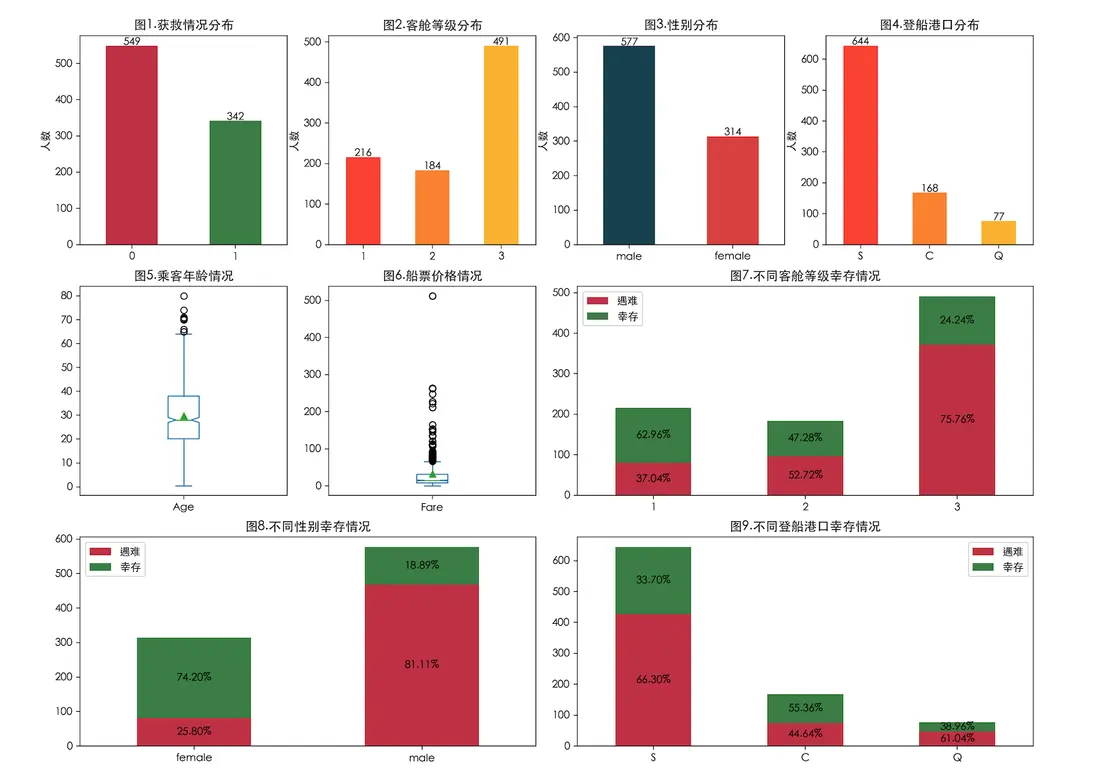
从上面的统计图表可以看出,一等舱的乘客有更高的存活率,女性乘客相较于男性乘客也有更高的存活率,在瑟堡登船的用户存活率较其他两地更高。如果愿意,我们还可以尝试对性别、舱位、年龄等维度进行交叉组合并绘制出对应的统计图表,甚至还可以探索乘客姓名中的称谓(Mr、Miss、Mrs、Dr、Master、Major等)跟乘客能否幸存是否存在某种关系,有兴趣的读者可以自行研究。
我们进一步查看DataFrame对象相关信息。
df.info()输出:
<class 'pandas.core.frame.DataFrame'>Index: 891 entries, 1 to 891Data columns (total 11 columns): # Column Non-Null Count Dtype--- ------ -------------- ----- 0 Survived 891 non-null int64 1 Pclass 891 non-null int64 2 Name 891 non-null object 3 Sex 891 non-null object 4 Age 714 non-null float64 5 SibSp 891 non-null int64 6 Parch 891 non-null int64 7 Ticket 891 non-null object 8 Fare 891 non-null float64 9 Cabin 204 non-null object 10 Embarked 889 non-null objectdtypes: float64(2), int64(4), object(5)memory usage: 83.5+ KB可以看出,训练集一共891条数据,其中年龄、客舱号、登船港口等列存在缺失值,乘客姓名、登船港口等是字符串类型没有办法直接用于模型训练,所以我们需要做一些准备工作。
特征工程
特征工程(Feature Engineering)是机器学习中的一个重要环节,通过对原始数据的处理、转换与选择,提取出能够帮助模型更好理解数据的特征,最终提升模型的预测性能。特征工程的主要步骤包括:
-
数据清洗:处理数据中的缺失值、重复值、异常值等。
-
特征转换:将原始数据转化为更适合模型输入的形式。常见的特征转换方法有:
-
标准化和归一化:标准化将数据转换为均值为
0、标准差为1的分布;归一化将数据缩放到特定的范围(如:),确保各特征在同一数量级,对应的公式如下所示:其中,表示数据的均值,表示数据的标准差,表示数据中的最小值,表示数据中的最大值。Scikit-learn 库
preprocessing模块中的StandardScaler和MinMaxScaler可以实现数据的标准化和归一化。 -
类别编码:对于类别变量(如:性别、职业、地区等),常用的编码方式有独热编码(One-Hot Encoding)和标签编码(Label Encoding)。Scikit-learn 库
preprocessing模块中的OneHotEncoder和LabelEncoder可以实现数据的独热编码和标签编码,当然也可以通过 pandas 库的get_dummies函数来处理DataFrame中的类别变量。 -
对数变换:对数变换可以帮助处理具有偏态分布的特征,使其更接近正态分布。
-
-
特征选择:从大量的特征中筛选出对模型预测有用的特征,去除冗余或无关的特征,减少维度并提高模型的性能。常用的方法有:
- 过滤法:基于统计检验方法(如:卡方检验、皮尔逊相关系数等)选择最具区分度的特征。
- 包裹法:通过模型的性能来评估特征子集的效果(如:递归特征消除法)。
- 嵌入法:通过训练模型并从模型中提取特征的重要性(如:决策树、L1正则化等),从而进行特征选择。
-
特征降维:通过某种数学变换将数据从高维空间映射到低维空间,以便保留数据的主要信息,简化模型,降维后的新特征是原始特征的某种组合。降维可以减少模型训练的运算量,减少不必要的噪声和冗余特征来降低复杂性,从而提高模型的泛化能力。特征降维常用的方法有:
- PCA(主成分分析):PCA 的目标是找出数据中最重要的特征(主成分),这些主成分能够保留数据的大部分方差。PCA 通过线性变换将数据投影到新的坐标轴上,使得投影后的数据方差最大化。换句话说,PCA通过对数据的特征进行“旋转”,将其转换为一个新的坐标系,新坐标系的每个轴(即主成分)按数据的方差大小排列,前几个主成分通常就能够解释数据的大部分变异。Scikit-learn 库
decomposition模块的PCA类可以帮助我们完成主成分分析。 - LDA(线性判别分析):LDA 的主要目标是通过寻找最佳的投影方向来最大化不同类别之间的可分性,并同时最小化同一类别内数据点的散布。LDA在特征空间中找到一个低维的空间,使得类别之间的差异尽可能大,而同一类别内的数据尽量聚集。简单的说,LDA 的核心思想是最大化类间散度,最小化类内散度。Scikit-learn 库
discriminant_analysis模块的LinearDiscriminantAnalysis类可以帮助我们完成线性判别分析。 - t-SNE(t分布随机邻居嵌入):t-SNE 是一种非线性的降维方法,主要用于数据可视化,特别适用于高维数据(如图像、文本等)的降维。t-SNE的目标是将高维空间中的相似点(邻近点)映射到低维空间中的相近位置,同时尽量避免不同类别之间的重叠。Scikit-learn 库
manifold模块的TSNE类可以帮助我们完成t分布随机邻居嵌入。
- PCA(主成分分析):PCA 的目标是找出数据中最重要的特征(主成分),这些主成分能够保留数据的大部分方差。PCA 通过线性变换将数据投影到新的坐标轴上,使得投影后的数据方差最大化。换句话说,PCA通过对数据的特征进行“旋转”,将其转换为一个新的坐标系,新坐标系的每个轴(即主成分)按数据的方差大小排列,前几个主成分通常就能够解释数据的大部分变异。Scikit-learn 库
-
特征构造:通过原始特征组合、变换或派生出新的特征。
特征工程不仅是提高模型准确性的关键因素,也是机器学习中一个需要持续优化的过程。通过对数据进行精心的清洗、转换、选择和构造,可以为模型提供更有价值的信息,提高模型的表现。尽管特征工程看似复杂,但它的效果在很多情况下超出了模型本身的改进,因此在实际应用中,我们应投入足够的精力和时间来进行特征工程的优化。
对于我们加载的数据集,我们可以将年龄字段的缺失值处理为中位数,将登船港口的缺失值处理为众数,客舱号字段的缺失值比较多,一种处理方式是直接删除这个列,另一种处理方式是二值化,有客舱号的记为1,没有客舱号的记为0,代码如下所示。
df['Age'] = df.Age.fillna(df.Age.median())df['Embarked'] = df.Embarked.fillna(df.Embarked.mode()[0])df['Cabin'] = df.Cabin.replace(r'.+', '1', regex=True).replace(np.nan, 0).astype('i8')处理完缺失值后,我们对年龄和船票价格两个字段进行特征缩放,通过StandardScaler实现标准化,代码如下所示。
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()df[['Fare', 'Age']] = scaler.fit_transform(df[['Fare', 'Age']])接下来,还需要对性别和登船港口两个字段进行独热编码处理,可以使用 pandas 库中的get_dummies函数或 scikit-learn 库的OneHotEncoder处理,两者处理的结果类似,代码如下所示。
df = pd.get_dummies(df, columns=['Sex', 'Embarked'], drop_first=True)我们继续处理乘客姓名字段,根据姓名中的称谓衍生出一个新的特征;此外,对于SibSp和Parch两个字段,我们可以将其衍生为家庭成员数量的新特征,代码如下所示。
title_mapping = { 'Mr': 0, 'Miss': 1, 'Mrs': 2, 'Master': 3, 'Dr': 4, 'Rev': 5, 'Col': 6, 'Major': 7, 'Mlle': 8, 'Ms': 9, 'Lady': 10, 'Sir': 11, 'Jonkheer': 12, 'Don': 13, 'Dona': 14, 'Countess': 15}df['Title'] = df['Name'].map( lambda x: x.split(',')[1].split('.')[0].strip()).map(title_mapping).fillna(-1)df['FamilySize'] = df['SibSp'] + df['Parch'] + 1说明:我们将每个称谓映射到一个数字,这里不必过于纠结称谓跟数字的对应关系,而且有些称谓在我们的训练集中并没有出现。对于那些未知的称谓,我们统一处理为
-1。
完成上面的操作之后,我们可以把不必要的字段全部删除掉,数据的准备工作就基本完成了。
df.drop(columns=['Name', 'SibSp', 'Parch', 'Ticket'], inplace=True)模型训练
首先我们将数据集划分为训练集和验证集,注意这里不是划分训练集和测试集,因为我们最终的测试集是官方提供的test.csv文件,这里我们把train.csv中 90% 的数据划分出来训练模型,用剩下的 10% 对模型进行验证。下面的代码中我们将验证集的特征和标签分别命名为X_valid和y_valid。
from sklearn.model_selection import train_test_split
X, y = df.drop(columns='Survived'), df.SurvivedX_train, X_valid, y_train, y_valid = train_test_split(X, y, train_size=0.9, random_state=3)我们先尝试逻辑回归模型,代码如下所示。
from sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import classification_report
model = LogisticRegression(penalty='l1', tol=1e-6, solver='liblinear')model.fit(X_train, y_train)y_pred = model.predict(X_valid)print(classification_report(y_valid, y_pred))输出:
precision recall f1-score support
0 0.88 0.80 0.84 56 1 0.72 0.82 0.77 34
accuracy 0.81 90 macro avg 0.80 0.81 0.80 90weighted avg 0.82 0.81 0.81 90我们再试一试大杀器 XGBoost,代码如下所示。
import xgboost as xgb
# 将数据处理成数据集格式DMatrix格式dm_train = xgb.DMatrix(X_train, y_train)dm_valid = xgb.DMatrix(X_valid)
# 设置模型参数params = { 'booster': 'gbtree', # 用于训练的基学习器类型 'objective': 'binary:logistic', # 指定模型的损失函数 'gamma': 0.1, # 控制每次分裂的最小损失函数减少量 'max_depth': 10, # 决策树最大深度 'lambda': 0.5, # L2正则化权重 'subsample': 0.8, # 控制每棵树训练时随机选取的样本比例 'colsample_bytree': 0.8, # 用于控制每棵树或每个节点的特征选择比例 'eta': 0.05, # 学习率 'seed': 3, # 设置随机数生成器的种子 'nthread': 16, # 指定了训练时并行使用的线程数}
model = xgb.train(params, dm_train, num_boost_round=200)y_pred = model.predict(dm_valid)# 将预测的概率转换为类别标签y_pred_label = (y_pred > 0.5).astype('i8')print(classification_report(y_valid, y_pred_label))输出:
precision recall f1-score support
0 0.89 0.91 0.90 56 1 0.85 0.82 0.84 34
accuracy 0.88 90 macro avg 0.87 0.87 0.87 90weighted avg 0.88 0.88 0.88 90当然,在条件允许的情况下,强烈建议大家通过网格搜索交叉验证的方式对模型的超参数进行调优,同时我们还可以绘制学习曲线(learning curve)来辅助判定是否存在过拟合和欠拟合问题。学习曲线包含两条曲线,一条反映训练误差,一条反映验证误差。欠拟合通常表现为模型在训练集和验证集上的误差都较大,并且随着训练数据增加,训练误差和验证误差的差距较小,说明我们的模型过于简单,无法捕捉到数据中的模式。过拟合通常表现为模型在训练集上表现得很好(训练误差较低),但在验证集上表现较差(验证误差较高),且随着训练数据增加,训练误差持续降低而验证误差开始上升时,说明我们的模型过于复杂。Scikit-learn 库model_selection模块的learning_curve函数可以帮助我们绘制学习曲线,有兴趣的读者可以自行研究。
模型评估
接下来我们加载真正的测试数据test.csv,通过前面训练好的模型来做出预测。我们可以将预测的结果保存成一个 CSV 文件,该文件共有两列,一列是 PassengerID,一列是我们预测的结果。我们将该文件提交到 Kaggle 平台,可以获得最终模型的准确率评分。
test = pd.read_csv('data/test.csv', index_col='PassengerId')# 处理缺失值test['Age'] = test.Age.fillna(test.Age.median())test['Fare'] = test.Fare.fillna(test.Fare.median())test['Embarked'] = test.Embarked.fillna(test.Embarked.mode()[0])test['Cabin'] = test.Cabin.replace(r'.+', '1', regex=True).replace(np.nan, 0).astype('i8')# 特征缩放test[['Fare', 'Age']] = scaler.fit_transform(test[['Fare', 'Age']])# 处理类别test = pd.get_dummies(test, columns=['Sex', 'Embarked'], drop_first=True)# 特征构造test['Title'] = test['Name'].apply(lambda x: x.split(',')[1].split('.')[0].strip()).map(title_mapping).fillna(-1)test['FamilySize'] = test['SibSp'] + test['Parch'] + 1# 删除多余特征test.drop(columns=['Name', 'Ticket', 'SibSp', 'Parch'], inplace=True)
# 使用逻辑回归模型passenger_id, X_test = test.index, test# 使用XGBoost模型# passenger_id, X_test = test.index, xgb.DMatrix(test)
y_test_pred = model.predict(X_test)# XGoost模型 - 将预测的概率转换成类别标签# y_test_pred = (model.predict(X_test) > 0.5).astype('i8')
# 生成提交文件result = pd.DataFrame({ 'PassengerId': passenger_id, 'Survived': y_test_pred})result.to_csv('submission.csv', index=False)大家可以试一试,不同的模型预测结果是否存在较大的差异,哪个是你心目中最理想的模型,然后大家可以通过实验验证我们之前提到的一个观点,看看特征工程是不是对预测的结果有重要的影响。下面是我对特征工程的一些小建议(仅供参考),大家可以自行实践,看看能否通过这些操作提升模型的性能。
- 对年龄(Age)字段进行离散化(分箱),将年龄特别小的(儿童)单独处理(如增加一个布尔字段)。
- 对客舱号(Cabin)字段进行更细致的处理,提取前缀字母和后续数字作为特征,而不是简单的二值化。
- 对比较重要的两个特征舱位等级(Pclass)和性别(Sex)进行特征组合。
- 对名字(Name)中有 Mrs 且父母小孩登船人数大于1的(可能是一位母亲)单独处理(如增加一个布尔字段)。
- 删除掉登船港口(Embarked)字段。
模型部署
我们可以将训练好的模型部署到工程化项目中,首先需要对模型进行序列化处理,代码如下所示。
import joblib
joblib.dump(model, 'model.pkl')说明:此处我们默认上面代码中的
model对象是之前通过 XGBoost 训练的模型。
joblib模块的dump函数对模型进行了 Pickle 序列化(Python私有序列化协议),在需要使用模型的地方,我们可以通过load函数实现反序列化,这样就可以将模型加载到应用程序中并完成预测,代码如下所示。
import joblib
model = joblib.load('model.pkl')model.predict(X_test)说明:此处我们默认上面代码中的
X_test已经处理为 XGBoost 中DMatrix对象。
如果我们希望将模型部署成 Web 服务,可以利用 Flask、FastAPI 这样的 Web 框架来创建 API 接口。下面,我们以 Flask 框架为例,用简单的代码为大家演示这个过程。
from flask import Flaskfrom flask import jsonifyfrom flask import request
import joblibimport pandas as pdimport xgboost as xgb
app = Flask(__name__)
@app.route('/predict', methods=['POST'])def predict(): query_df = pd.DataFrame(request.json) model = joblib.load('model.pkl') y_pred = (model.predict(xgb.DMatrix(query_df)) > 0.5).tolist() return jsonify({'message': 'OK', 'result': y_pred})
if __name__ == '__main__': app.run(debug=True)说明:作为工程化的项目,肯定不能在请求到来时才加载模型,因为这样会严重影响 Web 服务的性能。可以在项目启动之后的适当时机提前加载需要的模型,与此同时还要根据实际需求做好模型资源占用的监控。
运行上面的代码,默认会在本机 5000 端口运行一个 Web 服务器,下面我们通过 API 测试工具模拟发送一个 HTTP 请求给服务器,看看我们的模型能否运转起来给出预测的结果。
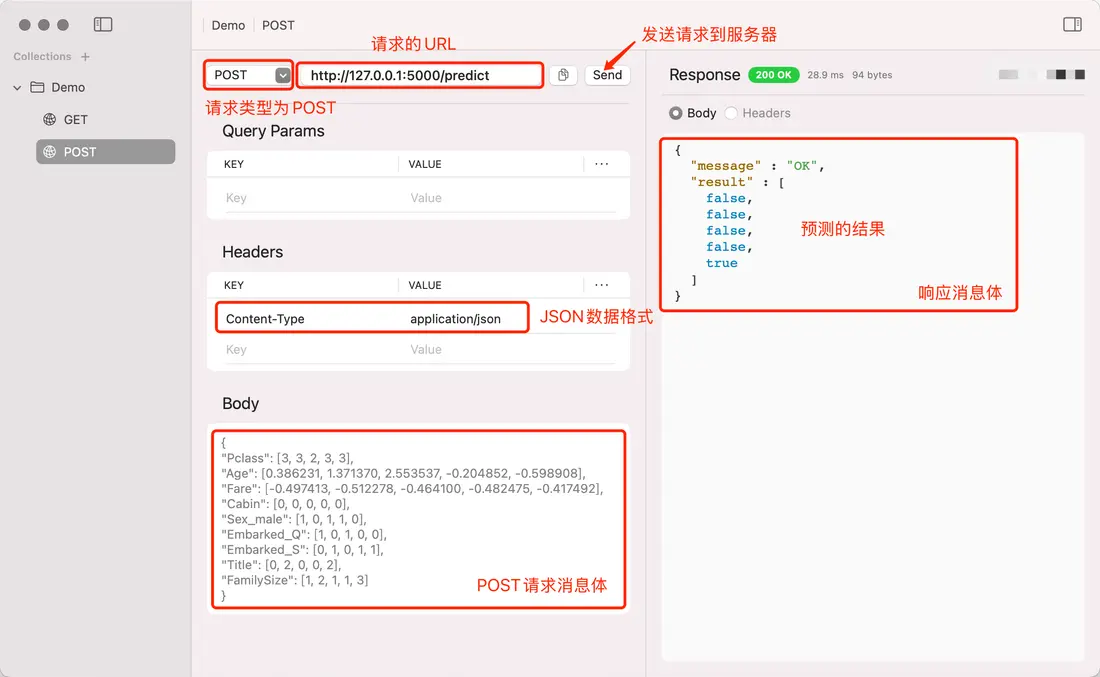
除了把模型部署成 Web 服务之外,我们还可以将模型部署到定时任务中,通过时间自动激发对模型的调用。此外,一些边缘设备支持我们将训练好的模型以某种特殊的格式嵌入进去,有兴趣的读者可以自行探索。
Python100天
已完结分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 301 天
部分内容可能已过时
评论