本篇目录
- 66 数据分析概述
- 67 环境准备
- 68 NumPy的应用-1
- 69 NumPy的应用-2
- 70 NumPy的应用-3
- 71 NumPy的应用-4
- 72 深入浅出pandas-1
- 73 深入浅出pandas-2
- 74 深入浅出pandas-3
- 75 深入浅出pandas-4
- 76 深入浅出pandas-5
- 77 深入浅出pandas-6
- 78 数据可视化-1
- 79 数据可视化-2
- 80 数据可视化-3
目录里每一条都可以点开直达对应章节;右侧(移动端为悬浮按钮)的「文章目录」也会列出同一批标题。
66 数据分析概述
当今世界,各行各业对信息技术的依赖程度在不断加深,每天都会有大量的数据产生,我们常常会感到数据越来越多,但是要从中发现有价值的信息却越来越难。这里所说的信息,可以理解为对数据集处理之后的结果,是从数据集中提炼出的可用于支撑和指导决策的东西,而从原始数据中抽取出有价值的信息的这个过程我们就称之为数据分析,它是数据科学的重要组成部分。
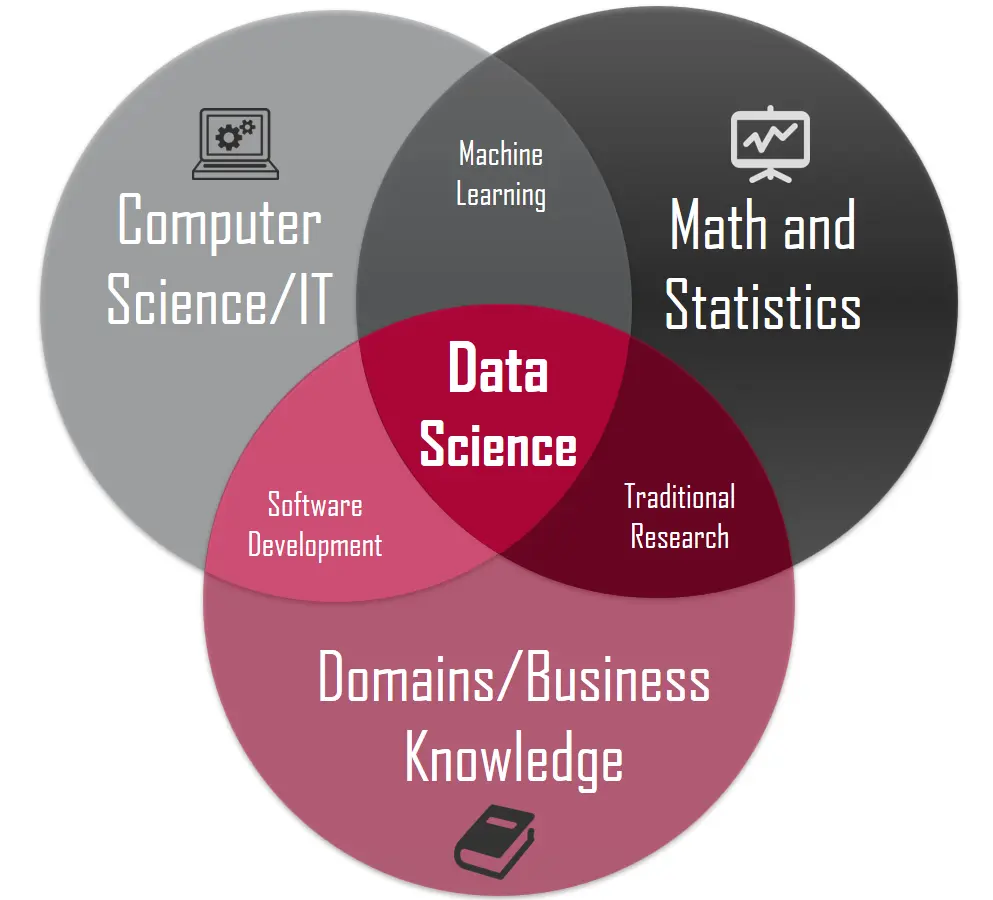
定义1:数据分析是有针对性的收集、加工、整理数据并采用统计、挖掘等技术对数据进行探索、分析、呈现和解释的科学。
定义2:数据分析是通过收集、整理和分析数据,从中提取有价值的信息和洞察,以支持决策和优化过程的活动。(GPT-4o)
定义3:数据分析是通过系统性的收集、整理、处理、检验和解释数据,从中提取有价值的信息、形成结论并支持决策的过程,其核心是利用统计、算法和逻辑方法揭示数据背后的规律、趋势或关联。(DeepSeek)
对于想从事数据分析工作的人来说,需要掌握两个部分的技能,一是“数据思维”,二是“分析工具”,如下图所示。
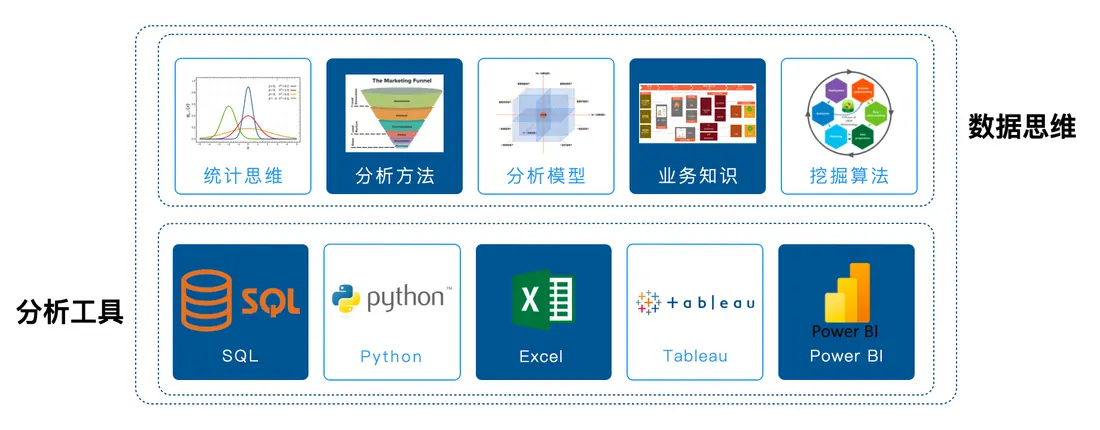
上图中,分析工具部分其实是比较容易掌握的,像 SQL 或 Python 这样的编程语言,只要经过系统的学习和适量的练习,大部分人都是可以驾驭的;像 Power BI、Tableau 这样的商业智能工具,更是让我们通过“拖拉拽”操作就能完成数据的可视化并在此基础上产生商业洞察,上手难度会更低。相反,数据思维部分的内容对大多数新手来说是不太容易驾驭的,例如“统计思维”,很多人在读书的时候都学习过“概率论和统计学”这样的课程,但是当面对实际的业务场景时,却很难将这些知识映射到业务场景来解决现实的问题。此外,如果没有掌握基本的分析方法、没有理解常用的分析模型,没有相关业务知识的积累,即便我们拿到再多有用的数据,也会感觉无从下手,更不用说产生业务洞察发现商业价值了。所以,数据思维这个部分,除了系统的学习相关知识技能,还需要不断的在实际业务场景中积累和沉淀。
数据分析师的职责
HR在发布招聘需求时,通常将数据工程、数据分析、数据挖掘等岗位都统称为数据分析岗位,但是根据工作性质的不同,又可以分为偏工程的数据治理方向、偏业务的商业分析方向、偏算法的数据挖掘方向、偏应用的数据开发方向、偏产品的数据产品经理。我们通常所说的数据分析师主要是指业务数据分析师,很多数据分析师的职业生涯都是从这个岗位开始的,而且这个岗位也是招聘数量最多的岗位。有些公司会将业务数据分析师归属到具体的业务部门(市场、运营、产品等),有些公司有专门的数据部门(数据分析团队或数据科学团队),还有些公司数据分析师会直接服务高层决策,属于企业战略部门。正因如此,你在招聘网站上看到的把数据分析师称为数据运营、商业分析师、BI工程师就不会感到奇怪了。通常,我们在招聘网站看到的对业务数据分析师岗位职责(JD)的描述如下所示:
- 负责相关报表的输出。
- 建立和优化指标体系。
- 监控数据波动和异常,找出问题。
- 优化和驱动业务,推动数字化运营。
- 找出潜在的市场和产品的上升空间。
根据上面的描述,作为业务数据分析师,我们的工作不是给出一个简单浅显的结论,而是结合公司的业务,完成监控数据、揪出异常、找到原因、探索趋势等工作。不管你是用 Python 语言、Excel、Tableau、SPSS或其他的商业智能工具,工具只是达成目标的手段,数据思维是核心技能,从实际业务问题出发到最终发现数据中的商业价值是终极目标。数据分析师在很多公司只是一个基础岗位,精于业务的数据分析师可以向数据分析经理或数据运营总监等管理岗位发展;对于熟悉机器学习算法的数据分析师来说,可以向数据挖掘工程师或算法专家方向发展,这些岗位除了需要相应的数学和统计学知识,在编程能力方面也比数据分析师有更高的要求,可能还需要有大数据存储和处理的相关经验。
这里顺便说一下其他几个方向,数据治理岗位主要是帮助公司建设数据仓库或数据湖,实现数据从业务系统、埋点系统、日志系统到数据仓库或数据湖的转移,为后续的数据分析和挖掘提供基础设施。数据治理岗位对 SQL 和 HiveSQL 有着较高的要求,需要熟练的使用 ETL 工具,此外还需要对 Hadoop 生态圈有较好的认知。作为数据产品经理,除了传统产品经理的技能栈之外,也需要较强的技术能力,例如要了解常用的推荐算法、机器学习模型,能够为算法的改进提供依据,能够制定相关埋点的规范和口径,虽然不需要精通各种算法,但是要站在产品的角度去考虑数据模型、指标、算法等的落地。
数据分析师的技能栈
数据分析师的技能栈也包括硬技能和软技能,以下是我对这个职位的理解,仅供参考。
- 计算机科学(数据分析工具、编程语言、数据库)
- 数学和统计学(数据思维、统计思维)
- 人工智能(机器学习和深度学习算法)
- 业务理解能力(沟通、表达、经验)
- 总结和表述能力(总结、汇报、商业 PPT)
当然,对于一个新手来说,不可能用短时间掌握整个技能栈的内容,但是随着这份工作的深入,上面提到的东西多多少少都会涉猎到,大家可以根据实际工作的需求去深耕其中的某个或某些技能。
数据分析通用流程
我们提到数据分析这个词很多时候可能指的都是狭义的数据分析,这类数据分析主要目标就是生成可视化报表并通过这些报表来洞察业务中的问题,这类工作一般都是具有滞后性的。广义的数据分析还包含了数据挖掘的部分,不仅要通过数据实现对业务的监控和分析,还要利用机器学习算法,找出隐藏在数据背后的知识,并利用这些知识为将来的决策提供支撑,具备一定的前瞻性。
基本的数据分析工作一般包含以下几个方面的内容,当然因为行业和工作内容的不同会略有差异。
- 确定目标(输入):理解业务,确定指标口径
- 获取数据:数据仓库、电子表格、三方接口、网络爬虫、开放数据集等
- 清洗数据:缺失值、重复值、异常值的处理以及其他预处理(格式化、离散化、二值化等)
- 数据透视:排序、统计、分组聚合、交叉表、透视表等
- 数据呈现(输出):数据可视化,发布工作成果(数据分析报告)
- 分析洞察(后续):解释数据的变化,提出对应的方案
深入的数据挖掘工作通常包含以下几个方面的内容,当然因为行业和工作内容的不同会略有差异。
- 确定目标(输入):理解业务,明确挖掘目标
- 数据准备:数据采集、数据描述、数据探索、质量判定等
- 数据加工:提取数据、清洗数据、数据变换、特殊编码、降维、特征选择等
- 数据建模:模型比较、模型选择、算法应用
- 模型评估:交叉检验、参数调优、结果评价
- 模型部署(输出):模型落地、业务改进、运营监控、报告撰写
数据分析相关库
使用 Python 从事数据分析相关的工作是一个非常棒的选择,首先 Python 语言非常容易上手,而且整个 Python 生态圈中,有非常多成熟的用于数据科学的软件包和工具库。不同于其他的数据科学编程语言(如:Julia、R等),Python 除了可以用于数据科学,还能做很多其他的事情。
经典的三大神器
- NumPy:支持常见的数组和矩阵操作,通过
ndarray类实现了对多维数组的封装,提供了操作这些数组的方法和函数。由于 NumPy 内置了并行运算功能,当使用多核 CPU 时,NumPy 会自动做并行计算。 - Pandas:pandas 的核心是其特有的数据结构
DataFrame和Series,这使得 pandas 可以处理包含不同类型数据的表格和时间序列,这一点是 NumPy 的ndarray做不到的。使用 pandas,可以轻松顺利的加载各种形式的数据,然后对数据进行切片、切块、重塑、清洗、聚合、呈现等操作。 - Matplotlib:matplotlib 是一个包含各种绘图模块的库,能够根据我们提供的数据创建高质量的图表。此外,matplotlib 还提供了 pylab 模块,这个模块包含了很多像 MATLAB 一样的绘图组件。
其他相关库
- SciPy:完善了 NumPy 的功能,封装了大量科学计算的算法,包括线性代数、统计检验、稀疏矩阵、信号和图像处理、最优化问题、快速傅里叶变换等。
- Polars:一个高性能的数据分析库,旨在提供比 pandas 更快的数据操作。它支持大规模数据处理,并能够利用多核 CPU 来加速计算,在处理大规模数据集时可以用来替代 pandas。
- Seaborn:seaborn 是基于 matplotlib 的图形可视化工具,直接使用 matplotlib 虽然可以定制出漂亮的统计图表,但是总体来说还不够简单方便,seaborn 相当于是对 matplotlib 做了封装,让用户能够以更简洁有效的方式做出各种有吸引力的统计图表。
- Scikit-learn:scikit-learn 最初是 SciPy 的一部分,提供了大量机器学习可能用到的工具,包括数据预处理、监督学习(分类、回归)、无监督学习(聚类)、模式选择、交叉检验等。
- Statsmodels:包含了经典统计学和计量经济学算法的库,帮助帮助用户完成数据探索、回归分析、假设检验等任务。
- PySpark:Apache Spark(大数据处理引擎)的 Python 版本,用于大规模数据处理和分布式计算,能够在分布式环境中高效地进行数据清洗、转化和分析。
- Tensorflow:TensorFlow 是一个开源的深度学习框架,由 Google 开发,主要面向深度学习任务,常用于构建和训练机器学习模型(尤其是复杂的神经网络模型)。
- Keras:Keras 是一个高层次的神经网络 API,主要用于构建和训练深度学习模型。Keras 适合深度学习初学者和研究人员,因为它让构建和训练神经网络变得更加简单。
- PyTorch:PyTorch 是一个开源的深度学习框架,由 Facebook 开发,广泛用于研究和生产环境。PyTorch 是深度学习研究中的热门框架,在计算机视觉、自然语言处理等领域得到了广泛应用。
- NLTK / SpaCy:自然语言处理(NLP)库。
67 环境准备
如果希望快速开始使用 Python 处理数据科学相关的工作,建议大家直接安装 Anaconda,然后使用 Anaconda 中集成的 Notebook 或 JupyterLab 工具来编写代码。因为对于新手来说,先安装官方的 Python 解释器,再逐个安装工作中会使用到的三方库文件会比较麻烦,尤其是在 Windows 环境下,经常会因为构建工具或 DLL 文件的缺失导致安装失败,而一般新手也很难根据错误提示信息采取正确的解决措施,容易产生严重的挫败感。如果计算机上已经有 Python 解释器环境了,也可以直接使用 Python 的包管理工具 pip 安装 Jupyter,再根据实际工作的需要安装三方库,这种方式适合有一定经验的用户。
安装和使用 Anaconda
对于个人用户来说,可以从 Anaconda 的官方网站下载它的“个人版(Individual Edition)”安装程序,安装完成后,你的计算机上不仅拥有了 Python 环境和 Spyder(类似于 PyCharm 的集成开发工具),还拥有了与数据科学工作相关的近200个工具包,包括我们上面提到 Python 数据分析三大神器。除此之外,Anaconda 还提供了一个名为 conda 的包管理工具,通过这个工具不仅可以管理 Python 的工具包,还可以用于创建运行 Python 程序的虚拟环境。
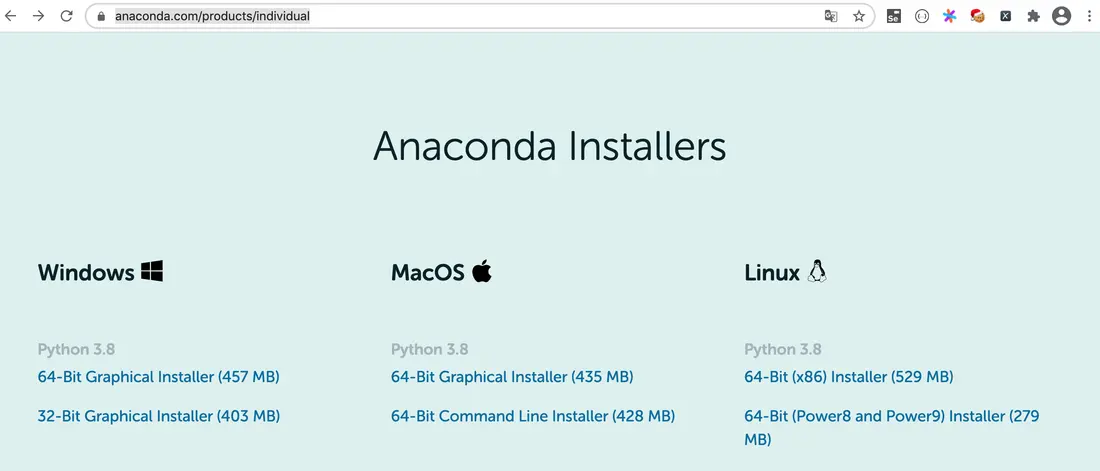
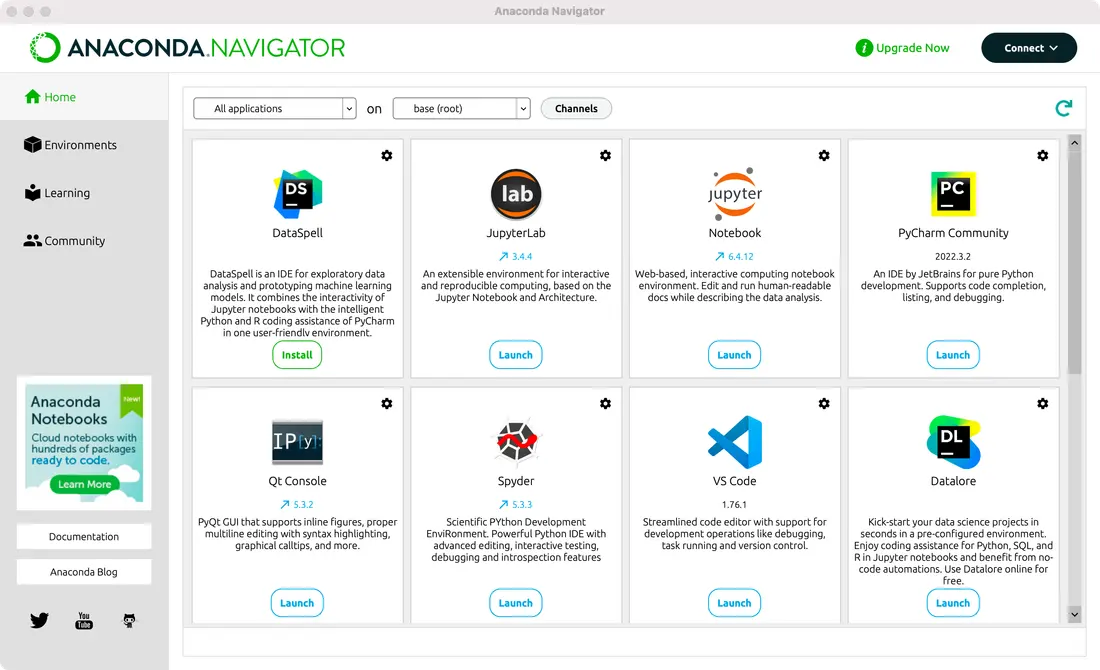
如上图所示,可以通过 Anaconda 官网提供的下载链接选择适合自己操作系统的安装程序,建议大家选择图形化的安装程序,下载完成后双击安装程序开始安装。安装过程基本使用默认设置即可,完成安装后,macOS 用户可以在“应用程序”或“启动台”中找到名为“Anaconda-Navigator”的应用程序,运行该程序可以看到如下所示的界面,我们可以在这里选择需要执行的操作。
对于 Windows 用户,建议按照安装向导的提示和推荐的选项来安装 Anaconda(除了安装路径,基本也没有什么需要选择的),安装完成后可以在“开始菜单”中找到“Anaconda3”。
提示:可以选择 Miniconda 作为 Anaconda 的替代品,Miniconda 只会安装 Python 解释器环境和一些必要的工具,其他的三方库由用户自行选择安装。其实我个人并不喜欢 Anaconda,因为它是给小白用户使用的,我们有了 Python 环境以后完全可以按照自己的意愿来安装需要的三方库。
conda命令
对于非新手用户,如果希望使用 conda 工具来管理依赖项或者创建项目的虚拟环境,可以在终端或命令行提示符中使用 conda 命令。Windows 用户可以在“开始菜单”中找到“Anaconda3”,然后点击“Anaconda Prompt”或“Anaconda PowerShell”来启动支持 conda 的命令行提示符。新手用户如果想创建新的虚拟环境或管理三方库(依赖项),建议直接使用“Anaconda-Navigator”中的“Environments”,通过可视化的方式对虚拟环境和依赖项进行管理。
-
版本和帮助信息。
- 查看版本:
conda -V或conda --version - 获取帮助:
conda -h或conda --help - 相关信息:
conda list
- 查看版本:
-
虚拟环境相关。
- 显示所有虚拟环境:
conda env list - 创建虚拟环境:
conda create --name venv - 指定 Python 版本创建虚拟环境:
conda create --name venv python=3.7 - 指定 Python 版本创建虚拟环境并安装指定依赖项:
conda create --name venv python=3.7 numpy pandas - 通过克隆现有虚拟环境的方式创建虚拟环境:
conda create --name venv2 --clone venv - 分享虚拟环境并重定向到指定的文件中:
conda env export > environment.yml - 通过分享的虚拟环境文件创建虚拟环境:
conda env create -f environment.yml - 激活虚拟环境:
conda activate venv - 退出虚拟环境:
conda deactivate - 删除虚拟环境:
conda remove --name venv --all
说明:上面的命令中,
venv和venv2是虚拟环境文件夹的名字,可以将其替换为自己喜欢的名字,但是强烈建议使用英文且不要有特殊字符。 - 显示所有虚拟环境:
-
包(三方库或工具)管理。
- 查看已经安装的包:
conda list - 搜索指定的包:
conda search matplotlib - 安装指定的包:
conda install matplotlib - 更新指定的包:
conda update matplotlib - 移除指定的包:
conda remove matplotlib
说明:在搜索、安装和更新软件包时,默认会连接到官方网站进行操作,如果觉得速度不给力,可以将默认的官方网站替换为国内的镜像网站,推荐使用清华大学的开源镜像网站。将默认源更换为国内镜像的命令是:
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/和conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/main。如果需要换回默认源,可以使用命令conda config --remove-key channels。 - 查看已经安装的包:
安装和使用JupyterLab
安装和启动
如果已经安装了 Anaconda,可以按照上面所说的方式在“Anaconda-Navigator”中直接启动 Notebook 或 JupyterLab。按照官方的说法,JupyterLab 是下一代的 Notebook,提供了更友好的界面和更强大的功能,我们也推荐大家使用 JupyterLab。Windows 用户也可以在开始菜单中打开“Anaconda Prompt”或“Anaconda PowerShell”,由于已经激活了 Anaconda 默认的虚拟环境,只需要输入jupyter lab命令来启动JupyterLab。macOS 系统在安装 Anaconda以后,每次打开终端时会自动激活 Anaconda 默认的虚拟环境,也是通过输入jupyter lab命令就可以启动JupyterLab。
对于安装了 Python 环境但是没有安装 Anaconda 的用户,可以用 Python 的包管理工具pip来安装 JupyterLab,安装成功后在终端或命令行提示符中执行jupyter lab命令来启动 JupyterLab,如下所示。
安装 JupyterLab:
pip install jupyterlab安装 Python 数据分析三大神器:
pip install numpy pandas matplotlib启动 JupyterLab:
jupyter labJupyterLab 是基于网页的用于交互计算的应用程序,可以用于代码开发、文档撰写、代码运行和结果展示。简单的说,你可以在网页中直接编写代码和运行代码,代码的运行结果也会直接在代码块下方进行展示。如在编写代码的过程中需要编写说明文档,可在同一个页面中使用 Markdown 格式进行编写,而且可以直接看到渲染后的效果。此外,Notebook 的设计初衷是提供一个能够支持多种编程语言的工作环境,目前它能够支持超过40种编程语言,包括 Python、R、Julia、Scala 等。
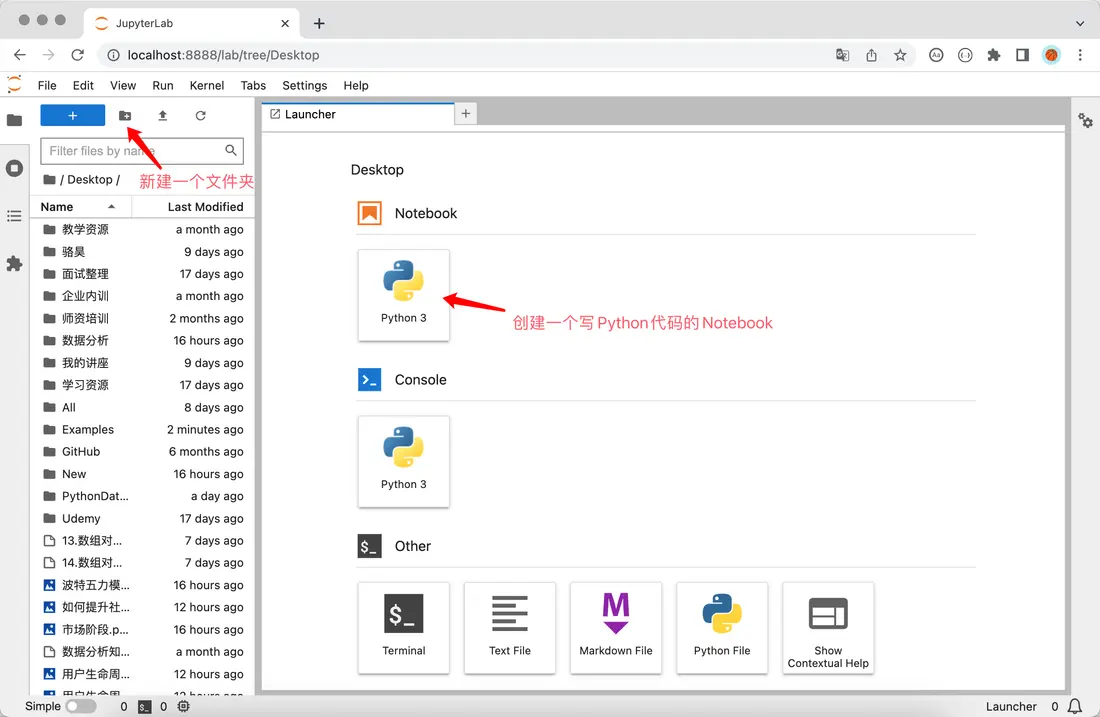
首先,我们可以创建一个用于书写 Python 代码的 Notebook,如下图所示。
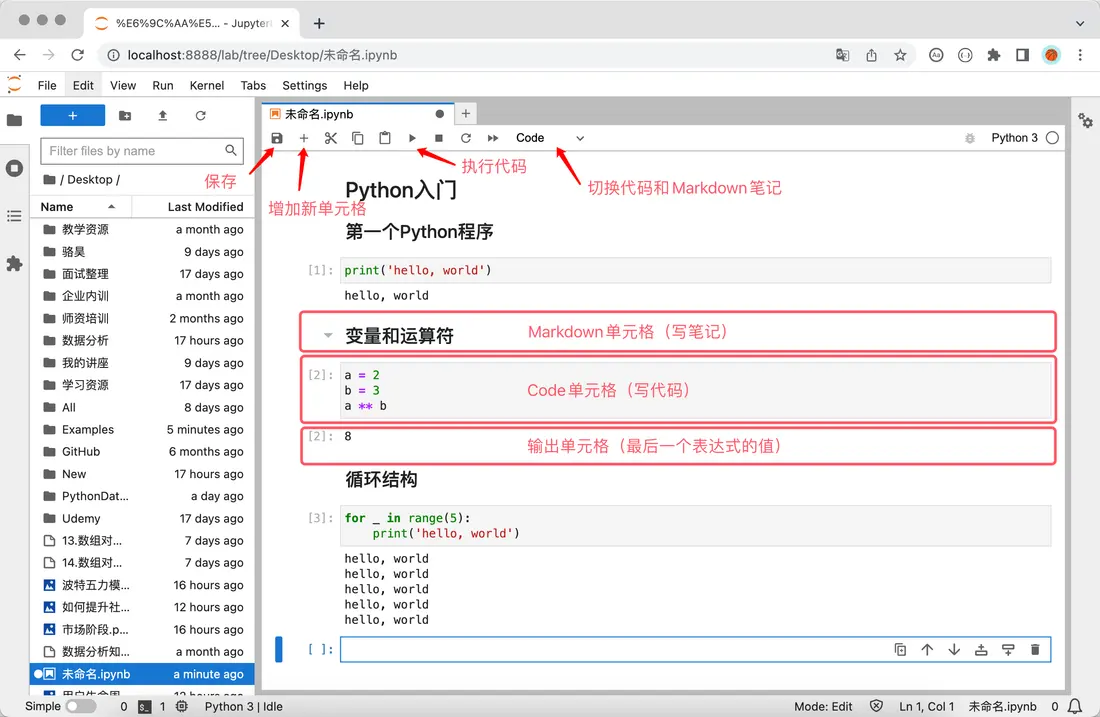
接下来,我们就可以编写代码、撰写文档和运行程序啦,如下图所示。
使用技巧
如果使用 Python 做工程化的项目开发,PyCharm 肯定是最好的选择,它提供了一个集成开发环境应该具有的所有功能,尤其是智能提示、代码补全、自动纠错这类功能会让开发人员感到非常舒服。如果使用 Python 做数据科学相关的工作,JupyterLab 并不比 PyCharm 逊色,在数据和图表展示方面 JupyterLab 更加优秀。为此,JetBrains 公司还专门开发了一个对标 JupyterLab 的新工具 DataSpell,有兴趣的读者可以自行了解。下面我们为大家介绍一些 JupyterLab 的使用技巧,希望能够帮助大家提升工作效率。
-
自动补全。在使用 JupyterLab 编写代码时,按
Tab键会获得代码提示和补全功能。 -
获得帮助。如果希望了解一个对象(如变量、类、函数等)的相关信息或使用方式,可以在对象后面使用
?并运行代码, 窗口下方会显示出对应的信息,帮助我们了解该对象,如下所示。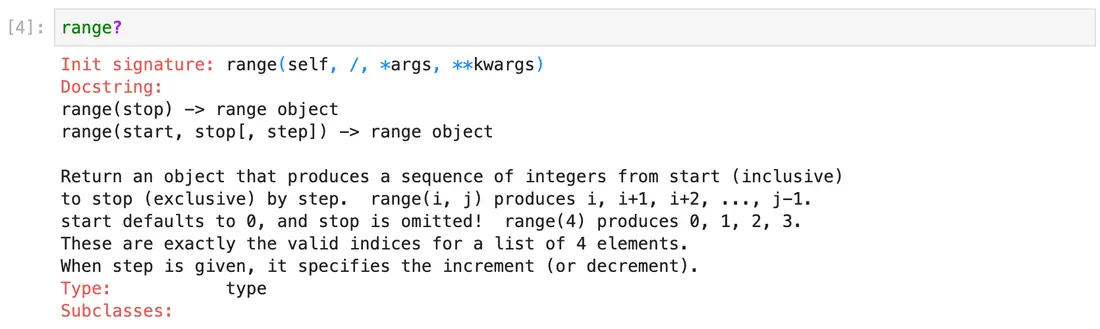
-
搜索命名。如果只记得一个类或一个函数名字的一部分,可以使用通配符
*并配合?进行搜索,如下所示。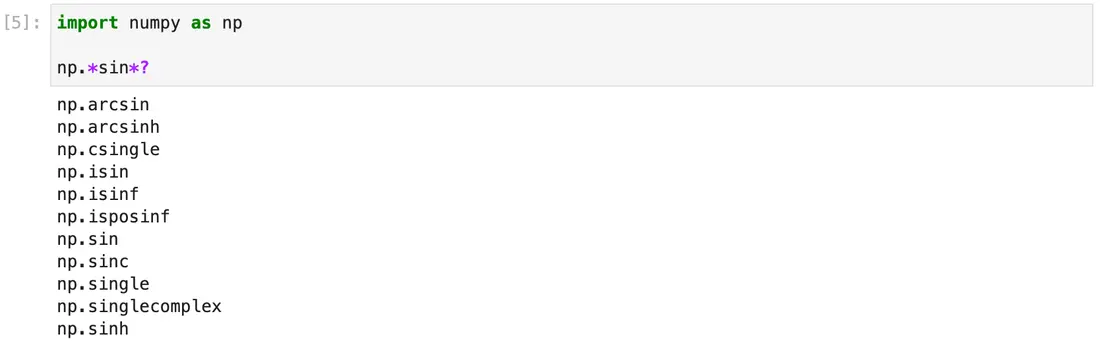
-
调用命令。可以在 JupyterLab 中使用
!后面跟系统命令的方式来执行系统命令。 -
魔法指令。JupyterLab 中有很多非常有趣且有用的魔法指令,例如可以使用
%timeit测试语句的执行时间,可以使用%pwd查看当前工作目录等。如果想查看所有的魔法指令,可以使用%lsmagic,如果了解魔法指令的用法,可以使用%magic来查看,如下图所示。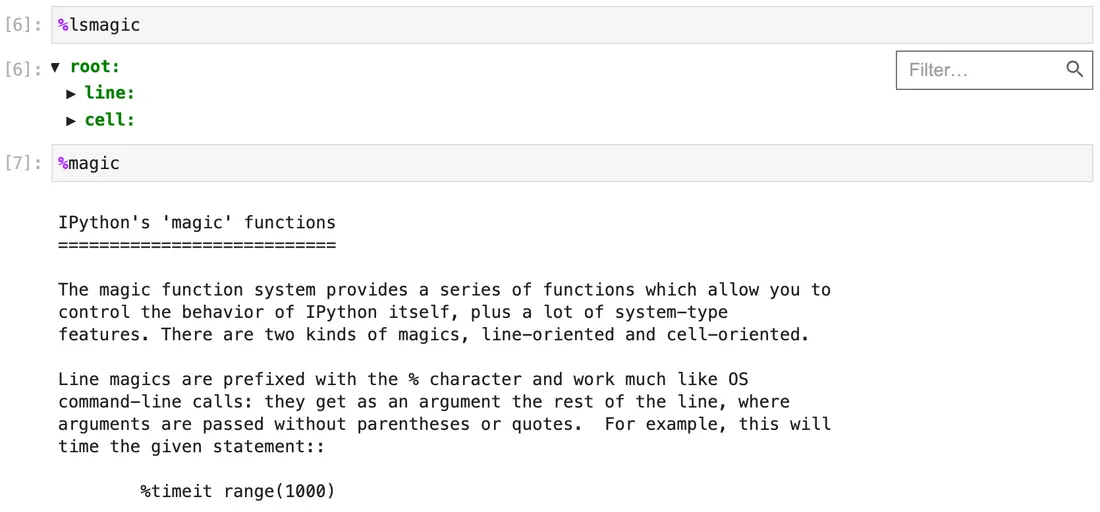
常用的魔法指令有:
魔法指令 功能说明 %pwd查看当前工作目录 %ls列出当前或指定文件夹下的内容 %cat查看指定文件的内容 %hist查看输入历史 %matplotlib inline设置在页面中嵌入matplotlib输出的统计图表 %config Inlinebackend.figure_format='svg'设置统计图表使用SVG格式(矢量图) %run运行指定的程序 %load加载指定的文件到单元格中 %quickref显示IPython的快速参考 %timeit多次运行代码并统计代码执行时间 %prun用 cProfile.run运行代码并显示分析器的输出%who/%whos显示命名空间中的变量 %xdel删除一个对象并清理所有对它的引用 -
快捷键。JupyterLab 中的很多操作可以通过快捷键来实现,使用快捷键可以提升工作效率。JupyterLab 的快捷键可以分为命令模式下的快捷键和编辑模式下的快捷键,所谓编辑模式就是处于输入代码或撰写文档状态的模式,在编辑模式下按
Esc可以回到命令模式,在命令模式下按Enter可以进入编辑模式。命令模式下的快捷键:
快捷键 功能说明 Alt+Enter运行当前单元格并在下面插入新的单元格 Shift+Enter运行当前单元格并选中下方的单元格 Ctrl+Enter运行当前单元格 j/k、Shift+j/Shift+k选中下方/上方单元格、连续选中下方/上方单元格 a/b在下方/上方插入新的单元格 c/x复制单元格 / 剪切单元格 v/Shift+v在下方/上方粘贴单元格 dd/z删除单元格 / 恢复删除的单元格 Shift+l显示或隐藏当前/所有单元格行号 Space/Shift+Space向下/向上滚动页面 编辑模式下的快捷键:
快捷键 功能说明 Shift+Tab获得提示信息 Ctrl+]/Ctrl+[增加/减少缩进 Alt+Enter运行当前单元格并在下面插入新的单元格 Shift+Enter运行当前单元格并选中下方的单元格 Ctrl+Enter运行当前单元格 Ctrl+Left/Right光标移到行首/行尾 Ctrl+Up/Down光标移动代码开头/结尾处 Up/Down光标上移/下移一行或移到上/下一个单元格 说明:对于 macOS 系统可以将
Alt键替换成Option键,将Ctrl键替换成Command键。
68 NumPy的应用-1
Numpy 是一个开源的 Python 科学计算库,用于快速处理任意维度的数组。Numpy 支持常见的数组和矩阵操作,对于同样的数值计算任务,使用 NumPy 不仅代码要简洁的多,而且 NumPy 在性能上也远远优于原生 Python,至少是一到两个数量级的差距,而且数据量越大,NumPy 的优势就越明显。
NumPy 最为核心的数据类型是ndarray,使用ndarray可以处理一维、二维和多维数组,该对象相当于是一个快速而灵活的大数据容器。NumPy 底层代码使用 C 语言编写,解决了 GIL 的限制,ndarray在存取数据的时候,数据与数据的地址都是连续的,这确保了可以进行高效率的批量操作,性能上远远优于 Python 中的list;另一方面ndarray对象提供了更多的方法来处理数据,尤其获取数据统计特征的方法,这些方法也是 Python 原生的list没有的。
准备工作
-
启动 JupyterLab
Terminal window jupyter lab提示:在启动 JupyterLab 之前,建议先安装好数据分析相关依赖项,包括之前提到的三大神器以及相关依赖项。如果使用 Anaconda,则无需单独安装,可以通过 Anaconda 的 Navigator 来启动。
-
导入
import numpy as npimport pandas as pdimport matplotlib.pyplot as plt说明:如果已经启动了 JupyterLab 但尚未安装相关依赖库,例如尚未安装
numpy,可以在单元格中输入%pip install numpy并运行该单元格来安装 NumPy。当然,我们也可以在单元格中输入%pip install numpy pandas matplotlib把 Python 数据分析三个核心的三方库都安装上。注意上面的代码,我们不仅导入了 NumPy,还将 pandas 和 matplotlib 库一并导入了。
创建数组对象
创建ndarray对象有很多种方法,下面我们介绍一些常用的方法。
方法一:使用array函数,通过list创建数组对象
代码:
array1 = np.array([1, 2, 3, 4, 5])array1输出:
array([1, 2, 3, 4, 5])代码:
array2 = np.array([[1, 2, 3], [4, 5, 6]])array2输出:
array([[1, 2, 3], [4, 5, 6]])方法二:使用arange函数,指定取值范围和跨度创建数组对象
代码:
array3 = np.arange(0, 20, 2)array3输出:
array([ 0, 2, 4, 6, 8, 10, 12, 14, 16, 18])方法三:使用linspace函数,用指定范围和元素个数创建数组对象,生成等差数列
代码:
array4 = np.linspace(-1, 1, 11)array4输出:
array([-1. , -0.8, -0.6, -0.4, -0.2, 0. , 0.2, 0.4, 0.6, 0.8, 1. ])方法四:使用logspace函数,生成等比数列
代码:
array5 = np.logspace(1, 10, num=10, base=2)array5注意:等比数列的起始值是 ,等比数列的终止值是 ,
num是元素的个数,base就是底数。
输出:
array([ 2., 4., 8., 16., 32., 64., 128., 256., 512., 1024.])方法五:通过fromstring函数从字符串提取数据创建数组对象
代码:
array6 = np.fromstring('1, 2, 3, 4, 5', sep=',', dtype='i8')array6输出:
array([1, 2, 3, 4, 5])方法六:通过fromiter函数从生成器(迭代器)中获取数据创建数组对象
代码:
def fib(how_many): a, b = 0, 1 for _ in range(how_many): a, b = b, a + b yield a
gen = fib(20)array7 = np.fromiter(gen, dtype='i8')array7输出:
array([ 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, 233, 377, 610, 987, 1597, 2584, 4181, 6765])方法七:使用numpy.random模块的函数生成随机数创建数组对象
产生 10 个 范围的随机小数,代码:
array8 = np.random.rand(10)array8输出:
array([0.45556132, 0.67871326, 0.4552213 , 0.96671509, 0.44086463, 0.72650875, 0.79877188, 0.12153022, 0.24762739, 0.6669852 ])产生 10 个 范围的随机整数,代码:
array9 = np.random.randint(1, 100, 10)array9输出:
array([29, 97, 87, 47, 39, 19, 71, 32, 79, 34])产生 20 个 , 的正态分布随机数,代码:
array10 = np.random.normal(50, 10, 20)array10输出:
array([55.04155586, 46.43510797, 20.28371158, 62.67884053, 61.23185964, 38.22682148, 53.17126151, 43.54741592, 36.11268017, 40.94086676, 63.27911699, 46.92688903, 37.1593374 , 67.06525656, 67.47269463, 23.37925889, 31.45312239, 48.34532466, 55.09180924, 47.95702787])产生 范围的随机小数构成的 3 行 4 列的二维数组,代码:
array11 = np.random.rand(3, 4)array11输出:
array([[0.54017809, 0.46797771, 0.78291445, 0.79501326], [0.93973783, 0.21434806, 0.03592874, 0.88838892], [0.84130479, 0.3566601 , 0.99935473, 0.26353598]])产生 范围的随机整数构成的三维数组,代码:
array12 = np.random.randint(1, 100, (3, 4, 5))array12输出:
array([[[94, 26, 49, 24, 43], [27, 27, 33, 98, 33], [13, 73, 6, 1, 77], [54, 32, 51, 86, 59]],
[[62, 75, 62, 29, 87], [90, 26, 6, 79, 41], [31, 15, 32, 56, 64], [37, 84, 61, 71, 71]],
[[45, 24, 78, 77, 41], [75, 37, 4, 74, 93], [ 1, 36, 36, 60, 43], [23, 84, 44, 89, 79]]])方法八:创建全0、全1或指定元素的数组
使用zeros函数,代码:
array13 = np.zeros((3, 4))array13输出:
array([[0., 0., 0., 0.], [0., 0., 0., 0.], [0., 0., 0., 0.]])使用ones函数,代码:
array14 = np.ones((3, 4))array14输出:
array([[1., 1., 1., 1.], [1., 1., 1., 1.], [1., 1., 1., 1.]])使用full函数,代码:
array15 = np.full((3, 4), 10)array15输出:
array([[10, 10, 10, 10], [10, 10, 10, 10], [10, 10, 10, 10]])方法九:使用eye函数创建单位矩阵
代码:
np.eye(4)输出:
array([[1., 0., 0., 0.], [0., 1., 0., 0.], [0., 0., 1., 0.], [0., 0., 0., 1.]])方法十:读取图片获得对应的三维数组
代码:
array16 = plt.imread('guido.jpg')array16输出:
array([[[ 36, 33, 28], [ 36, 33, 28], [ 36, 33, 28], ..., [ 32, 31, 29], [ 32, 31, 27], [ 31, 32, 26]],
[[ 37, 34, 29], [ 38, 35, 30], [ 38, 35, 30], ..., [ 31, 30, 28], [ 31, 30, 26], [ 30, 31, 25]],
[[ 38, 35, 30], [ 38, 35, 30], [ 38, 35, 30], ..., [ 30, 29, 27], [ 30, 29, 25], [ 29, 30, 25]],
...,
[[239, 178, 123], [237, 176, 121], [235, 174, 119], ..., [ 78, 68, 56], [ 75, 67, 54], [ 73, 65, 52]],
[[238, 177, 120], [236, 175, 118], [234, 173, 116], ..., [ 82, 70, 58], [ 78, 68, 56], [ 75, 66, 51]],
[[238, 176, 119], [236, 175, 118], [234, 173, 116], ..., [ 84, 70, 61], [ 81, 69, 57], [ 79, 67, 53]]], dtype=uint8)说明:上面的代码读取了当前路径下名为
guido.jpg的图片文件,计算机系统中的图片通常由若干行若干列的像素点构成,而每个像素点又是由红绿蓝三原色构成的,刚好可以用三维数组来表示。读取图片用到了matplotlib库的imread函数。
数组对象的属性
size属性:获取数组元素个数。
代码:
array17 = np.arange(1, 100, 2)array18 = np.random.rand(3, 4)print(array16.size)print(array17.size)print(array18.size)输出:
11250005012shape属性:获取数组的形状。
代码:
print(array16.shape)print(array17.shape)print(array18.shape)输出:
(750, 500, 3)(50,)(3, 4)dtype属性:获取数组元素的数据类型。
代码:
print(array16.dtype)print(array17.dtype)print(array18.dtype)输出:
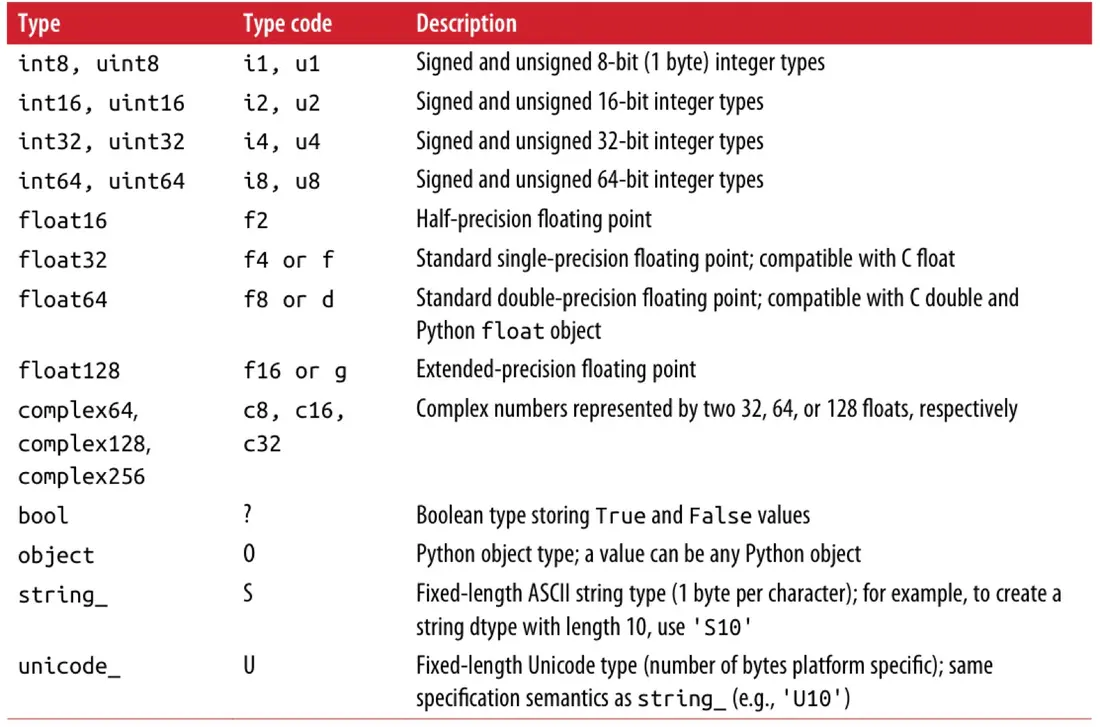
uint8int64float64ndarray对象元素的数据类型可以参考如下所示的表格。
ndim属性:获取数组的维度。
代码:
print(array16.ndim)print(array17.ndim)print(array18.ndim)输出:
312itemsize属性:获取数组单个元素占用内存空间的字节数。
代码:
print(array16.itemsize)print(array17.itemsize)print(array18.itemsize)输出:
188nbytes属性:获取数组所有元素占用内存空间的字节数。
代码:
print(array16.nbytes)print(array17.nbytes)print(array18.nbytes)输出:
112500040096数组的索引运算
和 Python 中的列表类似,NumPy 的ndarray对象可以进行索引和切片操作,通过索引可以获取或修改数组中的元素,通过切片操作可以取出数组的一部分,我们把切片操作也称为切片索引。
普通索引
类似于 Python 中list类型的索引运算。
代码:
array19 = np.arange(1, 10)print(array19[0], array19[array19.size - 1])print(array19[-array20.size], array19[-1])输出:
1 91 9代码:
array20 = np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]])array20[2]输出:
array([7, 8, 9])代码:
print(array20[0][0])print(array20[-1][-1])输出:
19代码:
print(array20[1][1])print(array20[1, 1])输出:
55代码:
array20[1][1] = 10array20输出:
array([[ 1, 2, 3], [ 4, 10, 6], [ 7, 8, 9]])代码:
array20[1] = [10, 11, 12]array20输出:
array([[ 1, 2, 3], [10, 11, 12], [ 7, 8, 9]])切片索引
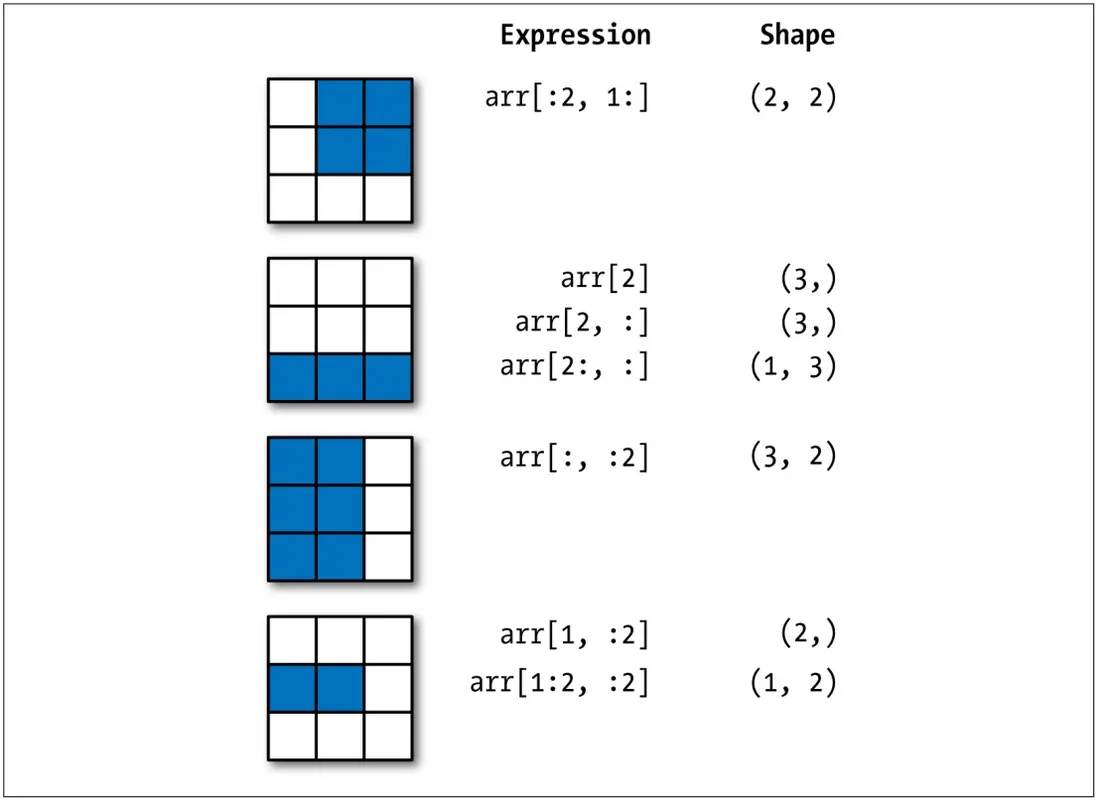
切片索引是形如[开始索引:结束索引:跨度]的语法,通过指定开始索引(默认值无穷小)、结束索引(默认值无穷大)和跨度(默认值1),从数组中取出指定部分的元素并构成新的数组。因为开始索引、结束索引和步长都有默认值,所以它们都可以省略,如果不指定步长,第二个冒号也可以省略。一维数组的切片运算跟 Python 中的list类型的切片非常类似,此处不再赘述,二维数组的切片可以参考下面的代码,相信非常容易理解。
代码:
array20[:2, 1:]输出:
array([[ 2, 3], [11, 12]])代码:
array20[2, :]输出:
array([7, 8, 9])代码:
array20[2:, :]输出:
array([[7, 8, 9]])代码:
array20[:, :2]输出:
array([[ 1, 2], [10, 11], [ 7, 8]])代码:
array20[::2, ::2]输出:
array([[1, 3], [7, 9]])代码:
array20[::-2, ::-2]输出:
array([[9, 7], [3, 1]])关于数组的索引和切片运算,大家可以通过下面的两张图来增强印象,这两张图来自《利用Python进行数据分析》一书,它是 pandas 库的作者 Wes McKinney 撰写的 Python 数据分析领域的经典教科书,有兴趣的读者可以购买和阅读原书。
图1:二维数组的普通索引
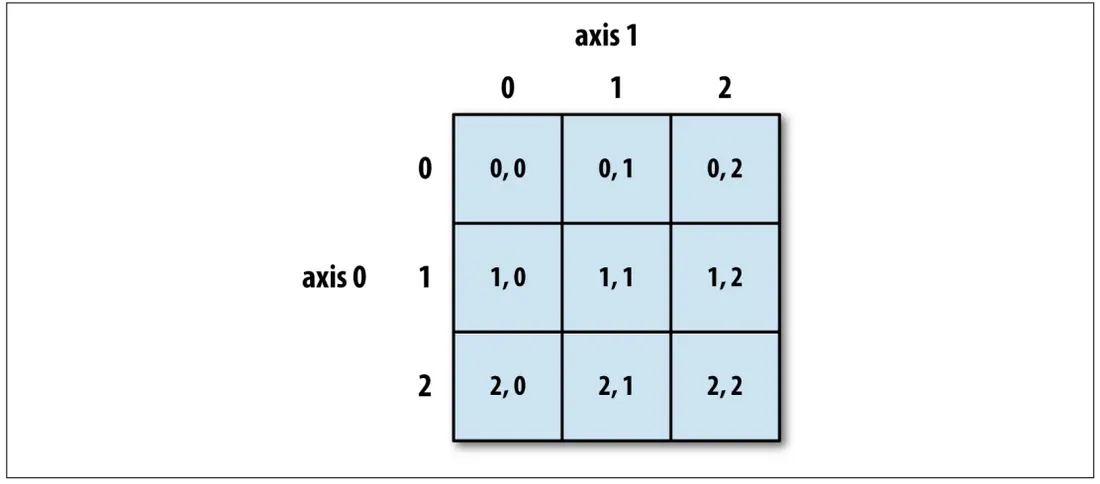
图2:二维数组的切片索引
花式索引
花式索引是用保存整数的数组充当一个数组的索引,这里所说的数组可以是 NumPy 的ndarray,也可以是 Python 中list、tuple等可迭代类型,可以使用正向或负向索引。
代码:
array19[[0, 1, 1, -1, 4, -1]]输出:
array([1, 2, 2, 9, 5, 9])代码:
array20[[0, 2]]输出:
array([[1, 2, 3], [7, 8, 9]])代码:
array20[[0, 2], [1, 2]]输出:
array([2, 9])代码:
array20[[0, 2], 1]输出:
array([2, 8])布尔索引
布尔索引就是通过保存布尔值的数组充当一个数组的索引,布尔值为True的元素保留,布尔值为False的元素不会被选中。布尔值的数组可以手动构造,也可以通过关系运算来产生。
代码:
array19[[True, True, False, False, True, False, False, True, True]]输出:
array([1, 2, 5, 8, 9])代码:
array19 > 5输出:
array([False, False, False, False, False, True, True, True, True])代码:
~(array19 > 5)输出:
array([ True, True, True, True, True, False, False, False, False])说明:
~运算符可以对布尔数组中的布尔值进行逻辑取反,也就是原来的True会变成False,原来的False会变成True。
代码:
array19[array19 > 5]输出:
array([6, 7, 8, 9])代码:
array19 % 2 == 0输出:
array([False, True, False, True, False, True, False, True, False])代码:
array19[array19 % 2 == 0]输出:
array([2, 4, 6, 8])代码:
(array19 > 5) & (array19 % 2 == 0)输出:
array([False, False, False, False, False, True, False, True, False])说明:
&运算符可以作用于两个布尔数组,如果两个数组对应元素都是True,那么运算的结果就是True,否则就是False,该运算符的运算规则类似于 Python 中的and运算符,只不过作用的对象是两个布尔数组。
代码:
array19[(array19 > 5) & (array19 % 2 == 0)]输出:
array([6, 8])代码:
array19[(array19 > 5) | (array19 % 2 == 0)]输出:
array([2, 4, 6, 7, 8, 9])说明:
|运算符可以作用于两个布尔数组,如果两个数组对应元素都是False,那么运算的结果就是False,否则就是True,该运算符的运算规则类似于 Python 中的or运算符,只不过作用的对象是两个布尔数组。
代码:
array20[array21 % 2 != 0]输出:
array([1, 3, 5, 7, 9])关于索引运算需要说明的是,切片索引虽然创建了新的数组对象,但是新数组和原数组共享了数组中的数据,简单的说,无论你通过新数组对象或原数组对象修改数组中的数据,修改的其实是内存中的同一块数据。花式索引和布尔索引也会创建新的数组对象,而且新数组复制了原数组的元素,新数组和原数组并不是共享数据的关系,这一点可以查看数组对象的base属性,有兴趣的读者可以自行探索。
案例:通过数组切片处理图像
学习基础知识总是比较枯燥且没有成就感的,所以我们还是来个案例为大家演示下上面学习的数组索引和切片操作到底有什么用。前面我们说到过,可以用三维数组来表示图像,那么通过图像对应的三维数组进行操作,就可以实现对图像的处理,如下所示。
读入图片创建三维数组对象。
guido_image = plt.imread('guido.jpg')plt.imshow(guido_image)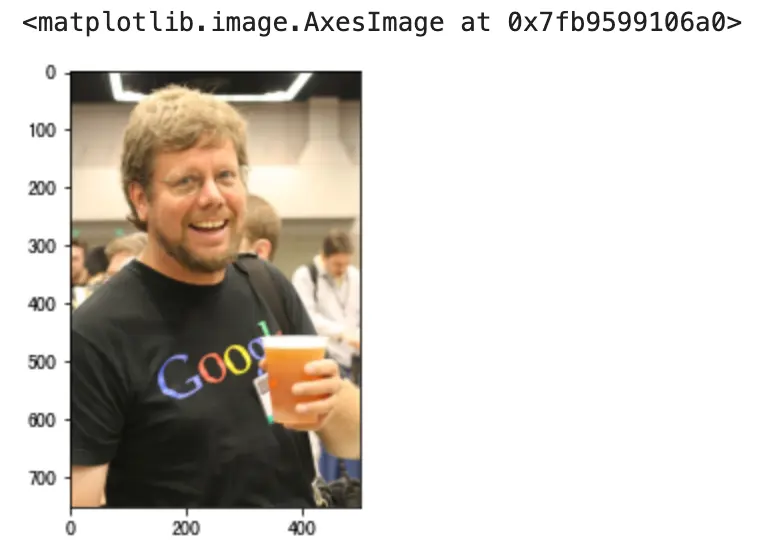
对数组的0轴进行反向切片,实现图像的垂直翻转。
plt.imshow(guido_image[::-1])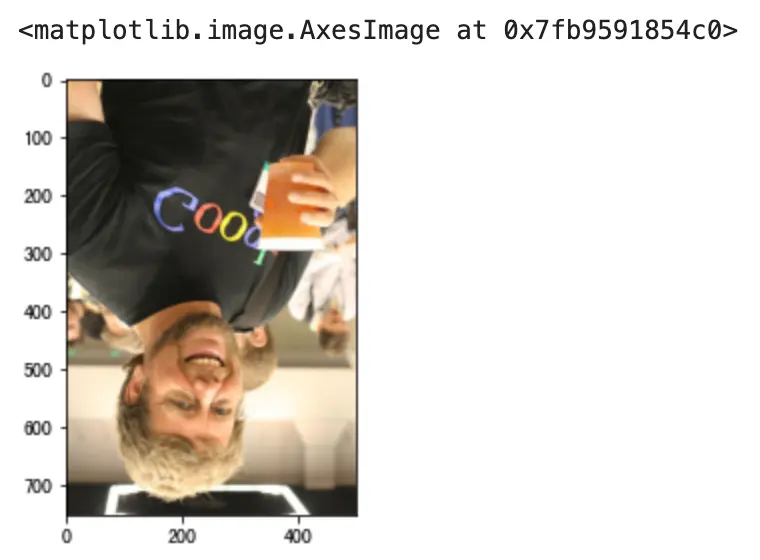
对数组的1轴进行反向切片,实现图像的水平翻转。
plt.imshow(guido_image[:,::-1])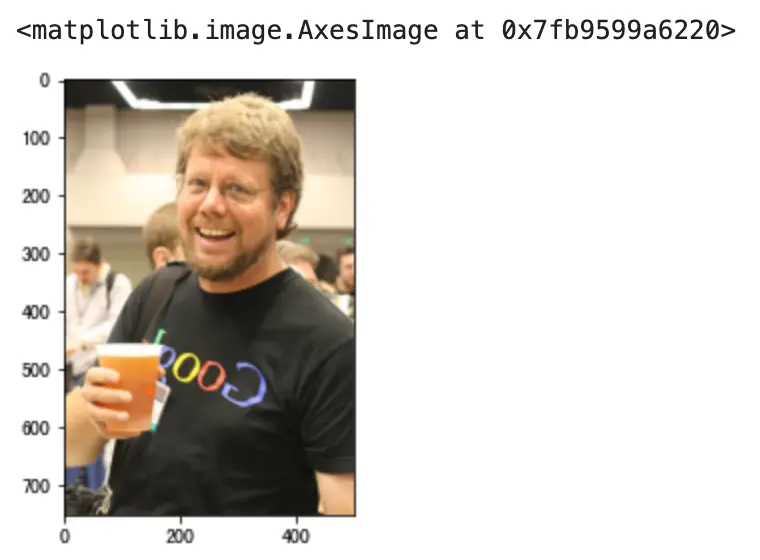
通过切片操作实现抠图,将吉多大叔的头抠出来。
plt.imshow(guido_image[30:350, 90:300])
通过切片操作实现降采样。
plt.imshow(guido_image[::10, ::10])
69 NumPy的应用-2
数组对象的方法
获取描述统计信息
描述统计信息主要包括数据的集中趋势、离散程度和频数分析等,其中集中趋势主要看均值和中位数,离散程度可以看极值、方差、标准差等。
array1 = np.random.randint(1, 100, 10)array1输出:
array([46, 51, 15, 42, 53, 71, 20, 62, 6, 94])计算总和、均值和中位数。
代码:
print(array1.sum())print(np.sum(array1))print(array1.mean())print(np.mean(array1))print(np.median(array1))print(np.quantile(array1, 0.5))说明:上面代码中的
mean、median和quantile分别是 NumPy 中计算算术平均值、中位数和分位数的函数,其中quantitle函数的第二个参数设置为0.5表示计算50%分位数,也就是中位数。
输出:
46046046.046.048.548.5极值、全距和四分位距离。
代码:
print(array1.max())print(np.amax(array1))print(array1.min())print(np.amin(array1))print(np.ptp(array1))print(np.ptp(array1))q1, q3 = np.quantile(array1, [0.25, 0.75])print(q3 - q1)输出:
949466888834.25方差、标准差和变异系数。
代码:
print(array1.var())print(np.var(array1))print(array1.std())print(np.std(array1))print(array1.std() / array1.mean())输出:
651.2651.225.5186206523785325.518620652378530.5547526228777941绘制箱线图。
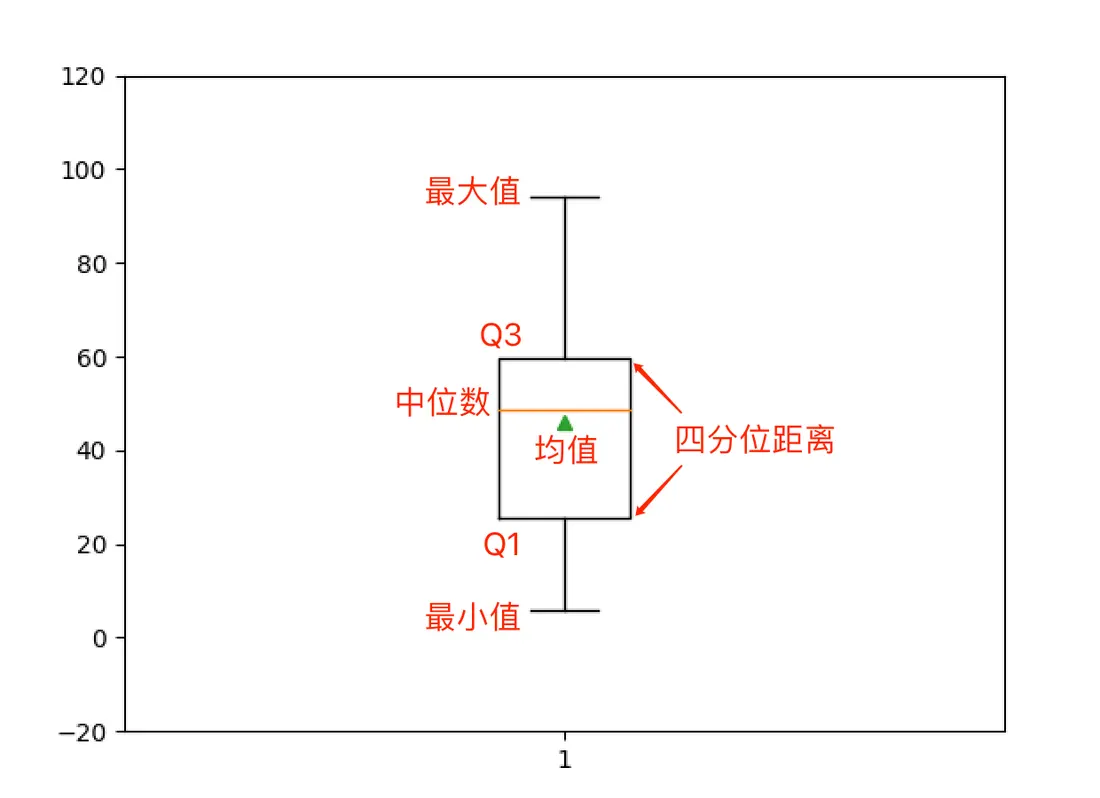
箱线图又称为盒须图,是显示一组数据分散情况的统计图,因形状如箱子而得名。 它主要用于反映原始数据分布的特征,还可以进行多组数据分布特征的比较。
代码:
plt.boxplot(array1, showmeans=True)plt.ylim([-20, 120])plt.show()输出:
值得注意的是,对于二维或更高维的数组,在获取描述统计信息时,可以通过名为axis的参数指定均值、方差等运算是沿着哪一个轴来执行,axis参数不同,执行的结果可能是大相径庭的,如下所示。
代码:
array2 = np.random.randint(60, 101, (5, 3))array2输出:
array([[72, 64, 73], [61, 73, 61], [76, 85, 77], [97, 88, 90], [63, 93, 82]])代码:
array2.mean()输出:
77.0代码:
array2.mean(axis=0)输出:
array([73.8, 80.6, 76.6])代码:
array2.mean(axis=1)输出:
array([69.66666667, 65. , 79.33333333, 91.66666667, 79.33333333])代码:
array2.max(axis=0)输出:
array([97, 93, 90])代码:
array2.max(axis=1)输出:
array([73, 73, 85, 97, 93])再看看绘制箱线图,对于二维数组每一列都会产生一个统计图形,如下所示。
代码:
plt.boxplot(array2, showmeans=True)plt.ylim([-20, 120])plt.show()输出:
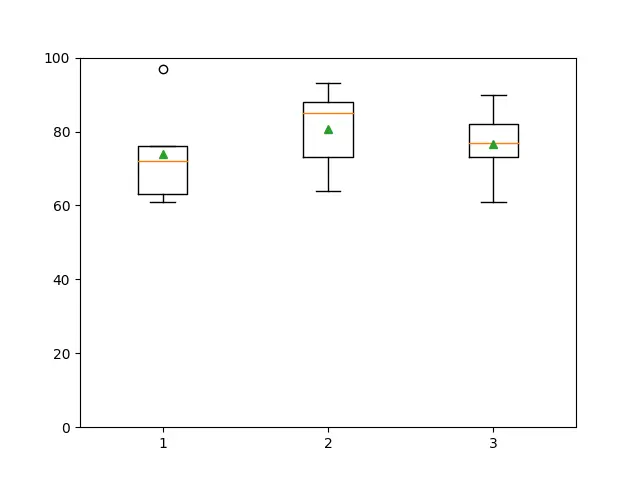
说明:箱线图中的小圆圈用来表示离群点,也就是大于 或小于 的值。公式中的常量 1.5 可以通过绘制箱线图的
boxplot函数的whis参数进行修改,常用的值是 1.5 和 3,修改为 3 通常是为了标识出极度离群点。
需要说明的是,NumPy 的数组对象并没有提供计算几何平均值、调和平均值、去尾平均值等的方法,如果有这方面的需求,可以使用名为 scipy 的三方库,它的stats模块中提供了这些函数。此外,该模块还提供了计算众数、变异系数、偏态、峰度的函数,代码如下所示。
代码:
from scipy import stats
print(np.mean(array1)) # 算术平均值print(stats.gmean(array1)) # 几何平均值print(stats.hmean(array1)) # 调和平均值print(stats.tmean(array1, [10, 90])) # 去尾平均值print(stats.variation(array1)) # 变异系数print(stats.skew(array1)) # 偏态系数print(stats.kurtosis(array1)) # 峰度系数输出:
46.036.2234954882559924.49721953082549745.00.55475262287779410.11644192634527782-0.7106251396024126其他相关方法概述
-
all()/any()方法:判断数组是否所有元素都是True/ 判断数组是否有为True的元素。 -
astype()方法:拷贝数组,并将数组中的元素转换为指定的类型。 -
reshape()方法:调整数组对象的形状。 -
dump()方法:保存数组到二进制文件中,可以通过 NumPy 中的load()函数从保存的文件中加载数据创建数组。代码:
array.dump('array1-data')array3 = np.load('array1-data', allow_pickle=True)array3输出:
array([46, 51, 15, 42, 53, 71, 20, 62, 6, 94]) -
tofile()方法:将数组对象写入文件中。array1.tofile('array.txt', sep=',') -
fill()方法:向数组中填充指定的元素。 -
flatten()方法:将多维数组扁平化为一维数组。代码:
array2.flatten()输出:
array([1, 2, 3, 4, 5, 6, 7, 8, 9]) -
nonzero()方法:返回非0元素的索引。 -
round()方法:对数组中的元素做四舍五入操作。 -
sort()方法:对数组进行就地排序。代码:
array1.sort()array1输出:
array([ 6, 15, 20, 42, 46, 51, 53, 62, 71, 94]) -
swapaxes()和transpose()方法:交换数组指定的轴和转置。代码:
array2.swapaxes(0, 1)输出:
array([[1, 4, 7],[2, 5, 8],[3, 6, 9]])代码:
array2.transpose()输出:
array([[1, 4, 7],[2, 5, 8],[3, 6, 9]]) -
tolist()方法:将数组转成 Python 中的list。代码:
print(array2.tolist())print(type(array2.tolist()))输出:
[[1, 2, 3], [4, 5, 6], [7, 8, 9]]<class 'list'>
70 NumPy的应用-3
数组的运算
使用 NumPy 最为方便的是当需要对数组元素进行运算时,不用编写循环代码遍历每个元素,所有的运算都会自动的矢量化。简单的说就是,NumPy 中的数学运算和数学函数会自动作用于数组中的每个成员。
数组跟标量的运算
NumPy 的数组可以跟一个数值进行加、减、乘、除、求模、求幂等运算,对应的运算会作用到数组的每一个元素上,如下所示。
代码:
array1 = np.arange(1, 10)print(array1 + 10)print(array1 * 10)输出:
[11 12 13 14 15 16 17 18 19][10 20 30 40 50 60 70 80 90]除了上述的运算,关系运算也是没有问题的,之前讲布尔索引的时候已经遇到过了。
代码:
print(array1 > 5)print(array1 % 2 == 0)输出:
[False False False False False True True True True][False True False True False True False True False]数组跟数组的运算
NumPy 的数组跟数组也可以执行算术运算和关系运算,运算会作用于两个数组对应的元素上,这就要求两个数组的形状(shape属性)要相同,如下所示。
代码:
array2 = np.array([1, 1, 1, 2, 2, 2, 3, 3, 3])print(array1 + array2)print(array1 * array2)print(array1 ** array2)输出:
[ 2 3 4 6 7 8 10 11 12][ 1 2 3 8 10 12 21 24 27][ 1 2 3 16 25 36 343 512 729]代码:
print(array1 > array2)print(array1 % array2 == 0)输出:
[False True True True True True True True True][ True True True True False True False False True]通用一元函数
NumPy 中通用一元函数的参数是一个数组对象,函数会对数组进行元素级的处理,例如:sqrt函数会对数组中的每个元素计算平方根,而log2函数会对数组中的每个元素计算以2为底的对数,代码如下所示。
代码:
print(np.sqrt(array1))print(np.log2(array1))输出:
[1. 1.41421356 1.73205081 2. 2.23606798 2.44948974 2.64575131 2.82842712 3. ][0. 1. 1.5849625 2. 2.32192809 2.5849625 2.80735492 3. 3.169925 ]表1:通用一元函数
| 函数 | 说明 |
|---|---|
abs / fabs | 求绝对值的函数 |
sqrt | 求平方根的函数,相当于array ** 0.5 |
square | 求平方的函数,相当于array ** 2 |
exp | 计算 的函数,相当于np.e ** array |
log / log10 / log2 | 对数函数(e为底 / 10为底 / 2为底) |
sign | 符号函数(1 - 正数;0 - 零;-1 - 负数) |
ceil / floor | 上取整 / 下取整 |
isnan | 返回布尔数组,NaN对应True,非NaN对应False |
isfinite / isinf | 判断数值是否为无穷大的函数 |
cos / cosh / sin | 三角函数 |
sinh / tan / tanh | 三角函数 |
arccos / arccosh / arcsin | 反三角函数 |
arcsinh / arctan / arctanh | 反三角函数 |
rint / round | 四舍五入函数 |
通用二元函数
NumPy 中通用二元函数的参数是两个数组对象,函数会对两个数组中的对应元素进行运算,例如:maximum函数会对两个数组中对应的元素找最大值,而power函数会对两个数组中对应的元素进行求幂操作,代码如下所示。
代码:
array3 = np.array([[4, 5, 6], [7, 8, 9]])array4 = np.array([[1, 2, 3], [3, 2, 1]])print(np.maximum(array3, array4))print(np.power(array3, array4))输出:
[[4 5 6] [7 8 9]][[ 4 25 216] [343 64 9]]表2:通用二元函数
| 函数 | 说明 |
|---|---|
add(x, y) / substract(x, y) | 加法函数 / 减法函数 |
multiply(x, y) / divide(x, y) | 乘法函数 / 除法函数 |
floor_divide(x, y) / mod(x, y) | 整除函数 / 求模函数 |
allclose(x, y) | 检查数组x和y元素是否几乎相等 |
power(x, y) | 数组x的元素 和数组y的元素 ,计算 |
maximum(x, y) / fmax(x, y) | 两两比较元素获取最大值 / 获取最大值(忽略NaN) |
minimum(x, y) / fmin(x, y) | 两两比较元素获取最小值 / 获取最小值(忽略NaN) |
dot(x, y) | 点积运算(数量积,通常记为 ,用于欧几里得空间(Euclidean space)) |
inner(x, y) | 内积运算(内积的含义要高于点积,点积相当于是内积在欧几里得空间 的特例,而内积可以推广到赋范向量空间,只要它满足平行四边形法则即可) |
cross(x, y) | 叉积运算(向量积,通常记为 ,运算结果是一个向量) |
outer(x, y) | 外积运算(张量积,通常记为 ,运算结果通常是一个矩阵) |
intersect1d(x, y) | 计算x和y的交集,返回这些元素构成的有序数组 |
union1d(x, y) | 计算x和y的并集,返回这些元素构成的有序数组 |
in1d(x, y) | 返回由判断x 的元素是否在y中得到的布尔值构成的数组 |
setdiff1d(x, y) | 计算x和y的差集,返回这些元素构成的数组 |
setxor1d(x, y) | 计算x和y的对称差,返回这些元素构成的数组 |
说明:关于向量和矩阵的运算,我们在下一个章节加以说明。
广播机制
上面数组运算的例子中,两个数组的形状(shape属性)是完全相同的,我们再来研究一下,两个形状不同的数组是否可以直接做二元运算或使用通用二元函数进行运算,请看下面的例子。
代码:
array5 = np.array([[0, 0, 0], [1, 1, 1], [2, 2, 2], [3, 3, 3]])array6 = np.array([1, 2, 3])array5 + array6输出:
array([[1, 2, 3], [2, 3, 4], [3, 4, 5], [4, 5, 6]])代码:
array7 = np.array([[1], [2], [3], [4]])array5 + array7输出:
array([[1, 1, 1], [3, 3, 3], [5, 5, 5], [7, 7, 7]])通过上面的例子,我们发现形状不同的数组仍然有机会进行二元运算,但这不代表任意形状的数组都可以进行二元运算。简单的说,只有两个数组后缘维度相同或者后缘维度不同但其中一个数组后缘维度为1时,广播机制才会被触发。通过广播机制,NumPy 将两个原本形状不相同的数组变成形状相同,才能进行二元运算。所谓后缘维度,指的是数组形状(shape属性)从后往前看对应的部分,我们举例说明。
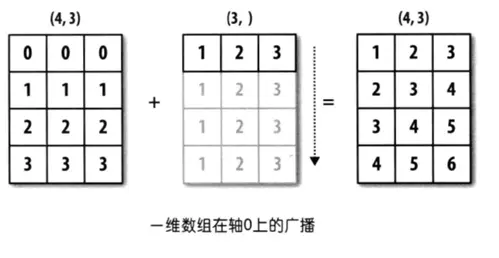
上图中,一个数组的形状是(4, 3),另一个数组的形状是(3, ),从后往前看对应的部分都是3,属于后缘维度相同,可以应用广播机制,第二个数组会沿着缺失元素那个轴的方向去广播自己,最终让两个数组形状达成一致。
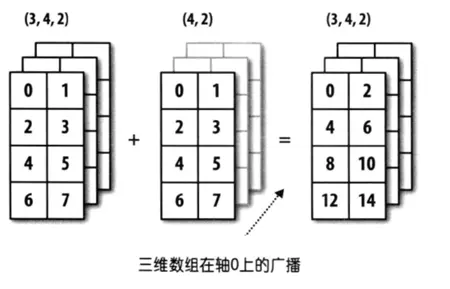
上图中,一个数组的形状是(3, 4, 2),另一个数组的形状是(4, 2),从后往前看对应的部分都是(4, 2),属于后缘维度相同,可以应用广播机制,第二个数组会沿着缺失元素那个轴的方向去广播自己,最终让两个数组形状达成一致。
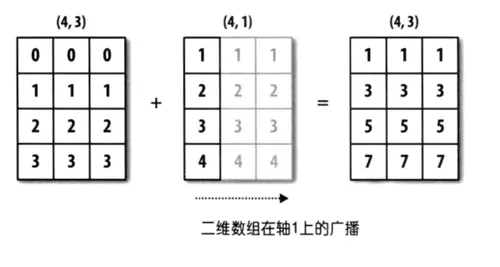
上图中,一个数组的形状是(4, 3),另一个数组的形状是(4, 1),这是后缘维度不相同的情况,但是第二个数组跟第一个数组不同的地方为1,第二个数组可以沿着为1 的那个轴广播自己,最终让两个数组形状达成一致。
思考:一个3行1列的二维数组和一个1行3列的二维数组能够执行加法运算吗?
其他常用函数
除了上面讲到的函数外,NumPy 中还提供了很多用于处理数组的函数,ndarray对象的很多方法也可以通过调用函数来实现,下表给出了一些常用的函数。
表3:NumPy其他常用函数
| 函数 | 说明 |
|---|---|
unique | 去除数组重复元素,返回唯一元素构成的有序数组 |
copy | 返回拷贝数组得到的数组 |
sort | 返回数组元素排序后的拷贝 |
split / hsplit / vsplit | 将数组拆成若干个子数组 |
stack / hstack / vstack | 将多个数组堆叠成新数组 |
concatenate | 沿着指定的轴连接多个数组构成新数组 |
append / insert | 向数组末尾追加元素 / 在数组指定位置插入元素 |
argwhere | 找出数组中非0元素的位置 |
extract / select / where | 按照指定的条件从数组中抽取或处理数组元素 |
flip | 沿指定的轴翻转数组中的元素 |
fromregex | 通过读取文件和正则表达式解析获取数据创建数组对象 |
repeat / tile | 通过对元素的重复来创建新数组 |
roll | 沿指定轴对数组元素进行移位 |
resize | 重新调整数组的大小 |
place / put | 将数组中满足条件的元素/指定的元素替换为指定的值 |
partition | 用选定的元素对数组进行一次划分并返回划分后的数组 |
去重(重复元素只保留一项)。
代码:
np.unique(array5)输出:
array([0, 1, 2, 3])堆叠和拼接。
代码:
array8 = np.array([[1, 1, 1], [2, 2, 2], [3, 3, 3]])array9 = np.array([[4, 4, 4], [5, 5, 5], [6, 6, 6]])np.hstack((array8, array9))输出:
array([[1, 1, 1, 4, 4, 4], [2, 2, 2, 5, 5, 5], [3, 3, 3, 6, 6, 6]])代码:
np.vstack((array8, array9))输出:
array([[1, 1, 1], [2, 2, 2], [3, 3, 3], [4, 4, 4], [5, 5, 5], [6, 6, 6]])代码:
np.concatenate((array8, array9))输出:
array([[1, 1, 1], [2, 2, 2], [3, 3, 3], [4, 4, 4], [5, 5, 5], [6, 6, 6]])代码:
np.concatenate((array8, array9), axis=1)输出:
array([[1, 1, 1, 4, 4, 4], [2, 2, 2, 5, 5, 5], [3, 3, 3, 6, 6, 6]])追加和插入元素。
代码:
np.append(array1, [10, 100])输出:
array([ 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 100])代码:
np.insert(array1, 1, [98, 99, 100])输出:
array([ 1, 98, 99, 100, 2, 3, 4, 5, 6, 7, 8, 9])抽取和处理元素。
代码:
np.extract(array1 % 2 != 0, array1)输出:
array([1, 3, 5, 7, 9])说明:上面
extract函数的操作相当于我们之前讲的布尔索引。
代码:
np.select([array1 <= 3, array1 >= 7], [array1 * 10, array1 ** 2])输出:
array([10, 20, 30, 0, 0, 0, 49, 64, 81])说明:上面
select函数的第一个参数设置了两个条件,满足第一个条件的元素执行了乘以10的操作,满足第二个条件的元素执行了求平方的操作,两个条件都不能满足的数组元素会被处理为0。
代码:
np.where(array1 <= 5, array1 * 10, array1 ** 2)输出:
array([10, 20, 30, 40, 50, 36, 49, 64, 81])说明:上面
where函数的第一个参数给出了条件,满足条件的元素执行了乘以10的操作,不能满足条件的元素执行了求平方的操作。
重复数组元素创建新数组。
代码:
np.repeat(array1, 3)输出:
array([1, 1, 1, 2, 2, 2, 3, 3, 3, 4, 4, 4, 5, 5, 5, 6, 6, 6, 7, 7, 7, 8, 8, 8, 9, 9, 9])代码:
np.tile(array1, 2)输出:
array([1, 2, 3, 4, 5, 6, 7, 8, 9, 1, 2, 3, 4, 5, 6, 7, 8, 9])调整数组大小。
代码:
np.resize(array1, (5, 3))输出:
array([[1, 2, 3], [4, 5, 6], [7, 8, 9], [1, 2, 3], [4, 5, 6]])提示:
array1原本是一个有9个元素的一维数组,通过resize函数调整成为5行3列共15个元素的二维数组,缺少的元素通过复用原数组中的元素来补充。
代码:
np.resize(array5, (2, 4))输出:
array([[0, 0, 0, 1], [1, 1, 2, 2]])替换数组元素。
代码:
np.put(array1, [0, 1, -1, 3, 5], [100, 200])array1输出:
array([100, 200, 3, 200, 5, 100, 7, 8, 100])说明:上面
put函的第二个参数给出了要被替换的元素的索引,但是用来作为替换值的元素只有100和200,所以这两个值会被循环使用,因此索引为0、1、-1、3、5的元素被依次替换成了100、200、100、200、100。
代码:
np.place(array1, array1 > 5, [1, 2, 3])array1输出:
array([1, 2, 3, 3, 5, 1, 2, 3, 1])注意:
put函数和place函数都没有返回新的数组对象,而是在原来的数组上直接进行替换。
71 NumPy的应用-4
向量
向量(vector)也叫矢量,是一个同时具有大小和方向,且满足平行四边形法则的几何对象。与向量相对的概念叫标量或数量,标量只有大小,绝大多数情况下没有方向。我们通常用带箭头的线段来表示向量,在平面直角坐标系中的向量如下图所示。需要注意的是,向量是表达大小和方向的量,并没有规定起点和终点,所以相同的向量可以画在任意位置,例如下图中 和 两个向量并没有什么区别。
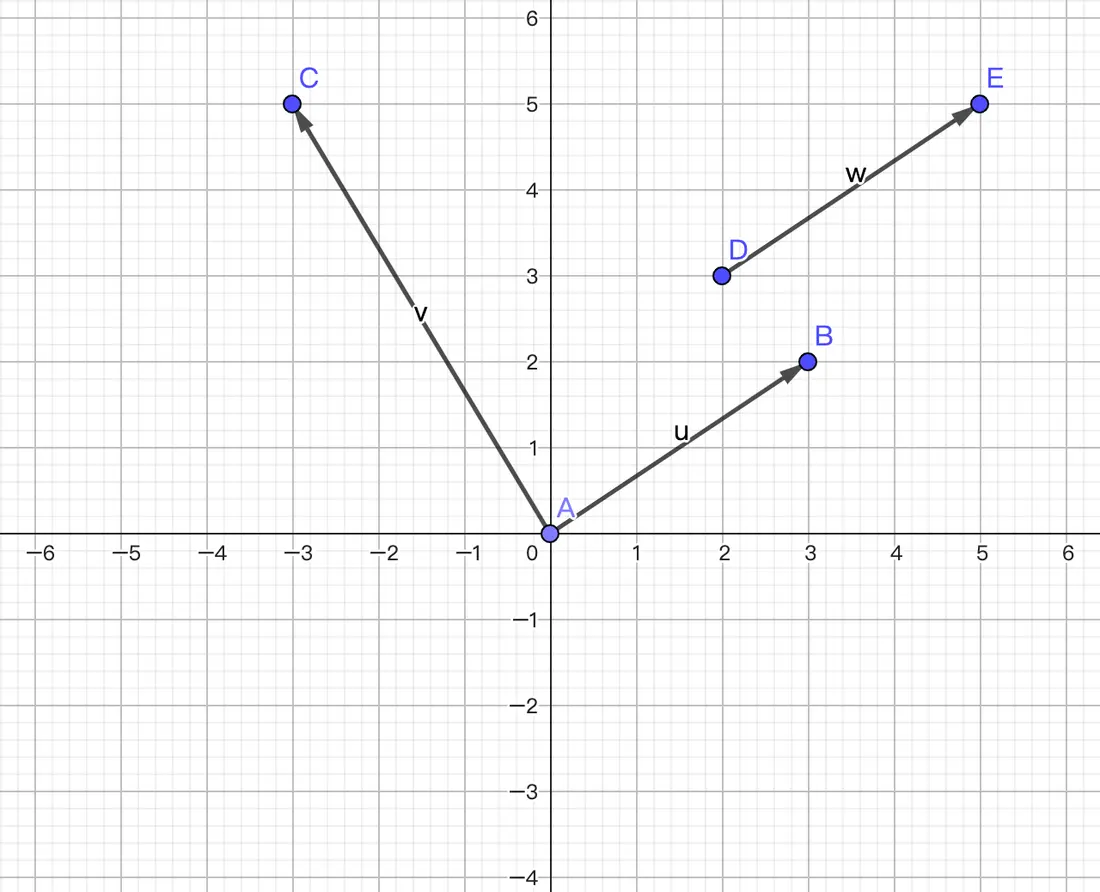
向量有很多种代数表示法,对于二维空间的向量,下面几种写法都是可以的。
向量的大小称为向量的模,它是一个标量,对于二维空间的向量,模可以通过下面的公式计算。
注意,这里的 并不是绝对值,你可以将其称为向量 的二范数,这是数学中的符号重用现象。上面的写法和概念也可以推广到 维空间,我们通常用 表示 维空间,我们刚才说的二维空间可以记为 ,三维空间可以记为 。虽然生活在三维空间的我们很难想象四维空间、五维空间是什么样子,但是这并不影响我们探讨高维空间,机器学习中,我们经常把有 个特征的训练样本称为一个 维向量。
向量的加法
相同维度的向量可以相加得到一个新的向量,运算的方法是将向量的每个分量相加,如下所示。
向量的加法满足“平行四边形法则”,即两个向量 和 构成了平行四边形的两条邻边,相加的结果是平行四边形的对角线,如下图所示。
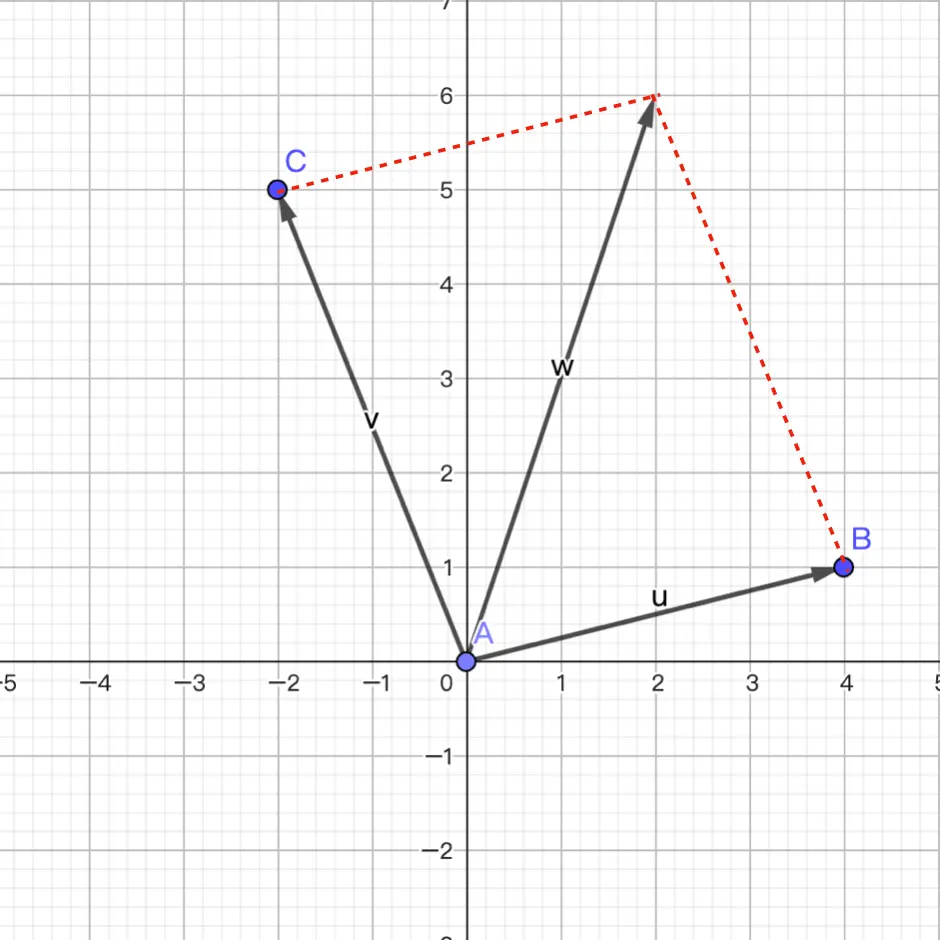
向量的数乘
一个向量 可以和一个标量 相乘,运算的方法是将向量中的每个分量与该标量相乘即可,如下所示。
我们可以用 NumPy 的数组来表示向量,向量的加法可以通过两个数组的加法来实现,向量的数乘可以通过数组和标量的乘法来实现,此处不再进行赘述。
向量的点积
点积(dot product)是两个向量之间最为重要的运算之一,运算的方法是将两个向量对应分量的乘积求和,所以点积的结果是一个标量,其几何意义是两个向量的模乘以二者夹角的余弦如下所示。
假如我们用三维向量来表示用户对喜剧片、言情片和动作片这三类电影的偏好,我们用 1 到 5 的数字来表示喜欢的程度,其中 5 表示非常喜欢,4 表示比较喜欢,3 表示无感,2 表示比较反感,1 表示特别反感。那么,下面的向量表示用户非常喜欢喜剧片,特别反感言情片,对动作片不喜欢也不反感。
现在有两部电影上映了,一部属于言情喜剧片,一部属于喜剧动作片,我们把两部电影也通过3维向量的方式进行表示,如下所示。
如果现在我们需要向刚才的用户推荐一部电影,我们应该给他推荐哪一部呢?我们可以将代表用户的向量 和代表电影的向量 和 分别进行点积运算,再除以向量的模长,得到向量夹角的余弦值,余弦值越接近 1,说明向量的夹角越接近 0 度,也就是两个向量的相似度越高。很显然,我们应该向用户推荐跟他观影喜好相似度更高的电影。
大家可能会说,向量 代表的电影肉眼可见跟用户是更加匹配的。的确,对于一个三维向量我们凭借直觉也能够给出正确的答案,但是对于一个 维向量,当 的值非常大时,你还有信心凭借肉眼的观察和本能的直觉给出准确的答案吗?向量的点积可以通过dot函数来计算,而向量的模长可以通过 NumPy 的linalg模块中的norm函数来计算,代码如下所示。
u = np.array([5, 1, 3])m1 = np.array([4, 5, 1])m2 = np.array([5, 1, 5])print(np.dot(u, m1) / (np.linalg.norm(u) * np.linalg.norm(m1))) # 0.7302967433402214print(np.dot(u, m2) / (np.linalg.norm(u) * np.linalg.norm(m2))) # 0.9704311900788593向量的叉积
在二维空间,两个向量的叉积是这样定义的:
对于三维空间,两个向量的叉积结果是一个向量,如下所示:
因为叉积的结果是向量,所以 和 的结果并不相同,事实上:
NumPy 中可以通过cross函数来计算向量的叉积,代码如下所示。
print(np.cross(u, m1)) # [-14 7 21]print(np.cross(m1, u)) # [ 14 -7 -21]行列式
行列式(determinant)通常记作 或 ,其中 是一个 阶方阵。行列式可以看做是有向面积或体积的概念在一般欧几里得空间的推广,或者说行列式描述的是一个线性变换对“体积”所造成的影响。行列式的概念最早出现在解线性方程组的过程中,十七世纪晚期,关孝和(日本江户时代的数学家)与莱布尼茨的著作中已经使用行列式来确定线性方程组解的个数以及形式;十八世纪开始,行列式开始作为独立的数学概念被研究;十九世纪以后,行列式理论进一步得到发展和完善。
行列式的性质
行列式是由向量引出的,所以行列式解释的其实是向量的性质。
性质1:如果 中某行(或某列)的元素全部为 0,那么 。
性质2:如果 中某行(或某列)有公共因子 ,则可以提出 ,得到行列式 ,且 。
性质3:如果 中某行(或某列)的每个元素是两数之和,则此行列式可拆分为两个行列式相加,如下所示。
性质4:如果 中两行(或两列)元素对应成比例,那么 。
性质5:如果 中两行(或两列)互换得到 ,那么 。
性质6:将 中某行(或某列)的 倍加进另一行(或另一列)里,行列式的值不变,如下所示。
性质7:将行列式的行列互换,行列式的值不变,如下所示。
性质8:方块矩阵 和 的乘积的行列式等于其行列式的乘积,即 。特别的,若将矩阵中的每一行都乘以常数 ,那么行列式的值将是原来的 倍,即 ,其中 是 阶单位矩阵。
性质9:若 是可逆矩阵,那么 。
行列式的计算
阶行列式的计算公式如下所示:
对于二阶行列式,上面的公式相当于:
对于三阶行列式,上面的计算公式相当于:
高阶行列式可以用代数余子式(cofactor)展开成多个低阶行列式,如下所示:
其中, 是原行列式去掉 所在行和列之后剩余的部分构成的行列式,以此类推。
矩阵
矩阵(matrix)是由一系列元素排成的矩形阵列,矩阵里的元素可以是数字、符号或数学公式。矩阵可以进行加法、减法、数乘、转置、矩阵乘法等运算,如下图所示。
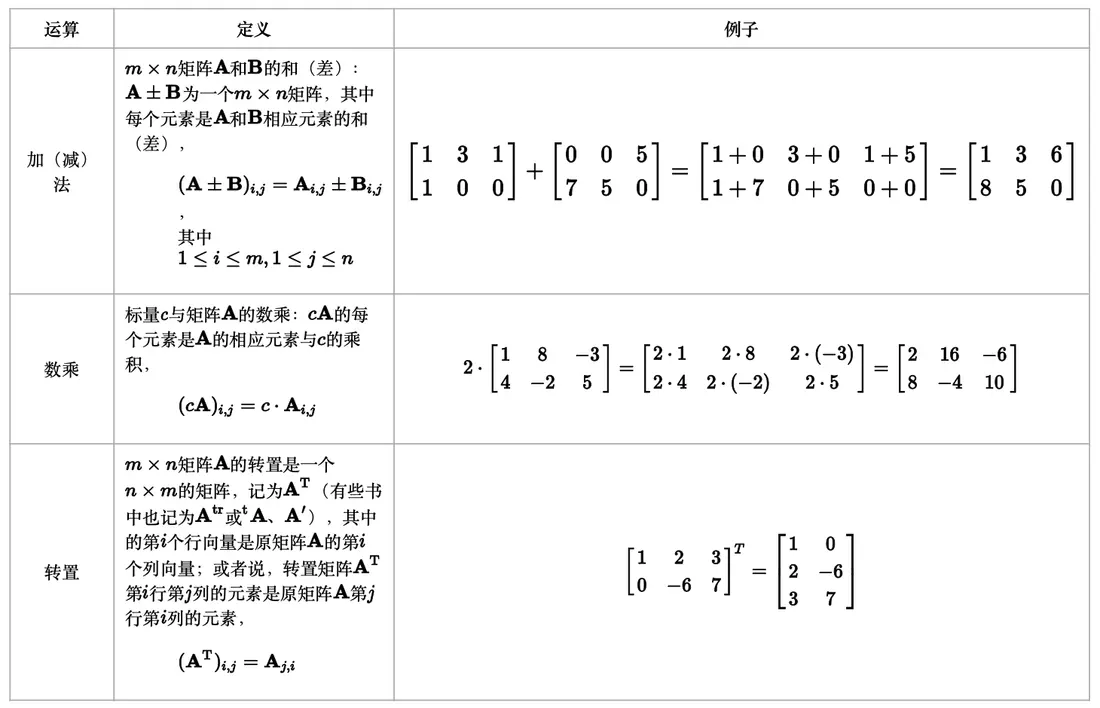
值得一提的是矩阵乘法运算,该运算仅当第一个矩阵 的列数和另一个矩阵 的行数相等时才能定义。如果 是一个 的矩阵, 是一个 矩阵,它们的乘积是一个 的矩阵,如下图所示。
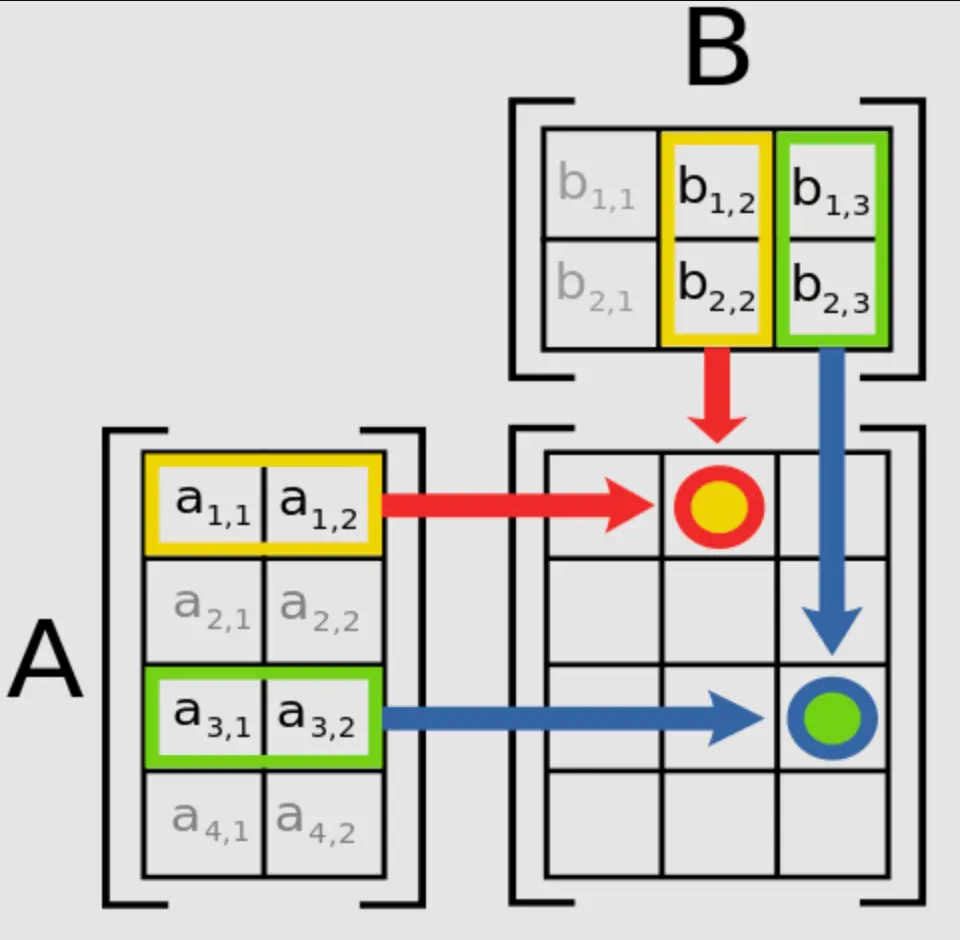
例如:
矩阵的乘法满足结合律和对矩阵加法的分配律:
结合律: 。
左分配律: 。
右分配律: 。
矩阵乘法不满足交换律。一般情况下,矩阵 和 的乘积 存在,但 不一定存在,即便 存在,大多数时候 。
矩阵乘法的一个基本应用是在线性方程组上。线性方程组是方程组的一种,它符合以下的形式:
运用矩阵的方式,可以将线性方程组写成一个向量方程:
其中, 是由方程组里未知数的系数排成的 矩阵, 是含有 个元素的行向量, 是含有 个元素的行向量。
矩阵是线性变换(保持向量加法和标量乘法的函数)的便利表达法。矩阵乘法的本质在联系到线性变换的时候最能体现,因为矩阵乘法和线性变换的合成有以下的联系,即每个 的矩阵 都代表了一个从 射到 的线性变换。如果无法理解上面这些内容,推荐大家看看B站上名为《线性代数的本质》的视频,相信这套视频会让你对线性代数有一个更好的认知。
下图是一个来自于维基百科的例子,图中展示了一些典型的二维实平面上的线性变换对平面向量(图形)造成的效果以及它们对应的二维矩阵,其中每个线性变换将蓝色图形映射成绿色图形;平面的原点 用黑点表示。
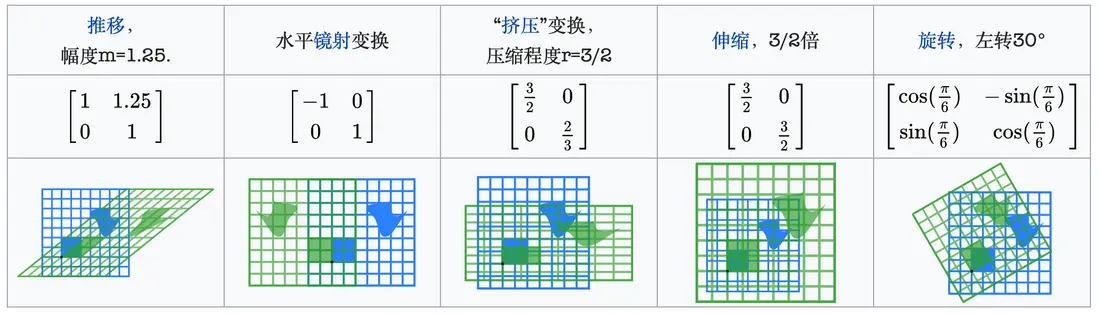
矩阵对象
NumPy 中提供了专门用于线性代数(linear algebra)的模块和表示矩阵的类型matrix,当然我们通过二维数组也可以表示一个矩阵,官方并不推荐使用matrix类而是建议使用二维数组,而且有可能在将来的版本中会移除matrix类。无论如何,利用这些已经封装好的类和函数,我们可以轻松愉快的实现很多对矩阵的操作。
我们可以通过下面的代码来创建矩阵(matrix)对象。
代码:
m1 = np.matrix('1 2 3; 4 5 6')m1说明:
matrix构造器可以传入类数组对象也可以传入字符串来构造矩阵对象。
输出:
matrix([[1, 2, 3], [4, 5, 6]])代码:
m2 = np.asmatrix(np.array([[1, 1], [2, 2], [3, 3]]))m2说明:
asmatrix函数也可以用mat函数代替,这两个函数其实是同一个函数。
输出:
matrix([[1, 1], [2, 2], [3, 3]])代码:
m1 * m2输出:
matrix([[14, 14], [32, 32]])说明:注意
matrix对象和ndarray对象乘法运算的差别,matrix对象的*运算是矩阵乘法运算。如果两个二维数组要做矩阵乘法运算,应该使用@运算符或matmul函数,而不是*运算符。
矩阵对象的属性如下表所示。
| 属性 | 说明 |
|---|---|
A | 获取矩阵对象对应的ndarray对象 |
A1 | 获取矩阵对象对应的扁平化后的ndarray对象 |
I | 可逆矩阵的逆矩阵 |
T | 矩阵的转置 |
H | 矩阵的共轭转置 |
shape | 矩阵的形状 |
size | 矩阵元素的个数 |
矩阵对象的方法跟之前讲过的ndarray数组对象的方法基本差不多,此处不再进行赘述。
线性代数模块
NumPy 的linalg模块中有一组标准的矩阵分解运算以及诸如求逆和行列式之类的函数,它们跟 MATLAB 和 R 等语言所使用的是相同的行业标准线性代数库,下面的表格列出了numpy以及linalg模块中一些常用的线性代数相关函数。
| 函数 | 说明 |
|---|---|
diag | 以一维数组的形式返回方阵的对角线元素或将一维数组转换为方阵(非对角元素元素为0) |
matmul | 矩阵乘法运算 |
trace | 计算对角线元素的和 |
norm | 求矩阵或向量的范数 |
det | 计算行列式的值 |
matrix_rank | 计算矩阵的秩 |
eig | 计算矩阵的特征值(eigenvalue)和特征向量(eigenvector) |
inv | 计算非奇异矩阵( 阶方阵)的逆矩阵 |
pinv | 计算矩阵的摩尔-彭若斯(Moore-Penrose)广义逆 |
qr | QR分解(把矩阵分解成一个正交矩阵与一个上三角矩阵的积) |
svd | 计算奇异值分解(singular value decomposition) |
solve | 解线性方程组 ,其中 是一个方阵 |
lstsq | 计算 的最小二乘解 |
下面我们简单尝试一下上面的函数,先试一试求逆矩阵。
代码:
m3 = np.array([[1., 2.], [3., 4.]])m4 = np.linalg.inv(m3)m4输出:
array([[-2. , 1. ], [ 1.5, -0.5]])代码:
np.around(m3 @ m4)说明:
around函数对数组元素进行四舍五入操作,默认小数点后面的位数为0。
输出:
array([[1., 0.], [0., 1.]])说明:矩阵和它的逆矩阵做矩阵乘法会得到单位矩阵。
计算行列式的值。
代码:
m5 = np.array([[1, 3, 5], [2, 4, 6], [4, 7, 9]])np.linalg.det(m5)输出:
2计算矩阵的秩。
代码:
np.linalg.matrix_rank(m5)输出:
3求解线性方程组。
对于上面的线性方程组,我们可以用矩阵的形式来表示它,如下所示。
线性方程组有唯一解的条件:系数矩阵 的秩等于增广矩阵 的秩,而且跟未知数的个数相同。
代码:
A = np.array([[1, 2, 1], [3, 7, 2], [2, 2, 1]])b = np.array([8, 23, 9]).reshape(-1, 1)print(np.linalg.matrix_rank(A))print(np.linalg.matrix_rank(np.hstack((A, b))))说明:使用数组对象的
reshape方法调形时,如果其中一个参数为-1,那么该维度有多少个元素是通过数组元素个数(size属性)和其他维度的元素个数自动计算出来的。
输出:
33代码:
np.linalg.solve(A, b)输出:
array([[1.], [2.], [3.]])说明:上面的结果表示,线性方程组的解为: 。
下面是另一种求解线性方程组的方法,大家可以停下来思考下为什么。
代码:
np.linalg.inv(A) @ b输出:
array([[1.], [2.], [3.]])多项式
除了数组,NumPy 中还封装了用于多项式(polynomial)运算的数据类型。多项式是变量的整数次幂与系数的乘积之和,形如:
在 NumPy 1.4版本之前,我们可以用poly1d类型来表示多项式,目前它仍然可用,但是官方提供了新的模块numpy.polynomial,它除了支持基本的幂级数多项式外,还可以支持切比雪夫多项式、拉盖尔多项式等。
创建多项式对象
创建poly1d对象,例如: 。
代码:
p1 = np.poly1d([3, 2, 1])p2 = np.poly1d([1, 2, 3])print(p1)print(p2)输出:
23 x + 2 x + 1 21 x + 2 x + 3多项式的操作
获取多项式的系数
代码:
print(p1.coefficients)print(p2.coeffs)输出:
[3 2 1][1 2 3]两个多项式的四则运算
代码:
print(p1 + p2)print(p1 * p2)输出:
24 x + 4 x + 4 4 3 23 x + 8 x + 14 x + 8 x + 3带入 求多项式的值
代码:
print(p1(3))print(p2(3))输出:
3418多项式求导和不定积分
代码:
print(p1.deriv())print(p1.integ())输出:
6 x + 2 3 21 x + 1 x + 1 x求多项式的根
例如有多项式 ,多项式的根即一元二次方程 的解。
代码:
p3 = np.poly1d([1, 3, 2])print(p3.roots)输出:
[-2. -1.]如果使用numpy.polynomial模块的Polynomial类来表示多项式对象,那么对应的操作如下所示。
代码:
from numpy.polynomial import Polynomial
p3 = Polynomial((2, 3, 1))print(p3) # 输出多项式print(p3(3)) # 令x=3,计算多项式的值print(p3.roots()) # 计算多项式的根print(p3.degree()) # 获得多项式的次数print(p3.deriv()) # 求导print(p3.integ()) # 求不定积分输出:
2.0 + 3.0·x + 1.0·x²20.0[-2. -1.]23.0 + 2.0·x0.0 + 2.0·x + 1.5·x² + 0.33333333·x³最小二乘解
Polynomial类还有一个名为fit的类方法,它可以给多项式求最小二乘解。所谓最小二乘解(least-squares solution),是用最小二乘法通过最小化误差的平方和来寻找数据的最佳匹配函数的系数。假设多项式为 ,最小二乘解就是让下面的残差平方和 达到最小的 和 。
例如,我们想利用收集到的月收入和网购支出的历史数据来建立一个预测模型,以达到通过某人的月收入预测他网购支出金额的目标,下面是我们收集到的收入和网购支出的数据,保存在两个数组中。
x = np.array([ 25000, 15850, 15500, 20500, 22000, 20010, 26050, 12500, 18500, 27300, 15000, 8300, 23320, 5250, 5800, 9100, 4800, 16000, 28500, 32000, 31300, 10800, 6750, 6020, 13300, 30020, 3200, 17300, 8835, 3500])y = np.array([ 2599, 1400, 1120, 2560, 1900, 1200, 2320, 800, 1650, 2200, 980, 580, 1885, 600, 400, 800, 420, 1380, 1980, 3999, 3800, 725, 520, 420, 1200, 4020, 350, 1500, 560, 500])我们可以先绘制散点图来了解两组数据是否具有正相关或负相关关系。正相关意味着数组x中较大的值对应到数组y中也是较大的值,而负相关则意味着数组x中较大的值对应到数组y中较小的值。
import matplotlib.pyplot as plt
plt.figure(dpi=120)plt.scatter(x, y, color='blue')plt.show()输出:
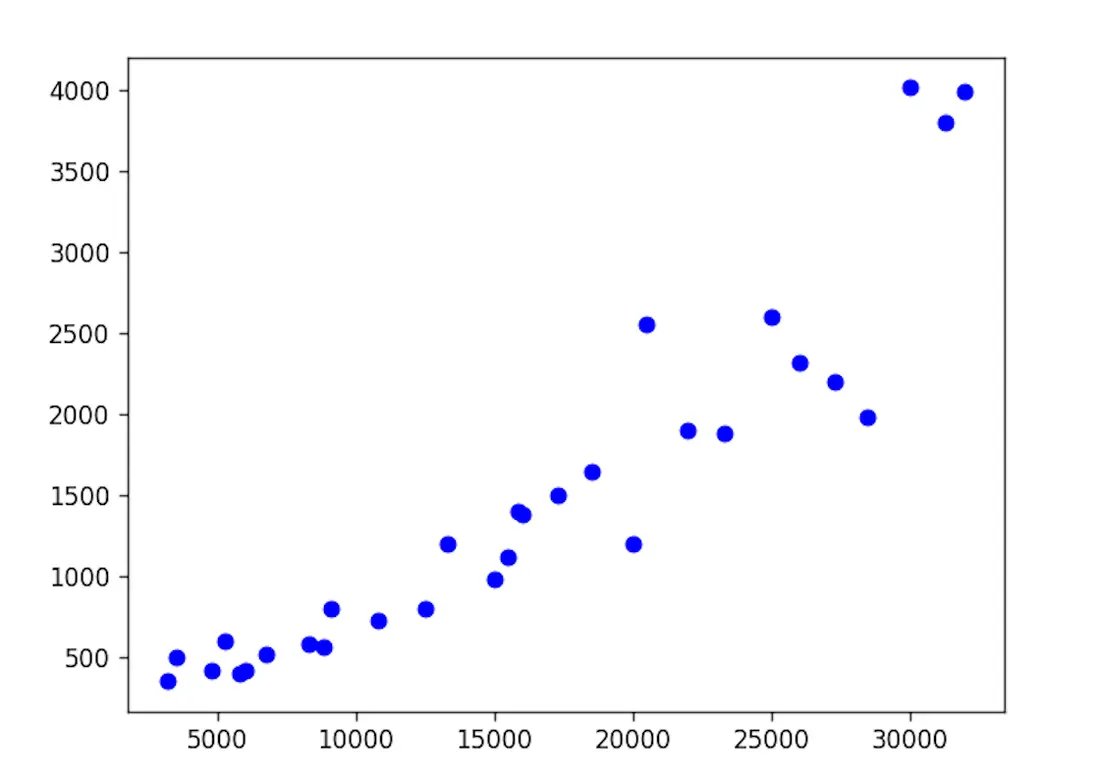
如果需要定量的研究两组数据的相关性,我们可以计算协方差或相关系数,对应的 NumPy 函数分别是cov和corrcoef。
代码:
np.corrcoef(x, y)输出:
array([[1. , 0.92275889], [0.92275889, 1. ]])说明:相关系数是一个
-1到1之间的值,越靠近1说明正相关性越强,越靠近-1说明负相关性越强,靠近0则说明两组数据没有明显的相关性。上面月收入和网购支出之间的相关系数是0.92275889,说明二者是强正相关关系。
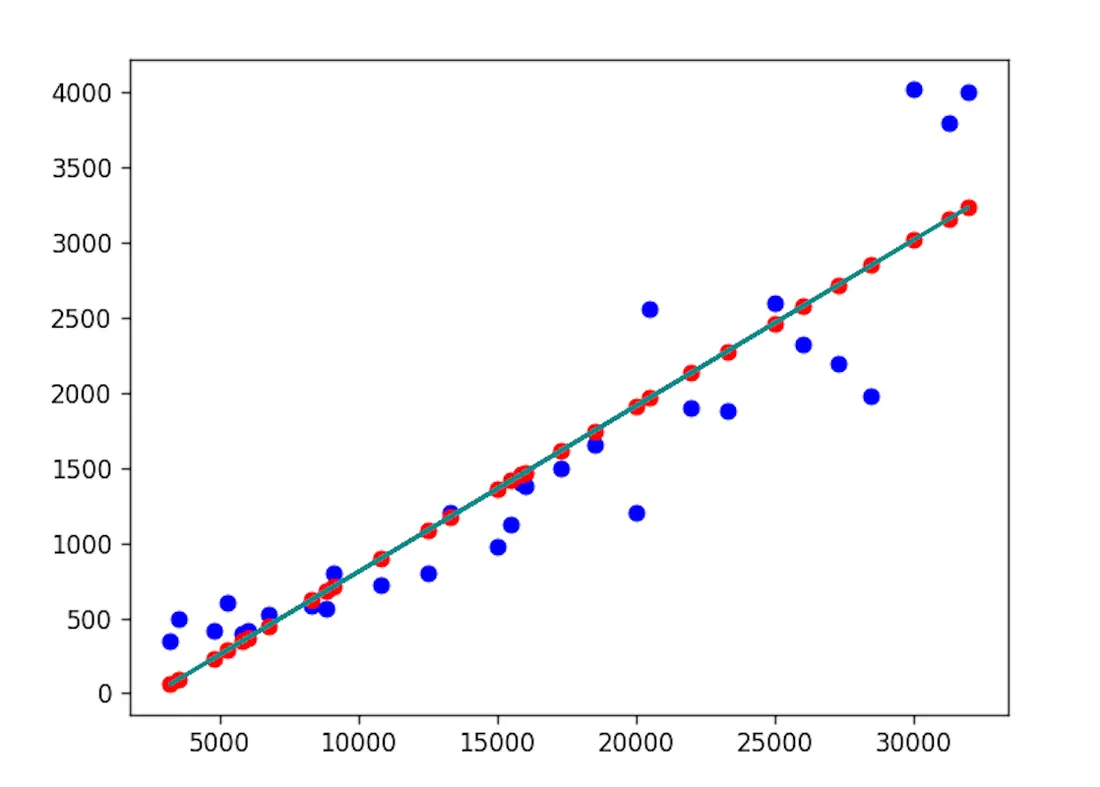
通过上面的操作,我们确定了收入和网购支出之前存在强正相关关系,于是我们用这些数据来创建一个回归模型,找出一条能够很好的拟合这些数据点的直线。这里,我们就可以用到上面提到的fit方法,具体的代码如下所示。
代码:
from numpy.polynomial import Polynomial
Polynomial.fit(x, y, deg=1).convert().coef说明:
deg=1说明回归模型最高次项就是1次项,回归模型形如 ;如果要生一个类似于 的模型,就需要设置deg=2,以此类推。
输出:
array([-2.94883437e+02, 1.10333716e-01])根据上面输出的结果,我们的回归方程应该是 。我们将这个回归方程绘制到刚才的散点图上,红色的点是我们的预测值,蓝色的点是历史数据,也就是真实值。
代码:
import matplotlib.pyplot as plt
plt.scatter(x, y, color='blue')plt.scatter(x, 0.110333716 * x - 294.883437, color='red')plt.plot(x, 0.110333716 * x - 294.883437, color='darkcyan')plt.show()输出:
如果不使用Polynomial类型的fit方法,我们也可以通过 NumPy 提供的polyfit函数来完成同样的操作,有兴趣的读者可以自行研究。
说明:本章部分图片来自于维基百科。
72 深入浅出pandas-1
Pandas 是 Wes McKinney 在2008年开发的一个强大的分析结构化数据的工具集。Pandas 以 NumPy 为基础(实现数据存储和运算),提供了专门用于数据分析的类型、方法和函数,对数据分析和数据挖掘提供了很好的支持;同时 pandas 还可以跟数据可视化工具 matplotlib 很好的整合在一起,非常轻松愉快的实现数据可视化呈现。
Pandas 核心的数据类型是Series(数据系列)、DataFrame(数据窗/数据框),分别用于处理一维和二维的数据,除此之外,还有一个名为Index的类型及其子类型,它们为Series和DataFrame提供了索引功能。日常工作中DataFrame使用得最为广泛,因为二维的数据结构刚好可以对应有行有列的表格。Series和DataFrame都提供了大量的处理数据的方法,数据分析师以此为基础,可以实现对数据的筛选、合并、拼接、清洗、预处理、聚合、透视和可视化等各种操作。
创建Series对象
Pandas 库中的Series对象可以用来表示一维数据结构,但是多了索引和一些额外的功能。Series类型的内部结构包含了两个数组,其中一个用来保存数据,另一个用来保存数据的索引。我们可以通过列表或数组创建Series对象,代码如下所示。
代码:
import numpy as npimport pandas as pd
ser1 = pd.Series(data=[120, 380, 250, 360], index=['一季度', '二季度', '三季度', '四季度'])ser1说明:
Series构造器中的data参数表示数据,index参数表示数据的索引,相当于数据对应的标签。
输出:
一季度 120二季度 380三季度 250四季度 360dtype: int64通过字典创建Series对象。
代码:
ser2 = pd.Series({'一季度': 320, '二季度': 180, '三季度': 300, '四季度': 405})ser2说明:通过字典创建
Series对象时,字典的键就是数据的标签(索引),键对应的值就是数据。
输出:
一季度 320二季度 180三季度 300四季度 405dtype: int64Series对象的运算
标量运算
我们尝试给刚才的ser1每个季度加上10,代码如下所示。
代码:
ser1 += 10ser1输出:
一季度 130二季度 390三季度 260四季度 370dtype: int64矢量运算
我们尝试把ser1和ser2对应季度的数据加起来,代码如下所示。
代码:
ser1 + ser2输出:
一季度 450二季度 570三季度 560四季度 775dtype: int64索引运算
普通索引
跟数组一样,Series对象也可以进行索引和切片操作,不同的是Series对象因为内部维护了一个保存索引的数组,所以除了可以使用整数索引检索数据外,还可以通过自己设置的索引(标签)获取对应的数据。
使用整数索引。
代码:
ser1[2]输出:
260使用自定义索引。
代码:
ser1['三季度']输出:
260代码:
ser1['一季度'] = 380ser1输出:
一季度 380二季度 390三季度 260四季度 370dtype: int64切片索引
Series对象的切片操作跟列表、数组类似,通过给出起始和结束索引,从原来的Series对象中取出或修改部分数据,这里也可以使用整数索引和自定义的索引,代码如下所示。
代码:
ser2[1:3]输出:
二季度 180三季度 300dtype: int64代码:
ser2['二季度':'四季度']输出:
二季度 180三季度 300四季度 405dtype: int64提示:在使用自定义索引进行切片时,结束索引对应的元素也是可以取到的。
代码:
ser2[1:3] = 400, 500ser2输出:
一季度 320二季度 400三季度 500四季度 405dtype: int64花式索引
代码:
ser2[['二季度', '四季度']]输出:
二季度 400四季度 405dtype: int64代码:
ser2[['二季度', '四季度']] = 600, 520ser2输出:
一季度 320二季度 600三季度 500四季度 520dtype: int64布尔索引
代码:
ser2[ser2 >= 500]输出:
二季度 600三季度 500四季度 520dtype: int64Series对象的属性和方法
Series对象的属性和方法非常多,我们就捡着重要的跟大家讲吧。先看看下面的表格,它展示了Series对象常用的属性。
| 属性 | 说明 |
|---|---|
dtype / dtypes | 返回Series对象的数据类型 |
hasnans | 判断Series对象中有没有空值 |
at / iat | 通过索引访问Series对象中的单个值 |
loc / iloc | 通过索引访问Series对象中的单个值或一组值 |
index | 返回Series对象的索引(Index对象) |
is_monotonic | 判断Series对象中的数据是否单调 |
is_monotonic_increasing | 判断Series对象中的数据是否单调递增 |
is_monotonic_decreasing | 判断Series对象中的数据是否单调递减 |
is_unique | 判断Series对象中的数据是否独一无二 |
size | 返回Series对象中元素的个数 |
values | 以ndarray的方式返回Series对象中的值(ndarray对象) |
我们可以通过下面的代码来了解Series对象的属性。
代码:
print(ser2.dtype) # 数据类型print(ser2.hasnans) # 有没有空值print(ser2.index) # 索引print(ser2.values) # 值print(ser2.is_monotonic_increasing) # 是否单调递增print(ser2.is_unique) # 是否每个值都独一无二输出:
int64FalseIndex(['一季度', '二季度', '三季度', '四季度'], dtype='object')[320 600 500 520]FalseTrueSeries对象的方法很多,下面我们通过一些代码片段为大家介绍常用的方法。
统计相关
Series对象支持各种获取描述性统计信息的方法。
代码:
print(ser2.count()) # 计数print(ser2.sum()) # 求和print(ser2.mean()) # 求平均print(ser2.median()) # 找中位数print(ser2.max()) # 找最大print(ser2.min()) # 找最小print(ser2.std()) # 求标准差print(ser2.var()) # 求方差输出:
41940485.0510.0600320118.1806526749055713966.666666666666Series对象还有一个名为describe()的方法,可以获得上述所有的描述性统计信息,如下所示。
代码:
ser2.describe()输出:
count 4.000000mean 485.000000std 118.180653min 320.00000025% 455.00000050% 510.00000075% 540.000000max 600.000000dtype: float64提示:因为
describe()返回的也是一个Series对象,所以也可以用ser2.describe()['mean']来获取平均值,用ser2.describe()[['max', 'min']]来获取最大值和最小值。
如果Series对象有重复的值,我们可以使用unique()方法获得由独一无二的值构成的数组;可以使用nunique()方法统计不重复值的数量;如果想要统计每个值重复的次数,可以使用value_counts()方法,这个方法会返回一个Series对象,它的索引就是原来的Series对象中的值,而每个值出现的次数就是返回的Series对象中的数据,在默认情况下会按照出现次数做降序排列,如下所示。
代码:
ser3 = pd.Series(data=['apple', 'banana', 'apple', 'pitaya', 'apple', 'pitaya', 'durian'])ser3.value_counts()输出:
apple 3pitaya 2durian 1banana 1dtype: int64代码:
ser3.nunique()输出:
4对于ser3,我们还可以用mode()方法来找出数据的众数,由于众数可能不唯一,所以mode()方法的返回值仍然是一个Series对象。
代码:
ser3.mode()输出:
0 appledtype: object处理数据
Series对象的isna()和isnull()方法可以用于空值的判断,notna()和notnull()方法可以用于非空值的判断,代码如下所示。
代码:
ser4 = pd.Series(data=[10, 20, np.nan, 30, np.nan])ser4.isna()说明:
np.nan是一个IEEE 754标准的浮点小数,专门用来表示“不是一个数”,在上面的代码中我们用它来代表空值;当然,也可以用 Python 中的None来表示空值,在 pandas 中None也会被处理为np.nan。
输出:
0 False1 False2 True3 False4 Truedtype: bool代码:
ser4.notna()输出:
0 True1 True2 False3 True4 Falsedtype: boolSeries对象的dropna()和fillna()方法分别用来删除空值和填充空值,具体的用法如下所示。
代码:
ser4.dropna()输出:
0 10.01 20.03 30.0dtype: float64代码:
ser4.fillna(value=40) # 将空值填充为40输出:
0 10.01 20.02 40.03 30.04 40.0dtype: float64代码:
ser4.fillna(method='ffill') # 用空值前面的非空值填充输出:
0 10.01 20.02 20.03 30.04 30.0dtype: float64需要提醒大家注意的是,dropna()和fillna()方法都有一个名为inplace的参数,它的默认值是False,表示删除空值或填充空值不会修改原来的Series对象,而是返回一个新的Series对象。如果将inplace参数的值修改为True,那么删除或填充空值会就地操作,直接修改原来的Series对象,此时方法的返回值是None。后面我们会接触到的很多方法,包括DataFrame对象的很多方法都会有这个参数,它们的意义跟这里是一样的。
Series对象的mask()和where()方法可以将满足或不满足条件的值进行替换,如下所示。
代码:
ser5 = pd.Series(range(5))ser5.where(ser5 > 0)输出:
0 NaN1 1.02 2.03 3.04 4.0dtype: float64代码:
ser5.where(ser5 > 1, 10)输出:
0 101 102 23 34 4dtype: int64代码:
ser5.mask(ser5 > 1, 10)输出:
0 01 12 103 104 10dtype: int64Series对象的duplicated()方法可以帮助我们找出重复的数据,而drop_duplicates()方法可以帮我们删除重复数据。
代码:
ser3.duplicated()输出:
0 False1 False2 True3 False4 True5 True6 Falsedtype: bool代码:
ser3.drop_duplicates()输出:
0 apple1 banana3 pitaya6 duriandtype: objectSeries对象的apply()和map()方法非常重要,它们可以通过字典或者指定的函数来处理数据,把数据映射或转换成我们想要的样子。这两个方法在数据准备阶段非常重要,我们先来试一试这个名为map的方法。
代码:
ser6 = pd.Series(['cat', 'dog', np.nan, 'rabbit'])ser6输出:
0 cat1 dog2 NaN3 rabbitdtype: object代码:
ser6.map({'cat': 'kitten', 'dog': 'puppy'})说明:通过字典给出的映射规则对数据进行处理。
输出:
0 kitten1 puppy2 NaN3 NaNdtype: object代码:
ser6.map('I am a {}'.format, na_action='ignore')说明:将指定字符串的
format方法作用到数据系列的数据上,忽略掉所有的空值。
输出:
0 I am a cat1 I am a dog2 NaN3 I am a rabbitdtype: object我们创建一个新的Series对象,
ser7 = pd.Series([20, 21, 12], index=['London', 'New York', 'Helsinki'])ser7输出:
London 20New York 21Helsinki 12dtype: int64代码:
ser7.apply(np.square)说明:将求平方的函数作用到数据系列的数据上,也可以将参数
np.square替换为lambda x: x ** 2。
输出:
London 400New York 441Helsinki 144dtype: int64代码:
ser7.apply(lambda x, value: x - value, args=(5, ))注意:上面
apply方法中的lambda函数有两个参数,第一个参数是数据系列中的数据,而第二个参数需要我们传入,所以我们给apply方法增加了args参数,用于给lambda函数的第二个参数传值。
输出:
London 15New York 16Helsinki 7dtype: int64取头部值和排序
Series对象的sort_index()和sort_values()方法可以用于对索引和数据的排序,排序方法有一个名为ascending的布尔类型参数,该参数用于控制排序的结果是升序还是降序;而名为kind的参数则用来控制排序使用的算法,默认使用了quicksort,也可以选择mergesort或heapsort;如果存在空值,那么可以用na_position参数空值放在最前还是最后,默认是last,代码如下所示。
代码:
ser8 = pd.Series( data=[35, 96, 12, 57, 25, 89], index=['grape', 'banana', 'pitaya', 'apple', 'peach', 'orange'])ser8.sort_values() # 按值从小到大排序输出:
pitaya 12peach 25grape 35apple 57orange 89banana 96dtype: int64代码:
ser8.sort_index(ascending=False) # 按索引从大到小排序输出:
pitaya 12peach 25orange 89grape 35banana 96apple 57dtype: int64如果要从Series对象中找出元素中最大或最小的“Top-N”,我们不需要对所有的值进行排序的,可以使用nlargest()和nsmallest()方法来完成,如下所示。
代码:
ser8.nlargest(3) # 值最大的3个输出:
banana 96orange 89apple 57dtype: int64代码:
ser8.nsmallest(2) # 值最小的2个输出:
pitaya 12peach 25dtype: int64绘制图表
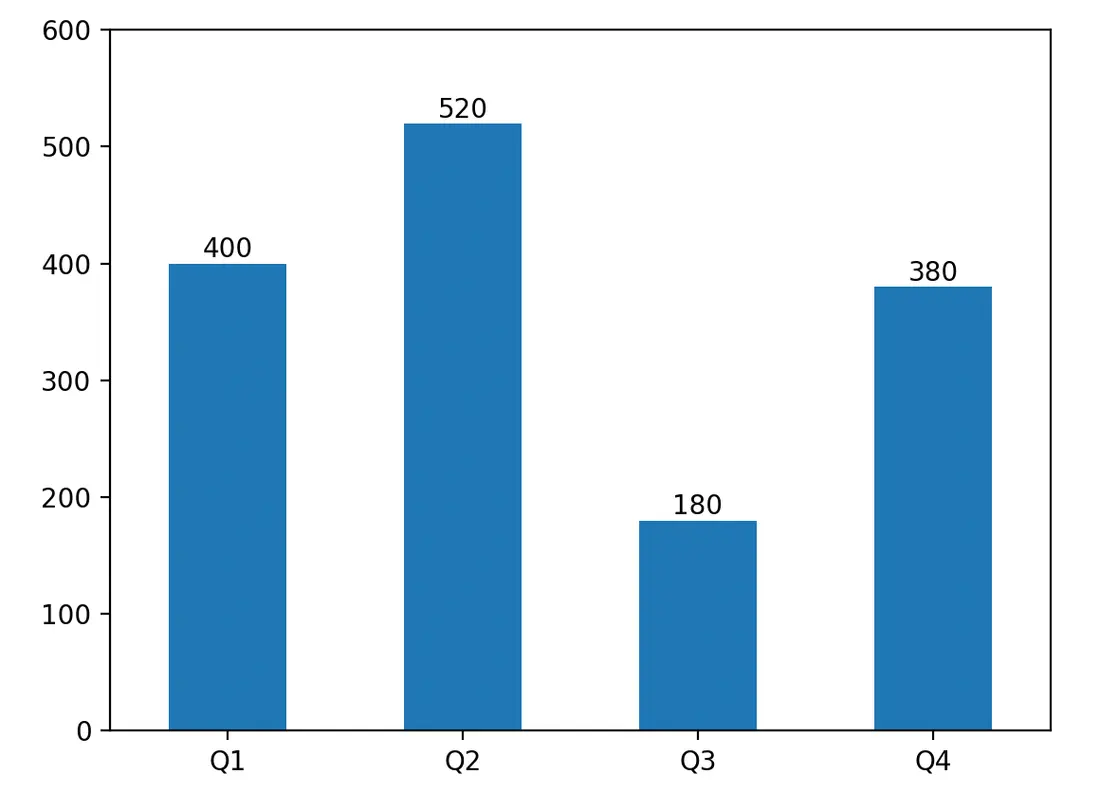
Series对象有一个名为plot的方法可以用来生成图表,如果选择生成折线图、饼图、柱状图等,默认会使用Series对象的索引作为横坐标,使用Series对象的数据作为纵坐标。下面我们创建一个Series对象并基于它绘制柱状图,代码如下所示。
代码:
import matplotlib.pyplot as plt
ser9 = pd.Series({'Q1': 400, 'Q2': 520, 'Q3': 180, 'Q4': 380})# 通过plot方法的kind指定图表类型为柱状图ser9.plot(kind='bar')# 定制纵轴的取值范围plt.ylim(0, 600)# 定制横轴刻度(旋转到0度)plt.xticks(rotation=0)# 为柱子增加数据标签for i in range(ser9.size): plt.text(i, ser9[i] + 5, ser9[i], ha='center')plt.show()输出:
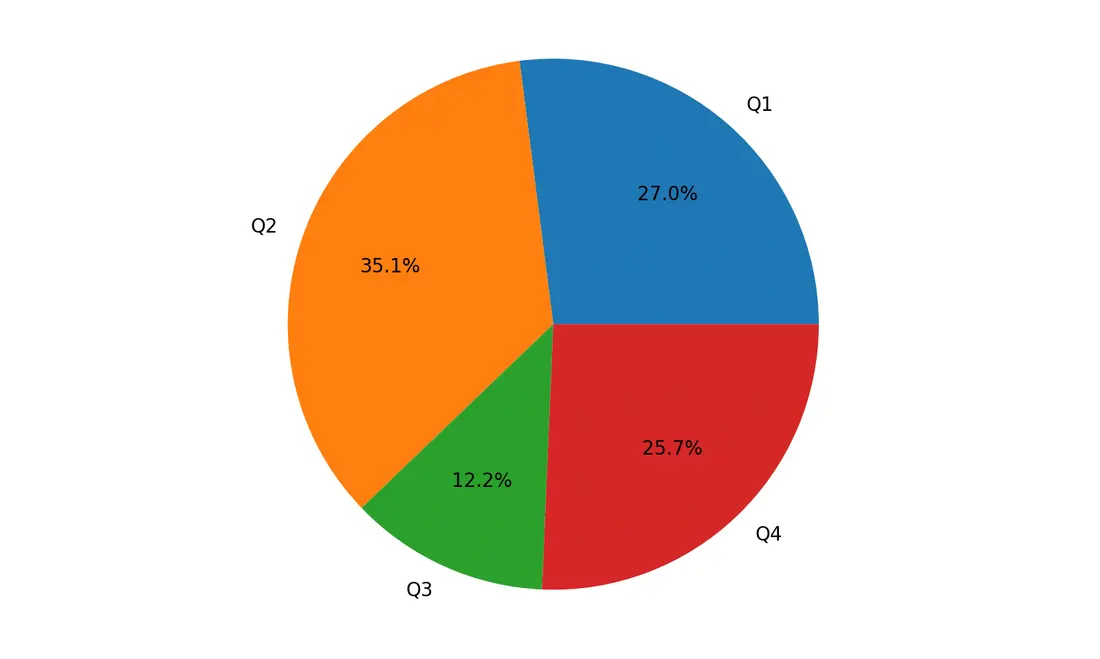
我们也可以将其绘制为饼图,代码如下所示。
代码:
# plot方法的kind参数指定了图表类型为饼图# autopct会自动计算并显示百分比# pctdistance用来控制百分比到圆心的距离ser9.plot(kind='pie', autopct='%.1f%%', pctdistance=0.65)plt.show()输出:
73 深入浅出pandas-2
如果使用 pandas 做数据分析,那么DataFrame一定是被使用得最多的类型,它可以用来保存和处理异质的二维数据。这里所谓的“异质”是指DataFrame中每个列的数据类型不需要相同,这也是它区别于 NumPy 二维数组的地方。DataFrame提供了极为丰富的属性和方法,帮助我们实现对数据的重塑、清洗、预处理、透视、呈现等一系列操作。
创建DataFrame对象
通过二维数组创建DataFrame对象
代码:
scores = np.random.randint(60, 101, (5, 3))courses = ['语文', '数学', '英语']stu_ids = np.arange(1001, 1006)df1 = pd.DataFrame(data=scores, columns=courses, index=stu_ids)df1输出:
语文 数学 英语1001 69 80 791002 71 60 1001003 94 81 931004 88 88 671005 82 66 60通过字典创建DataFrame对象
代码:
scores = { '语文': [62, 72, 93, 88, 93], '数学': [95, 65, 86, 66, 87], '英语': [66, 75, 82, 69, 82],}stu_ids = np.arange(1001, 1006)df2 = pd.DataFrame(data=scores, index=stu_ids)df2输出:
语文 数学 英语1001 62 95 661002 72 65 751003 93 86 821004 88 66 691005 93 87 82读取CSV文件创建DataFrame对象
可以通过pandas 模块的read_csv函数来读取 CSV 文件,read_csv函数的参数非常多,下面介绍几个比较重要的参数。
sep/delimiter:分隔符,默认是,。header:表头(列索引)的位置,默认值是infer,用第一行的内容作为表头(列索引)。index_col:用作行索引(标签)的列。usecols:需要加载的列,可以使用序号或者列名。true_values/false_values:哪些值被视为布尔值True/False。skiprows:通过行号、索引或函数指定需要跳过的行。skipfooter:要跳过的末尾行数。nrows:需要读取的行数。na_values:哪些值被视为空值。iterator:设置为True,函数返回迭代器对象。chunksize:配合上面的参数,设置每次迭代获取的数据体量。
代码:
df3 = pd.read_csv('data/2018年北京积分落户数据.csv', index_col='id')df3提示:上面代码中的CSV文件是用相对路径进行获取的,也就是说当前工作路径下有名为
data的文件夹,而“2018年北京积分落户数据.csv”就在这个文件夹下。如果使用Windows系统,在写路径分隔符时也建议使用/而不是\,如果想使用\,建议在字符串前面添加一个r,使用原始字符串来避开转义字符,例如r'c:\new\data\2018年北京积分落户数据.csv'。
输出:
name birthday company scoreid1 杨xx 1972-12 北京利德华福xxxx 122.592 纪xx 1974-12 北京航天数据xxxx 121.253 王x 1974-05 品牌联盟(北京)xx 118.964 杨x 1975-07 中科专利商标xxxx 118.215 张xx 1974-11 北京阿里巴巴xxxx 117.79... ... ... ... ...6015 孙xx 1978-08 华为海洋网络xxxx 90.756016 刘xx 1976-11 福斯(上海)xxxx 90.756017 周x 1977-10 赢创德固赛xxxxxx 90.756018 赵x 1979-07 澳科利耳医疗xxxx 90.756019 贺x 1981-06 北京宝洁技术xxxx 90.75
[6019 rows x 4 columns]说明: 上面输出的内容隐去了姓名(name)和公司名称(company)字段中的部分信息。如果需要上面例子中的 CSV 文件,可以通过百度云盘获取,链接:https://pan.baidu.com/s/1rQujl5RQn9R7PadB2Z5g_g,提取码:e7b4。
读取Excel工作表创建DataFrame对象
可以通过pandas 模块的read_excel函数来读取 Excel 文件,该函数与上面的read_csv非常类似,多了一个sheet_name参数来指定数据表的名称,但是不同于 CSV 文件,没有sep或delimiter这样的参数。假设有名为“2022年股票数据.xlsx”的 Excel 文件,里面有用股票代码命名的五个表单,分别是阿里巴巴(BABA)、百度(BIDU)、京东(JD)、亚马逊(AMZN)、甲骨文(ORCL)这五个公司2022年的股票数据,如果想加载亚马逊的股票数据,代码如下所示。
代码:
df4 = pd.read_excel('data/2022年股票数据.xlsx', sheet_name='AMZN', index_col='Date')df4说明:上面例子中的 CSV 文件可以通过百度云盘获取,链接:https://pan.baidu.com/s/1rQujl5RQn9R7PadB2Z5g_g,提取码:e7b4。
输出:
Open High Low Close VolumeDate2022-12-30 83.120 84.050 82.4700 84.000 624011942022-12-29 82.870 84.550 82.5500 84.180 549958952022-12-28 82.800 83.480 81.6900 81.820 582285752022-12-27 84.970 85.350 83.0000 83.040 572840352022-12-23 83.250 85.780 82.9344 85.250 57433655... ... ... ... ... ...2022-01-07 163.839 165.243 162.0310 162.554 466059002022-01-06 163.450 164.800 161.9370 163.254 519577802022-01-05 166.883 167.126 164.3570 164.357 643027202022-01-04 170.438 171.400 166.3490 167.522 707251602022-01-03 167.550 170.704 166.1600 170.404 63869140
[251 rows x 5 columns]读取关系数据库二维表创建DataFrame对象
pandas模块的read_sql函数可以通过 SQL 语句从数据库中读取数据创建DataFrame对象,该函数的第二个参数代表了需要连接的数据库。对于 MySQL 数据库,我们可以通过pymysql或mysqlclient来创建数据库连接(需要提前安装好三方库),得到一个Connection 对象,而这个对象就是read_sql函数需要的第二个参数,代码如下所示。
代码:
import pymysql
# 创建一个MySQL数据库的连接对象conn = pymysql.connect( host='101.42.16.8', port=3306, user='guest', password='Guest.618', database='hrs', charset='utf8mb4')# 通过SQL从数据库二维表读取数据创建DataFramedf5 = pd.read_sql('select * from tb_emp', conn, index_col='eno')df5提示:执行上面的代码需要先安装
pymysql库,如果尚未安装,可以先在单元格中先执行魔法指令%pip install pymysql,然后再运行上面的代码。上面的代码连接的是我部署在腾讯云上的 MySQL 数据库,公网 IP 地址:101.42.16.8,用户名:guest,密码:Guest.618,数据库:hrs,字符集:utf8mb4,大家可以使用这个数据库,但是不要进行恶意的访问。hrs数据库一共有三张表,分别是:tb_dept(部门表)、tb_emp(员工表)、tb_emp2(员工表2)。
输出:
ename job mgr sal comm dnoeno1359 胡一刀 销售员 3344.0 1800 200.0 302056 乔峰 分析师 7800.0 5000 1500.0 203088 李莫愁 设计师 2056.0 3500 800.0 203211 张无忌 程序员 2056.0 3200 NaN 203233 丘处机 程序员 2056.0 3400 NaN 203244 欧阳锋 程序员 3088.0 3200 NaN 203251 张翠山 程序员 2056.0 4000 NaN 203344 黄蓉 销售主管 7800.0 3000 800.0 303577 杨过 会计 5566.0 2200 NaN 103588 朱九真 会计 5566.0 2500 NaN 104466 苗人凤 销售员 3344.0 2500 NaN 305234 郭靖 出纳 5566.0 2000 NaN 105566 宋远桥 会计师 7800.0 4000 1000.0 107800 张三丰 总裁 NaN 9000 1200.0 20执行上面的代码会出现一个警告,因为 pandas 库希望我们使用SQLAlchemy三方库接入数据库,具体内容是:“UserWarning: pandas only supports SQLAlchemy connectable (engine/connection) or database string URI or sqlite3 DBAPI2 connection. Other DBAPI2 objects are not tested. Please consider using SQLAlchemy.”。如果不想看到这个警告,我们可以试一试下面的解决方案。
首先,安装三方库SQLAlchemy,在 Jupyter 中可以使用%pip魔法指令。
%pip install sqlalchemy通过SQLAlchemy的create_engine函数创建Engine对象作为read_sql函数的第二个参数,此时read_sql函数的第一个参数可以是 SQL 语句,也可以是二维表的表名。
from sqlalchemy import create_engine
# 通过指定的URL(统一资源定位符)访问数据库engine = create_engine('mysql+pymysql://guest:Guest.618@101.42.16.8:3306/hrs')# 直接通过表名加载整张表的数据df5 = pd.read_sql('tb_emp', engine, index_col='eno')df5说明:如果通过表名加载二维表数据,也可以将上面的函数换成
read_sql_table。
我们再来加载部门表的数据创建DataFrame对象。
df6 = pd.read_sql('select dno, dname, dloc from tb_dept', engine, index_col='dno')df6说明:如果通过 SQL 查询获取数据,也可以将上面的函数换成
read_sql_query。
输出:
dname dlocdno10 会计部 北京20 研发部 成都30 销售部 重庆40 运维部 深圳在完成数据加载后,如果希望释放数据库连接,可以使用下面的代码。
engine.connect().close()基本属性和方法
在开始讲解DataFrame的属性和方法前,我们先从之前提到的hrs数据库中读取三张表的数据,创建出三个DataFrame对象,完整的代码如下所示。
from sqlalchemy import create_engine
engine = create_engine('mysql+pymysql://guest:Guest.618@101.42.16.8:3306/hrs')dept_df = pd.read_sql_table('tb_dept', engine, index_col='dno')emp_df = pd.read_sql_table('tb_emp', engine, index_col='eno')emp2_df = pd.read_sql_table('tb_emp2', engine, index_col='eno')得到的三个DataFrame对象如下所示。
部门表(dept_df),其中dno是部门的编号,dname和dloc分别是部门的名称和所在地。
dname dlocdno10 会计部 北京20 研发部 成都30 销售部 重庆40 运维部 深圳员工表(emp_df),其中eno是员工编号,ename、job、mgr、sal、comm和dno分别代表员工的姓名、职位、主管编号、月薪、补贴和部门编号。
ename job mgr sal comm dnoeno1359 胡一刀 销售员 3344.0 1800 200.0 302056 乔峰 分析师 7800.0 5000 1500.0 203088 李莫愁 设计师 2056.0 3500 800.0 203211 张无忌 程序员 2056.0 3200 NaN 203233 丘处机 程序员 2056.0 3400 NaN 203244 欧阳锋 程序员 3088.0 3200 NaN 203251 张翠山 程序员 2056.0 4000 NaN 203344 黄蓉 销售主管 7800.0 3000 800.0 303577 杨过 会计 5566.0 2200 NaN 103588 朱九真 会计 5566.0 2500 NaN 104466 苗人凤 销售员 3344.0 2500 NaN 305234 郭靖 出纳 5566.0 2000 NaN 105566 宋远桥 会计师 7800.0 4000 1000.0 107800 张三丰 总裁 NaN 9000 1200.0 20说明:在数据库中
mgr和comm两个列的数据类型是int,但是因为有缺失值(空值),读取到DataFrame之后,列的数据类型变成了float,因为我们通常会用float类型的NaN来表示空值。
员工表(emp2_df),跟上面的员工表结构相同,但是保存了不同的员工数据。
ename job mgr sal comm dnoeno9500 张三丰 总裁 NaN 50000 8000 209600 王大锤 程序员 9800.0 8000 600 209700 张三丰 总裁 NaN 60000 6000 209800 骆昊 架构师 7800.0 30000 5000 209900 陈小刀 分析师 9800.0 10000 1200 20DataFrame对象的属性如下表所示。
| 属性名 | 说明 |
|---|---|
at / iat | 通过标签获取DataFrame中的单个值。 |
columns | DataFrame对象列的索引 |
dtypes | DataFrame对象每一列的数据类型 |
empty | DataFrame对象是否为空 |
loc / iloc | 通过标签获取DataFrame中的一组值。 |
ndim | DataFrame对象的维度 |
shape | DataFrame对象的形状(行数和列数) |
size | DataFrame对象中元素的个数 |
values | DataFrame对象的数据对应的二维数组 |
关于DataFrame的方法,首先需要了解的是info()方法,它可以帮助我们了解DataFrame的相关信息,如下所示。
代码:
emp_df.info()输出:
<class 'pandas.core.frame.DataFrame'>Int64Index: 14 entries, 1359 to 7800Data columns (total 6 columns): # Column Non-Null Count Dtype--- ------ -------------- ----- 0 ename 14 non-null object 1 job 14 non-null object 2 mgr 13 non-null float64 3 sal 14 non-null int64 4 comm 6 non-null float64 5 dno 14 non-null int64dtypes: float64(2), int64(2), object(2)memory usage: 1.3+ KB如果需要查看DataFrame的头部或尾部的数据,可以使用head()或tail()方法,这两个方法的默认参数是5,表示获取DataFrame最前面5行或最后面5行的数据,如下所示。
emp_df.head()输出:
ename job mgr sal comm dnoeno1359 胡一刀 销售员 3344 1800 200 302056 乔峰 分析师 7800 5000 1500 203088 李莫愁 设计师 2056 3500 800 203211 张无忌 程序员 2056 3200 NaN 203233 丘处机 程序员 2056 3400 NaN 20操作数据
索引和切片
如果要获取DataFrame的某一列,例如取出上面emp_df的ename列,可以使用下面的两种方式。
emp_df.ename或者
emp_df['ename']执行上面的代码可以发现,我们获得的是一个Series对象。事实上,DataFrame对象就是将多个Series对象组合到一起的结果。
如果要获取DataFrame的某一行,可以使用整数索引或我们设置的索引,例如取出员工编号为2056的员工数据,代码如下所示。
emp_df.iloc[1]或者
emp_df.loc[2056]通过执行上面的代码我们发现,单独取DataFrame 的某一行或某一列得到的都是Series对象。我们当然也可以通过花式索引来获取多个行或多个列的数据,花式索引的结果仍然是一个DataFrame对象。
获取多个列:
emp_df[['ename', 'job']]获取多个行:
emp_df.loc[[2056, 7800, 3344]]如果要获取或修改DataFrame 对象某个单元格的数据,需要同时指定行和列的索引,例如要获取员工编号为2056的员工的职位信息,代码如下所示。
emp_df['job'][2056]或者
emp_df.loc[2056]['job']或者
emp_df.loc[2056, 'job']我们推荐大家使用第三种做法,因为它只做了一次索引运算。如果要将该员工的职位修改为“架构师”,可以使用下面的代码。
emp_df.loc[2056, 'job'] = '架构师'当然,我们也可以通过切片操作来获取多行多列,相信大家一定已经想到了这一点。
emp_df.loc[2056:3344]输出:
ename job mgr sal comm dnoeno2056 乔峰 分析师 7800.0 5000 1500.0 203088 李莫愁 设计师 2056.0 3500 800.0 203211 张无忌 程序员 2056.0 3200 NaN 203233 丘处机 程序员 2056.0 3400 NaN 203244 欧阳锋 程序员 3088.0 3200 NaN 203251 张翠山 程序员 2056.0 4000 NaN 203344 黄蓉 销售主管 7800.0 3000 800.0 30数据筛选
上面我们提到了花式索引,相信大家已经联想到了布尔索引。跟ndarray和Series一样,我们可以通过布尔索引对DataFrame对象进行数据筛选,例如我们要从emp_df中筛选出月薪超过3500的员工,代码如下所示。
emp_df[emp_df.sal > 3500]输出:
ename job mgr sal comm dnoeno2056 乔峰 分析师 7800.0 5000 1500.0 203251 张翠山 程序员 2056.0 4000 NaN 205566 宋远桥 会计师 7800.0 4000 1000.0 107800 张三丰 总裁 NaN 9000 1200.0 20当然,我们也可以组合多个条件来进行数据筛选,例如从emp_df中筛选出月薪超过3500且部门编号为20的员工,代码如下所示。
emp_df[(emp_df.sal > 3500) & (emp_df.dno == 20)]输出:
ename job mgr sal comm dnoeno2056 乔峰 分析师 7800.0 5000 1500.0 203251 张翠山 程序员 2056.0 4000 NaN 207800 张三丰 总裁 NaN 9000 1200.0 20除了使用布尔索引,DataFrame对象的query方法也可以实现数据筛选,query方法的参数是一个字符串,它代表了筛选数据使用的表达式,而且更符合 Python 程序员的使用习惯。下面我们使用query方法将上面的效果重新实现一遍,代码如下所示。
emp_df.query('sal > 3500 and dno == 20')74 深入浅出pandas-3
在完成数据加载之后,我们可能需要对事实表和维度表进行连接,这是对数据进行多维度拆解的基础;我们可能从不同的数据源加载了结构相同的数据,我们需要将这些数据拼接起来;我们把这些操作统称为数据重塑。当然,由于企业的信息化水平以及数据中台建设水平的差异,我们拿到的数据未必是质量很好的,可能还需要对数据中的缺失值、重复值、异常值进行适当的处理。即便我们获取的数据在质量上是没有问题的,但也可能需要对数据进行一系列的预处理,才能满足我们做数据分析的需求。接下来,我们就为大家讲解和梳理这方面的知识。
数据重塑
有的时候,我们做数据分析需要的原始数据可能并不是来自一个地方,就像上一章的例子中,我们从关系型数据库中读取了三张表,得到了三个DataFrame对象,但实际工作可能需要我们把他们的数据整合到一起。例如:emp_df和emp2_df其实都是员工的数据,而且数据结构完全一致,我们可以使用pandas提供的concat函数实现两个或多个DataFrame的数据拼接,代码如下所示。
all_emp_df = pd.concat([emp_df, emp2_df])输出:
ename job mgr sal comm dnoeno1359 胡一刀 销售员 3344.0 1800 200.0 302056 乔峰 分析师 7800.0 5000 1500.0 203088 李莫愁 设计师 2056.0 3500 800.0 203211 张无忌 程序员 2056.0 3200 NaN 203233 丘处机 程序员 2056.0 3400 NaN 203244 欧阳锋 程序员 3088.0 3200 NaN 203251 张翠山 程序员 2056.0 4000 NaN 203344 黄蓉 销售主管 7800.0 3000 800.0 303577 杨过 会计 5566.0 2200 NaN 103588 朱九真 会计 5566.0 2500 NaN 104466 苗人凤 销售员 3344.0 2500 NaN 305234 郭靖 出纳 5566.0 2000 NaN 105566 宋远桥 会计师 7800.0 4000 1000.0 107800 张三丰 总裁 NaN 9000 1200.0 209500 张三丰 总裁 NaN 50000 8000.0 209600 王大锤 程序员 9800.0 8000 600.0 209700 张三丰 总裁 NaN 60000 6000.0 209800 骆昊 架构师 7800.0 30000 5000.0 209900 陈小刀 分析师 9800.0 10000 1200.0 20上面的代码将两个代表员工数据的DataFrame拼接到了一起,接下来我们使用merge函数将员工表和部门表的数据合并到一张表中,代码如下所示。
先使用reset_index方法重新设置all_emp_df的索引,这样eno 不再是索引而是一个普通列,reset_index方法的inplace参数设置为True表示,重置索引的操作直接在all_emp_df上执行,而不是返回修改后的新对象。
all_emp_df.reset_index(inplace=True)通过merge函数合并数据,当然,也可以调用DataFrame对象的merge方法来达到同样的效果。
pd.merge(all_emp_df, dept_df, how='inner', on='dno')输出:
eno ename job mgr sal comm dno dname dloc0 1359 胡一刀 销售员 3344.0 1800 200.0 30 销售部 重庆1 3344 黄蓉 销售主管 7800.0 3000 800.0 30 销售部 重庆2 4466 苗人凤 销售员 3344.0 2500 NaN 30 销售部 重庆3 2056 乔峰 分析师 7800.0 5000 1500.0 20 研发部 成都4 3088 李莫愁 设计师 2056.0 3500 800.0 20 研发部 成都5 3211 张无忌 程序员 2056.0 3200 NaN 20 研发部 成都6 3233 丘处机 程序员 2056.0 3400 NaN 20 研发部 成都7 3244 欧阳锋 程序员 3088.0 3200 NaN 20 研发部 成都8 3251 张翠山 程序员 2056.0 4000 NaN 20 研发部 成都9 7800 张三丰 总裁 NaN 9000 1200.0 20 研发部 成都10 9500 张三丰 总裁 NaN 50000 8000.0 20 研发部 成都11 9600 王大锤 程序员 9800.0 8000 600.0 20 研发部 成都12 9700 张三丰 总裁 NaN 60000 6000.0 20 研发部 成都13 9800 骆昊 架构师 7800.0 30000 5000.0 20 研发部 成都14 9900 陈小刀 分析师 9800.0 10000 1200.0 20 研发部 成都15 3577 杨过 会计 5566.0 2200 NaN 10 会计部 北京16 3588 朱九真 会计 5566.0 2500 NaN 10 会计部 北京17 5234 郭靖 出纳 5566.0 2000 NaN 10 会计部 北京18 5566 宋远桥 会计师 7800.0 4000 1000.0 10 会计部 北京merge函数的一个参数代表合并的左表、第二个参数代表合并的右表,有SQL编程经验的同学对这两个词是不是感觉到非常亲切。正如大家猜想的那样,DataFrame对象的合并跟数据库中的表连接非常类似,所以上面代码中的how代表了合并两张表的方式,有left、right、inner、outer四个选项;而on则代表了基于哪个列实现表的合并,相当于 SQL 表连接中的连表条件,如果左右两表对应的列列名不同,可以用left_on和right_on参数取代on参数分别进行指定。
如果对上面的代码稍作修改,将how参数修改为'right',大家可以思考一下代码执行的结果。
pd.merge(all_emp_df, dept_df, how='right', on='dno')运行结果比之前的输出多出了如下所示的一行,这是因为how='right'代表右外连接,也就意味着右表dept_df中的数据会被完整的查出来,但是在all_emp_df中又没有编号为40 部门的员工,所以对应的位置都被填入了空值。
19 NaN NaN NaN NaN NaN NaN 40 运维部 深圳数据清洗
通常,我们从 Excel、CSV 或数据库中获取到的数据并不是非常完美的,里面可能因为系统或人为的原因混入了重复值或异常值,也可能在某些字段上存在缺失值;再者,DataFrame中的数据也可能存在格式不统一、量纲不统一等各种问题。因此,在开始数据分析之前,对数据进行清洗就显得特别重要。
缺失值
可以使用DataFrame对象的isnull或isna方法来找出数据表中的缺失值,如下所示。
emp_df.isnull()或者
emp_df.isna()输出:
ename job mgr sal comm dnoeno1359 False False False False False False2056 False False False False False False3088 False False False False False False3211 False False False False True False3233 False False False False True False3244 False False False False True False3251 False False False False True False3344 False False False False False False3577 False False False False True False3588 False False False False True False4466 False False False False True False5234 False False False False True False5566 False False False False False False7800 False False True False False False相对应的,notnull和notna方法可以将非空的值标记为True。如果想删除这些缺失值,可以使用DataFrame对象的dropna方法,该方法的axis参数可以指定沿着0轴还是1轴删除,也就是说当遇到空值时,是删除整行还是删除整列,默认是沿0轴进行删除的,代码如下所示。
emp_df.dropna()输出:
ename job mgr sal comm dnoeno1359 胡一刀 销售员 3344.0 1800 200.0 302056 乔峰 架构师 7800.0 5000 1500.0 203088 李莫愁 设计师 2056.0 3500 800.0 203344 黄蓉 销售主管 7800.0 3000 800.0 305566 宋远桥 会计师 7800.0 4000 1000.0 10如果要沿着1轴进行删除,可以使用下面的代码。
emp_df.dropna(axis=1)输出:
ename job sal dnoeno1359 胡一刀 销售员 1800 302056 乔峰 架构师 5000 203088 李莫愁 设计师 3500 203211 张无忌 程序员 3200 203233 丘处机 程序员 3400 203244 欧阳锋 程序员 3200 203251 张翠山 程序员 4000 203344 黄蓉 销售主管 3000 303577 杨过 会计 2200 103588 朱九真 会计 2500 104466 苗人凤 销售员 2500 305234 郭靖 出纳 2000 105566 宋远桥 会计师 4000 107800 张三丰 总裁 9000 20注意:
DataFrame对象的很多方法都有一个名为inplace的参数,该参数的默认值为False,表示我们的操作不会修改原来的DataFrame对象,而是将处理后的结果通过一个新的DataFrame对象返回。如果将该参数的值设置为True,那么我们的操作就会在原来的DataFrame上面直接修改,方法的返回值为None。简单的说,上面的操作并没有修改emp_df,而是返回了一个新的DataFrame对象。
在某些特定的场景下,我们可以对空值进行填充,对应的方法是fillna,填充空值时可以使用指定的值(通过value参数进行指定),也可以用表格中前一个单元格(通过设置参数method=ffill)或后一个单元格(通过设置参数method=bfill)的值进行填充,当代码如下所示。
emp_df.fillna(value=0)注意:填充的值如何选择也是一个值得探讨的话题,实际工作中,可能会使用某种统计量(如:均值、众数等)进行填充,或者使用某种插值法(如:随机插值法、拉格朗日插值法等)进行填充,甚至有可能通过回归模型、贝叶斯模型等对缺失数据进行填充。
输出:
ename job mgr sal comm dnoeno1359 胡一刀 销售员 3344.0 1800 200.0 302056 乔峰 分析师 7800.0 5000 1500.0 203088 李莫愁 设计师 2056.0 3500 800.0 203211 张无忌 程序员 2056.0 3200 0.0 203233 丘处机 程序员 2056.0 3400 0.0 203244 欧阳锋 程序员 3088.0 3200 0.0 203251 张翠山 程序员 2056.0 4000 0.0 203344 黄蓉 销售主管 7800.0 3000 800.0 303577 杨过 会计 5566.0 2200 0.0 103588 朱九真 会计 5566.0 2500 0.0 104466 苗人凤 销售员 3344.0 2500 0.0 305234 郭靖 出纳 5566.0 2000 0.0 105566 宋远桥 会计师 7800.0 4000 1000.0 107800 张三丰 总裁 0.0 9000 1200.0 20重复值
接下来,我们先给之前的部门表添加两行数据,让部门表中名为“研发部”和“销售部”的部门各有两个。
dept_df.loc[50] = {'dname': '研发部', 'dloc': '上海'}dept_df.loc[60] = {'dname': '销售部', 'dloc': '长沙'}dept_df输出:
dname dlocdno10 会计部 北京20 研发部 成都30 销售部 重庆40 运维部 天津50 研发部 上海60 销售部 长沙现在,我们的数据表中有重复数据了,我们可以通过DataFrame对象的duplicated方法判断是否存在重复值,该方法在不指定参数时默认判断行索引是否重复,我们也可以指定根据部门名称dname判断部门是否重复,代码如下所示。
dept_df.duplicated('dname')输出:
dno10 False20 False30 False40 False50 True60 Truedtype: bool从上面的输出可以看到,50和60两个部门从部门名称上来看是重复的,如果要删除重复值,可以使用drop_duplicates方法,该方法的keep参数可以控制在遇到重复值时,保留第一项还是保留最后一项,或者多个重复项一个都不用保留,全部删除掉。
dept_df.drop_duplicates('dname')输出:
dname dlocdno10 会计部 北京20 研发部 成都30 销售部 重庆40 运维部 天津将keep参数的值修改为last。
dept_df.drop_duplicates('dname', keep='last')输出:
dname dlocdno10 会计部 北京40 运维部 天津50 研发部 上海60 销售部 长沙使用同样的方式,我们也可以清除all_emp_df中的重复数据,例如我们认定“ename”和“job”两个字段完全相同的就是重复数据,我们可以用下面的代码去除重复数据。
all_emp_df.drop_duplicates(['ename', 'job'], inplace=True)说明:上面的
drop_duplicates方法添加了参数inplace=True,该方法不会返回新的DataFrame对象,而是在原来的DataFrame对象上直接删除,大家可以查看all_emp_df看看是不是已经移除了重复的员工数据。
异常值
异常值在统计学上的全称是疑似异常值,也称作离群点(outlier),异常值的分析也称作离群点分析。异常值是指样本中出现的“极端值”,数据值看起来异常大或异常小,其分布明显偏离其余的观测值。实际工作中,有些异常值可能是由系统或人为原因造成的,但有些异常值却不是,它们能够重复且稳定的出现,属于正常的极端值,例如很多游戏产品中头部玩家的数据往往都是离群的极端值。所以,我们既不能忽视异常值的存在,也不能简单地把异常值从数据分析中剔除。重视异常值的出现,分析其产生的原因,常常成为发现问题进而改进决策的契机。
异常值的检测有Z-score 方法、IQR 方法、DBScan 聚类、孤立森林等,这里我们对前两种方法做一个简单的介绍。
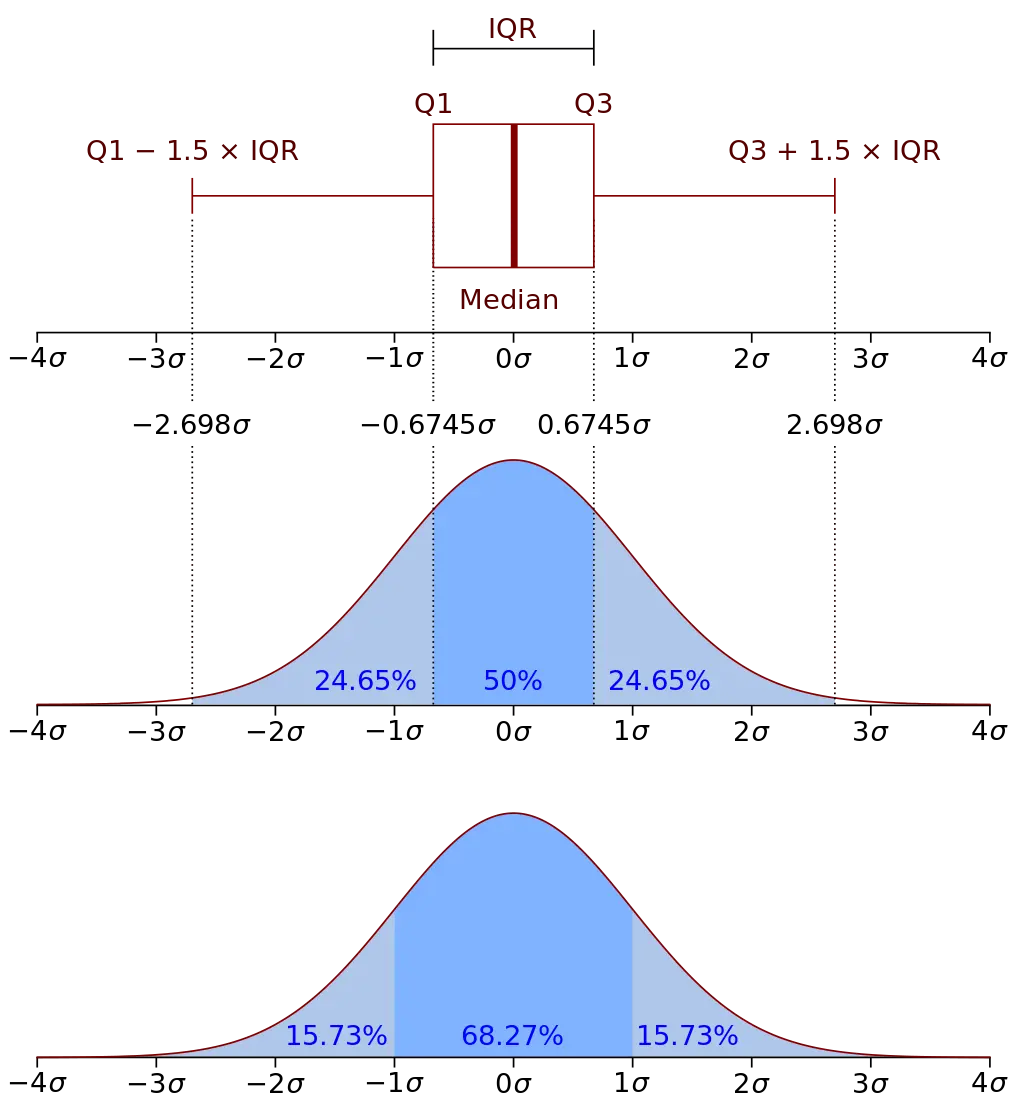
如果数据服从正态分布,依据3σ法则,异常值被定义与平均值的偏差超过三倍标准差的值。在正态分布下,距离平均值3σ之外的值出现的概率为 ,属于小概率事件。如果数据不服从正态分布,那么可以用远离均值的多少倍的标准差来描述,这里的倍数就是Z-score。Z-score以标准差为单位去度量某一原始分数偏离平均值的距离,公式如下所示。
Z-score需要根据经验和实际情况来决定,通常把远离标准差 3 倍距离以上的数据点视为离群点,下面的代给出了如何通过Z-score方法检测异常值。
def detect_outliers_zscore(data, threshold=3): avg_value = np.mean(data) std_value = np.std(data) z_score = np.abs((data - avg_value) / std_value) return data[z_score > threshold]IQR 方法中的 IQR(Inter-Quartile Range)代表四分位距离,即上四分位数(Q3)和下四分位数(Q1)的差值。通常情况下,可以认为小于 或大于 的就是异常值,而这种检测异常值的方法也是箱线图(后面会讲到)默认使用的方法。下面的代码给出了如何通过 IQR 方法检测异常值。
def detect_outliers_iqr(data, whis=1.5): q1, q3 = np.quantile(data, [0.25, 0.75]) iqr = q3 - q1 lower, upper = q1 - whis * iqr, q3 + whis * iqr return data[(data < lower) | (data > upper)]如果要删除异常值,可以使用DataFrame对象的drop方法,该方法可以根据行索引或列索引删除指定的行或列。例如我们认为月薪低于2000或高于8000的是员工表中的异常值,可以用下面的代码删除对应的记录。
emp_df.drop(emp_df[(emp_df.sal > 8000) | (emp_df.sal < 2000)].index)如果要替换掉异常值,可以通过给单元格赋值的方式来实现,也可以使用replace方法将指定的值替换掉。例如我们要将月薪为1800和9000的替换为月薪的平均值,补贴为800的替换为1000,代码如下所示。
avg_sal = np.mean(emp_df.sal).astype(int)emp_df.replace({'sal': [1800, 9000], 'comm': 800}, {'sal': avg_sal, 'comm': 1000})预处理
对数据进行预处理也是一个很大的话题,它包含了对数据的拆解、变换、归约、离散化等操作。我们先来看看数据的拆解。如果数据表中的数据是一个时间日期,我们通常都需要从年、季度、月、日、星期、小时、分钟等维度对其进行拆解,如果时间日期是用字符串表示的,可以先通过pandas的to_datetime函数将其处理成时间日期。
在下面的例子中,我们先读取 Excel 文件,获取到一组销售数据,其中第一列就是销售日期,我们将其拆解为“月份”、“季度”和“星期”,代码如下所示。
sales_df = pd.read_excel( 'data/2020年销售数据.xlsx', usecols=['销售日期', '销售区域', '销售渠道', '品牌', '销售额'])sales_df.info()说明:上面代码中使用了相对路径来获取 Excel 文件,也就是说 Excel 文件在当前工作路径下名为
data的文件夹中。如果需要上面例子中的 Excel 文件,可以通过下面的百度云盘地址进行获取。链接:https://pan.baidu.com/s/1rQujl5RQn9R7PadB2Z5g_g,提取码:e7b4。
输出:
<class 'pandas.core.frame.DataFrame'>RangeIndex: 1945 entries, 0 to 1944Data columns (total 5 columns): # Column Non-Null Count Dtype--- ------ -------------- ----- 0 销售日期 1945 non-null datetime64[ns] 1 销售区域 1945 non-null object 2 销售渠道 1945 non-null object 3 品牌 1945 non-null object 4 销售额 1945 non-null int64dtypes: datetime64[ns](1), int64(1), object(3)memory usage: 76.1+ KBsales_df['月份'] = sales_df['销售日期'].dt.monthsales_df['季度'] = sales_df['销售日期'].dt.quartersales_df['星期'] = sales_df['销售日期'].dt.weekdaysales_df输出:
销售日期 销售区域 销售渠道 品牌 销售额 月份 季度 星期0 2020-01-01 上海 拼多多 八匹马 8217 1 1 21 2020-01-01 上海 抖音 八匹马 6351 1 1 22 2020-01-01 上海 天猫 八匹马 14365 1 1 23 2020-01-01 上海 天猫 八匹马 2366 1 1 24 2020-01-01 上海 天猫 皮皮虾 15189 1 1 2... ... ... ... ... ... ... ... ...1940 2020-12-30 北京 京东 花花姑娘 6994 12 4 21941 2020-12-30 福建 实体 八匹马 7663 12 4 21942 2020-12-31 福建 实体 花花姑娘 14795 12 4 31943 2020-12-31 福建 抖音 八匹马 3481 12 4 31944 2020-12-31 福建 天猫 八匹马 2673 12 4 3在上面的代码中,通过日期时间类型的Series对象的dt 属性,获得一个访问日期时间的对象,通过该对象的year、month、quarter、hour等属性,就可以获取到年、月、季度、小时等时间信息,获取到的仍然是一个Series对象,它包含了一组时间信息,所以我们通常也将这个dt属性称为“日期时间向量”。
我们再来说一说字符串类型的数据的处理,我们先从指定的 Excel 文件中读取某招聘网站的招聘数据。
jobs_df = pd.read_csv( 'data/某招聘网站招聘数据.csv', usecols=['city', 'companyFullName', 'positionName', 'salary'])jobs_df.info()说明:上面代码中使用了相对路径来获取 CSV 文件,也就是说 CSV 文件在当前工作路径下名为
data的文件夹中。如果需要上面例子中的 CSV 文件,可以通过下面的百度云盘地址进行获取。链接:https://pan.baidu.com/s/1rQujl5RQn9R7PadB2Z5g_g,提取码:e7b4。
输出:
<class 'pandas.core.frame.DataFrame'>RangeIndex: 3140 entries, 0 to 3139Data columns (total 4 columns): # Column Non-Null Count Dtype--- ------ -------------- ----- 0 city 3140 non-null object 1 companyFullName 3140 non-null object 2 positionName 3140 non-null object 3 salary 3140 non-null objectdtypes: object(4)memory usage: 98.2+ KB查看前5条数据。
jobs_df.head()输出:
city companyFullName positionName salary0 北京 达疆网络科技(上海)有限公司 数据分析岗 15k-30k1 北京 北京音娱时光科技有限公司 数据分析 10k-18k2 北京 北京千喜鹤餐饮管理有限公司 数据分析 20k-30k3 北京 吉林省海生电子商务有限公司 数据分析 33k-50k4 北京 韦博网讯科技(北京)有限公司 数据分析 10k-15k上面的数据表一共有3140条数据,但并非所有的职位都是“数据分析”的岗位,如果要筛选出数据分析的岗位,可以通过检查positionName字段是否包含“数据分析”这个关键词,这里需要模糊匹配,应该如何实现呢?我们可以先获取positionName列,因为这个Series对象的dtype是字符串,所以可以通过str属性获取对应的字符串向量,然后就可以利用我们熟悉的字符串的方法来对其进行操作,代码如下所示。
jobs_df = jobs_df[jobs_df.positionName.str.contains('数据分析')]jobs_df.shape输出:
(1515, 4)可以看出,筛选后的数据还有1515条。接下来,我们还需要对salary字段进行处理,如果我们希望统计所有岗位的平均工资或每个城市的平均工资,首先需要将用范围表示的工资处理成其中间值,代码如下所示。
jobs_df.salary.str.extract(r'(\d+)[kK]?-(\d+)[kK]?')说明:上面的代码通过正则表达式捕获组从字符串中抽取出两组数字,分别对应工资的下限和上限,对正则表达式不熟悉的读者,可以阅读我的知乎专栏“从零开始学Python”中的《正则表达式的应用》一文。
输出:
0 10 15 301 10 182 20 303 33 504 10 15... ... ...3065 8 103069 6 103070 2 43071 6 123088 8 12需要提醒大家的是,抽取出来的两列数据都是字符串类型的值,我们需要将其转换成int类型,才能计算平均值,对应的方法是DataFrame对象的applymap方法,该方法的参数是一个函数,而该函数会作用于DataFrame中的每个元素。完成这一步之后,我们就可以使用apply方法将上面的DataFrame处理成中间值,apply方法的参数也是一个函数,可以通过指定axis参数使其作用于DataFrame 对象的行或列,代码如下所示。
temp_df = jobs_df.salary.str.extract(r'(\d+)[kK]?-(\d+)[kK]?').applymap(int)temp_df.apply(np.mean, axis=1)输出:
0 22.51 14.02 25.03 41.54 12.5 ...3065 9.03069 8.03070 3.03071 9.03088 10.0Length: 1515, dtype: float64接下来,我们可以用上面的结果替换掉原来的salary列或者增加一个新的列来表示职位对应的工资,完整的代码如下所示。
temp_df = jobs_df.salary.str.extract(r'(\d+)[kK]?-(\d+)[kK]?').applymap(int)jobs_df['salary'] = temp_df.apply(np.mean, axis=1)jobs_df.head()输出:
city companyFullName positionName salary0 北京 达疆网络科技(上海)有限公司 数据分析岗 22.51 北京 北京音娱时光科技有限公司 数据分析 14.02 北京 北京千喜鹤餐饮管理有限公司 数据分析 25.03 北京 吉林省海生电子商务有限公司 数据分析 41.54 北京 韦博网讯科技(北京)有限公司 数据分析 12.5applymap和apply两个方法在数据预处理的时候经常用到,Series对象也有apply方法,也是用于数据的预处理,但是DataFrame对象还有一个名为transform 的方法,也是通过传入的函数对数据进行变换,类似Series对象的map方法。需要强调的是,apply方法具有归约效果的,简单的说就是能将较多的数据处理成较少的数据或一条数据;而transform方法没有归约效果,只能对数据进行变换,原来有多少条数据,处理后还是有多少条数据。
如果要对数据进行深度的分析和挖掘,字符串、日期时间这样的非数值类型都需要处理成数值,因为非数值类型没有办法计算相关性,也没有办法进行 检验等操作。对于字符串类型,通常可以其分为以下三类,再进行对应的处理。
- 有序变量(Ordinal Variable):字符串表示的数据有顺序关系,那么可以对字符串进行序号化处理。
- 分类变量(Categorical Variable)/ 名义变量(Nominal Variable):字符串表示的数据没有大小关系和等级之分,那么就可以使用独热编码的方式处理成哑变量(虚拟变量)矩阵。
- 定距变量(Scale Variable):字符串本质上对应到一个有大小高低之分的数据,而且可以进行加减运算,那么只需要将字符串处理成对应的数值即可。
对于第1类和第3类,我们可以用上面提到的apply或transform方法来处理,也可以利用scikit-learn中的OrdinalEncoder处理第1类字符串,这个我们在后续的课程中会讲到。对于第2类字符串,可以使用pandas的get_dummies()函数来生成哑变量(虚拟变量)矩阵,代码如下所示。
persons_df = pd.DataFrame( data={ '姓名': ['关羽', '张飞', '赵云', '马超', '黄忠'], '职业': ['医生', '医生', '程序员', '画家', '教师'], '学历': ['研究生', '大专', '研究生', '高中', '本科'] })persons_df输出:
姓名 职业 学历0 关羽 医生 研究生1 张飞 医生 大专2 赵云 程序员 研究生3 马超 画家 高中4 黄忠 教师 本科将职业处理成哑变量矩阵。
pd.get_dummies(persons_df['职业'])输出:
医生 教师 画家 程序员0 1 0 0 01 1 0 0 02 0 0 0 13 0 0 1 04 0 1 0 0将学历处理成大小不同的值。
def handle_education(x): edu_dict = {'高中': 1, '大专': 3, '本科': 5, '研究生': 10} return edu_dict.get(x, 0)
persons_df['学历'].apply(handle_education)输出:
0 101 32 103 14 5Name: 学历, dtype: int64我们再来说说数据离散化。离散化也叫分箱,如果变量的取值是连续值,那么它的取值有无数种可能,在进行数据分组的时候就会非常的不方便,这个时候将连续变量离散化就显得非常重要。之所以把离散化叫做分箱,是因为我们可以预先设置一些箱子,每个箱子代表了数据取值的范围,这样就可以将连续的值分配到不同的箱子中,从而实现离散化。下面的例子读取了2018年北京积分落户数据,我们可以根据落户积分对数据进行分组,具体的做法如下所示。
luohu_df = pd.read_csv('data/2018年北京积分落户数据.csv', index_col='id')luohu_df.score.describe()输出:
count 6019.000000mean 95.654552std 4.354445min 90.75000025% 92.33000050% 94.46000075% 97.750000max 122.590000Name: score, dtype: float64可以看出,落户积分的最大值是122.59,最小值是90.75,那么我们可以构造一个从90分到125分,每5分一组的7个箱子,pandas的cut函数可以帮助我们首先数据分箱,代码如下所示。
bins = np.arange(90, 126, 5)pd.cut(luohu_df.score, bins, right=False)说明:
cut函数的right参数默认值为True,表示箱子左开右闭;修改为False可以让箱子的右边界为开区间,左边界为闭区间,大家看看下面的输出就明白了。
输出:
id1 [120, 125)2 [120, 125)3 [115, 120)4 [115, 120)5 [115, 120) ...6015 [90, 95)6016 [90, 95)6017 [90, 95)6018 [90, 95)6019 [90, 95)Name: score, Length: 6019, dtype: categoryCategories (7, interval[int64, left]): [[90, 95) < [95, 100) < [100, 105) < [105, 110) < [110, 115) < [115, 120) < [120, 125)]我们可以根据分箱的结果对数据进行分组,然后使用聚合函数对每个组进行统计,这是数据分析中经常用到的操作,下一个章节会为大家介绍。除此之外,pandas还提供了一个名为qcut的函数,可以指定分位数对数据进行分箱,有兴趣的读者可以自行研究。
75 深入浅出pandas-4
数据透视
经过前面的学习,我们已经将数据准备就绪而且变成了我们想要的样子,接下来就是最为重要的数据透视阶段了。当我们拿到一大堆数据的时候,如何从数据中迅速的解读出有价值的信息,把繁杂的数据变成容易解读的统计图表并再此基础上产生业务洞察,这就是数据分析要解决的核心问题。
获取描述性统计信息
首先,我们可以获取数据的描述性统计信息,通过描述性统计信息,我们可以了解数据的集中趋势和离散趋势。
例如,我们有如下所示的学生成绩表。
scores = np.random.randint(50, 101, (5, 3))names = ('关羽', '张飞', '赵云', '马超', '黄忠')courses = ('语文', '数学', '英语')df = pd.DataFrame(data=scores, columns=courses, index=names)df输出:
语文 数学 英语关羽 96 72 73张飞 72 70 97赵云 74 51 79马超 100 54 54黄忠 89 100 88我们可以通过DataFrame对象的方法mean、max、min、std、var等方法分别获取每个学生或每门课程的平均分、最高分、最低分、标准差、方差等信息,也可以直接通过describe方法直接获取描述性统计信息,代码如下所示。
计算每门课程成绩的平均分。
df.mean()输出:
语文 86.2数学 69.4英语 78.2dtype: float64计算每个学生成绩的平均分。
df.mean(axis=1)输出:
关羽 80.333333张飞 79.666667赵云 68.000000马超 69.333333黄忠 92.333333dtype: float64计算每门课程成绩的方差。
df.var()输出:
语文 161.2数学 379.8英语 265.7dtype: float64说明:通过方差可以看出,数学成绩波动最大,两极分化可能更严重。
获取每门课程的描述性统计信息。
df.describe()输出:
语文 数学 英语count 5.000000 5.000000 5.000000mean 86.200000 69.400000 78.200000std 12.696456 19.488458 16.300307min 72.000000 51.000000 54.00000025% 74.000000 54.000000 73.00000050% 89.000000 70.000000 79.00000075% 96.000000 72.000000 88.000000max 100.000000 100.000000 97.000000排序和取头部值
如果需要对数据进行排序,可以使用DataFrame对象的sort_values方法,该方法的by参数可以指定根据哪个列或哪些列进行排序,而ascending参数可以指定升序或是降序。例如,下面的代码展示了如何将学生表按语文成绩排降序。
df.sort_values(by='语文', ascending=False)输出:
语文 数学 英语马超 100 54 54关羽 96 72 73黄忠 89 100 88赵云 74 51 79张飞 72 70 97如果DataFrame数据量很大,排序将是一个非常耗费时间的操作。有的时候我们只需要获得排前N名或后N名的数据,这个时候其实没有必要对整个数据进行排序,而是直接利用堆结构找出Top-N的数据。DataFrame的nlargest和nsmallest方法就提供对Top-N操作的支持,代码如下所示。
找出语文成绩前3名的学生信息。
df.nlargest(3, '语文')输出:
语文 数学 英语马超 100 54 54关羽 96 72 73黄忠 89 100 88找出数学成绩最低的3名学生的信息。
df.nsmallest(3, '数学')输出:
语文 数学 英语赵云 74 51 79马超 100 54 54张飞 72 70 97分组聚合
我们先从之前使用过的 Excel 文件中读取2020年销售数据,然后再为大家演示如何进行分组聚合操作。
df = pd.read_excel('data/2020年销售数据.xlsx')df.head()输出:
销售日期 销售区域 销售渠道 销售订单 品牌 售价 销售数量0 2020-01-01 上海 拼多多 182894-455 八匹马 99 831 2020-01-01 上海 抖音 205635-402 八匹马 219 292 2020-01-01 上海 天猫 205654-021 八匹马 169 853 2020-01-01 上海 天猫 205654-519 八匹马 169 144 2020-01-01 上海 天猫 377781-010 皮皮虾 249 61如果我们要统计每个销售区域的销售总额,可以先通过“售价”和“销售数量”计算出销售额,为DataFrame添加一个列,代码如下所示。
df['销售额'] = df['售价'] * df['销售数量']df.head()输出:
销售日期 销售区域 销售渠道 销售订单 品牌 售价 销售数量 销售额0 2020-01-01 上海 拼多多 182894-455 八匹马 99 83 82171 2020-01-01 上海 抖音 205635-402 八匹马 219 29 63512 2020-01-01 上海 天猫 205654-021 八匹马 169 85 143653 2020-01-01 上海 天猫 205654-519 八匹马 169 14 23664 2020-01-01 上海 天猫 377781-010 皮皮虾 249 61 15189然后再根据“销售区域”列对数据进行分组,这里我们使用的是DataFrame对象的groupby方法。分组之后,我们取“销售额”这个列在分组内进行求和处理,代码和结果如下所示。
df.groupby('销售区域').销售额.sum()输出:
销售区域上海 11610489北京 12477717安徽 895463广东 1617949江苏 2304380浙江 687862福建 10178227Name: 销售额, dtype: int64如果我们要统计每个月的销售总额,我们可以将“销售日期”作为groupby`方法的参数,当然这里需要先将“销售日期”处理成月,代码和结果如下所示。
df.groupby(df['销售日期'].dt.month).销售额.sum()输出:
销售日期1 54098552 46084553 41649724 39967705 32390056 28179367 35013048 29481899 263296010 237538511 238528312 1691973Name: 销售额, dtype: int64接下来我们将难度升级,统计每个销售区域每个月的销售总额,这又该如何处理呢?事实上,groupby方法的第一个参数可以是一个列表,列表中可以指定多个分组的依据,大家看看下面的代码和输出结果就明白了。
df.groupby(['销售区域', df['销售日期'].dt.month]).销售额.sum()输出:
销售区域 销售日期上海 1 1679125 2 1689527 3 1061193 4 1082187 5 841199 6 785404 7 863906 8 734937 9 1107693 10 412108 11 825169 12 528041北京 1 1878234 2 1807787 3 1360666 4 1205989 5 807300 6 1216432 7 1219083 8 645727 9 390077 10 671608 11 678668 12 596146安徽 4 341308 5 554155广东 3 388180 8 469390 9 365191 11 395188江苏 4 537079 7 841032 10 710962 12 215307浙江 3 248354 8 439508福建 1 1852496 2 1111141 3 1106579 4 830207 5 1036351 6 816100 7 577283 8 658627 9 769999 10 580707 11 486258 12 352479Name: 销售额, dtype: int64如果希望统计出每个区域的销售总额以及每个区域单笔金额的最高和最低,我们可以在DataFrame或Series对象上使用agg方法并指定多个聚合函数,代码和结果如下所示。
df.groupby('销售区域').销售额.agg(['sum', 'max', 'min'])输出:
sum max min销售区域上海 11610489 116303 948北京 12477717 133411 690安徽 895463 68502 1683广东 1617949 120807 990江苏 2304380 114312 1089浙江 687862 90909 3927福建 10178227 87527 897如果希望自定义聚合后的列的名字,可以使用如下所示的方法。
df.groupby('销售区域').销售额.agg(销售总额='sum', 单笔最高='max', 单笔最低='min')输出:
销售总额 单笔最高 单笔最低销售区域上海 11610489 116303 948北京 12477717 133411 690安徽 895463 68502 1683广东 1617949 120807 990江苏 2304380 114312 1089浙江 687862 90909 3927福建 10178227 87527 897如果需要对多个列使用不同的聚合函数,例如“统计每个销售区域销售额的总和以及销售数量的最低值和最高值”,我们可以按照下面的方式来操作。
df.groupby('销售区域')[['销售额', '销售数量']].agg({ '销售额': 'sum', '销售数量': ['max', 'min']})输出:
销售额 销售数量 sum max min销售区域上海 11610489 100 10北京 12477717 100 10安徽 895463 98 16广东 1617949 98 10江苏 2304380 100 11浙江 687862 95 20福建 10178227 100 10透视表和交叉表
上面的例子中,“统计每个销售区域每个月的销售总额”会产生一个看起来很长的结果,在实际工作中我们通常把那些行很多列很少的表成为“窄表”,如果我们不想得到这样的一个“窄表”,可以使用DataFrame的pivot_table方法或者是pivot_table函数来生成透视表。透视表的本质就是对数据进行分组聚合操作,根据 A 列对 B 列进行统计,如果大家有使用 Excel 的经验,相信对透视表这个概念一定不会陌生。例如,我们要“统计每个销售区域的销售总额”,那么“销售区域”就是我们的 A 列,而“销售额”就是我们的 B 列,在pivot_table函数中分别对应index和values参数,这两个参数都可以是单个列或者多个列。
pd.pivot_table(df, index='销售区域', values='销售额', aggfunc='sum')输出:
销售额销售区域上海 11610489北京 12477717安徽 895463广东 1617949江苏 2304380浙江 687862福建 10178227注意:上面的结果操作跟之前用
groupby的方式得到的结果有一些区别,groupby操作后,如果对单个列进行聚合,得到的结果是一个Series对象,而上面的结果是一个DataFrame对象。
如果要统计每个销售区域每个月的销售总额,也可以使用pivot_table函数,代码如下所示。
df['月份'] = df['销售日期'].dt.monthpd.pivot_table(df, index=['销售区域', '月份'], values='销售额', aggfunc='sum')上面的操作结果是一个DataFrame,但也是一个长长的“窄表”,如果希望做成一个行比较少列比较多的“宽表”,可以将index参数中的列放到columns参数中,代码如下所示。
pd.pivot_table(df, index='销售区域', columns='月份', values='销售额', aggfunc='sum', fill_value=0)说明:
pivot_table函数的fill_value=0会将空值处理为0。
输出:
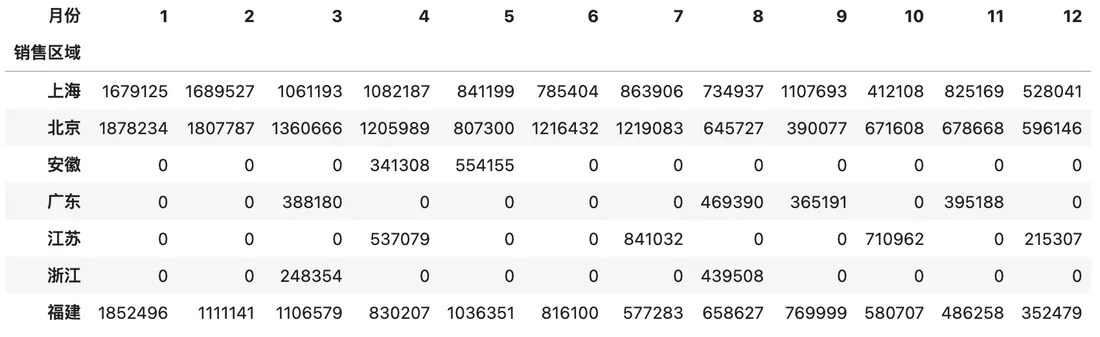
使用pivot_table函数时,还可以通过添加margins和margins_name参数对分组聚合的结果做一个汇总,具体的操作和效果如下所示。
pd.pivot_table(df, index='销售区域', columns='月份', values='销售额', aggfunc='sum', fill_value=0, margins=True, margins_name='总计')输出:
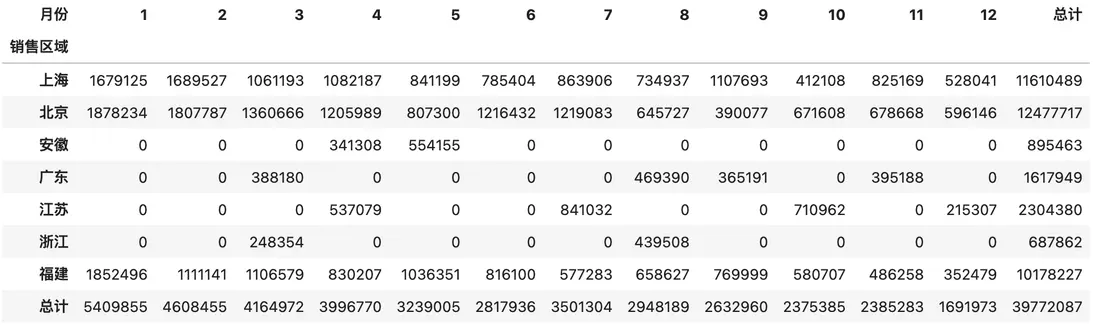
交叉表就是一种特殊的透视表,它不需要先构造一个DataFrame对象,而是直接通过数组或Series对象指定两个或多个因素进行运算得到统计结果。例如,我们要统计每个销售区域的销售总额,也可以按照如下所示的方式来完成,我们先准备三组数据。
sales_area, sales_month, sales_amount = df['销售区域'], df['月份'], df['销售额']使用crosstab函数生成交叉表。
pd.crosstab(index=sales_area, columns=sales_month, values=sales_amount, aggfunc='sum').fillna(0).astype('i8')说明:上面的代码使用了
DataFrame对象的fillna方法将空值处理为0,再使用astype方法将数据类型处理成整数。
数据呈现
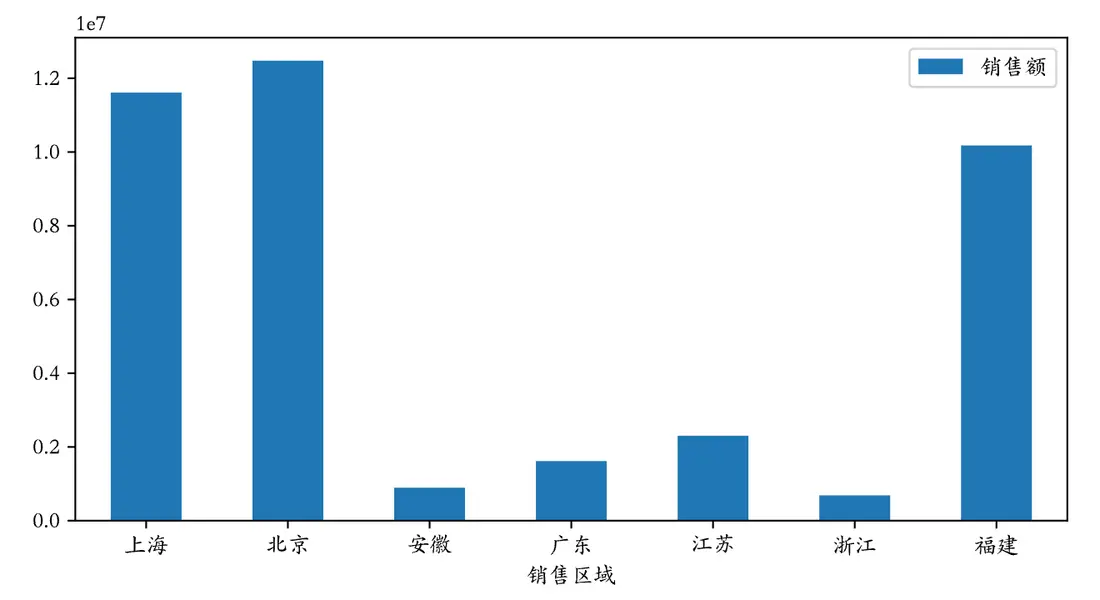
一图胜千言,我们对数据进行透视的结果,最终要通过图表的方式呈现出来,因为图表具有极强的表现力,能够让我们迅速的解读数据中隐藏的价值。和Series一样,DataFrame对象提供了plot方法来支持绘图,底层仍然是通过matplotlib库实现图表的渲染。关于matplotlib的内容,我们在下一个章节进行详细的探讨,这里我们只简单的讲解plot方法的用法。
例如,我们想通过一张柱状图来比较“每个销售区域的销售总额”,可以直接在透视表上使用plot方法生成柱状图。我们先导入matplotlib.pyplot模块,通过修改绘图的参数使其支持中文显示。
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = 'FZJKai-Z03S'说明:上面的
FZJKai-Z03S是我电脑上已经安装的一种支持中文的字体的名称,字体的名称可以通过查看用户主目录下.matplotlib文件夹下名为fontlist-v330.json的文件来获得,而这个文件在执行上面的命令后就会生成。
使用魔法指令配置生成矢量图。
%config InlineBackend.figure_format = 'svg'绘制“每个销售区域销售总额”的柱状图。
temp = pd.pivot_table(df, index='销售区域', values='销售额', aggfunc='sum')temp.plot(figsize=(8, 4), kind='bar')plt.xticks(rotation=0)plt.show()说明:上面的第3行代码会将横轴刻度上的文字旋转到0度,第4行代码会显示图像。
输出:
如果要绘制饼图,可以修改plot方法的kind参数为pie,然后使用定制饼图的参数对图表加以定制,代码如下所示。
temp.sort_values(by='销售额', ascending=False).plot( figsize=(6, 6), kind='pie', y='销售额', ylabel='', autopct='%.2f%%', pctdistance=0.8, wedgeprops=dict(linewidth=1, width=0.35), legend=False)plt.show()输出:
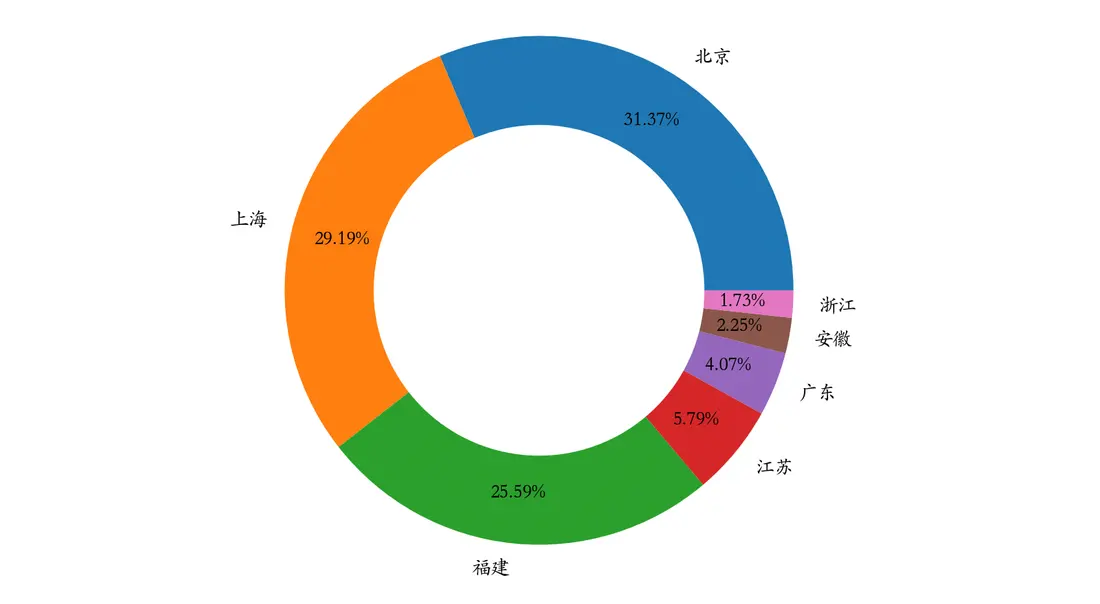
76 深入浅出pandas-5
我们再来补充一些使用DataFrame做数据分析时会使用到的操作,这些操作不仅常见而且也非常重要。
计算同比环比
我们之前讲过一个统计月度销售额的例子,我们可以通过groupby方法做分组聚合,也可以通过pivot_table生成透视表,如下所示。
sales_df = pd.read_excel('data/2020年销售数据.xlsx')sales_df['月份'] = sales_df.销售日期.dt.monthsales_df['销售额'] = sales_df.售价 * sales_df.销售数量result_df = sales_df.pivot_table(index='月份', values='销售额', aggfunc='sum')result_df.rename(columns={'销售额': '本月销售额'}, inplace=True)result_df输出:
本月销售额月份1 54098552 46084553 41649724 39967705 32390056 28179367 35013048 29481899 263296010 237538511 238528312 1691973在得到月度销售额之后,如果我们需要计算月环比,这里有两种方案。第一种方案是我们可以使用shift方法对数据进行移动,将上一个月的数据与本月数据对齐,然后通过(本月销售额 - 上月销售额) / 上月销售额来计算月环比,代码如下所示。
result_df['上月销售额'] = result_df.本月销售额.shift(1)result_df输出:
本月销售额 上月销售额月份1 5409855 NaN2 4608455 5409855.03 4164972 4608455.04 3996770 4164972.05 3239005 3996770.06 2817936 3239005.07 3501304 2817936.08 2948189 3501304.09 2632960 2948189.010 2375385 2632960.011 2385283 2375385.012 1691973 2385283.0在上面的例子中,shift方法的参数为1表示将数据向下移动一个单元,当然我们可以使用参数-1将数据向上移动一个单元。相信大家能够想到,如果我们有更多年份的数据,我们可以将参数设置为12,这样就可以计算今年的每个月与去年的每个月之间的同比。
result_df['环比'] = (result_df.本月销售额 - result_df.上月销售额) / result_df.上月销售额result_df.style.format( formatter={'上月销售额': '{:.0f}', '环比': '{:.2%}'}, na_rep='--------')输出:
本月销售额 上月销售额 环比月份1 5409855 -------- --------2 4608455 5409855 -14.81%3 4164972 4608455 -9.62%4 3996770 4164972 -4.04%5 3239005 3996770 -18.96%6 2817936 3239005 -13.00%7 3501304 2817936 24.25%8 2948189 3501304 -15.80%9 2632960 2948189 -10.69%10 2375385 2632960 -9.78%11 2385283 2375385 0.42%12 1691973 2385283 -29.07%说明:使用 JupyterLab 时,可以通过
DataFrame对象的style属性在网页中对其进行渲染,上面的代码通过Styler对象的format方法将环比格式化为百分比进行显示,此外还指定了将空值替换为--------。
更为简单的第二种方案是直接使用pct_change方法计算变化的百分比,我们先将之前的上月销售额和环比列删除掉。
result_df.drop(columns=['上月销售额', '环比'], inplace=True)接下来,我们使用DataFrame对象的pct_change方法完成环比的计算。值得一提的是,pct_change方法有一个名为periods的参数,它的默认值是1,计算相邻两项数据变化的百分比,这不就是我们想要的环比吗?如果我们有很多年的数据,在计算时把这个参数的值修改为12,就可以得到相邻两年的月同比。
result_df['环比'] = result_df.pct_change()result_df窗口计算
DataFrame对象的rolling方法允许我们将数据置于窗口中,然后用函数对窗口中的数据进行运算和处理。例如,我们获取了某只股票近期的数据,想制作5日均线和10日均线,那么就需要先设置窗口再进行运算。我们先用如下所示的代码读取2022年百度的股票数据,数据文件可以通过下面的链接来获取。
baidu_df = pd.read_excel('data/2022年股票数据.xlsx', sheet_name='BIDU', index_col='Date')baidu_df.sort_index(inplace=True)baidu_df输出:
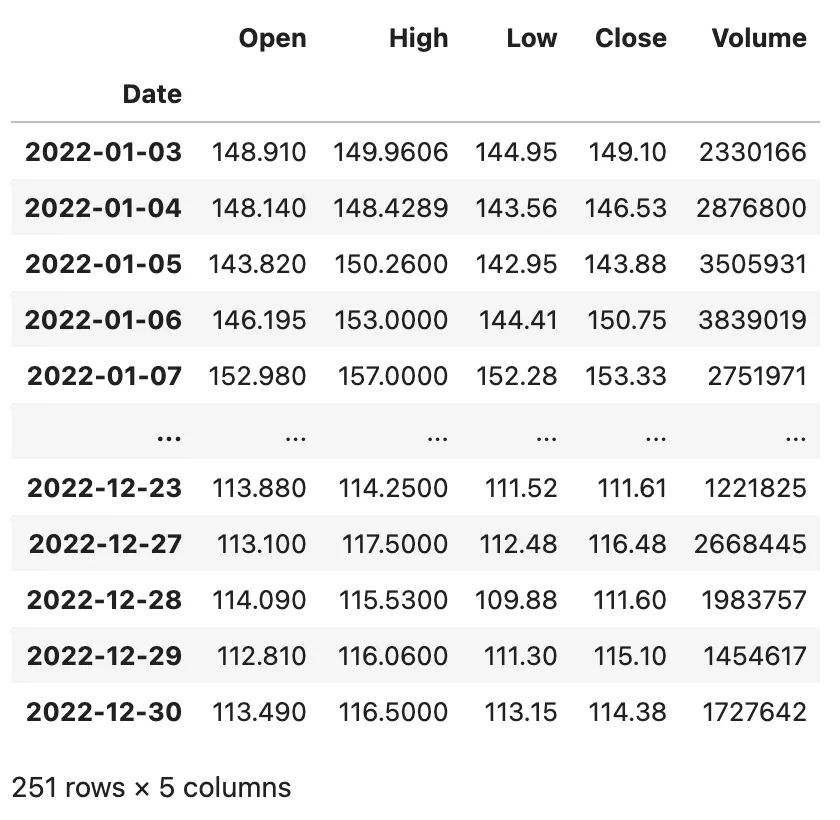
上面的DataFrame有Open、High、Low、Close、Volume五个列,分别代表股票的开盘价、最高价、最低价、收盘价和成交量,接下来我们对百度的股票数据进行窗口计算。
baidu_df.rolling(5).mean()输出:
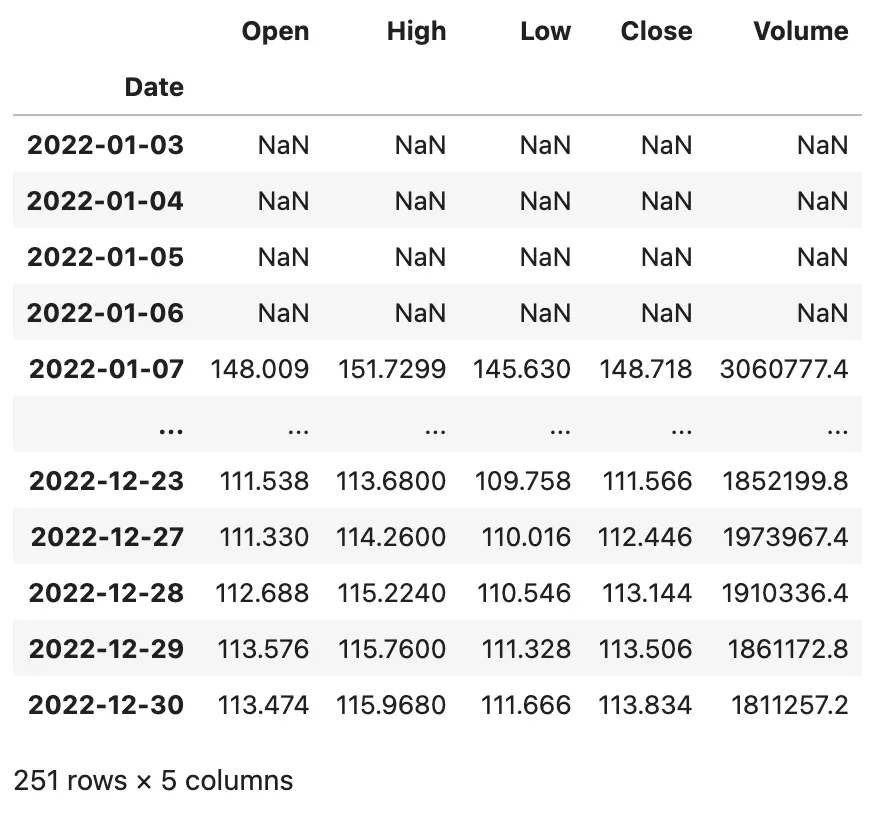
我们也可以在Series上使用rolling设置窗口并在窗口内完成运算,例如我们可以对上面的百度股票收盘价(Close列)计算5日均线和10日均线,并使用merge函数将其组装到一个DataFrame对象中并绘制出双均线图,代码如下所示。
close_ma5 = baidu_df.Close.rolling(5).mean()close_ma10 = baidu_df.Close.rolling(10).mean()result_df = pd.merge(close_ma5, close_ma10, left_index=True, right_index=True)result_df.rename(columns={'Close_x': 'MA5', 'Close_y': 'MA10'}, inplace=True)result_df.plot(kind='line', figsize=(10, 6))plt.show()输出:
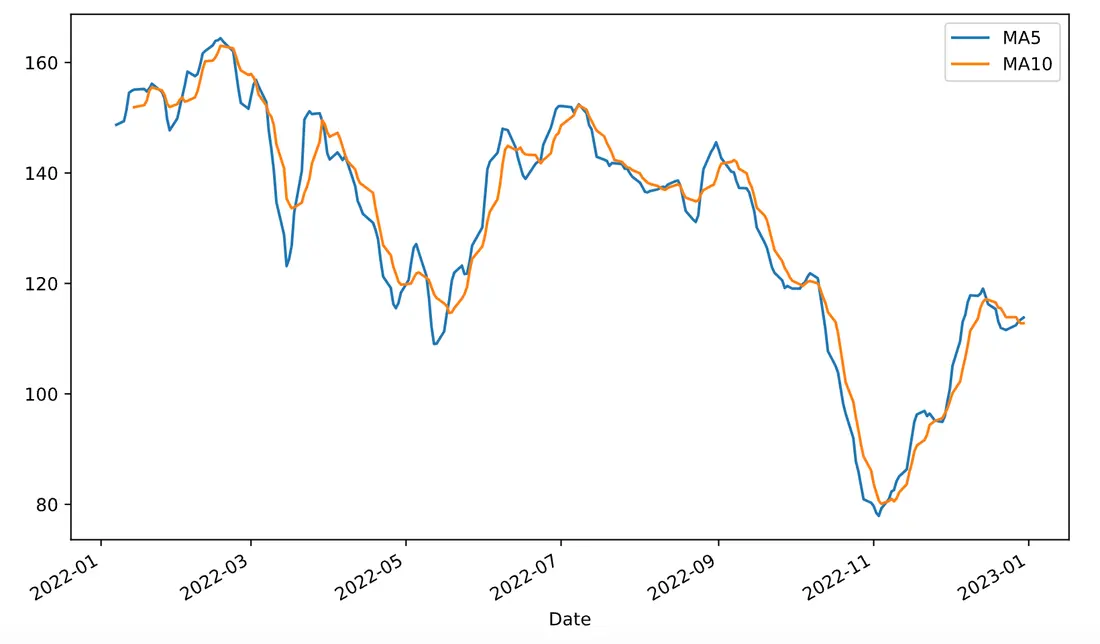
相关性判定
在统计学中,我们通常使用协方差(covariance)来衡量两个随机变量的联合变化程度。如果变量 的较大值主要与另一个变量 的较大值相对应,而两者较小值也相对应,那么两个变量倾向于表现出相似的行为,协方差为正。如果一个变量的较大值主要对应于另一个变量的较小值,则两个变量倾向于表现出相反的行为,协方差为负。简单的说,协方差的正负号显示着两个变量的相关性。方差是协方差的一种特殊情况,即变量与自身的协方差。
如果 和 是统计独立的,那么二者的协方差为 0,这是因为在 和 独立的情况下:
协方差的数值大小取决于变量的大小,通常是不容易解释的,但是正态形式的协方差可以显示两变量线性关系的强弱。在统计学中,皮尔逊积矩相关系数就是正态形式的协方差,它用于度量两个变量 和 之间的相关程度(线性相关),其值介于 -1 到 1 之间。
估算样本的协方差和标准差,可以得到样本皮尔逊系数,通常用希腊字母 表示。
我们用 值判断指标的相关性时遵循以下两个步骤。
- 判断指标间是正相关、负相关,还是不相关。
- 当 ,认为变量之间是正相关,也就是两者的趋势一致。
- 当 ,认为变量之间是负相关,也就是两者的趋势相反。
- 当 ,认为变量之间是不相关的,但并不代表两个指标是统计独立的。
- 判断指标间的相关程度。
- 当 的绝对值在 之间,认为变量之间是强相关的。
- 当 的绝对值在 之间,认为变量之间是弱相关的。
- 当 的绝对值在 之间,认为变量之间没有相关性。
皮尔逊相关系数适用于:
- 两个变量之间是线性关系,都是连续数据。
- 两个变量的总体是正态分布,或接近正态的单峰分布。
- 两个变量的观测值是成对的,每对观测值之间相互独立。
这里,我们顺便说一下,如果两组变量并不是来自于正态总体的连续值,我们该如何判断相关性呢?对于定序尺度(等级),我们可以使用斯皮尔曼秩相关系数,其计算公式如下所示:
其中, ,即每组观测中两个变量的等级差值, 为观测样本数。
对于定类尺度(类别),我们可以使用卡方检验的方式来判定其是否相关。其实很多时候,连续值也可以通过分箱的方式处理成离散的等级或类别,然后使用斯皮尔曼秩相关系数或卡方检验的方式来判定相关性。
DataFrame对象的cov方法和corr方法分别用于计算协方差和相关系数,corr方法有一个名为method的参数,其默认值是pearson,表示计算皮尔逊相关系数;除此之外,还可以指定kendall或spearman来计算肯德尔系数或斯皮尔曼秩相关系数。
我们从名为boston_house_price.csv的文件中获取著名的波士顿房价数据集来创建一个DataFrame。
boston_df = pd.read_csv('data/boston_house_price.csv')boston_df输出:
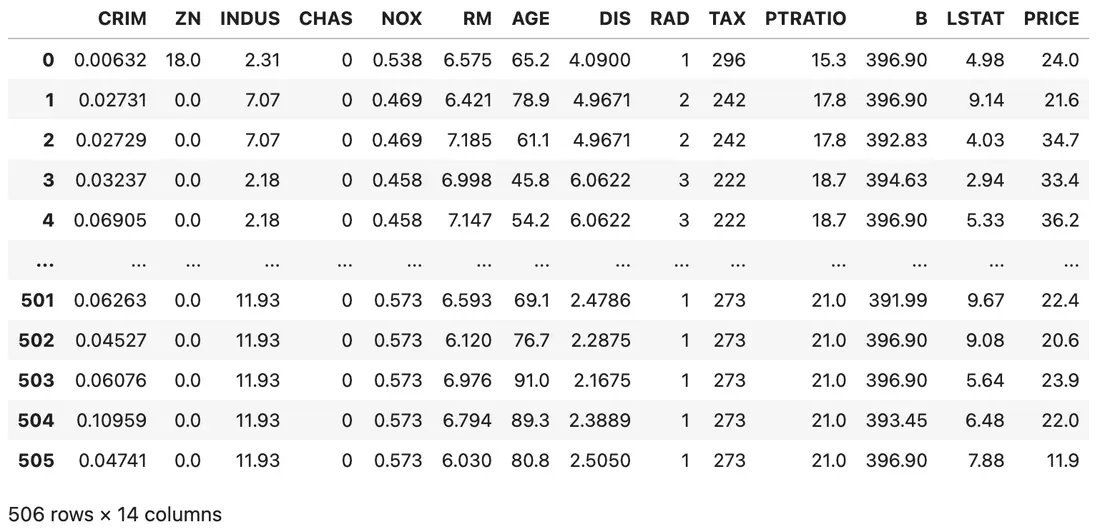
说明:上面代码中使用了相对路径来访问 CSV 文件,也就是说 CSV 文件在当前工作路径下名为
data的文件夹中。如果需要上面例子中的 CSV 文件,可以通过下面的百度云盘地址进行获取。链接:https://pan.baidu.com/s/1rQujl5RQn9R7PadB2Z5g_g?pwd=e7b4,提取码:e7b4。
可以看出,该数据集中包含了诸多影响房价的特征,包括犯罪率、一氧化氮浓度、平均房间数、低收入人群占比等,其中PRICE代表房价,具体情况如下所示。
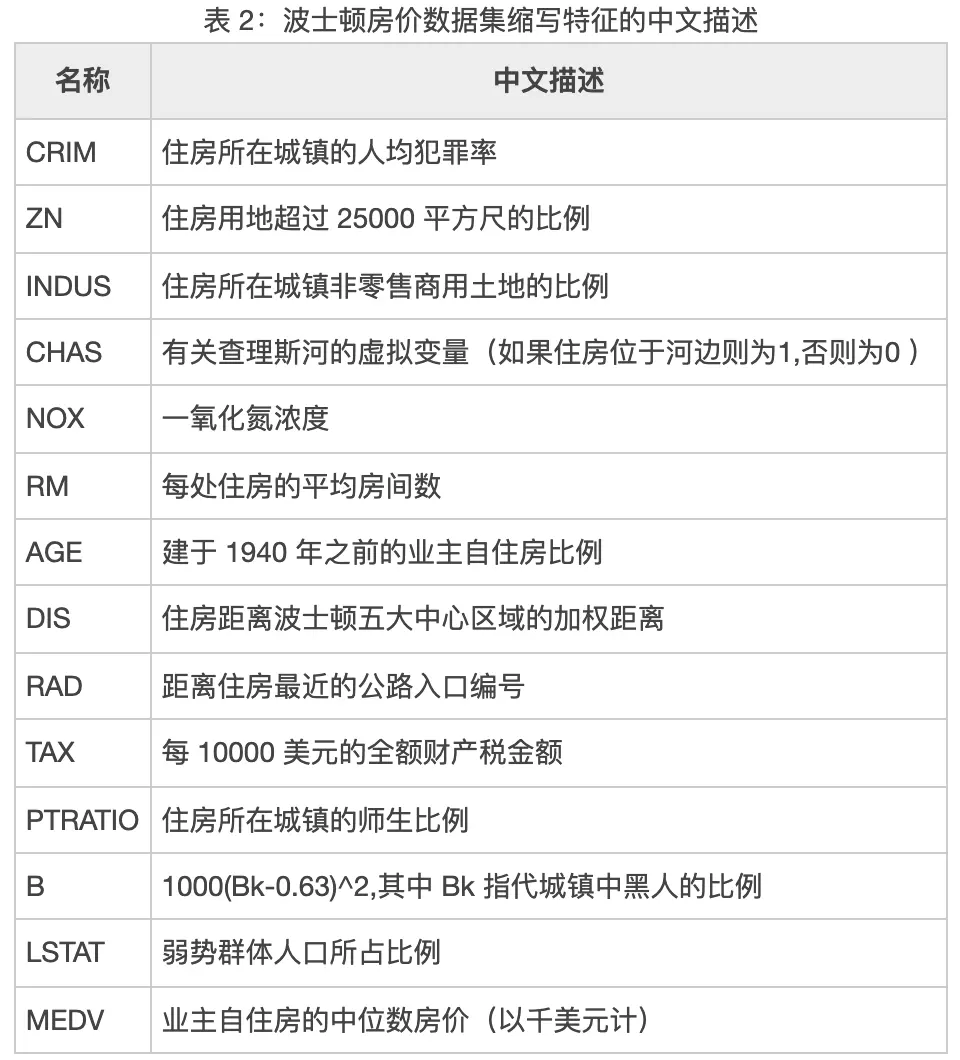
接下来,我们将其中可以视为来自于正态总体的连续值,通过corr方法计算皮尔逊相关系数,看看哪些跟房价是正相关或负相关的关系,代码如下所示。
boston_df[['NOX', 'RM', 'PTRATIO', 'LSTAT', 'PRICE']].corr()输出:
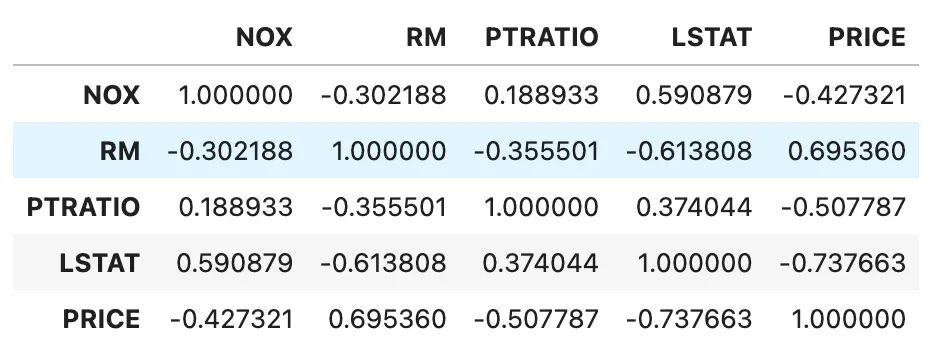
可以看出,平均房间数(RM)跟房价有较强的正相关性,而低收入人群占比(LSTAT)跟房价之间存在明显的负相关性。
斯皮尔曼秩相关系数对数据条件的要求没有皮尔逊相关系数严格,只要两个变量的观测值是成对的等级数据,或者是由连续变量转化成等级的数据,不论两个变量的总体分布形态、样本容量的大小如何,都可以用斯皮尔曼等级相关系数来进行研究。我们可以通过下面的方式对部分特征进行预处理,然后计算斯皮尔曼秩相关系数。
boston_df['CRIM'] = boston_df.CRIM.apply(lambda x: x // 5 if x < 25 else 5).map(int)boston_df['ZN'] = pd.qcut(boston_df.ZN, q=[0, 0.75, 0.8, 0.85, 0.9, 0.95, 1], labels=np.arange(6))boston_df['AGE'] = (boston_df.AGE // 20).map(int)boston_df['DIS'] = (boston_df.DIS // 2.05).map(int)boston_df['B'] = (boston_df.B // 66).map(int)boston_df['PRICE'] = pd.qcut(boston_df.PRICE, q=[0, 0.15, 0.3, 0.5, 0.7, 0.85, 1], labels=np.arange(6))boston_df[['CRIM', 'ZN', 'AGE', 'DIS', 'B', 'PRICE']].corr(method='spearman')输出:
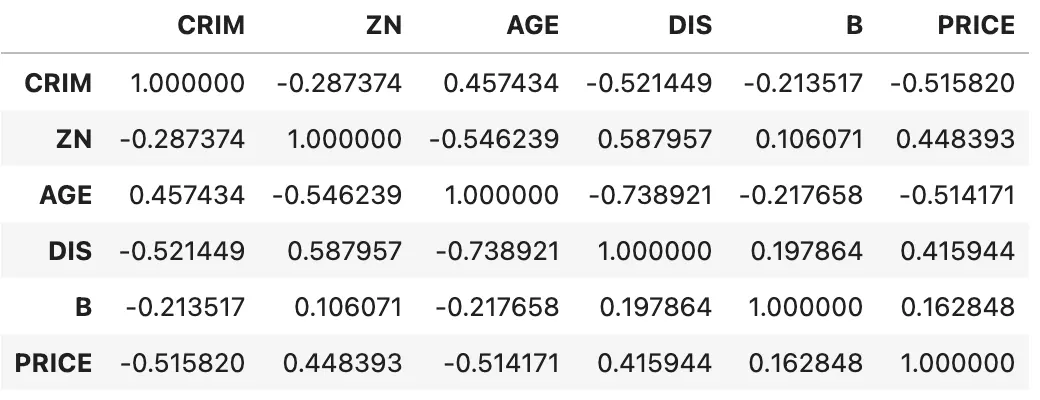
可以看出,房价跟犯罪率(CRIM)和房龄(AGE)之间存在较为明显的负相关关系,跟住房用地尺寸(ZN)存在微弱的正相关关系。相关性可以帮助我们在实际工作中找到业务抓手,即找到那些能够影响或改变工作结果的相关因素。
77 深入浅出pandas-6
我们再来看看Index类型,它为Series和DataFrame对象提供了索引服务,有了索引我们就可以排序数据(sort_index方法)、对齐数据(在运算和合并数据时非常重要)并实现对数据的快速检索(索引运算)。由于DataFrame类型表示的是二维数据,所以它的行和列都有索引,分别是index和columns。Index类型的创建的比较简单,通常给出data、dtype和name三个参数即可,分别表示作为索引的数据、索引的数据类型和索引的名称。由于Index本身也是一维的数据,索引它的方法和属性跟Series非常类似,你可以尝试创建一个Index对象,然后尝试一下之前学过的属性和方法在Index类型上是否生效。接下来,我们主要看看Index的几种子类型。
范围索引
范围索引是由具有单调性的整数构成的索引,我们可以通过RangeIndex构造器来创建范围索引,也可以通过RangeIndex类的类方法from_range来创建范围索引,代码如下所示。
代码:
sales_data = np.random.randint(400, 1000, 12)index = pd.RangeIndex(1, 13, name='月份')ser = pd.Series(data=sales_data, index=index)ser输出:
月份1 7032 7053 5574 9435 9616 6157 7888 9859 92110 95111 87412 609dtype: int64分类索引
分类索引是由定类尺度构成的索引。如果我们需要通过索引将数据分组,然后再进行聚合操作,分类索引就可以派上用场。分类索引还有一个名为reorder_categories的方法,可以给索引指定一个顺序,分组聚合的结果会按照这个指定的顺序进行呈现,代码如下所示。
代码:
sales_data = [6, 6, 7, 6, 8, 6]index = pd.CategoricalIndex( data=['苹果', '香蕉', '苹果', '苹果', '桃子', '香蕉'], categories=['苹果', '香蕉', '桃子'], ordered=True)ser = pd.Series(data=sales_data, index=index)ser输出:
苹果 6香蕉 6苹果 7苹果 6桃子 8香蕉 6dtype: int64基于索引分组数据,然后使用sum进行求和。
ser.groupby(level=0).sum()输出:
苹果 19香蕉 12桃子 8dtype: int64指定索引的顺序。
ser.index = index.reorder_categories(['香蕉', '桃子', '苹果'])ser.groupby(level=0).sum()输出:
香蕉 12桃子 8苹果 19dtype: int64多级索引
Pandas 中的MultiIndex类型用来表示层次或多级索引。可以使用MultiIndex类的类方法from_arrays、from_product、from_tuples等来创建多级索引,我们给大家举几个例子。
代码:
tuples = [(1, 'red'), (1, 'blue'), (2, 'red'), (2, 'blue')]index = pd.MultiIndex.from_tuples(tuples, names=['no', 'color'])index输出:
MultiIndex([(1, 'red'), (1, 'blue'), (2, 'red'), (2, 'blue')], names=['no', 'color'])代码:
arrays = [[1, 1, 2, 2], ['red', 'blue', 'red', 'blue']]index = pd.MultiIndex.from_arrays(arrays, names=['no', 'color'])index输出:
MultiIndex([(1, 'red'), (1, 'blue'), (2, 'red'), (2, 'blue')], names=['no', 'color'])代码:
sales_data = np.random.randint(1, 100, 4)ser = pd.Series(data=sales_data, index=index)ser输出:
no color1 red 43 blue 312 red 55 blue 75dtype: int64代码:
ser.groupby('no').sum()输出:
no1 742 130dtype: int64代码:
ser.groupby(level=1).sum()输出:
colorblue 106red 98dtype: int64代码:
stu_ids = np.arange(1001, 1006)semisters = ['期中', '期末']index = pd.MultiIndex.from_product((stu_ids, semisters), names=['学号', '学期'])courses = ['语文', '数学', '英语']scores = np.random.randint(60, 101, (10, 3))df = pd.DataFrame(data=scores, columns=courses, index=index)df输出:
语文 数学 英语学号 学期1001 期中 93 77 60 期末 93 98 841002 期中 64 78 71 期末 70 71 971003 期中 72 88 97 期末 99 100 631004 期中 80 71 61 期末 91 62 721005 期中 82 95 67 期末 84 78 86根据第一级索引分组数据,按照期中成绩占25%,期末成绩占75% 的方式计算每个学生每门课的成绩。
代码:
df.groupby(level=0).agg(lambda x: x.values[0] * 0.25 + x.values[1] * 0.75)输出:
语文 数学 英语学号1001 93.00 92.75 78.001002 68.50 72.75 90.501003 92.25 97.00 71.501004 88.25 64.25 69.251005 83.50 82.25 81.25间隔索引
间隔索引顾名思义是使用固定的间隔范围充当索引,我们通常会使用interval_range函数来创建间隔索引,代码如下所示。
代码:
index = pd.interval_range(start=0, end=5)index输出:
IntervalIndex([(0, 1], (1, 2], (2, 3], (3, 4], (4, 5]], dtype='interval[int64, right]')IntervalIndex有一个名为contains的方法,可以检查范围内是否包含了某个元素,如下所示。
代码:
index.contains(1.5)输出:
array([False, True, False, False, False])IntervalIndex还有一个名为overlaps的方法,可以检查一个范围跟其他的范围是否有重叠,如下所示。
代码:
index.overlaps(pd.Interval(1.5, 3.5))输出:
array([False, True, True, True, False])如果希望间隔范围是左闭右开的状态,可以在创建间隔索引时通过closed='left'来做到;如果希望两边都是关闭状态,可以将close参数的值赋值为both,代码如下所示。
代码:
index = pd.interval_range(start=0, end=5, closed='left')index输出:
IntervalIndex([[0, 1), [1, 2), [2, 3), [3, 4), [4, 5)], dtype='interval[int64, left]')代码:
index = pd.interval_range(start=pd.Timestamp('2022-01-01'), end=pd.Timestamp('2022-01-04'), closed='both')index输出:
IntervalIndex([[2022-01-01, 2022-01-02], [2022-01-02, 2022-01-03], [2022-01-03, 2022-01-04]], dtype='interval[datetime64[ns], both]')日期时间索引
DatetimeIndex应该是众多索引中最复杂最重要的一种索引,我们通常会使用date_range()函数来创建日期时间索引,该函数有几个非常重要的参数start、end、periods、freq、tz,分别代表起始日期时间、结束日期时间、生成周期、采样频率和时区。我们先来看看如何创建DatetimeIndex对象,再来讨论它的相关运算和操作,代码如下所示。
代码:
pd.date_range('2021-1-1', '2021-6-30', periods=10)输出:
DatetimeIndex(['2021-01-01', '2021-01-21', '2021-02-10', '2021-03-02', '2021-03-22', '2021-04-11', '2021-05-01', '2021-05-21', '2021-06-10', '2021-06-30'], dtype='datetime64[ns]', freq=None)代码:
pd.date_range('2021-1-1', '2021-6-30', freq='W')说明:
freq=W表示采样周期为一周,它会默认星期日是一周的开始;如果你希望星期一表示一周的开始,你可以将其修改为freq=W-MON;你也可以试着将该参数的值修改为12H,M,Q等,看看会发生什么,相信你不难猜到它们的含义。
输出:
DatetimeIndex(['2021-01-03', '2021-01-10', '2021-01-17', '2021-01-24', '2021-01-31', '2021-02-07', '2021-02-14', '2021-02-21', '2021-02-28', '2021-03-07', '2021-03-14', '2021-03-21', '2021-03-28', '2021-04-04', '2021-04-11', '2021-04-18', '2021-04-25', '2021-05-02', '2021-05-09', '2021-05-16', '2021-05-23', '2021-05-30', '2021-06-06', '2021-06-13', '2021-06-20', '2021-06-27'], dtype='datetime64[ns]', freq='W-SUN')DatatimeIndex可以跟DateOffset类型进行运算,这一点很好理解,以为我们可以设置一个时间差让时间向前或向后偏移,具体的操作如下所示。
代码:
index = pd.date_range('2021-1-1', '2021-6-30', freq='W')index - pd.DateOffset(days=2)输出:
DatetimeIndex(['2021-01-01', '2021-01-08', '2021-01-15', '2021-01-22', '2021-01-29', '2021-02-05', '2021-02-12', '2021-02-19', '2021-02-26', '2021-03-05', '2021-03-12', '2021-03-19', '2021-03-26', '2021-04-02', '2021-04-09', '2021-04-16', '2021-04-23', '2021-04-30', '2021-05-07', '2021-05-14', '2021-05-21', '2021-05-28', '2021-06-04', '2021-06-11', '2021-06-18', '2021-06-25'], dtype='datetime64[ns]', freq=None)代码:
index + pd.DateOffset(hours=2, minutes=10)输出:
DatetimeIndex(['2021-01-03 02:10:00', '2021-01-10 02:10:00', '2021-01-17 02:10:00', '2021-01-24 02:10:00', '2021-01-31 02:10:00', '2021-02-07 02:10:00', '2021-02-14 02:10:00', '2021-02-21 02:10:00', '2021-02-28 02:10:00', '2021-03-07 02:10:00', '2021-03-14 02:10:00', '2021-03-21 02:10:00', '2021-03-28 02:10:00', '2021-04-04 02:10:00', '2021-04-11 02:10:00', '2021-04-18 02:10:00', '2021-04-25 02:10:00', '2021-05-02 02:10:00', '2021-05-09 02:10:00', '2021-05-16 02:10:00', '2021-05-23 02:10:00', '2021-05-30 02:10:00', '2021-06-06 02:10:00', '2021-06-13 02:10:00', '2021-06-20 02:10:00', '2021-06-27 02:10:00'], dtype='datetime64[ns]', freq=None)如果Series对象或DataFrame对象使用了DatetimeIndex类型的索引,此时我们可以通过asfreq()方法指定一个时间频率来实现对数据的抽样,我们仍然以之前讲过的百度股票数据为例,给大家做一个演示。
代码:
baidu_df = pd.read_excel('data/2022年股票数据.xlsx', sheet_name='BIDU', index_col='Date')baidu_df.sort_index(inplace=True)baidu_df.asfreq('5D')输出:
大家可能注意到了,每5天抽取1天有可能会抽中非交易日,那么对应的列都变成了空值,为了解决这个问题,在使用asfreq方法时可以通过method参数来指定一种填充空值的方法,可以将相邻的交易日的数据填入进来。
代码:
baidu_df.asfreq('5D', method='ffill')输出:
当使用DatetimeIndex索引时,我们也可以通过resample()方法基于时间对数据进行重采样,相当于根据时间周期对数据进行了分组操作,分组之后还可以进行聚合统计,代码如下所示。
代码:
baidu_df.resample('1M').mean()输出:
代码:
baidu_df.resample('1M').agg(['mean', 'std'])输出:
提示:不知大家是否注意到,上面输出的
DataFrame的列索引是一个MultiIndex对象。你可以访问上面的DataFrame对象的columns属性看看。
如果要实现日期时间的时区转换,我们可以先用tz_localize()方法将日期时间本地化,代码如下所示。
代码:
baidu_df = baidu_df.tz_localize('Asia/Chongqing')baidu_df输出:
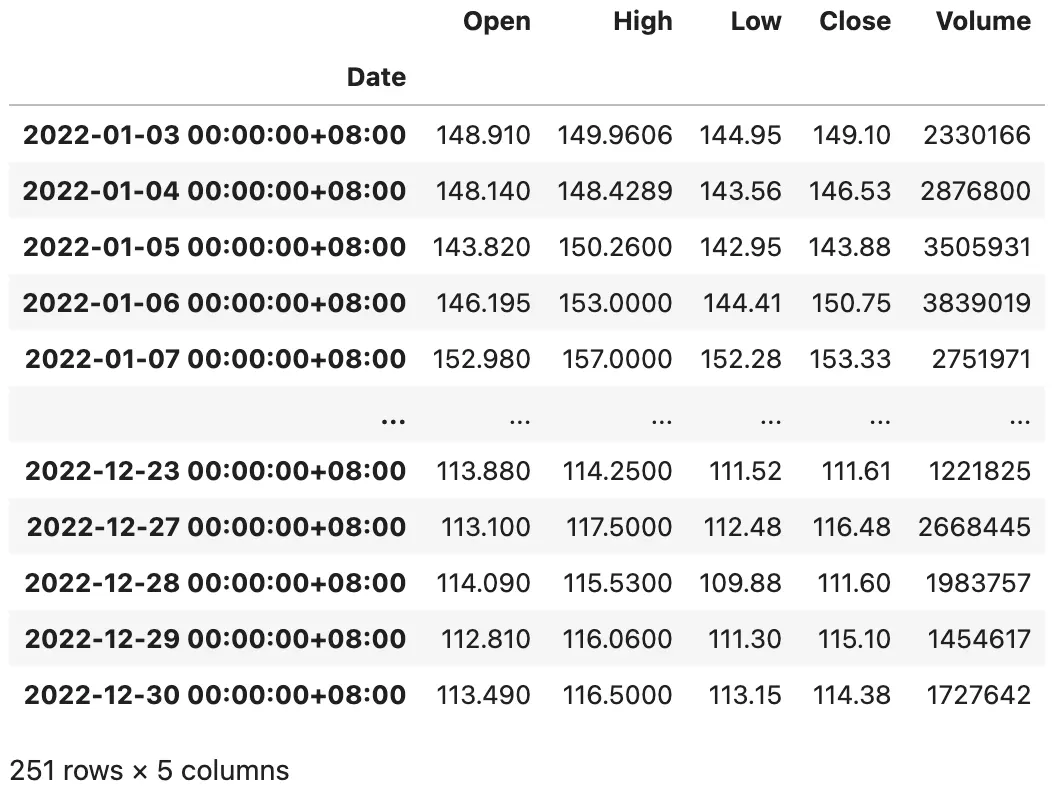
在对时间本地化以后,我们再使用tz_convert()方法就可以实现转换时区,代码如下所示。
代码:
baidu_df.tz_convert('America/New_York')输出:
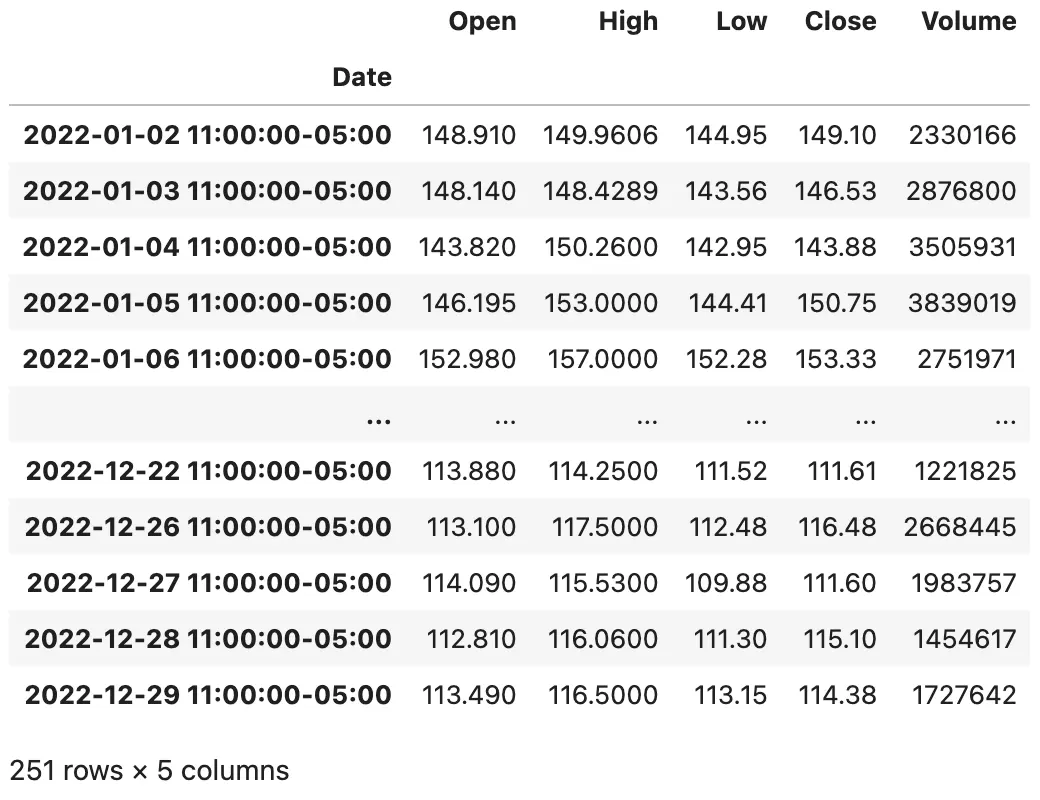
如果你的数据使用了DatetimeIndex类型的索引,那么你就很有可能要对数据进行时间序列分析,关于时间序列分析的方法和模型并不是本章节要探讨的内容,我们在其他的专栏中为大家分享。
78 数据可视化-1
在完成了对数据的透视之后,我们可以将数据透视的结果通过可视化的方式呈现出来,简单的说,就是将数据变成漂亮的统计图表,因为人类对颜色和形状会更加敏感,然后再进一步解读数据背后隐藏的商业价值。在之前的课程中,我们已经为大家展示过用使用Series或DataFrame对象的plot方法生成可视化图表的操作,本章我们为大家讲解这个绘图方法的基石,它就是大名鼎鼎的 matplotlib 库。
在讲解 matplotlib 之前,请大家先看看下面这张图,它给出了常用的图表类型及其应用场景。我们在选择统计图表时,如果不知道做出怎样的选择最合适,相信这张图就能帮到你。简单的说,看趋势折线图,比数据柱状图,定关系散点图,查占比饼状图,看分布直方图,找离群箱线图。
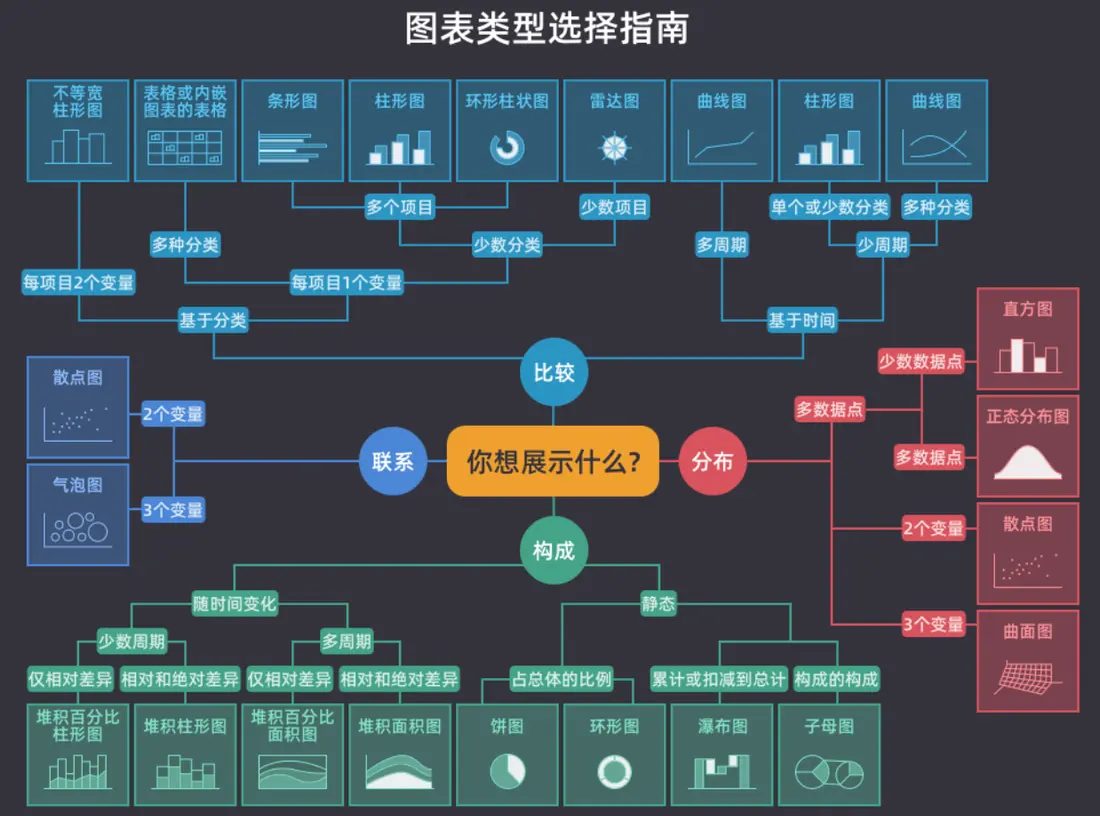
导入和配置
之前的课程中,我们为大家讲解过如何安装和导入 matplotlib 库,如果不确定是否已经安装了 matplotlib,可以使用下面的魔法指令尝试安装或升级你的 matplotlib。
%pip install -U matplotlib为了解决 matplotlib 图表中文显示的问题,我们需要修改pyplot模块的rcParams配置参数,具体的操作如下所示。
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'].insert(0, 'SimHei')plt.rcParams['axes.unicode_minus'] = False说明:上面代码中的
SimHei是字体名称,大家可以通过百度云盘下载并安装该字体,链接地址:https://pan.baidu.com/s/1rQujl5RQn9R7PadB2Z5g_g?pwd=e7b4。你可以尝试安装其他的中文字体,安装之后如果不知道字体叫什么名字,可以到用户主目录下名为`.matplotlib`的文件夹中找到`fontlist-v330.json`文件,打开后可以看到字体文件的路径和字体的名称等信息。需要注意的是,使用中文字体后坐标轴上的负号将会无法显示,需要将`axes.unicode_minus`参数设置为`False`,这样才能让坐标轴上的负号正常显示。
通过下面的魔法指令,我们可以在绘图时生成矢量图(SVG - Scalable Vector Graphics),矢量图的特点是不会因为放大、缩小或旋转等操作而失真,看起来会舒服很多。
%config InlineBackend.figure_format='svg'创建画布
pyplot模块的figure函数可以用来创建画布,创建画布时,可以通过figsize参数指定画布的尺寸(默认值是[6.4, 4.8]);可以通过dpi参数设置绘图的分辨率,因为dpi代表了每英寸的像素点数量。除此之外,还可以通过facecolor参数设置画布的背景色。figure函数的返回值是一个Figure对象,它代表了绘图使用的画布,我们可以基于画布来创建绘图使用的坐标系。
plt.figure(figsize=(8, 4), dpi=120, facecolor='darkgray')创建坐标系
可以直接使用pyplot模块的subplot函数来创建坐标系,该函数会返回Axes对象。subplot的前三个参数分别用来指定整个画布分成几行几列以及当前坐标系的索引,这三个参数的默认值都是1。如果没有创建坐标系,我们绘图时会使用画布上默认的也是唯一的一个坐标系;如果需要在画布上创建多个坐标系,就可以使用该函数。当然,我们也可以通过上面创建的Figure对象的add_subplot方法或add_axes方法来创建坐标系,前者跟subplot函数的作用一致,后者会产生嵌套的坐标系。
plt.subplot(2, 2, 1)绘制图表
折线图
在绘图时,如果没有先调用figure函数和subplot函数,我们将使用默认的画布和坐标系,如果要绘制折线图,可以使用pyplot模块的plot函数,并指定横轴和纵轴的数据。折线图最适合用来观察数据的趋势,尤其是当横坐标代表时间的情况下。我们可以使用plot函数的color参数来定制折线的颜色,可以使用marker参数来定制数据点的标记(例如:*表示五角星,^表示三角形,o表示小圆圈等),可以使用linestyle参数来定制折线的样式(例如:-表示实线,--表示虚线,:表示点线等),可以使用linewidth参数来定制折线的粗细。 下面的代码绘制了一条正弦曲线,其中marker='*'会将数据点的标记设置为五角星形状,而color='red'会将折线绘制为红色。
代码:
import numpy as np
x = np.linspace(-2 * np.pi, 2 * np.pi, 120)y = np.sin(x)
# 创建画布plt.figure(figsize=(8, 4), dpi=120)# 绘制折线图plt.plot(x, y, linewidth=2, marker='*', color='red')# 显示绘图plt.show()输出:
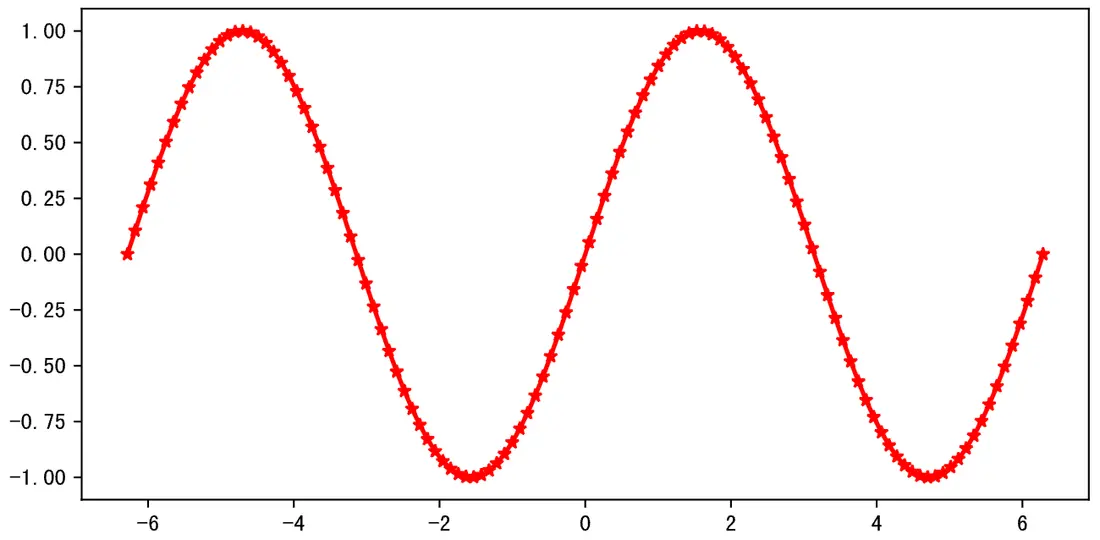
如果要在一个坐标系上同时绘制正弦和余弦曲线,可以对上面的代码稍作修改。
代码:
x = np.linspace(-2 * np.pi, 2 * np.pi, 120)y1, y2 = np.sin(x), np.cos(x)
plt.figure(figsize=(8, 4), dpi=120)plt.plot(x, y1, linewidth=2, marker='*', color='red')plt.plot(x, y2, linewidth=2, marker='^', color='blue')# 定制图表上的标注(annotate函数的参数如果不理解可以先不管它)plt.annotate('sin(x)', xytext=(0.5, -0.75), xy=(0, -0.25), fontsize=12, arrowprops={ 'arrowstyle': '->', 'color': 'darkgreen', 'connectionstyle': 'angle3, angleA=90, angleB=0'})plt.annotate('cos(x)', xytext=(-3, 0.75), xy=(-1.25, 0.5), fontsize=12, arrowprops={ 'arrowstyle': '->', 'color': 'darkgreen', 'connectionstyle': 'arc3, rad=0.35'})plt.show()输出:
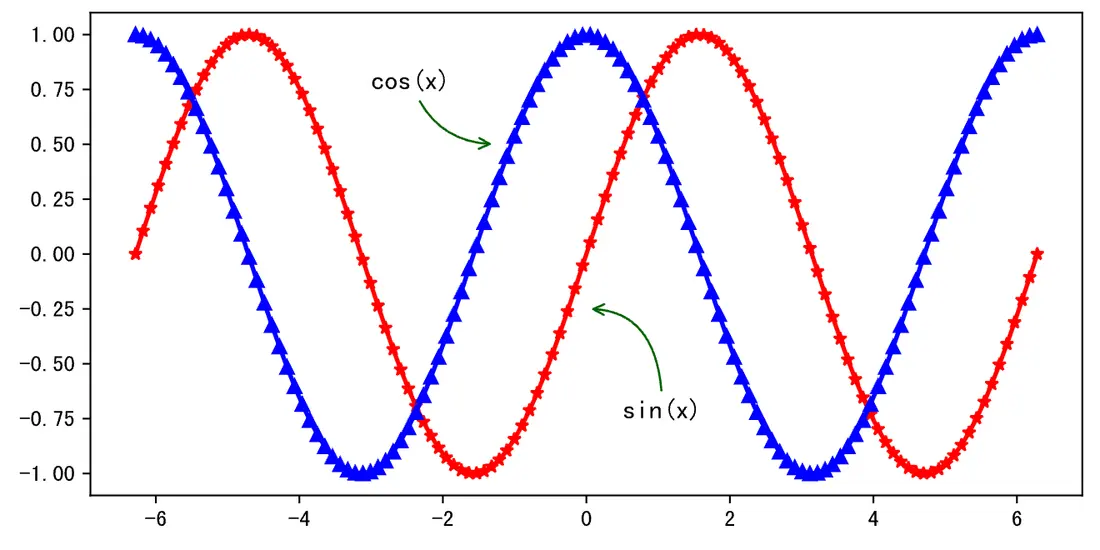
如果要使用两个坐标系分别绘制正弦和余弦,可以用上面提到的subplot函数来创建坐标系,然后再绘图。
代码:
plt.figure(figsize=(8, 4), dpi=120)# 创建坐标系(第1个图)plt.subplot(2, 1, 1)plt.plot(x, y1, linewidth=2, marker='*', color='red')# 创建坐标系(第2个图)plt.subplot(2, 1, 2)plt.plot(x, y2, linewidth=2, marker='^', color='blue')plt.show()输出:
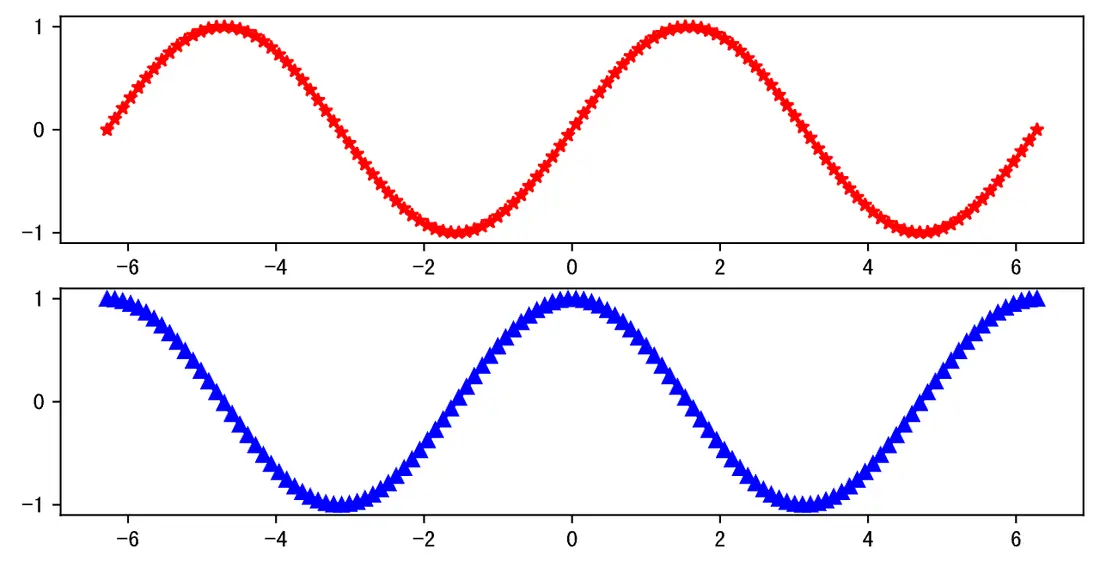
当然也可以像下面这么做,大家可以运行代码看看跟上面的图有什么区别。
plt.figure(figsize=(8, 4), dpi=120)plt.subplot(1, 2, 1)plt.plot(x, y1, linewidth=2, marker='*', color='red')plt.subplot(1, 2, 2)plt.plot(x, y2, linewidth=2, marker='^', color='blue')plt.show()然后,再试一试下面这个代码,看看运行效果如何。
fig = plt.figure(figsize=(10, 4), dpi=120)plt.plot(x, y1, linewidth=2, marker='*', color='red')# 用Figure对象的add_axes方法在现有坐标系中嵌套一个新的坐标系,该方法的参数是一个四元组,# 代表了新坐标系在原坐标系中的位置,前两个值是左下角的位置,后两个值是坐标系的宽度和高度ax = fig.add_axes((0.595, 0.6, 0.3,0.25))ax.plot(x, y2, marker='^', color='blue')ax = fig.add_axes((0.155, 0.2, 0.3,0.25))ax.plot(x, y2, marker='^', color='green')plt.show()散点图
散点图可以帮助我们了解两个变量的关系,如果需要了解三个变量的关系,可以将散点图升级为气泡图。下面的代码中,x和y两个数组分别表示每个月的收入和每个月网购的支出,如果我们想了解x和y是否存在相关关系,就可以绘制如下所示的散点图。
代码:
x = np.array([5550, 7500, 10500, 15000, 20000, 25000, 30000, 40000])y = np.array([800, 1800, 1250, 2000, 1800, 2100, 2500, 3500])
plt.figure(figsize=(6, 4), dpi=120)plt.scatter(x, y)plt.show()输出:
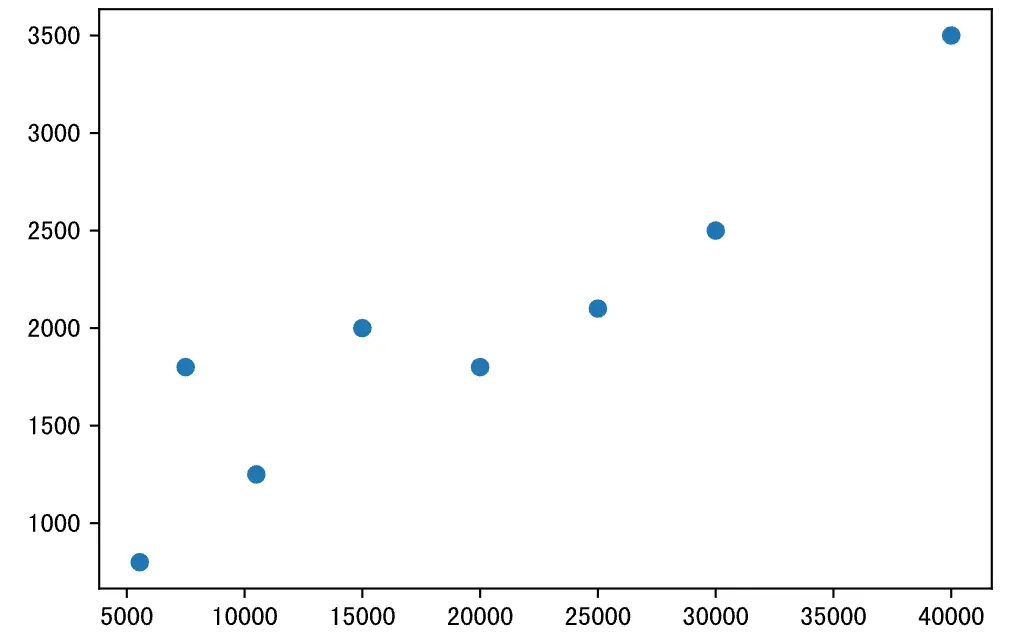
柱状图
在对比数据的差异时,柱状图是非常棒的选择,我们可以使用pyplot模块的bar函数来生成柱状图,也可以使用barh函数来生成水平柱状图(也称为“条状图”)。我们先为柱状图准备一些数据,代码如下所示。
x = np.arange(4)y1 = np.random.randint(20, 50, 4)y2 = np.random.randint(10, 60, 4)绘制柱状图的代码。
代码:
plt.figure(figsize=(6, 4), dpi=120)# 通过横坐标的偏移,让两组数据对应的柱子分开,width参数控制柱子的粗细,label参数为柱子添加标签plt.bar(x - 0.1, y1, width=0.2, label='销售A组')plt.bar(x + 0.1, y2, width=0.2, label='销售B组')# 定制横轴的刻度plt.xticks(x, labels=['Q1', 'Q2', 'Q3', 'Q4'])# 定制显示图例plt.legend()plt.show()输出:
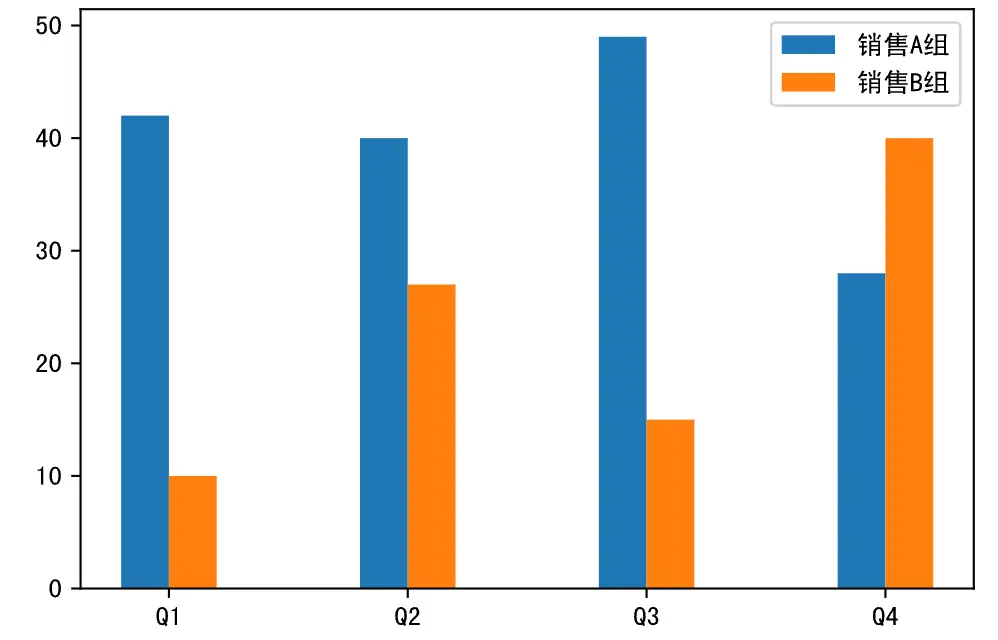
如果想绘制堆叠柱状图,可以对上面的代码稍作修改,如下所示。
代码:
labels = ['Q1', 'Q2', 'Q3', 'Q4']plt.figure(figsize=(6, 4), dpi=120)plt.bar(labels, y1, width=0.4, label='销售A组')# 注意:堆叠柱状图的关键是将之前的柱子作为新柱子的底部,可以通过bottom参数指定底部数据,新柱子绘制在底部数据之上plt.bar(labels, y2, width=0.4, bottom=y1, label='销售B组')plt.legend(loc='lower right')plt.show()输出:
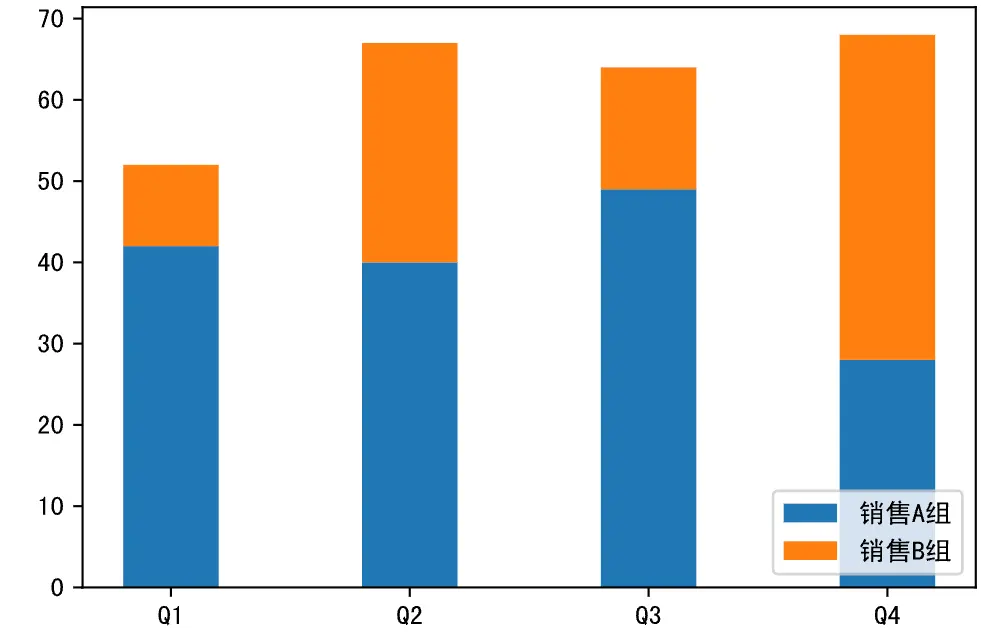
饼状图
饼状图通常简称为饼图,是一个将数据划分为几个扇形区域的统计图表,它主要用于描述数量、频率等之间的相对关系。在饼图中,每个扇形区域的大小就是其所表示的数量的比例,这些扇形区域合在一起刚好是一个完整的饼。在需要展示数据构成的场景下,饼状图、树状图和瀑布图是不错的选择,我们可以使用pyplot模块的pie函数来绘制饼图,代码如下所示。
代码:
data = np.random.randint(100, 500, 7)labels = ['苹果', '香蕉', '桃子', '荔枝', '石榴', '山竹', '榴莲']
plt.figure(figsize=(5, 5), dpi=120)plt.pie( data, # 自动显示百分比 autopct='%.1f%%', # 饼图的半径 radius=1, # 百分比到圆心的距离 pctdistance=0.8, # 颜色(随机生成) colors=np.random.rand(7, 3), # 分离距离 # explode=[0.05, 0, 0.1, 0, 0, 0, 0], # 阴影效果 # shadow=True, # 字体属性 textprops=dict(fontsize=8, color='black'), # 楔子属性(生成环状饼图的关键) wedgeprops=dict(linewidth=1, width=0.35), # 标签 labels=labels)# 定制图表的标题plt.title('水果销售额占比')plt.show()输出:
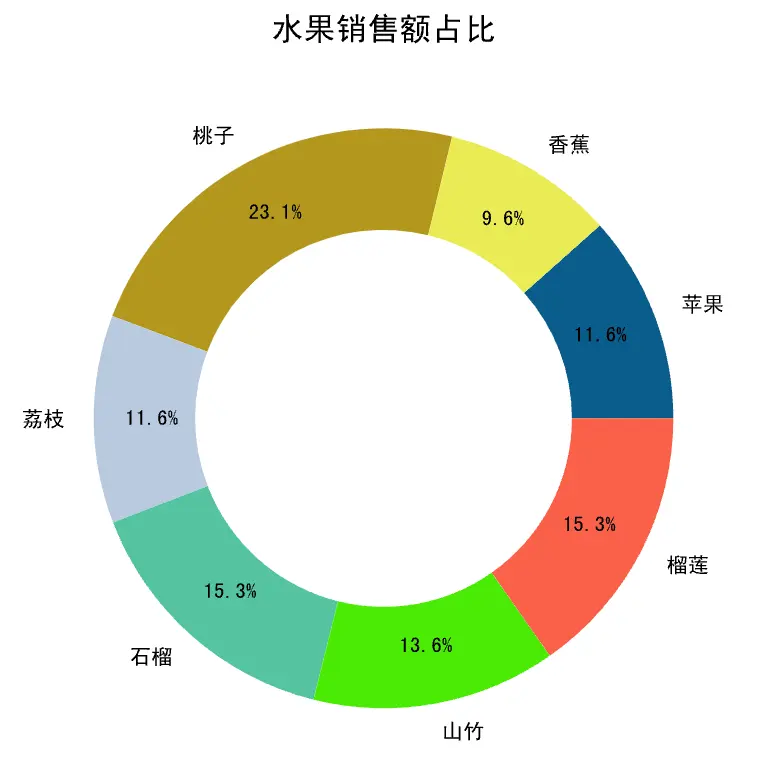
说明:大家可以试一试将上面代码中被注释的部分恢复,看看有什么样的效果。
直方图
在统计学中,直方图是一种展示数据分布情况的图形,是一种二维统计图表,它的两个坐标分别是统计样本和该样本对应的某个属性的度量。下面的数据是某学校100名男学生的身高,如果我们想知道数据的分布,就可以使用直方图。
heights = np.array([ 170, 163, 174, 164, 159, 168, 165, 171, 171, 167, 165, 161, 175, 170, 174, 170, 174, 170, 173, 173, 167, 169, 173, 153, 165, 169, 158, 166, 164, 173, 162, 171, 173, 171, 165, 152, 163, 170, 171, 163, 165, 166, 155, 155, 171, 161, 167, 172, 164, 155, 168, 171, 173, 169, 165, 162, 168, 177, 174, 178, 161, 180, 155, 155, 166, 175, 159, 169, 165, 174, 175, 160, 152, 168, 164, 175, 168, 183, 166, 166, 182, 174, 167, 168, 176, 170, 169, 173, 177, 168, 172, 159, 173, 185, 161, 170, 170, 184, 171, 172])可以使用pyplot模块的hist函数来绘制直方图,其中bins参数代表了我们使用的分箱方式(身高从150厘米到190厘米,每5厘米为一个分箱),代码如下所示。
代码:
plt.figure(figsize=(6, 4), dpi=120)# 绘制直方图plt.hist(heights, bins=np.arange(145, 196, 5), color='darkcyan')# 定制横轴标签plt.xlabel('身高')# 定制纵轴标签plt.ylabel('概率密度')plt.show()输出:
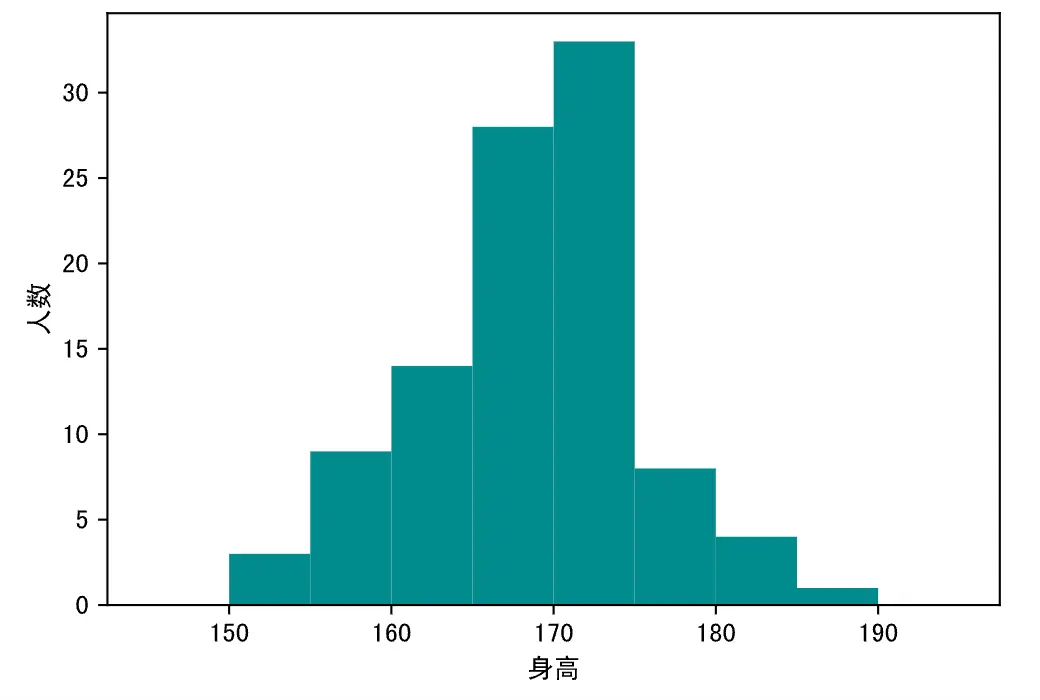
绘制直方图时,如果将hist函数的density参数修改为True,同时将cumulative参数也修改为True,那么一方面纵轴会显示为概率密度,而图表会绘制概率的累计分布,如下所示。
代码:
plt.figure(figsize=(6, 4), dpi=120)# 绘制直方图plt.hist(heights, bins=np.arange(145, 196, 5), color='darkcyan', density=True, cumulative=True)# 定制横轴标签plt.xlabel('身高')# 定制纵轴标签plt.ylabel('概率')plt.show()输出:
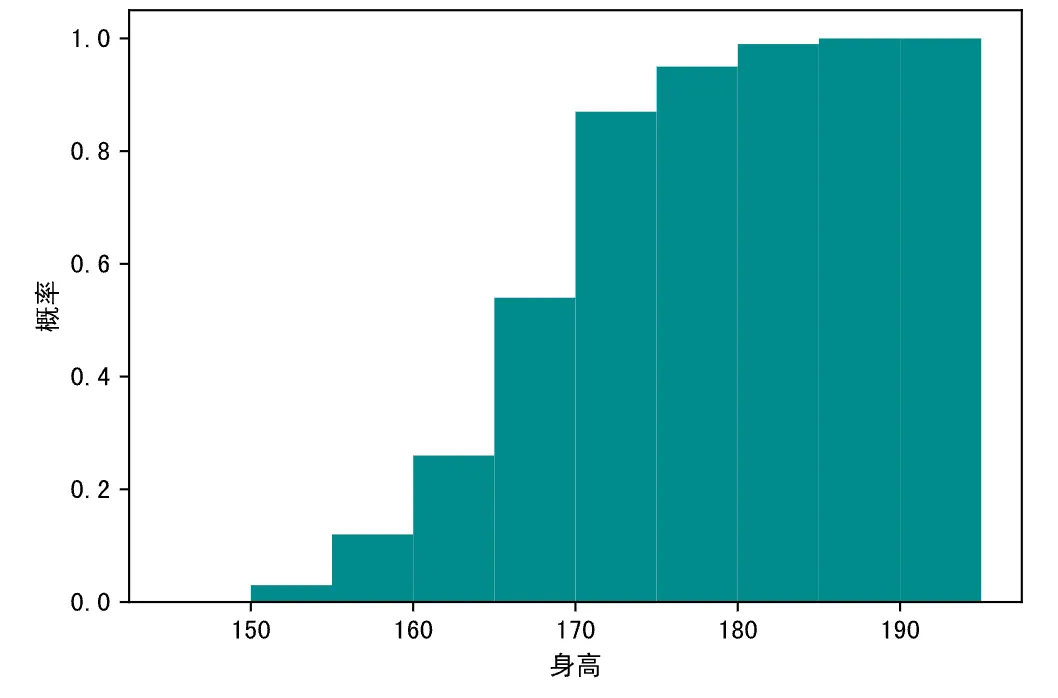
箱线图
箱线图又叫箱型图或盒须图,是一种用于展示一组数据分散情况的统计图表,如下所示。因图形如箱子,而且在上下四分位数之外有线条像胡须延伸出去而得名。在箱线图中,箱子的上边界是上四分位数( )的位置,箱子的下边界是下四分位数( )的位置,箱子中间的线条是中位数( )的位置,而箱子的长度就是四分位距离(IQR)。除此之外,箱子上方线条的边界是最大值,箱子下方线条的边界是最小值,这两条线之外的点就是离群值(outlier)。所谓离群值,是指数据小于 或数据大于 的值,公式中的1.5还可以替换为3来发现极端离群值(extreme outlier),而介于1.5到3之间的离群值通常称之为适度离群值(mild outlier)。
可以使用pyplot模块的boxplot函数来绘制箱线图,代码如下所示。
代码:
# 数组中有47个[0, 100)范围的随机数data = np.random.randint(0, 100, 47)# 向数组中添加三个可能是离群点的数据data = np.append(data, 160)data = np.append(data, 200)data = np.append(data, -50)
plt.figure(figsize=(6, 4), dpi=120)# whis参数的默认值是1.5,将其设置为3可以检测极端离群值,showmeans=True表示在图中标记均值的位置plt.boxplot(data, whis=1.5, showmeans=True, notch=True)# 定制纵轴的取值范围plt.ylim([-100, 250])# 定制横轴的刻度plt.xticks([1], labels=['data'])plt.show()输出:
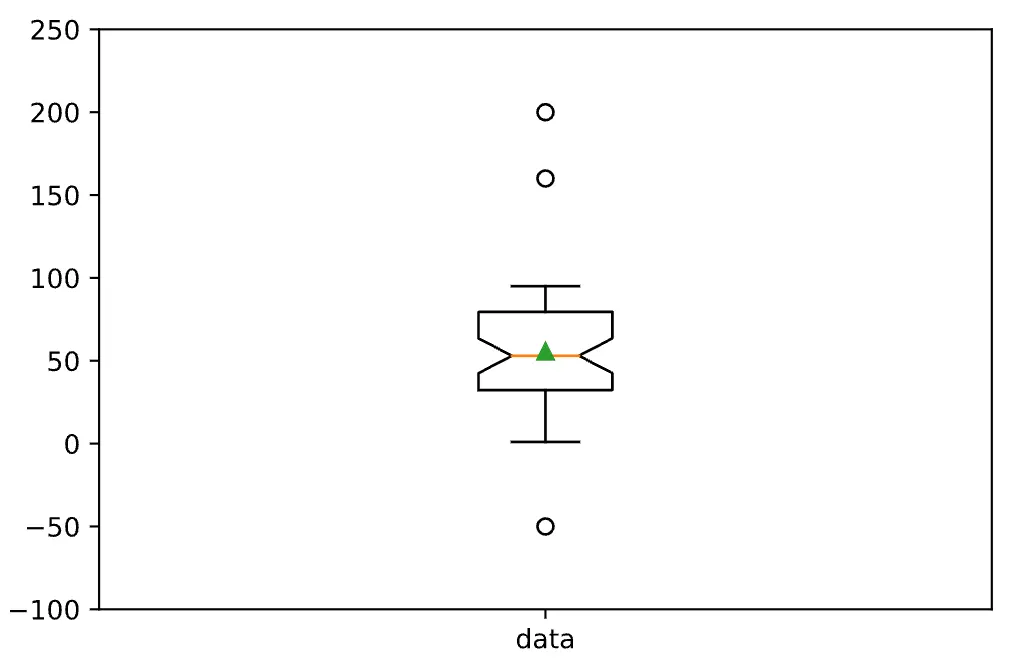
说明:由于数据是随机生成的,大家运行上面的代码生成的图表可能跟我这里并不相同,以实际运行结果为准。
显示和保存图表
可以使用pyplot模块的show函数来显示绘制的图表,我们在上面的代码中使用过这个函数。如果希望保存图表,可以使用savefig函数。需要注意的是,如果要同时显示和保存图表,应该先执行savefig函数,再执行show函数,因为在调用show函数时,图表已经被释放,位于show函数之后的savefig保存的只是一个空白的区域。
plt.savefig('chart.png')plt.show()其他图表
使用 matplotlib,我们还可以绘制出其他的统计图表(如:雷达图、玫瑰图、热力图等),但实际工作中,使用频率最高的几类图表我们在上面已经为大家完整的展示出来了。此外,matplotlib 还有很多对统计图表进行定制的细节,例如定制坐标轴、定制图表上的文字和标签等。如果想了解如何用 matplotlib 绘制和定制更多的统计图表,可以直接查看 matplotlib 官方网站上的文档和示例,在下一个章节我们会为大家做一个简要的介绍。
79 数据可视化-2
本章我们尝试用 matplotlib 来绘制一些高阶统计图表。正如前面所说的,大家可以通过 matplotlib 官方网站上提供的文档和示例来学习如何使用 matplotlib 并绘制出更加高级的统计图表;尤其是在定制一些比较复杂的图表时,我们建议大家直接找到官网提供的示例,然后只需要做出相应的修改,就可以绘制出自己想要的图表。这种“拷贝+修改”的做法应该会大大提高你的工作效率,因为大多数时候,你的代码跟官网上的代码就仅仅是数据有差别而已,没有必要去做重复乏味的事情。
气泡图
气泡图可以用来了解三个变量之间的关系,通过比较气泡位置和大小来分析数据维度之间的相关性。例如在我们之前绘制的月收入和网购支出的散点图中,我们已经发现了二者的正相关关系,如果我们引入第三个变量网购次数,那么我们就需要使用气泡图来进行展示。
代码:
income = np.array([5550, 7500, 10500, 15000, 20000, 25000, 30000, 40000])outcome = np.array([800, 1800, 1250, 2000, 1800, 2100, 2500, 3500])nums = np.array([5, 3, 10, 5, 12, 20, 8, 10])
# 通过scatter函数的s参数和c参数分别控制面积和颜色plt.scatter(income, outcome, s=nums * 30, c=nums, cmap='Reds')# 显示颜色条plt.colorbar()# 显示图表plt.show()输出:
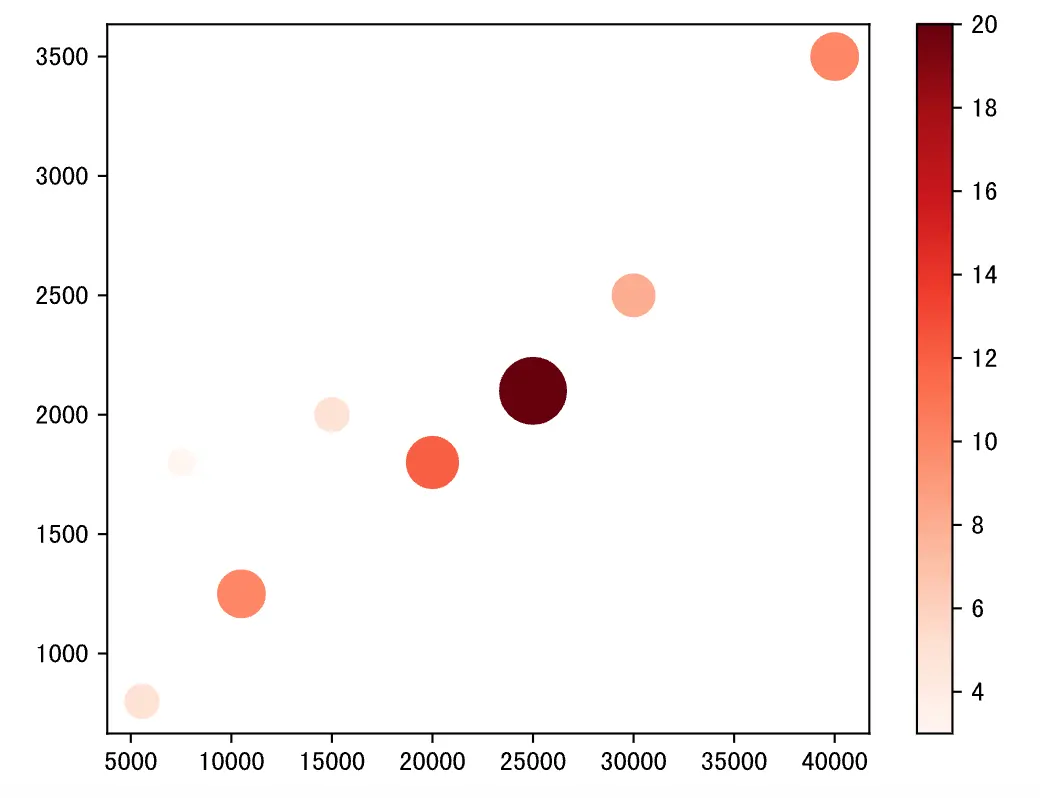
面积图
面积图又叫堆叠折线图,是在折线图的基础上,对折线以下的区域进行颜色填充(展示面积),用于在连续间隔或时间跨度上展示数值,一般用来显示趋势和对比数值,不同颜色的填充可以让多个面积块之间的对比和趋势更好的突显。下面的例子中,我们用面积图来展示从周一到周日花在睡觉、吃饭、工作和玩耍上的时间。
代码:
plt.figure(figsize=(8, 4))days = np.arange(7)sleeping = [7, 8, 6, 6, 7, 8, 10]eating = [2, 3, 2, 1, 2, 3, 2]working = [7, 8, 7, 8, 6, 2, 3]playing = [8, 5, 9, 9, 9, 11, 9]# 绘制堆叠折线图plt.stackplot(days, sleeping, eating, working, playing)# 定制横轴刻度plt.xticks(days, labels=[f'星期{x}' for x in '一二三四五六日'])# 定制图例plt.legend(['睡觉', '吃饭', '工作', '玩耍'], fontsize=10)# 显示图表plt.show()输出:
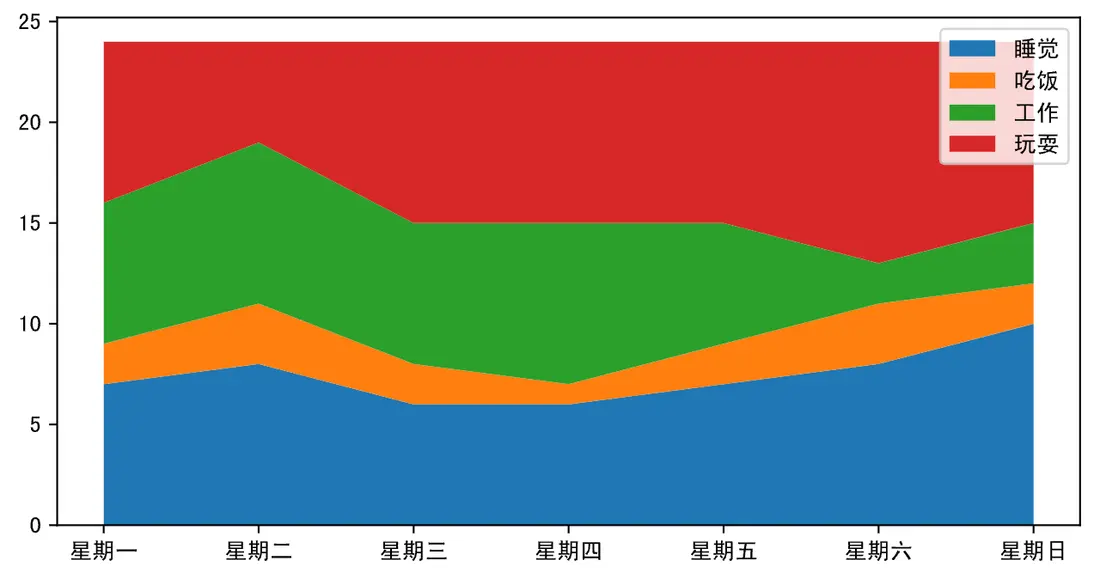
雷达图
雷达图通常用来比较多个定量数据,用于查看哪些变量具有相似的值。 雷达图也可用于查看数据集中哪些变量的值比较低,哪些变量的值比较高,是显示性能或表现的理想选择。经常观看篮球、足球比赛的读者应该对雷达图非常熟悉,例如在 NBA 的转播中就经常使用雷达图来展示球员的各项数据。雷达图的本质折线图,只不过将折线图映射到了极坐标系。在绘制雷达图时,需要让折线闭合,简单的说就是首尾相连,下面是绘制雷达图的代码。
代码:
labels = np.array(['速度', '力量', '经验', '防守', '发球', '技术'])# 马龙和水谷隼的数据malong_values = np.array([93, 95, 98, 92, 96, 97])shuigu_values = np.array([30, 40, 65, 80, 45, 60])angles = np.linspace(0, 2 * np.pi, labels.size, endpoint=False)# 多加一条数据让图形闭合malong_values = np.append(malong_values, malong_values[0])shuigu_values = np.append(shuigu_values, shuigu_values[0])angles = np.append(angles, angles[0])# 创建画布plt.figure(figsize=(4, 4), dpi=120)# 创建坐标系ax = plt.subplot(projection='polar')# 绘图和填充plt.plot(angles, malong_values, color='r', linewidth=2, label='马龙')plt.fill(angles, malong_values, color='r', alpha=0.3)plt.plot(angles, shuigu_values, color='g', linewidth=2, label='水谷隼')plt.fill(angles, shuigu_values, color='g', alpha=0.2)# 显示图例ax.legend()# 显示图表plt.show()输出:
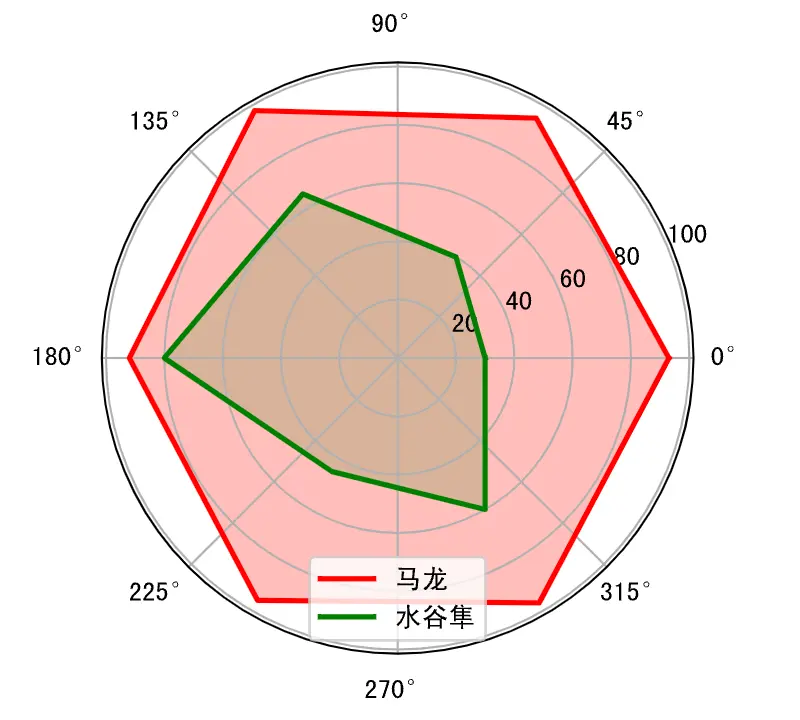
玫瑰图
玫瑰图是映射在极坐标下的柱状图,由弗罗伦斯·南丁格尔(Florence Nightingale)所发明,当年是南丁格尔用来呈现战地医院季节性死亡率的一种图表。由于半径和面积的关系是平方的关系,南丁格尔玫瑰图会将数据的比例大小夸大,尤其适合对比大小相近的数值,同时由于圆形有周期的特性,所以南丁格尔玫瑰图也适用于表示一个周期内的时间概念,比如星期、月份。
代码:
group1 = np.random.randint(20, 50, 4)group2 = np.random.randint(10, 60, 4)x = np.array([f'A组-Q{i}' for i in range(1, 5)] + [f'B组-Q{i}' for i in range(1, 5)])y = np.array(group1.tolist() + group2.tolist())# 玫瑰花瓣的角度和宽度theta = np.linspace(0, 2 * np.pi, x.size, endpoint=False)width = 2 * np.pi / x.size# 生成8种随机颜色colors = np.random.rand(8, 3)# 将柱状图投影到极坐标ax = plt.subplot(projection='polar')# 绘制柱状图plt.bar(theta, y, width=width, color=colors, bottom=0)# 设置网格ax.set_thetagrids(theta * 180 / np.pi, x, fontsize=10)# 显示图表plt.show()输出:
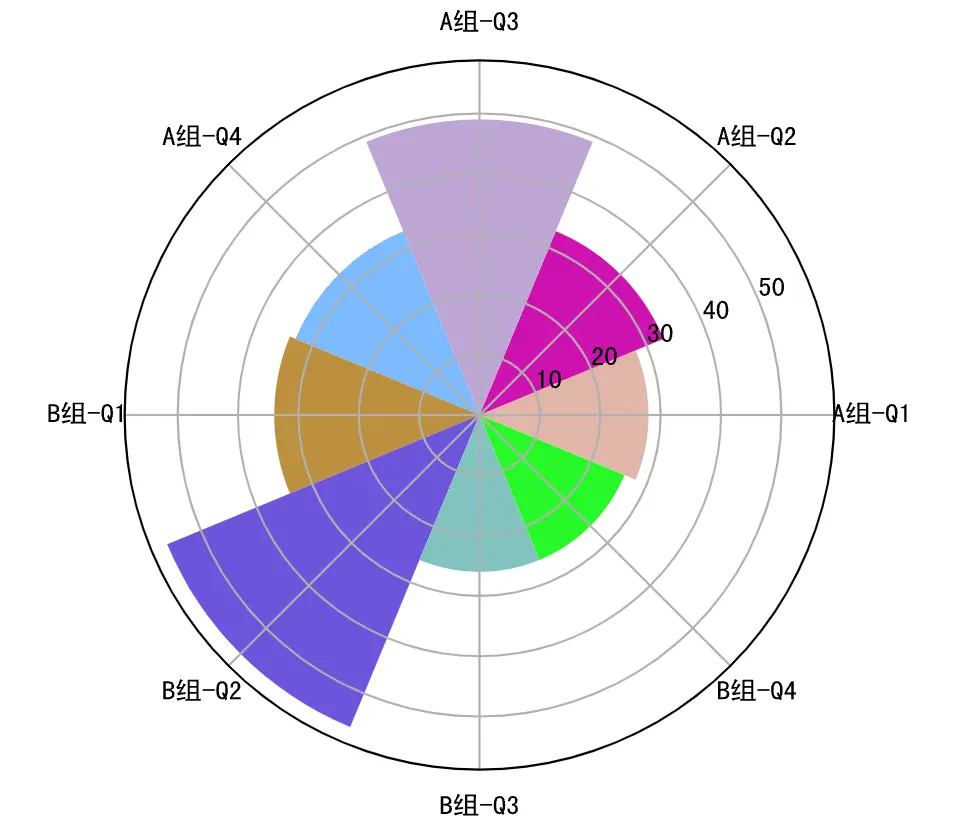
3D图表
matplotlib 还可以用于绘制3D图,具体的内容大家可以参考官方文档,下面我们用一段简单的代码为大家展示如何绘制3D图表。
代码:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(8, 4), dpi=120)# 创建3D坐标系并添加到画布上ax = Axes3D(fig, auto_add_to_figure=False)fig.add_axes(ax)x = np.arange(-2, 2, 0.1)y = np.arange(-2, 2, 0.1)x, y = np.meshgrid(x, y)z = (1 - y ** 5 + x ** 5) * np.exp(-x ** 2 - y ** 2)# 绘制3D曲面ax.plot_surface(x, y, z)# 显示图表plt.show()输出:
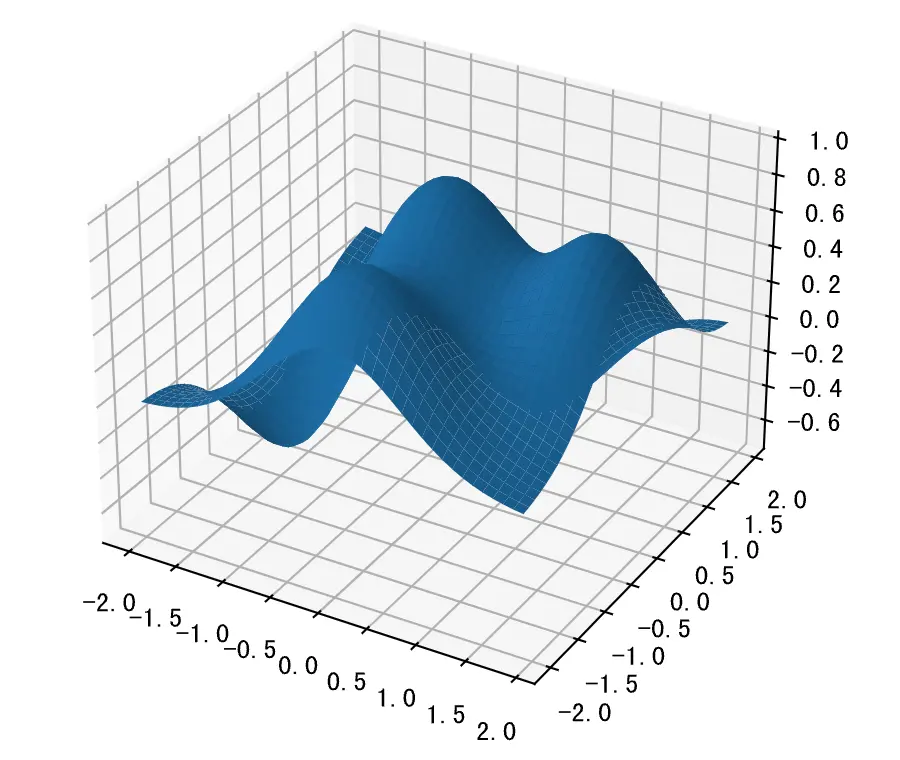
需要指出的是, JupyterLab 中渲染的3D图并不是真正的3D图,因为你没有办法调整观察者的视角,也没有办法旋转或者缩放。如果想要看到真正的3D效果,需要在将图表渲染到 Qt 窗口中,为此我们可以先安装名为 PyQt6 的三方库,如下所示。
%pip install PyQt6然后,我们使用魔法指令让 JupyterLab 将图表渲染到 Qt 窗口中。
%matplotlib qt在完成上面的操作后,我们可以重新运行刚才绘制3D图的代码,看到如下所示的窗口。在这个窗口中,我们可以通过鼠标对3D进行旋转、缩放,我们有可以选中图表的一部分数据进行观测,是不是非常的酷。
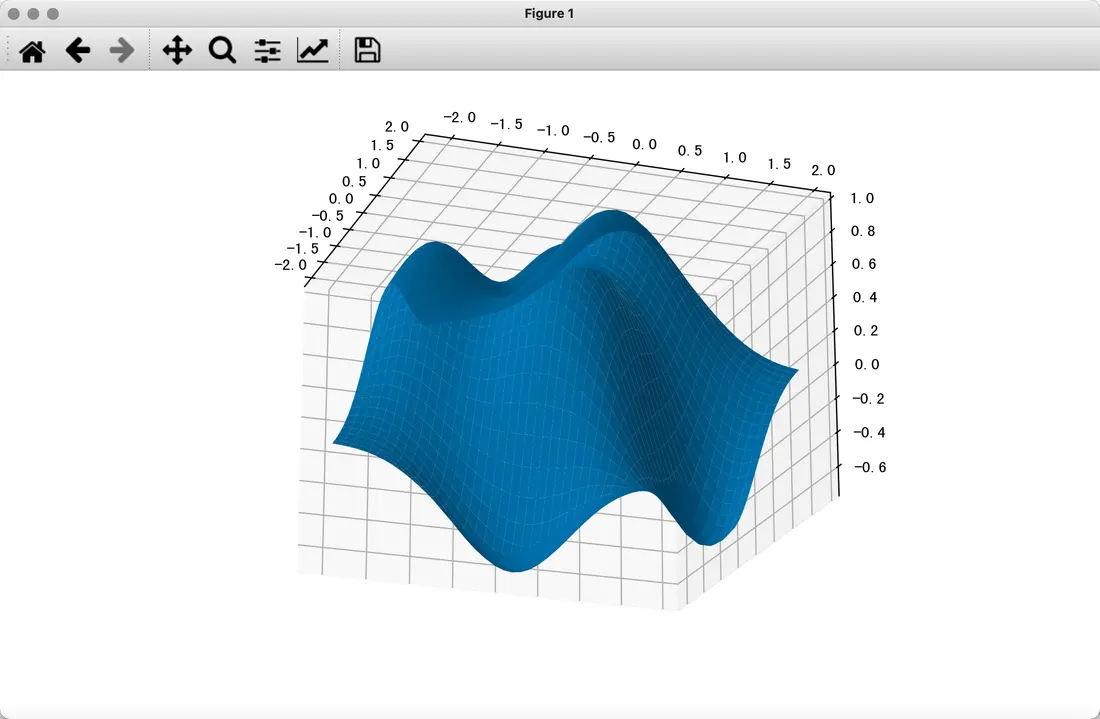
80 数据可视化-3
通过前面的学习,我们已经对数据可视化工具 matplotlib 有一个初步的认知。大家可能也会发现了,matplotlib 提供的函数虽然强大,但是参数太多,要想对图表进行深度的定制就需要修改一系列的参数,这一点对新手并不友好。另一方面,使用 matplotlib 定制的统计图是静态图表,可能在某些需要交互效果的场景下并不合适。为了解决这两个问题,我们为大家介绍两个新的可视化工具,一个是 seaborn,一个是 pyecharts。
Seaborn
Seaborn 是建立在 matplotlib 之上的数据可视化工具,它相当于是对 matplotlib 进行了更高级的封装,而且 seaborn 也能跟 pandas 无缝整合,让我们可以用更少的代码构建出更好的统计图表,帮助我们探索和理解数据。Seaborn 包含但不局限于以下描述的功能:
- 面向数据集的 API,可用于检查多个变量之间的关系。
- 支持使用分类变量来显示观察结果或汇总统计数据。
- 能够可视化单变量或双变量分布以及在数据子集之间进行比较的选项
- 各类因变量线性回归模型的自动估计与作图。
- 集成调色板和主题,轻松定制统计图表的视觉效果。
可以使用 Python 的包管理工具 pip 来安装 seaborn。
pip install seaborn在 Jupyter 中,可以直接使用魔法指令进行安装,如下所示。
%pip install seaborn下面,我们用 seaborn 自带的数据集为例,为大家简单的展示 seaborn 的用法和强大之处,想要深入研究 seaborn 的读者可以自行阅读官方文档和并查看官方作品集中的示例。根据官方示例来编写自己的代码是一个不错的选择,简单的说就是保留官方代码,将数据换成自己的数据即可。下图展示了 seaborn 绘制图表的函数,可以看出,seaborn 的这些函数主要支持我们通过绘制图表来探索数据的关系、分布和分类。
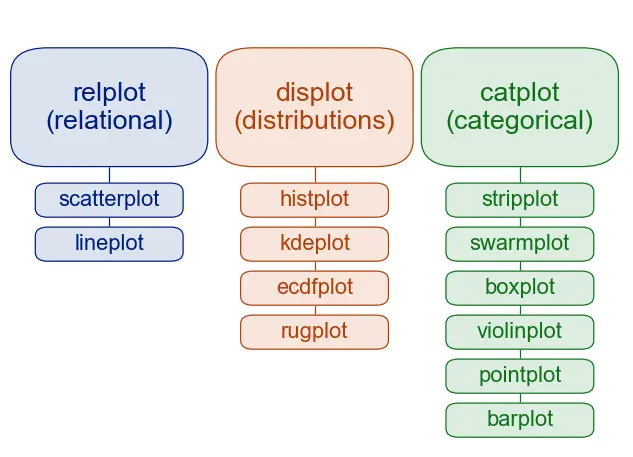
使用 seaborn,首先需要导入该库并设置主题,代码如下所示。
import seaborn as sns
sns.set_theme()如果需要在图表上显示中文,还需要用之前讲过的方法修改 matplotlib 的配置参数,代码如下所示。
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'].insert(0, 'SimHei')plt.rcParams['axes.unicode_minus'] = False注意:上面的代码必须放在调用 set_theme 函数之后,否则调用 set_theme 函数时又会重新修改 matplotlib 配置参数中的字体设置。
加载官方的 Tips 数据集(就餐小费数据)。
tips_df = sns.load_dataset('tips')tips_df.info()运行结果如下所示,其中 total_bill 表示账单总金额,tip 表示小费的金额,sex 是顾客的性别,smoker 表示顾客是否抽样,day 代表星期几,time 代表是午餐还是晚餐,size 是就餐人数。
<class 'pandas.core.frame.DataFrame'>RangeIndex: 244 entries, 0 to 243Data columns (total 7 columns): # Column Non-Null Count Dtype--- ------ -------------- ----- 0 total_bill 244 non-null float64 1 tip 244 non-null float64 2 sex 244 non-null category 3 smoker 244 non-null category 4 day 244 non-null category 5 time 244 non-null category 6 size 244 non-null int64dtypes: category(4), float64(2), int64(1)memory usage: 7.4 KB由于数据集是联网加载的,上述代码可能因为 SSL 的原因无法获取到数据,可以尝试先运行下面的代码,然后再加载数据集。
import ssl
ssl._create_default_https_context = ssl._create_unverified_context如果我们希望了解账单金额的分布,可以使用下面的代码来绘制分布图。
sns.histplot(data=tips_df, x='total_bill', kde=True)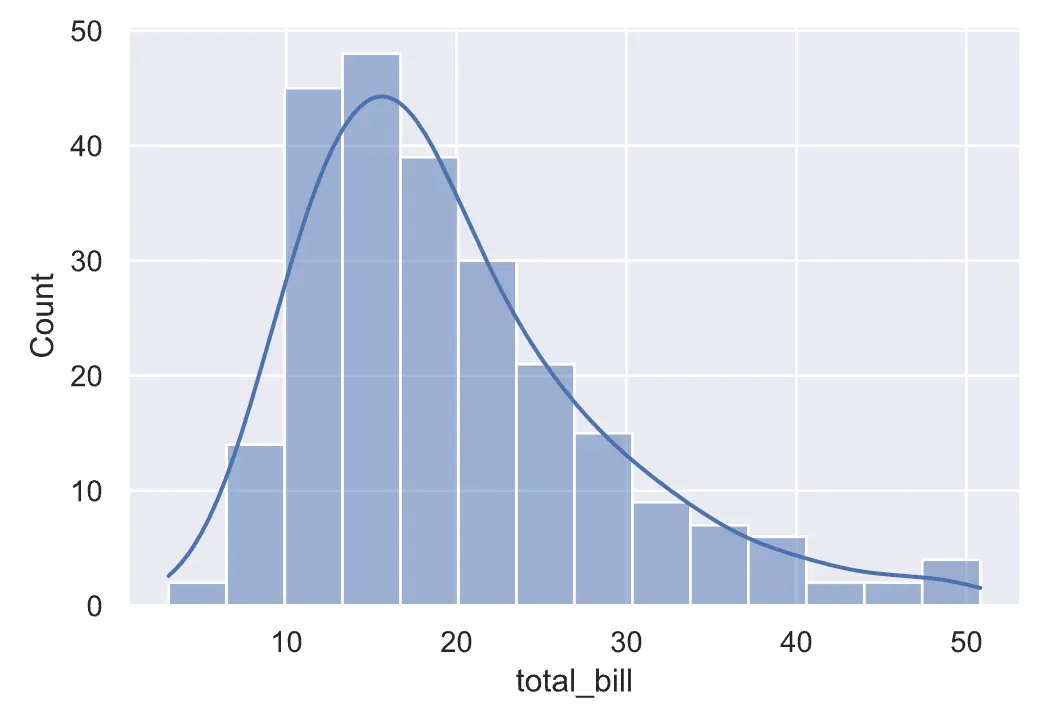
如果想了解变量之间的两两关系,我们可以绘制点对图,代码和效果如下所示。
sns.pairplot(data=tips_df, hue='sex')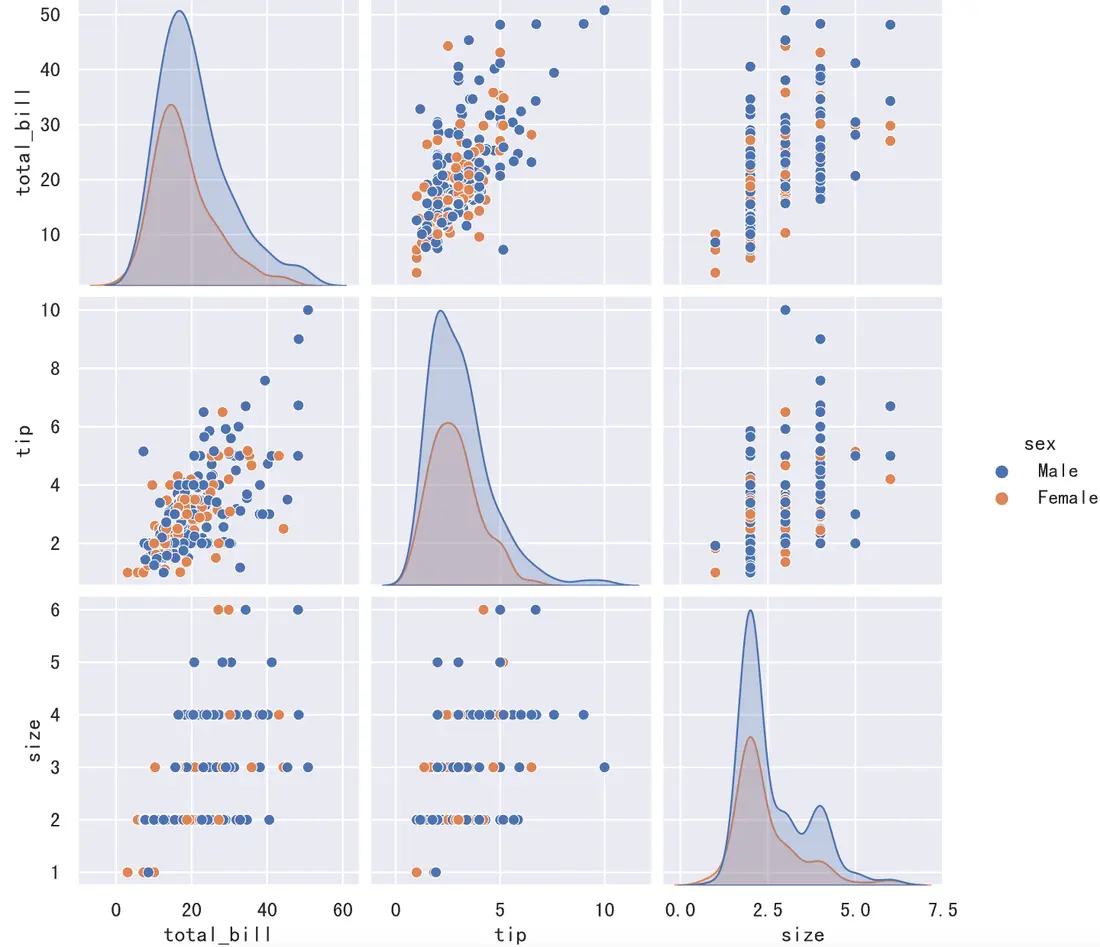
如果对上面图表的颜色不满意,还可以通过 palette 参数选择 seaborn 自带的“调色板”来修改颜色,这种方式相比于自行指定颜色或使用随机颜色方便和靠谱了很多,下图为大家展示了部分 seaborn 自带的“调色板”。
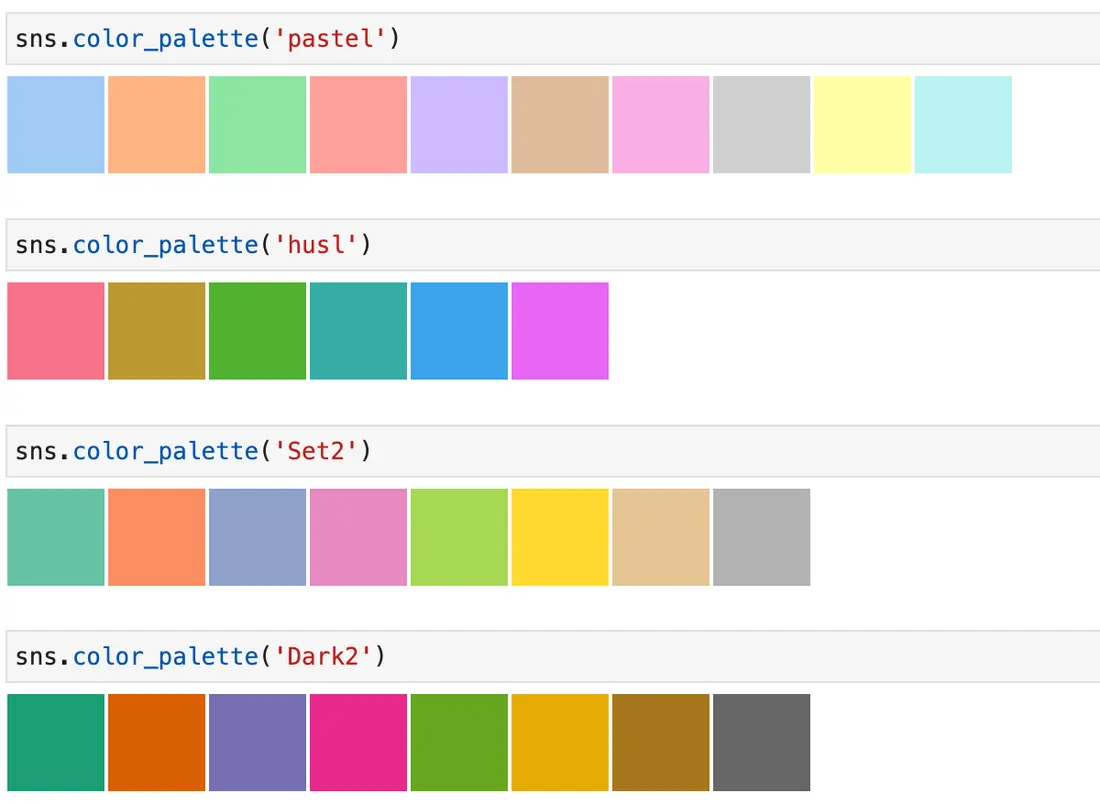
我们可以将上面的代码稍作修改,看看运行结果有什么差别。
sns.pairplot(data=tips_df, hue='sex', palette='Dark2')接下来,我们为 total_bill 和 tip 两组数据绘制联合分布图,代码如下所示。
sns.jointplot(data=tips_df, x='total_bill', y='tip', hue='sex')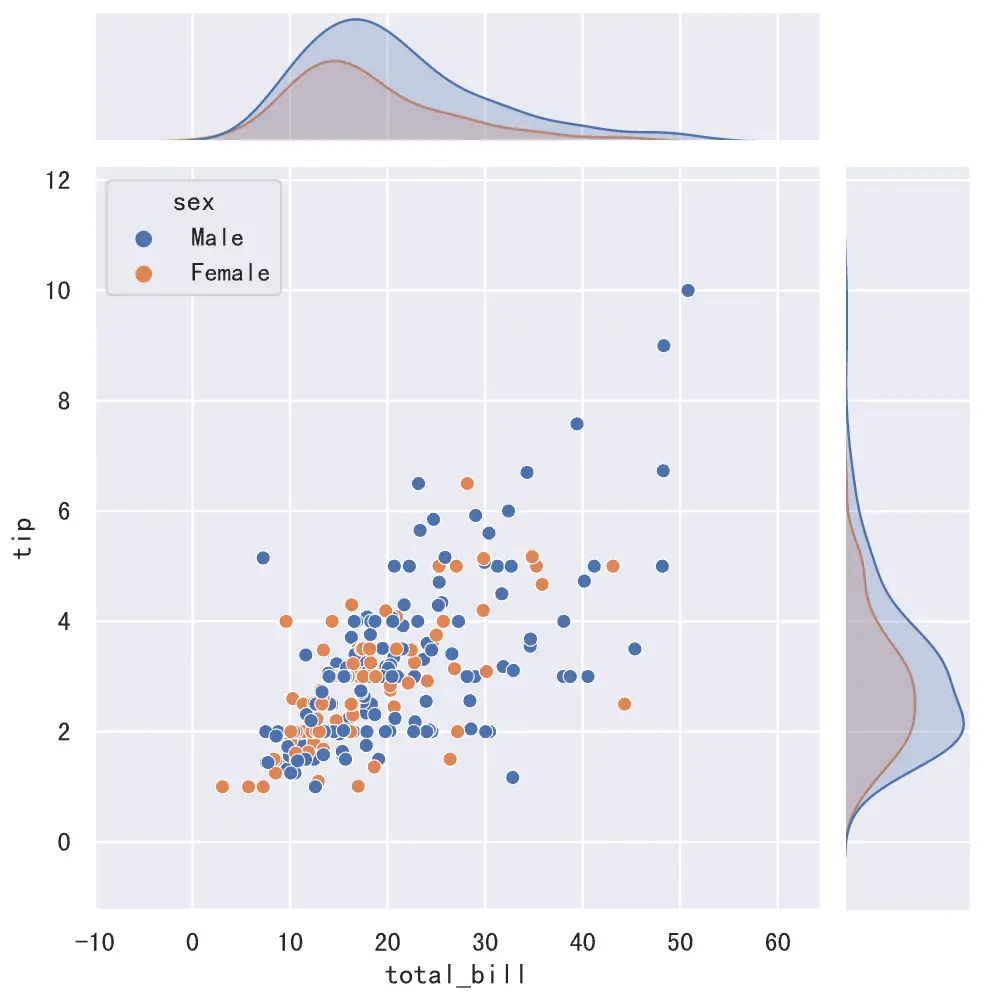
上面清晰的展示了,total_bill 和 tip 之间存在正相关关系,这一点我们也可以通过 DataFrame 对象的 corr 方法进行验证。接下来,我们可以建立回归模型来拟合这些数据点,而 seaborn 的线性回归模型图已经帮我们实现了这项功能,代码如下所示。
sns.lmplot(data=tips_df, x='total_bill', y='tip', hue='sex')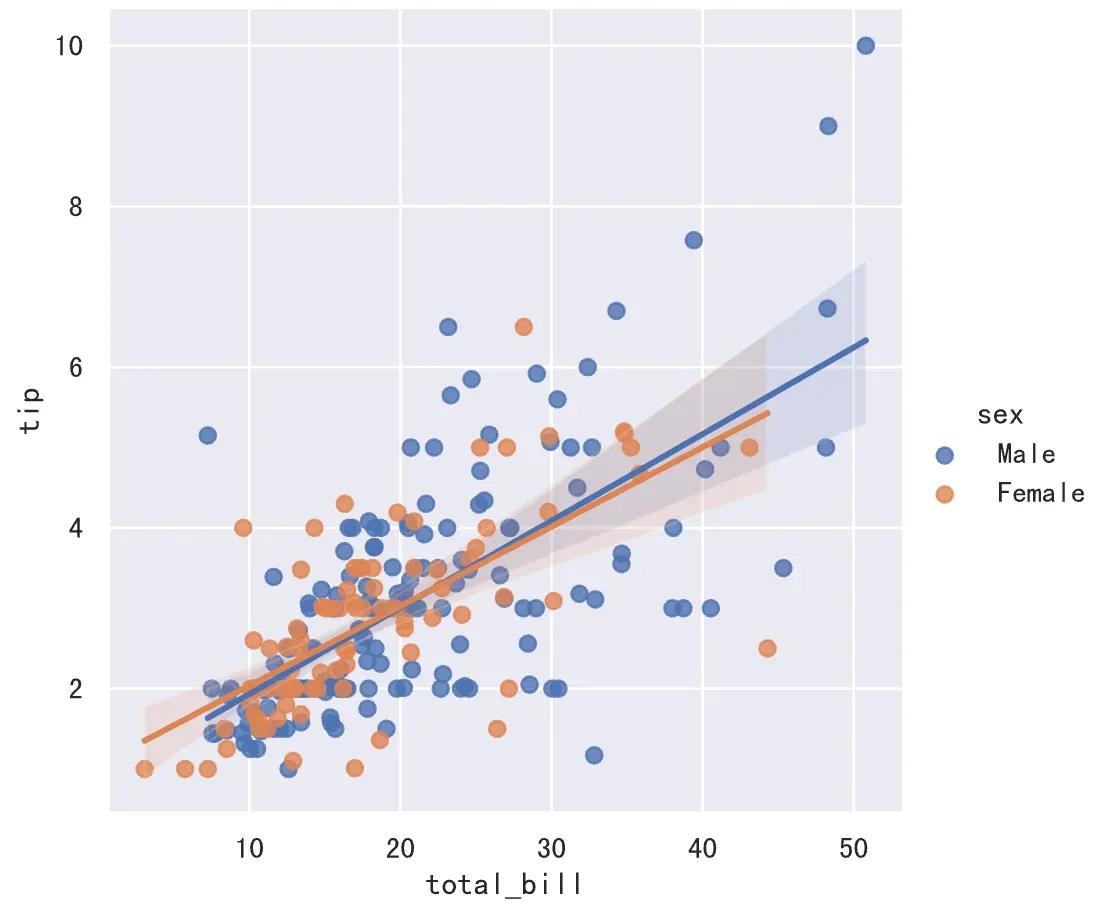
如果我们希望了解账单金额的集中和离散趋势,可以绘制箱线图或小提琴图,代码如下所示,我们将数据按星期四、星期五、星期六和星期天分别进行展示。
sns.boxplot(data=tips_df, x='day', y='total_bill')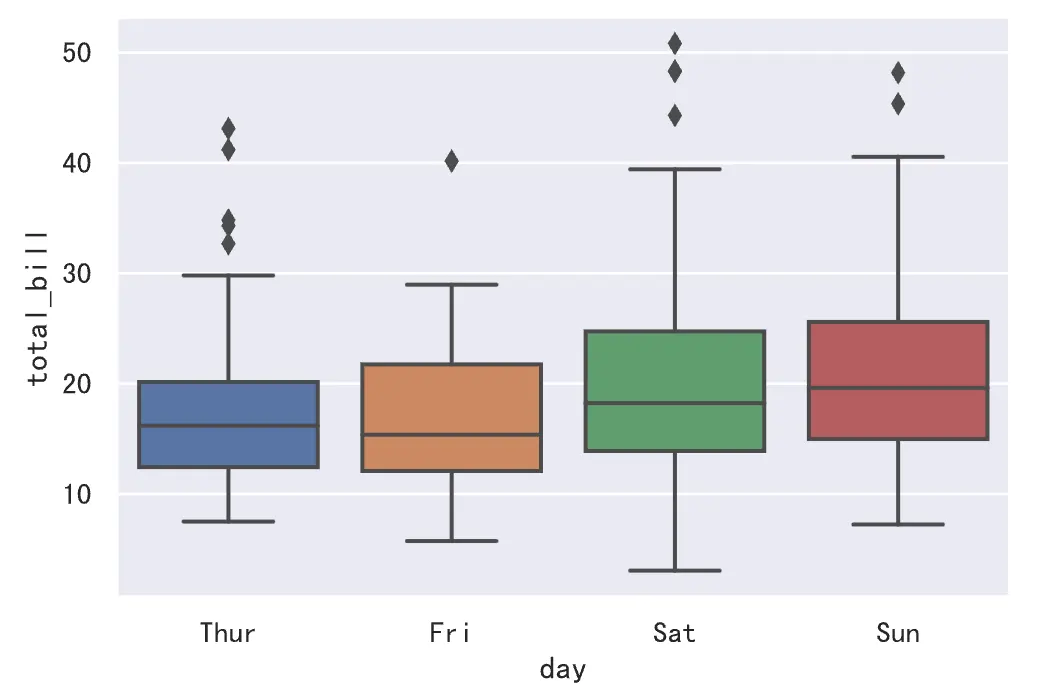
sns.violinplot(data=tips_df, x='day', y='total_bill')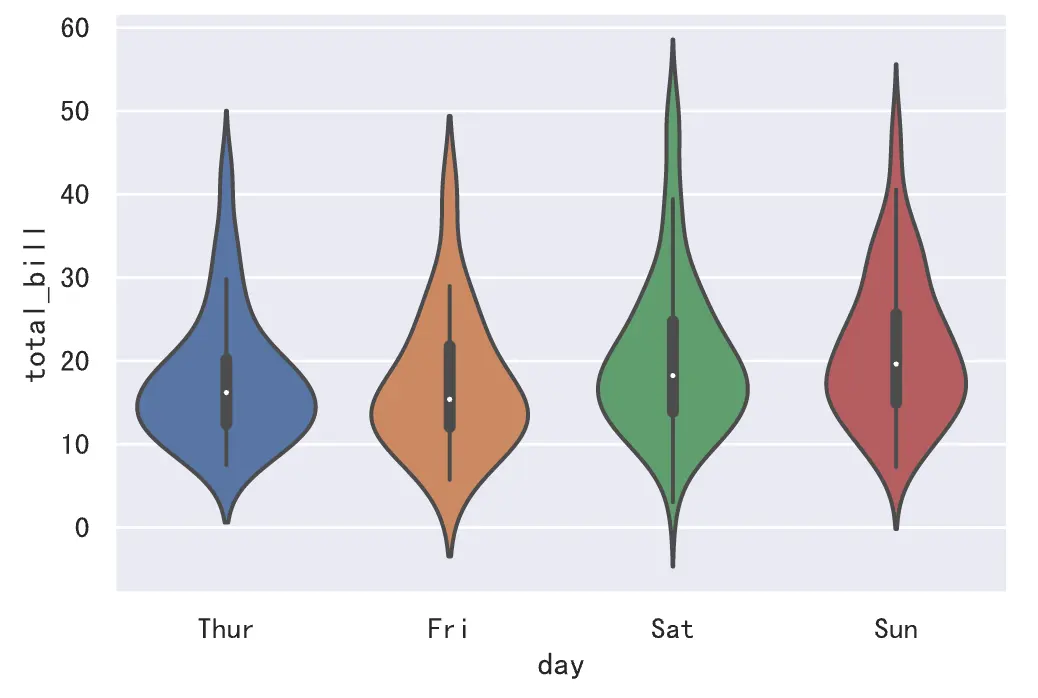
说明:相较于箱线图,小提琴图没有标注异常点而是显示了数据的整个范围,另一方面,小提琴图很好的展示了数据的分布(密度轨迹)。
Pyecharts
Echarts 原来是百度开发的一个前端图表库,2018年1月16日,ECharts 进入 Apache Incubator 进行孵化,目前已经是 Apache 软件基金会的顶级项目。凭借着良好的交互性和精巧的图表设计,ECharts 得到了众多开发者的认可,而 pyecharts 就是基于 Python 语言对 ECharts 进行了包装,让 Python 开发者也可以使用 ECharts 绘制外观精美且交互性强的统计图表。
可以使用 Python 的包管理工具 pip 来安装 pyecharts。
pip install pyecharts在 JupyterLab 中,可以直接使用魔法指令进行安装,如下所示。
%pip install pyecharts如果想在 JupyterLab 中使用 pyecharts 绘图,我们还需要做一些准备工作,主要是修改 pyecharts 的配置,代码如下所示。
from pyecharts.globals import CurrentConfig, NotebookType
CurrentConfig.NOTEBOOK_TYPE = NotebookType.JUPYTER_LAB接下来,我们通过来自于 pyecharts 官方网站新手教程中的一个例子,来认识 pyecharts。当然,我们对官网的例子进行一些调整,代码如下所示。
from pyecharts.charts import Barfrom pyecharts import options as opts
# 创建柱状图对象并设置初始参数(宽度、高度)bar_chart = Bar(init_opts=opts.InitOpts(width='600px', height='450px'))# 设置横轴数据bar_chart.add_xaxis(["衬衫", "羊毛衫", "雪纺衫", "裤子", "高跟鞋", "袜子"])# 设置纵轴数据(第一组)bar_chart.add_yaxis("商家A", [25, 20, 36, 10, 75, 90])# 设置纵轴数据(第二组)bar_chart.add_yaxis("商家B", [15, 12, 30, 20, 45, 60])# 设置纵轴数据(第三组)bar_chart.add_yaxis("商家C", [12, 32, 40, 52, 35, 26])# 添加全局配置参数bar_chart.set_global_opts( # 横轴相关的参数 xaxis_opts=opts.AxisOpts( axislabel_opts=opts.LabelOpts(color='navy') ), # 纵轴相关的参数(标签、最小值、最大值、间隔) yaxis_opts=opts.AxisOpts( axislabel_opts=opts.LabelOpts(color='navy'), min_=0, max_=100, interval=10 ), # 标题相关的参数(内容、链接、位置、文本样式) title_opts=opts.TitleOpts( title='2022年销售数据展示', pos_left='2%', title_textstyle_opts=opts.TextStyleOpts( color='navy', font_size=16, font_family='苹方-简', font_weight='bold' ) ), # 工具箱相关的参数 toolbox_opts=opts.ToolboxOpts( orient='vertical', pos_left='right' ))# 加载绘图需要的JavaScript文件bar_chart.load_javascript()在执行完上面的代码后,我们就可以通过调用bar对象的方法来完成对图表的渲染。如果直接使用render方法,那么绘制好的统计图表将保存到一个 HTML 文件中,打开该文件也能够看到绘制好的统计图表,而render_notebook方法则是将图表渲染到浏览器窗口中。
bar_chart.render_notebook()上面代码的运行效果如下图所示。值得一提的是,下图中的标题、图例、右侧的工具箱都是可以点击的,大家可以点击它们看看会有什么样的效果,ECharts 的魅力就在于它的交互效果,大家一定要试一试。
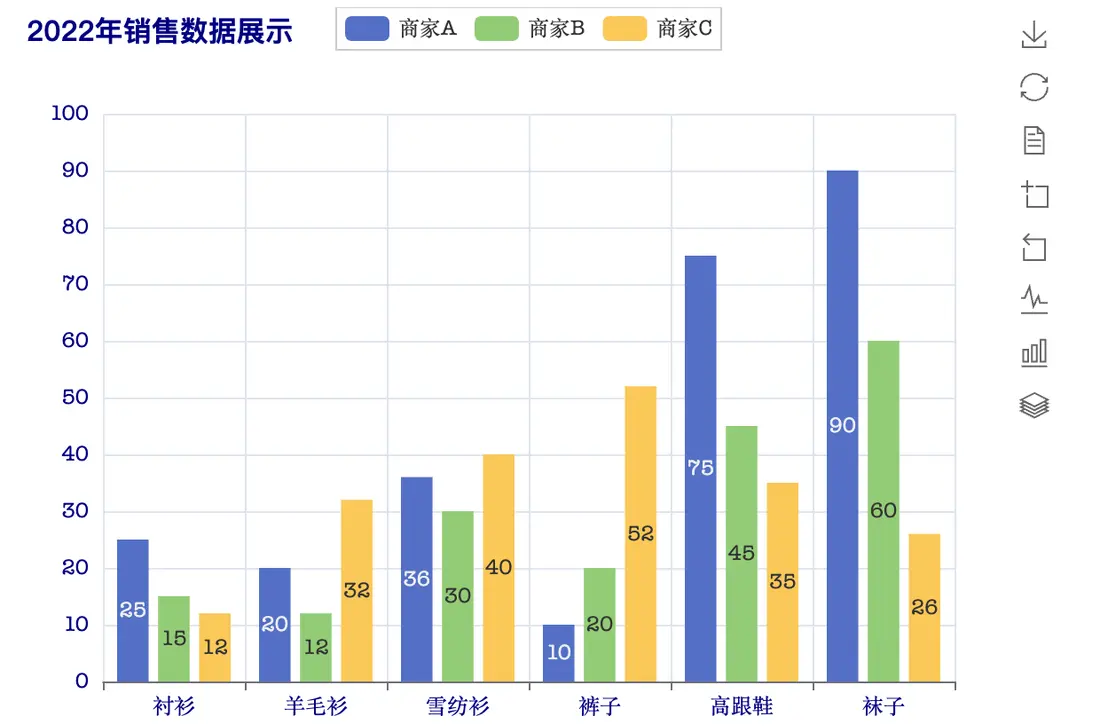
接下来,我们也是通过一个官方示例,看看如何绘制饼图。
import pyecharts.options as optsfrom pyecharts.charts import Pie
# 准备饼图需要的数据x_data = ["直接访问", "邮件营销", "联盟广告", "视频广告", "搜索引擎"]y_data = [335, 310, 234, 135, 1548]data = [(x, y) for x, y in zip(x_data, y_data)]
# 创建饼图对象并设置初始化参数pie_chart = Pie(init_opts=opts.InitOpts(width="800px", height="400px"))# 向饼图添加数据pie_chart.add( '', data_pair=data, radius=["50%", "75%"], label_opts=opts.LabelOpts(is_show=False),)# 设置全局配置项pie_chart.set_global_opts( # 配置图例相关的参数 legend_opts=opts.LegendOpts( pos_left="legft", orient="vertical" ))# 设置数据系列配置参数pie_chart.set_series_opts( # 设置不显示工具提示 tooltip_opts=opts.TooltipOpts(is_show=False), # 设置饼图标签的样式 label_opts=opts.LabelOpts(formatter="{b}({c}): {d}%"))pie_chart.load_javascript()pie_chart.render_notebook()运行上面的代码,效果如下图所示。
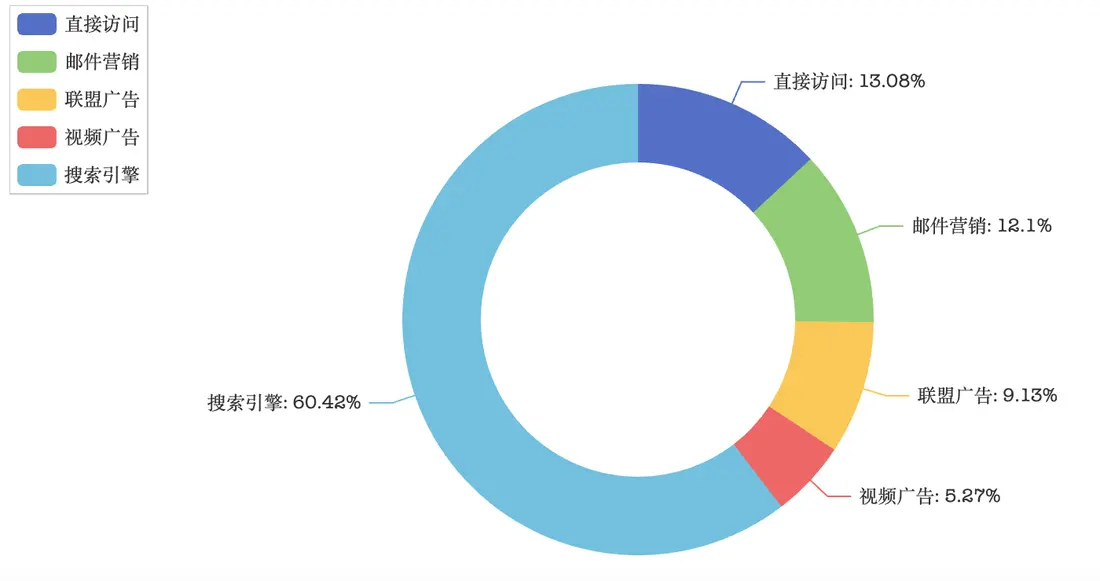
需要提醒大家注意的是,pyecharts 并不能直接使用 NumPy 的 ndarray 和 Pandas 的 Series、DataFrame 为其提供数据,它需要的是 Python 原生的数据类型。可能大家也注意到了,上面的代码中,我们使用的都是列表、元组这样的数据类型。
最后,我们来看看如何绘制地图,绘制地图首先需要安装额外的依赖库来获取地图相关信息,命令如下所示。
pip install echarts-countries-pypkg echarts-china-provinces-pypkg echarts-china-cities-pypkg echarts-china-counties-pypkg在 Jupyter 中,可以直接使用魔法指令进行安装,如下所示。
%pip install echarts-countries-pypkg%pip install echarts-china-provinces-pypkg%pip install echarts-china-cities-pypkg%pip install echarts-china-counties-pypkg说明:上面的四个库分别包含了世界各国、中国省级行政区域、中国市级行政区域、中国区/县级行政区域的数据。
然后,我们将全国各省的数据放在一个列表中,代码如下所示。
data = [ ('广东', 594), ('浙江', 438), ('四川', 316), ('北京', 269), ('山东', 248), ('江苏', 234), ('湖南', 196), ('福建', 166), ('河南', 153), ('辽宁', 152), ('上海', 138), ('河北', 86), ('安徽', 79), ('湖北', 75), ('黑龙江', 70), ('陕西', 63), ('吉林', 59), ('江西', 56), ('重庆', 46), ('贵州', 39), ('山西', 37), ('云南', 33), ('广西', 24), ('天津', 22), ('新疆', 21), ('海南', 18), ('内蒙古', 14), ('台湾', 11), ('甘肃', 7), ('广西壮族自治区', 4), ('香港', 4), ('青海', 3), ('新疆维吾尔自治区', 3), ('内蒙古自治区', 3), ('宁夏', 1)]接下来,我们使用 pyecharts 在地图上标记各省抖音大V人数。
import pyecharts.options as optsfrom pyecharts.charts import Map
map_chart = Map(init_opts=opts.InitOpts(width='1000px', height='1000px'))map_chart.add('', data, 'china', is_roam=False)map_chart.load_javascript()map_chart.render_notebook()代码的运行效果如下图所示,将鼠标置于地图上时,会高亮对应的省并看到相关的信息。
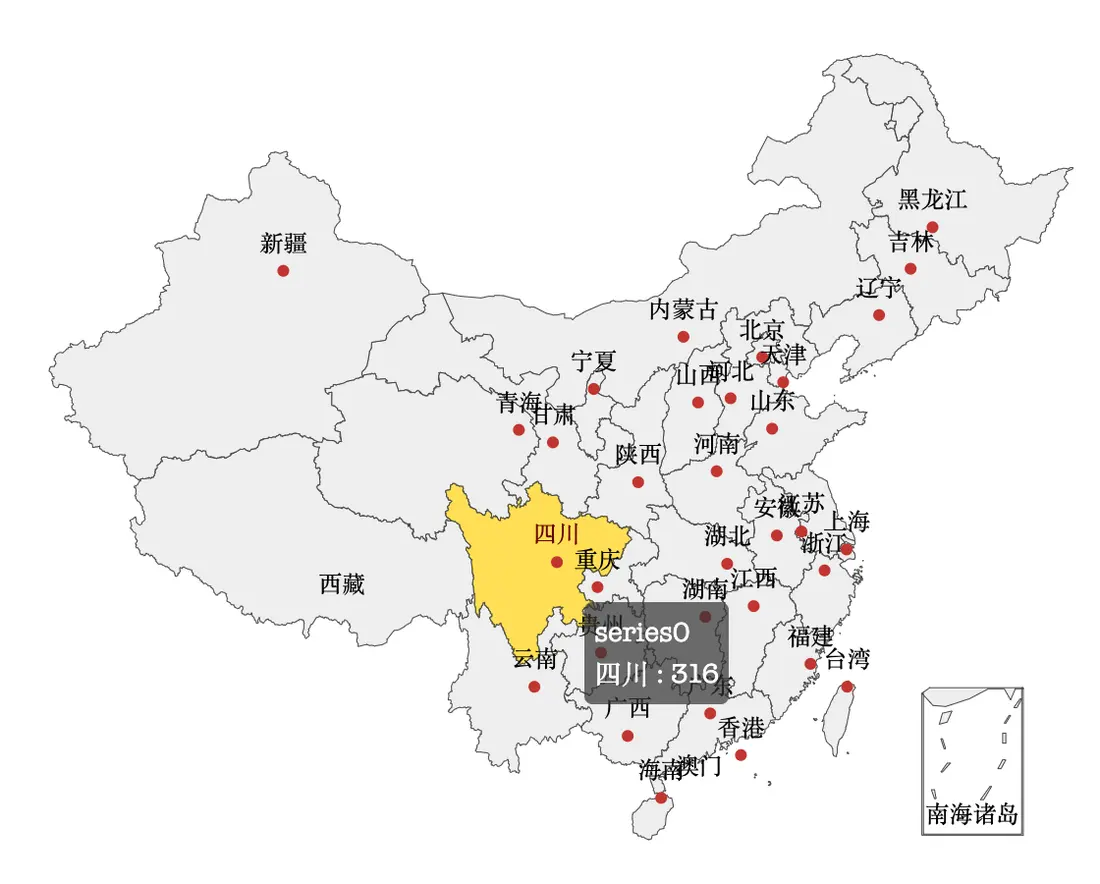
和 seaborn 一样,我们建议大家参考官方提供的示例来使用 pyecharts,我们可以在 pyecharts 官方网站的左侧导航栏中找到“图表类型”选项,下面每种类型的图表都有对应的官方示例,很多代码是可以直接使用的,我们需要做的就是将数据换成自己的数据。
Python100天
已完结分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 301 天
部分内容可能已过时
评论