本篇目录
- 46 Django快速上手
- 47 深入模型
- 48 静态资源和Ajax请求
- 49 Cookie和Session
- 50 制作报表
- 51 日志和调试工具栏
- 52 中间件的应用
- 53 前后端分离开发入门
- 54 RESTful架构和DRF入门
- 55 RESTful架构和DRF进阶
- 56 使用缓存
- 57 接入三方平台
- 58 异步任务和定时任务
- 59 单元测试
- 60 项目上线
目录里每一条都可以点开直达对应章节;右侧(移动端为悬浮按钮)的「文章目录」也会列出同一批标题。
46 Django快速上手
Web开发的早期阶段,开发者需要手动编写每个页面,例如一个新闻门户网站,每天都要修改它的HTML页面,随着网站规模和体量的增大,这种做法一定是非常糟糕的。为了解决这个问题,开发人员想到了用程序来为Web服务器生成动态内容,也就是说网页中的动态内容不再通过手动编写而是通过程序自动生成。最早的时候,这项技术被称为CGI(公共网关接口),当然随着时间的推移,CGI暴露出的问题也越来越多,例如大量重复的样板代码,总体性能较为低下等。在时代呼唤新英雄的背景下,PHP、ASP、JSP这类Web应用开发技术在上世纪90年代中后期如雨后春笋般涌现。通常我们说的Web应用是指通过浏览器来访问网络资源的应用程序,因为浏览器的普及性以及易用性,Web应用使用起来方便简单,免除了安装和更新应用程序带来的麻烦;站在开发者的角度,也不用关心用户使用什么样的操作系统,甚至不用区分是PC端还是移动端。
Web应用机制和术语
下图向我们展示了Web应用的工作流程,其中涉及到的术语如下表所示。
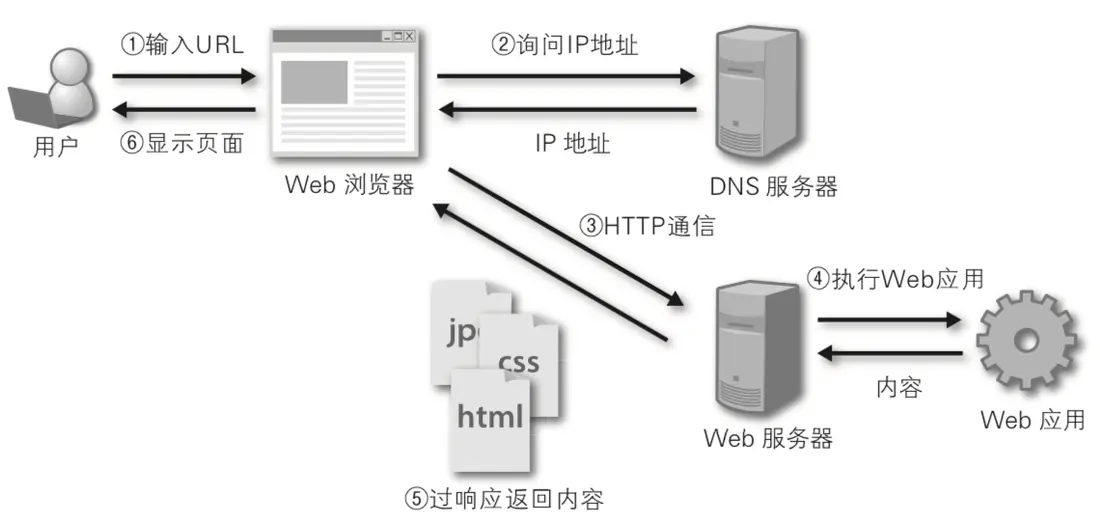
说明:相信有经验的读者会发现,这张图中其实还少了很多东西,例如反向代理服务器、数据库服务器、防火墙等,而且图中的每个节点在实际项目部署时可能是一组节点组成的集群。当然,如果你对这些没有什么概念也不要紧,继续下去就行了,后面会给大家一一讲解的。
| 术语 | 解释 |
|---|---|
| URL/URI | 统一资源定位符/统一资源标识符,网络资源的唯一标识 |
| 域名 | 与Web服务器地址对应的一个易于记忆的字符串名字 |
| DNS | 域名解析服务,可以将域名转换成对应的IP地址 |
| IP地址 | 网络上的主机的身份标识,通过IP地址可以区分不同的主机 |
| HTTP | 超文本传输协议,构建在TCP之上的应用级协议,万维网数据通信的基础 |
| 反向代理 | 代理客户端向服务器发出请求,然后将服务器返回的资源返回给客户端 |
| Web服务器 | 接受HTTP请求,然后返回HTML文件、纯文本文件、图像等资源给请求者 |
| Nginx | 高性能的Web服务器,也可以用作反向代理,负载均衡 和 HTTP缓存 |
HTTP协议
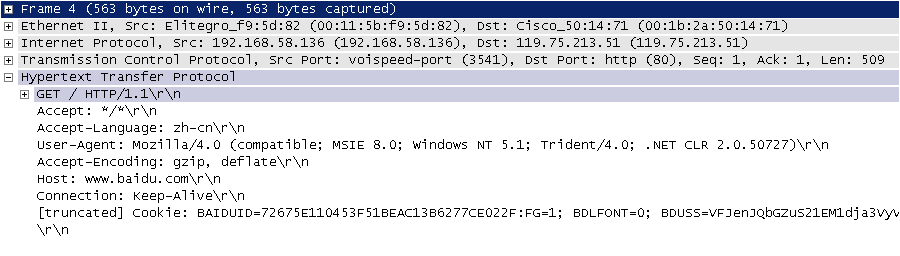
这里我们先费一些笔墨来说说HTTP这个协议。HTTP(超文本传输协议)是构建于TCP(传输控制协议)之上应用级协议,它利用了TCP提供的可靠的传输服务实现了Web应用中的数据交换。按照维基百科上的介绍,设计HTTP最初的目的是为了提供一种发布和接收HTML页面的方法,也就是说这个协议是浏览器和Web服务器之间传输的数据的载体。关于这个协议的详细信息以及目前的发展状况,大家可以阅读《HTTP 协议入门》、《互联网协议入门》系列以及《图解HTTPS协议》这几篇文章进行了解。下图是我在四川省网络通信技术重点实验室学习和工作期间使用开源协议分析工具Ethereal(抓包工具WireShark的前身)截取的访问百度首页时的HTTP请求和响应的报文(协议数据),由于Ethereal截取的是经过网络适配器的数据,因此可以清晰的看到从物理链路层到应用层的协议数据。
HTTP请求(请求行+请求头+空行+[消息体]):
HTTP响应(响应行+响应头+空行+消息体):
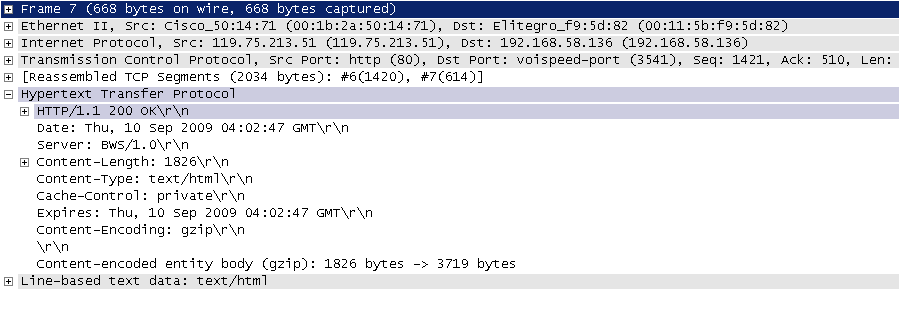
说明:这两张图是在2009年9月10日凌晨获得的,但愿这两张如同泛黄的照片般的截图能帮助你了解HTTP到底是什么样子的。当然,如果没有专业的抓包工具,也可以通过浏览器提供的“开发者工具”来查看HTTP请求和响应的数据格式。
Django概述
Python的Web框架有上百个,比它的关键字还要多。所谓Web框架,就是用于开发Web服务器端应用的基础设施,说得通俗一点就是一系列封装好的模块和工具。事实上,即便没有Web框架,我们仍然可以通过socket或CGI来开发Web服务器端应用,但是这样做的成本和代价在商业项目中通常是不能接受的。通过Web框架,我们可以化繁为简,降低创建、更新、扩展应用程序的工作量。刚才我们说到Python有上百个Web框架,这些框架包括Django、Flask、Tornado、Sanic、Pyramid、Bottle、Web2py、web.py等。
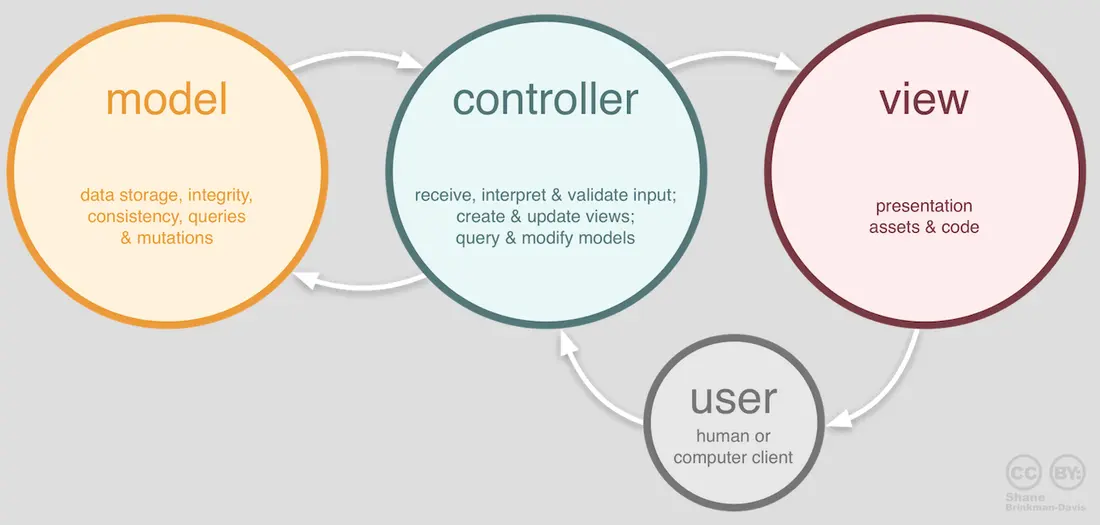
在上述Python的Web框架中,Django无疑是最有代表性的重量级选手,开发者可以基于Django快速的开发可靠的Web应用程序,因为它减少了Web开发中不必要的开销,对常用的设计和开发模式进行了封装,并对MVC架构提供了支持(Django中称之为MTV架构)。MVC是软件系统开发领域中一种放之四海而皆准的架构,它将系统中的组件分为模型(Model)、视图(View)和控制器(Controller)三个部分并借此实现模型(数据)和视图(显示)的解耦合。由于模型和视图进行了分离,所以需要一个中间人将解耦合的模型和视图联系起来,扮演这个角色的就是控制器。稍具规模的软件系统都会使用MVC架构(或者是从MVC演进出的其他架构),Django项目中我们称之为MTV,MTV中的M跟MVC中的M没有区别,就是代表数据的模型,T代表了网页模板(显示数据的视图),而V代表了视图函数,在Django框架中,视图函数和Django框架本身一起扮演了MVC中C的角色。
Django框架诞生于2003年,它是一个在真正的应用中成长起来的项目,由劳伦斯出版集团旗下在线新闻网站的内容管理系统(CMS)研发团队(主要是Adrian Holovaty和Simon Willison)开发,以比利时的吉普赛爵士吉他手Django Reinhardt来命名。Django框架在2005年夏天作为开源框架发布,使用Django框架能用很短的时间构建出功能完备的网站,因为它代替程序员完成了那些重复乏味的劳动,剩下真正有意义的核心业务给程序员来开发,这一点就是对DRY(Don’t Repeat Yourself)理念的最好践行。许多成功的网站和应用都是基于Python语言进行开发的,国内比较有代表性的网站包括:知乎、豆瓣网、果壳网、搜狐闪电邮箱、101围棋网、海报时尚网、背书吧、堆糖、手机搜狐网、咕咚、爱福窝、果库等,其中不乏使用了Django框架的产品。
快速上手
第一个Django项目
-
检查Python环境:Django 1.11需要Python 2.7或Python 3.4以上的版本;Django 2.0需要Python 3.4以上的版本;Django 2.1和2.2需要Python 3.5以上的版本;Django 3.0需要Python 3.6以上版本。
说明:Django框架不同版本所需的Python解释器环境,可以在Django官方文档的FAQ中找到。
可以在macOS的终端中输入下面的命令检查Python解释器版本,Windows系统可以在命令行提示符中输入
python --version。Terminal window
python3 —version
也可以在Python的交互式环境中执行下面的代码来查看Python解释器的版本。
```shellimport syssys.versionsys.version_info-
更新包管理工具并安装Django环境(用于创建Django项目)。
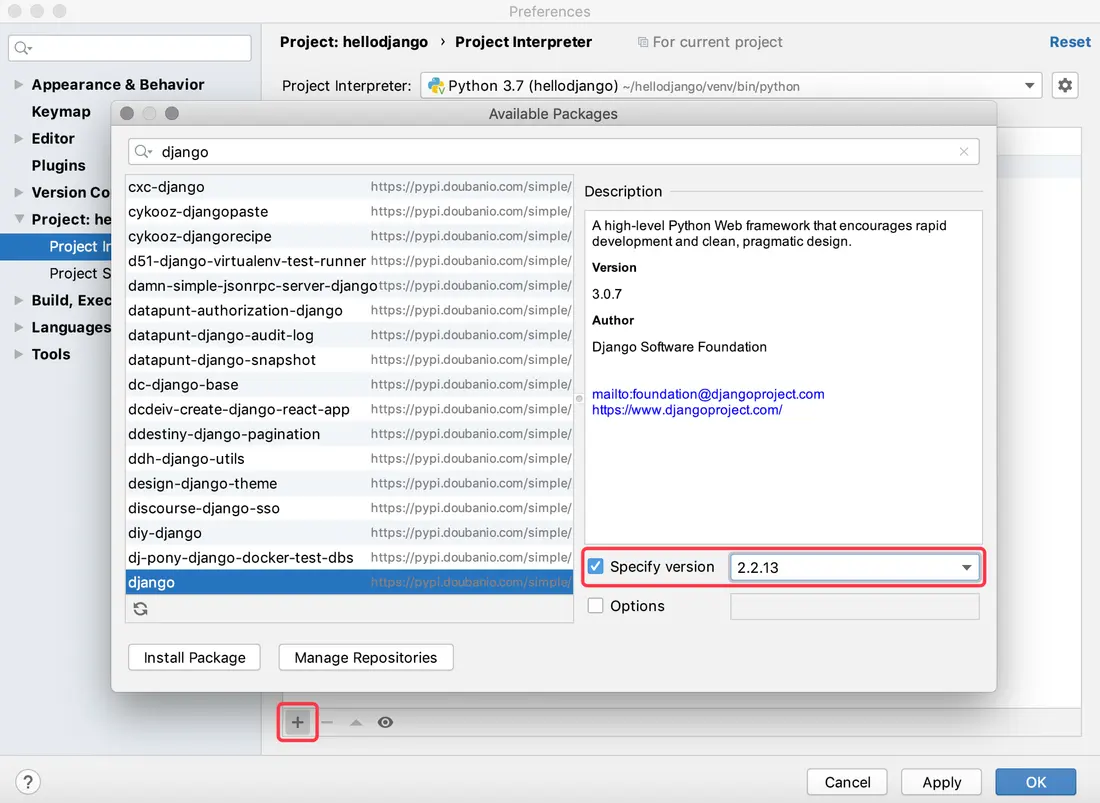
说明:在更新这个文档时,Django最新的正式版本是3.0.7,Django 3.0提供了对ASGI的支持,可以实现全双工的异步通信,但是目前的使用体验一般,所以暂时不推荐大家使用Django 3.0,下面我们安装的是Django 2.2.13版本。使用
pip安装三方库和工具时,可以通过==来指定安装的版本。Terminal window pip3 install -U pippip3 install django==2.2.13 -
检查Django环境并使用
django-admin命令创建Django项目(项目名称为hellodjango)。Terminal window django-admin --versiondjango-admin startproject hellodjango -
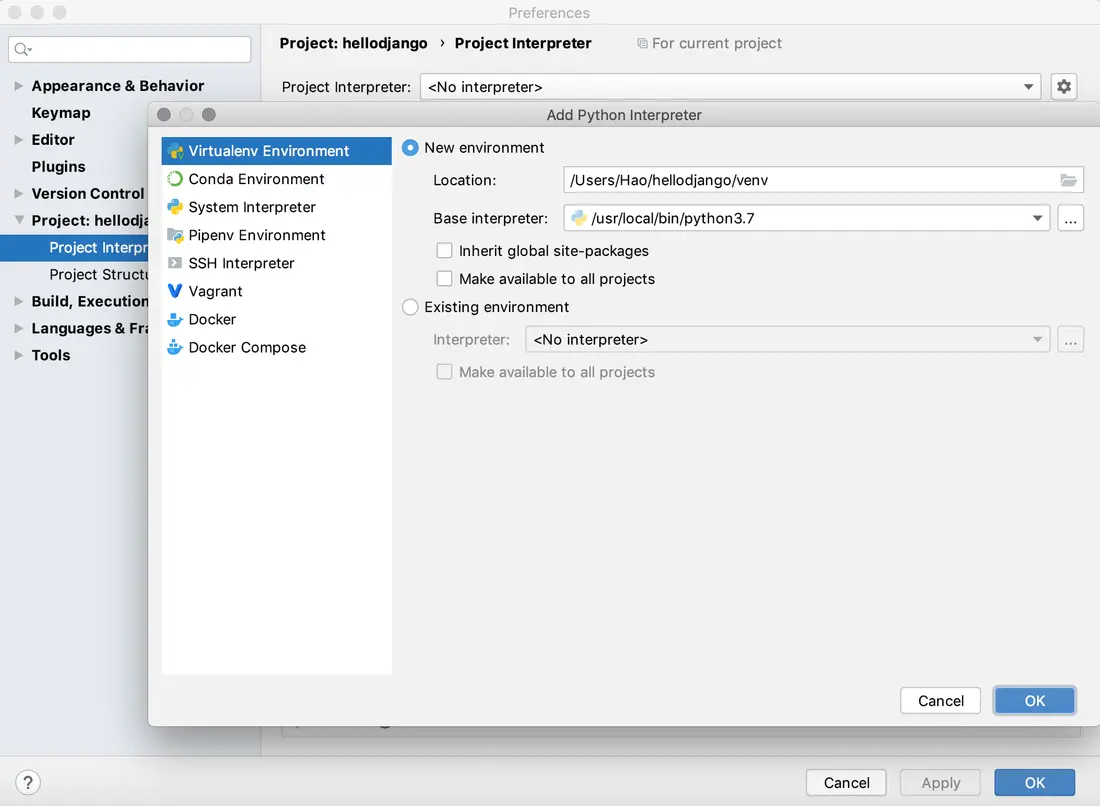
用PyCharm打开创建好的Djang项目,并为其添加虚拟环境。
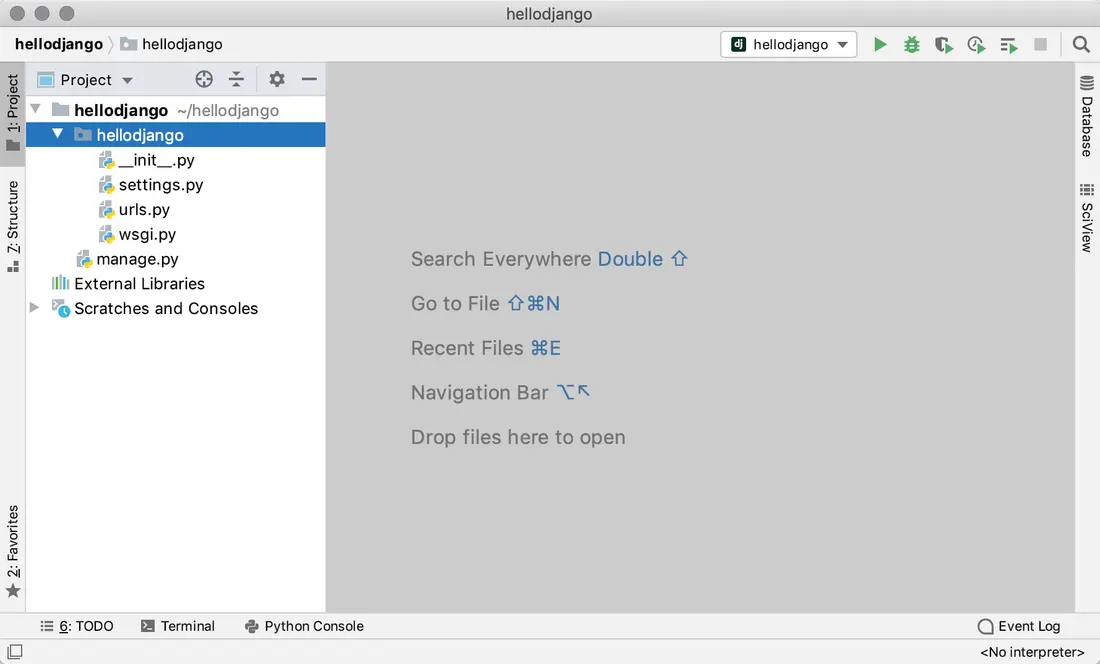
如上图所示,PyCharm的项目浏览器中,最顶层的文件夹
hellodjango是Python项目文件夹,这个文件夹的名字并不重要,Django项目也不关心这个文件夹叫什么名字。该文件夹下有一个同名的文件夹,它是Django项目文件夹,其中包含了__init__.py、settings.py、urls.py、wsgi.py四个文件,与名为hellodjango的Django项目文件夹同级的还有一个名为manage.py的文件,这些文件的作用如下所示:hellodjango/__init__.py:空文件,告诉Python解释器这个目录应该被视为一个Python的包。hellodjango/settings.py:Django项目的配置文件。hellodjango/urls.py:Django项目的URL映射声明,就像是网站的“目录”。hellodjango/wsgi.py:项目运行在WSGI兼容Web服务器上的入口文件。manage.py: 管理Django项目的脚本程序。
说明:WSGI全称是Web服务器网关接口,维基百科上给出的解释是“为Python语言定义的Web服务器和Web应用程序或框架之间的一种简单而通用的接口”。
创建虚拟环境的界面如下图所示。
-
安装项目依赖项。
方法一:打开PyCharm的终端,在终端中通过
pip命令安装Django项目的依赖项。说明:由于已经基于Python 3解释器环境为项目创建了虚拟环境,所以虚拟环境中的
python命令对应的是Python 3的解释器,而pip命令对应的是Python 3的包管理工具。Terminal window pip install django==2.2.13方法二:在PyCharm的偏好设置中,可以找到项目的解释器环境和已经安装的三方库,可以通过点击添加按钮来安装新的依赖项,需要提醒大家的是在安装Django依赖项时,需要指定版本号,否则将默认安装更新本文时最新的3.0.7版本。
下图展示了Django版本和Python版本的对应关系,请大家自行对号入座。
Django版本 Python版本 1.8 2.7、3.2、3.3、3.4、3.5 1.9、1.10 2.7、3.4、3.5 1.11 2.7、3.4、3.5、3.6、3.7(Django 1.11.17) 2.0 3.4、3.5、3.6、3.7 2.1 3.5、3.6、3.7 2.2 3.5、3.6、3.7、3.8(Django 2.2.8) 3.0 3.6、3.7、3.8 -
启动Django自带的服务器运行项目。
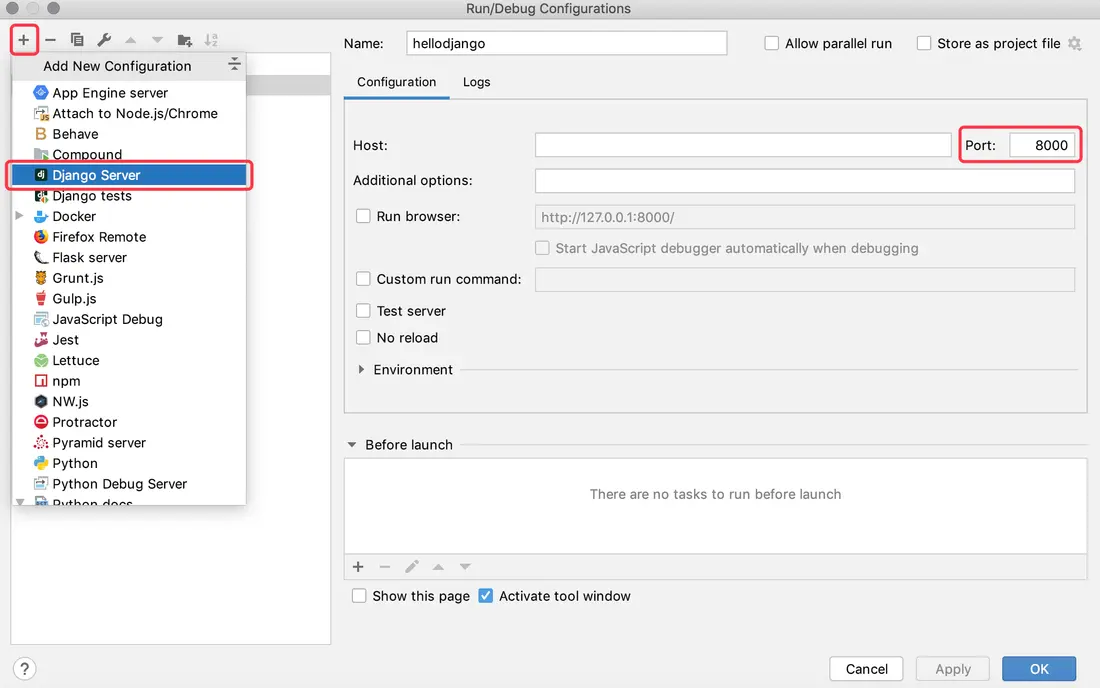
方法一:在“Run”菜单选择“Edit Configuration”,配置“Django server”运行项目(适用于专业版PyCharm)。
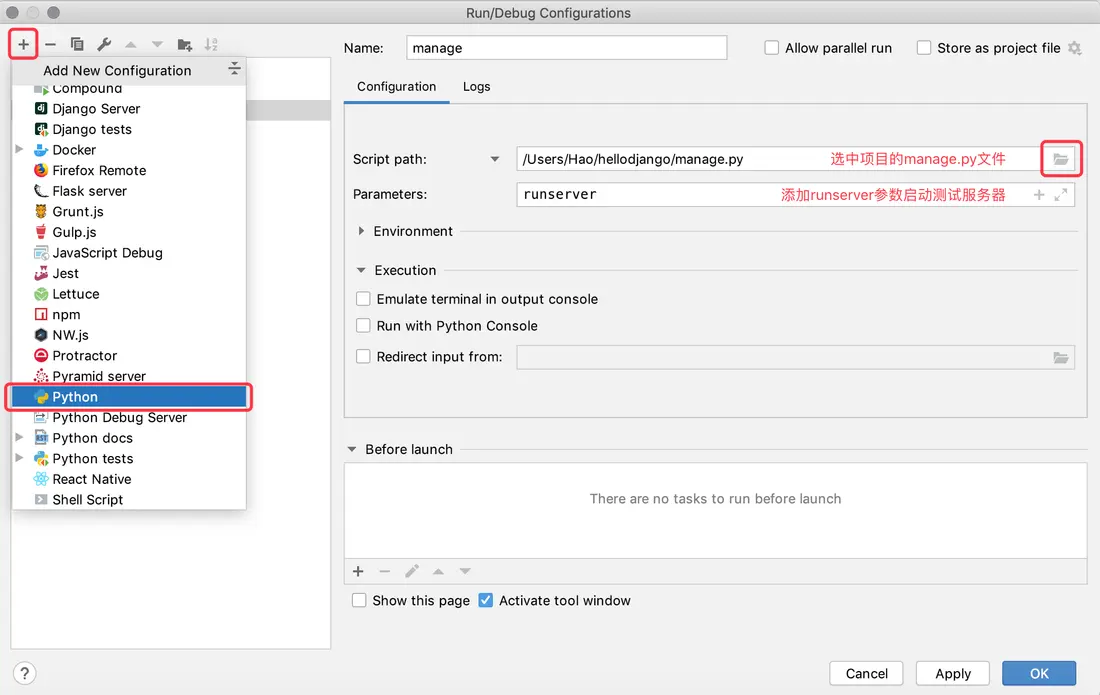
方法二:在“Run”菜单选择“Edit Configuration”,配置运行“Python”程序运行项目(适用于专业版和社区版PyCharm)。
方法三:在PyCharm的终端(Terminal)中通过命令运行项目(适用于专业版和社区版PyCharm)。
Terminal window python manage.py runserver -
查看运行效果。
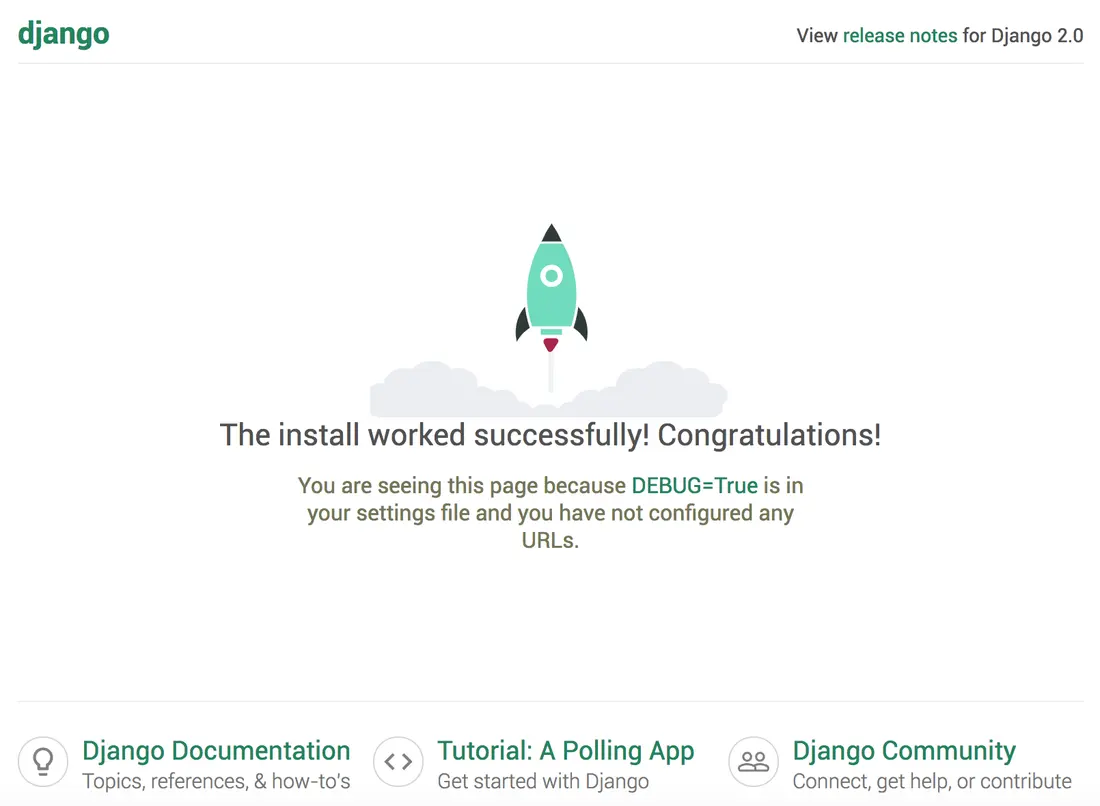
在浏览器中输入http://127.0.0.1:8000访问我们的服务器,效果如下图所示。
说明:
- 刚刚启动的Django自带的服务器只能用于开发和测试环境,因为这个服务器是纯Python编写的轻量级Web服务器,不适合在生产环境中使用。
- 如果修改了代码,不需要为了让修改的代码生效而重新启动Django自带的服务器。但是,在添加新的项目文件时,该服务器不会自动重新加载,这个时候就得手动重启服务器。
- 可以在终端中通过
python manage.py help命令查看Django管理脚本程序可用的命令参数。- 使用
python manage.py runserver启动服务器时,可以在后面添加参数来指定IP地址和端口号,默认情况下启动的服务器将运行在本机的8000端口。- 在终端中运行的服务器,可以通过Ctrl+C来停止它 。通过PyCharm的“运行配置”运行的服务器直接点击窗口上的关闭按钮就可以终止服务器的运行。
- 不能在同一个端口上启动多个服务器,因为会导致地址的冲突(端口是对IP地址的扩展,也是计算机网络地址的一部分)。
-
修改项目的配置文件
settings.py。Django是一个支持国际化和本地化的框架,因此刚才我们看到的Django项目的默认首页也是支持国际化的,我们可以通过修改配置文件将默认语言修改为中文,时区设置为东八区。
找到修改前的配置(在
settings.py文件第100行以后)。LANGUAGE_CODE = 'en-us'TIME_ZONE = 'UTC'修改为以下内容。
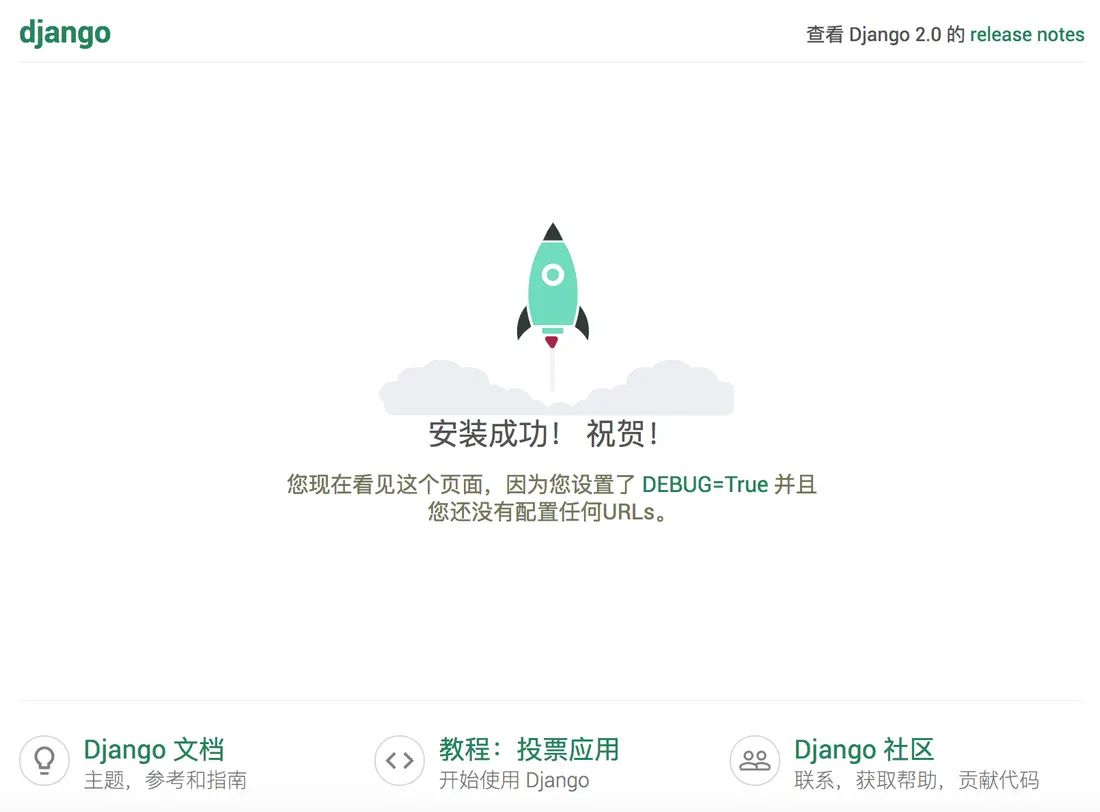
LANGUAGE_CODE = 'zh-hans'TIME_ZONE = 'Asia/Chongqing'刷新刚才的页面,可以看到修改语言代码和时区之后的结果。
创建自己的应用
如果要开发自己的Web应用,需要先在Django项目中创建“应用”,一个Django项目可以包含一个或多个应用。
-
在PyCharm的终端中执行下面的命令,创建名为
first的应用。Terminal window python manage.py startapp first执行上面的命令会在当前路径下创建
first目录,其目录结构如下所示:__init__.py:一个空文件,告诉Python解释器这个目录应该被视为一个Python的包。admin.py:可以用来注册模型,用于在Django框架自带的管理后台中管理模型。apps.py:当前应用的配置文件。migrations:存放与模型有关的数据库迁移信息。__init__.py:一个空文件,告诉Python解释器这个目录应该被视为一个Python的包。
models.py:存放应用的数据模型(MTV中的M)。tests.py:包含测试应用各项功能的测试类和测试函数。views.py:处理用户HTTP请求并返回HTTP响应的函数或类(MTV中的V)。
-
修改应用目录下的视图文件
views.py。from django.http import HttpResponsedef show_index(request):return HttpResponse('<h1>Hello, Django!</h1>') -
修改Django项目目录下的
urls.py文件,将视图函数和用户在浏览器中请求的路径对应。from django.contrib import adminfrom django.urls import path, includefrom first.views import show_indexurlpatterns = [path('admin/', admin.site.urls),path('hello/', show_index),] -
重新运行项目,并打开浏览器中访问
http://127.0.0.1:8000/hello/。 -
上面我们通过代码为浏览器生成了内容,但仍然是静态内容,如果要生成动态内容,可以修改
views.py文件并添加如下所示的代码。from random import samplefrom django.http import HttpResponsedef show_index(request):fruits = ['Apple', 'Orange', 'Pitaya', 'Durian', 'Waxberry', 'Blueberry','Grape', 'Peach', 'Pear', 'Banana', 'Watermelon', 'Mango']selected_fruits = sample(fruits, 3)content = '<h3>今天推荐的水果是:</h3>'content += '<hr>'content += '<ul>'for fruit in selected_fruits:content += f'<li>{fruit}</li>'content += '</ul>'return HttpResponse(content) -
刷新页面查看程序的运行结果,看看每次刷新的网页的时候,是不是可以看到不一样的内容。
使用模板
上面通过拼接HTML代码的方式为浏览器生成动态内容的做法在实际开发中是无能接受的,因为实际项目中的前端页面可能非常复杂,无法用这种拼接动态内容的方式来完成,这一点大家一定能够想到。为了解决这个问题,我们可以提前准备一个模板页(MTV中的T),所谓模板页就是一个带占位符和模板指令的HTML页面。
Django框架中有一个名为render的便捷函数可以来完成渲染模板的操作。所谓的渲染就是用数据替换掉模板页中的模板指令和占位符,当然这里的渲染称为后端渲染,即在服务器端完成页面的渲染再输出到浏览器中。后端渲染的做法在Web应用的访问量较大时,会让服务器承受较大的负担,所以越来越多的Web应用会选择前端渲染的方式,即服务器只提供页面所需的数据(通常是JSON格式),在浏览器中通过JavaScript代码获取这些数据并渲染页面上。关于前端渲染的内容,我们会在后续的课程中为大家讲解,目前我们使用的是通过模板页进行后端渲染的做法,具体步骤如下所示。
使用模板页的步骤如下所示。
-
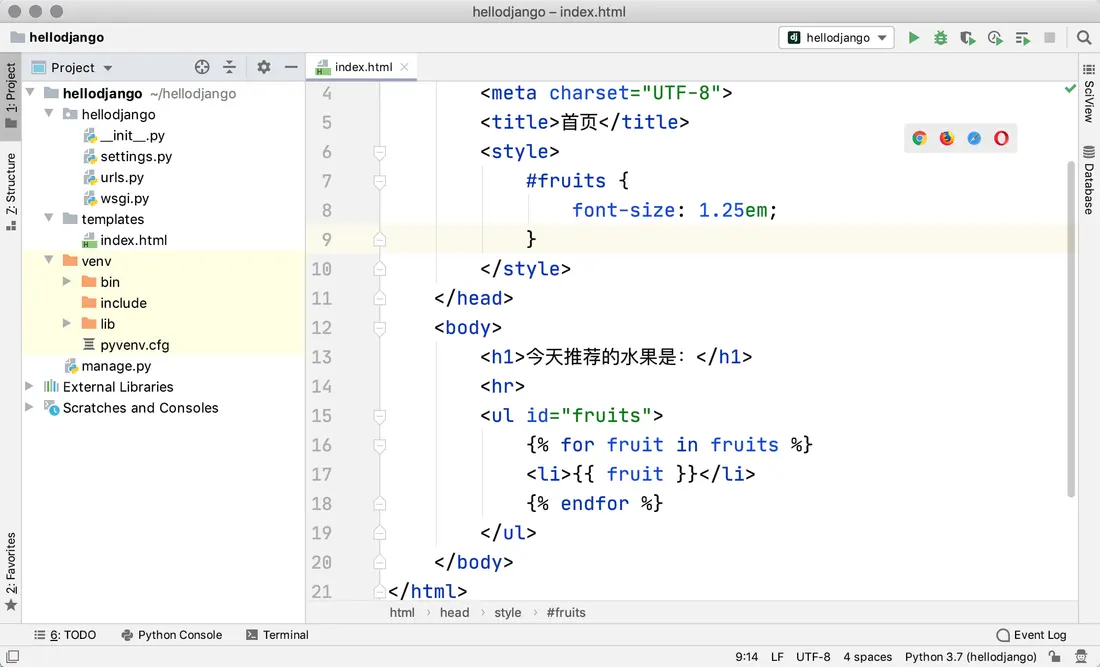
在项目目录下创建名为templates文件夹。
-
添加模板页
index.html。说明:实际项目开发中,静态页由前端开发者提供,后端开发者需要将静态页修改为模板页,以便通过Python程序对其进行渲染,这种做法就是上面提到的后端渲染。
<!DOCTYPE html><html lang="en"><head><meta charset="UTF-8"><title>首页</title><style>#fruits {font-size: 1.25em;}</style></head><body><h1>今天推荐的水果是:</h1><hr><ul id="fruits">{% for fruit in fruits %}<li>{{ fruit }}</li>{% endfor %}</ul></body></html>在上面的模板页中我们使用了
{{ fruit }}这样的模板占位符语法,也使用了{% for %}这样的模板指令,这些都是Django模板语言(DTL)的一部分。关于模板语法和指令,大家可以看看官方文档,相信这些内容还是很容易理解的,并不需要过多的赘述,大家也可以参考官方文档了解模板指令和语法。 -
修改
views.py文件,调用render函数渲染模板页。from random import samplefrom django.shortcuts import renderdef show_index(request):fruits = ['Apple', 'Orange', 'Pitaya', 'Durian', 'Waxberry', 'Blueberry','Grape', 'Peach', 'Pear', 'Banana', 'Watermelon', 'Mango']selected_fruits = sample(fruits, 3)return render(request, 'index.html', {'fruits': selected_fruits})render函数的第一个参数是请求对象request,第二个参数是我们要渲染的模板页的名字,第三个参数是要渲染到页面上的数据,我们通过一个字典将数据交给模板页,字典中的键就是模板页中使用的模板指令或占位符中的变量名。 -
到此为止,视图函数中的
render还无法找到模板文件index.html,需要修改settings.py文件,配置模板文件所在的路径。修改settings.py文件,找到TEMPLATES配置,修改其中的DIRS配置。TEMPLATES = [{'BACKEND': 'django.template.backends.django.DjangoTemplates','DIRS': [os.path.join(BASE_DIR, 'templates'), ],'APP_DIRS': True,'OPTIONS': {'context_processors': ['django.template.context_processors.debug','django.template.context_processors.request','django.contrib.auth.context_processors.auth','django.contrib.messages.context_processors.messages',],},},] -
重新运行项目或直接刷新页面查看结果。
总结
至此,我们已经利用Django框架完成了一个非常小的Web应用,虽然它并没有任何的实际价值,但是可以通过这个项目对Django框架有一个感性的认识。学习Django最好的资料肯定是它的官方文档,官方文档提供了对多国语言的支持,而且有新手教程引导初学者学习使用Django框架,建议大家通过阅读Django的官方文档来学习和使用这个框架。当然图灵社区出版的《Django基础教程》也是非常适合初学者的入门级读物,有兴趣的读者可以点击链接进行购买。
47 深入模型
在上一个章节中,我们提到了Django是基于MVC架构的Web框架,MVC架构追求的是“模型”和“视图”的解耦合。所谓“模型”说得更直白一些就是数据(的表示),所以通常也被称作“数据模型”。在实际的项目中,数据模型通常通过数据库实现持久化操作,而关系型数据库在过去和当下都是持久化的首选方案,下面我们通过完成一个投票项目来讲解和模型相关的知识点。投票项目的首页会展示某在线教育平台所有的学科;点击学科可以查看到该学科的老师及其信息;用户登录后在查看老师的页面为老师投票,可以投赞成票和反对票;未登录的用户可以通过登录页进行登录;尚未注册的用户可以通过注册页输入个人信息进行注册。在这个项目中,我们使用MySQL数据库来实现数据持久化操作。
创建项目和应用
我们首先创建Django项目vote并为其添加虚拟环境和依赖项。接下来,在项目下创建名为polls的应用和保存模板页的文件夹tempaltes,项目文件夹的结构如下所示。
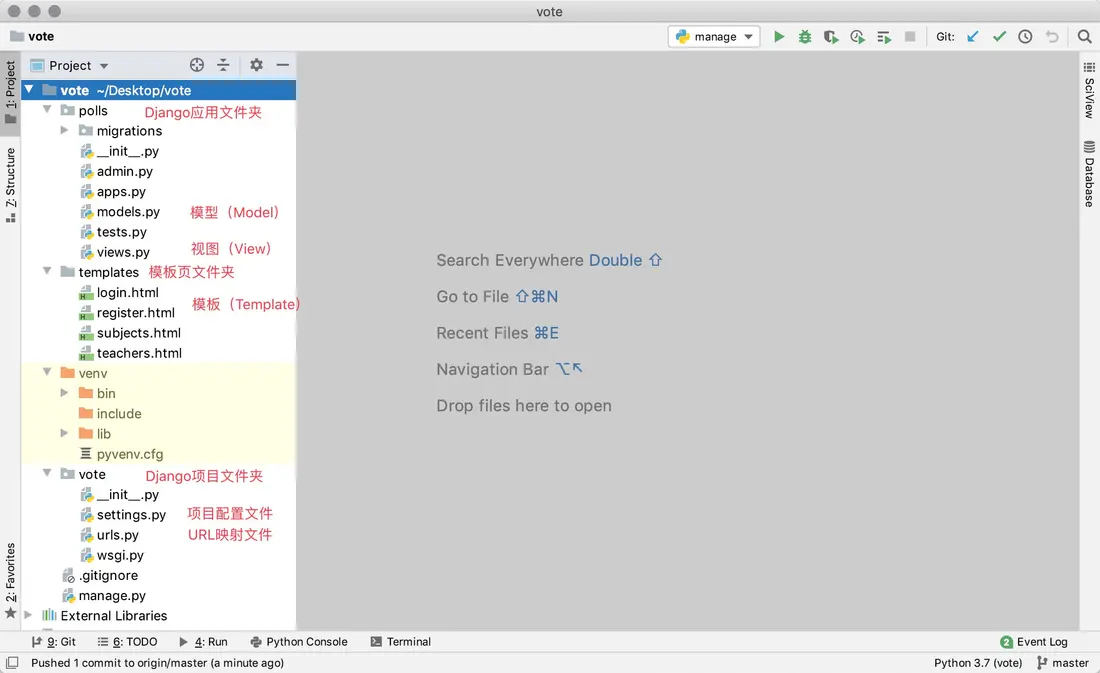
根据上面描述的项目需求,我们准备了四个静态页面,分别是展示学科的页面subjects.html,显示学科老师的页面teachers.html,登录页面login.html,注册页面register.html,稍后我们会将静态页修改为Django项目所需的模板页。
配置关系型数据库MySQL
-
在MySQL中创建数据库,创建用户,授权用户访问该数据库。
create database vote default charset utf8;create user 'hellokitty'@'%' identified by 'Hellokitty.618';grant all privileges on vote.* to 'hellokitty'@'%';flush privileges; -
在MySQL中创建保存学科和老师信息的二维表(保存用户信息的表稍后处理)。
use vote;-- 创建学科表create table `tb_subject`(`no` integer auto_increment comment '学科编号',`name` varchar(50) not null comment '学科名称',`intro` varchar(1000) not null default '' comment '学科介绍',`is_hot` boolean not null default 0 comment '是不是热门学科',primary key (`no`));-- 创建老师表create table `tb_teacher`(`no` integer auto_increment comment '老师编号',`name` varchar(20) not null comment '老师姓名',`sex` boolean not null default 1 comment '老师性别',`birth` date not null comment '出生日期',`intro` varchar(1000) not null default '' comment '老师介绍',`photo` varchar(255) not null default '' comment '老师照片',`gcount` integer not null default 0 comment '好评数',`bcount` integer not null default 0 comment '差评数',`sno` integer not null comment '所属学科',primary key (`no`),foreign key (`sno`) references `tb_subject` (`no`)); -
在虚拟环境中安装连接MySQL数据库所需的依赖项。
Terminal window pip install mysqlclient说明:如果因为某些原因无法安装
mysqlclient三方库,可以使用它的替代品pymysql,pymysql是用纯Python开发的连接MySQL的Python库,安装更容易成功,但是需要在Django项目文件夹的__init__.py中添加如下所示的代码。import pymysqlpymysql.install_as_MySQLdb()如果使用Django 2.2及以上版本,还会遇到PyMySQL跟Django框架的兼容性问题,兼容性问题会导致项目无法运行,需要按照GitHub上PyMySQL仓库Issues中提供的方法进行处理。总体来说,使用
pymysql会比较麻烦,强烈建议大家首选安装mysqlclient。 -
修改项目的settings.py文件,首先将我们创建的应用
polls添加已安装的项目(INSTALLED_APPS)中,然后配置MySQL作为持久化方案。INSTALLED_APPS = ['django.contrib.admin','django.contrib.auth','django.contrib.contenttypes','django.contrib.sessions','django.contrib.messages','django.contrib.staticfiles','polls',]DATABASES = {'default': {# 数据库引擎配置'ENGINE': 'django.db.backends.mysql',# 数据库的名字'NAME': 'vote',# 数据库服务器的IP地址(本机可以写localhost或127.0.0.1)'HOST': 'localhost',# 启动MySQL服务的端口号'PORT': 3306,# 数据库用户名和口令'USER': 'hellokitty','PASSWORD': 'Hellokitty.618',# 数据库使用的字符集'CHARSET': 'utf8',# 数据库时间日期的时区设定'TIME_ZONE': 'Asia/Chongqing',}}在配置ENGINE属性时,常用的可选值包括:
'django.db.backends.sqlite3':SQLite嵌入式数据库。'django.db.backends.postgresql':BSD许可证下发行的开源关系型数据库产品。'django.db.backends.mysql':甲骨文公司经济高效的数据库产品。'django.db.backends.oracle':甲骨文公司关系型数据库旗舰产品。
其他的配置可以参考官方文档中数据库配置的部分。
-
Django框架提供了ORM来解决数据持久化问题,ORM翻译成中文叫“对象关系映射”。因为Python是面向对象的编程语言,我们在Python程序中使用对象模型来保存数据,而关系型数据库使用关系模型,用二维表来保存数据,这两种模型并不匹配。使用ORM是为了实现对象模型到关系模型的双向转换,这样就不用在Python代码中书写SQL语句和游标操作,因为这些都会由ORM自动完成。利用Django的ORM,我们可以直接将刚才创建的学科表和老师表变成Django中的模型类。
Terminal window python manage.py inspectdb > polls/models.py我们可以对自动生成的模型类稍作调整,代码如下所示。
from django.db import modelsclass Subject(models.Model):no = models.AutoField(primary_key=True, verbose_name='编号')name = models.CharField(max_length=50, verbose_name='名称')intro = models.CharField(max_length=1000, verbose_name='介绍')is_hot = models.BooleanField(verbose_name='是否热门')class Meta:managed = Falsedb_table = 'tb_subject'class Teacher(models.Model):no = models.AutoField(primary_key=True, verbose_name='编号')name = models.CharField(max_length=20, verbose_name='姓名')sex = models.BooleanField(default=True, verbose_name='性别')birth = models.DateField(verbose_name='出生日期')intro = models.CharField(max_length=1000, verbose_name='个人介绍')photo = models.ImageField(max_length=255, verbose_name='照片')good_count = models.IntegerField(default=0, db_column='gcount', verbose_name='好评数')bad_count = models.IntegerField(default=0, db_column='bcount', verbose_name='差评数')subject = models.ForeignKey(Subject, models.DO_NOTHING, db_column='sno')class Meta:managed = Falsedb_table = 'tb_teacher'说明:模型类都直接或间接继承自
Model类,模型类跟关系型数据库的二维表对应,模型对象跟表中的记录对应,模型对象的属性跟表中的字段对应。如果对上面模型类的属性定义不是特别理解,可以看看本文后面提供的“模型定义参考”部分的内容。
使用ORM完成模型的CRUD操作
有了Django框架的ORM,我们可以直接使用面向对象的方式来实现对数据的CRUD(增删改查)操作。我们可以在PyCharm的终端中输入下面的命令进入到Django项目的交互式环境,然后尝试对模型的操作。
python manage.py shell新增
from polls.models import Subject
subject1 = Subject(name='Python全栈开发', intro='当下最热门的学科', is_hot=True)subject1.save()subject2 = Subject(name='全栈软件测试', intro='学习自动化测试的学科', is_hot=False)subject2.save()subject3 = Subject(name='JavaEE分布式开发', intro='基于Java语言的服务器应用开发', is_hot=True)删除
subject = Subject.objects.get(no=2)subject.delete()更新
subject = Subject.objects.get(no=1)subject.name = 'Python全栈+人工智能'subject.save()查询
- 查询所有对象。
Subject.objects.all()- 过滤数据。
# 查询名称为“Python全栈+人工智能”的学科Subject.objects.filter(name='Python全栈+人工智能')
# 查询名称包含“全栈”的学科(模糊查询)Subject.objects.filter(name__contains='全栈')Subject.objects.filter(name__startswith='全栈')Subject.objects.filter(name__endswith='全栈')
# 查询所有热门学科Subject.objects.filter(is_hot=True)
# 查询编号大于3小于10的学科Subject.objects.filter(no__gt=3).filter(no__lt=10)Subject.objects.filter(no__gt=3, no__lt=10)
# 查询编号在3到7之间的学科Subject.objects.filter(no__ge=3, no__le=7)Subject.objects.filter(no__range=(3, 7))- 查询单个对象。
# 查询主键为1的学科Subject.objects.get(pk=1)Subject.objects.get(no=1)Subject.objects.filter(no=1).first()Subject.objects.filter(no=1).last()- 排序。
# 查询所有学科按编号升序排列Subject.objects.order_by('no')# 查询所有部门按部门编号降序排列Subject.objects.order_by('-no')- 切片(分页查询)。
# 按编号从小到大查询前3个学科Subject.objects.order_by('no')[:3]- 计数。
# 查询一共有多少个学科Subject.objects.count()- 高级查询。
# 查询编号为1的学科的老师Teacher.objects.filter(subject__no=1)Subject.objects.get(pk=1).teacher_set.all()
# 查询学科名称有“全栈”二字的学科的老师Teacher.objects.filter(subject__name__contains='全栈')说明1:由于老师与学科之间存在多对一外键关联,所以能通过学科反向查询到该学科的老师(从一对多关系中“一”的一方查询“多”的一方),反向查询属性默认的名字是
类名小写_set(如上面例子中的teacher_set),当然也可以在创建模型时通过ForeingKey的related_name属性指定反向查询属性的名字。如果不希望执行反向查询可以将related_name属性设置为'+'或者以'+'开头的字符串。
说明2:ORM查询多个对象时会返回QuerySet对象,QuerySet使用了惰性查询,即在创建QuerySet对象的过程中不涉及任何数据库活动,等真正用到对象时(对QuerySet求值)才向数据库发送SQL语句并获取对应的结果,这一点在实际开发中需要引起注意!
说明3:如果希望更新多条数据,不用先逐一获取模型对象再修改对象属性,可以直接使用QuerySet对象的
update()方法一次性更新多条数据。
利用Django后台管理模型
在创建好模型类之后,可以通过Django框架自带的后台管理应用(admin应用)实现对模型的管理。虽然实际应用中,这个后台可能并不能满足我们的需求,但是在学习Django框架时,我们可以利用admin应用来管理我们的模型,同时也通过它来了解一个项目的后台管理系统需要哪些功能。使用Django自带的admin应用步骤如下所示。
-
将
admin应用所需的表迁移到数据库中。admin应用本身也需要数据库的支持,而且在admin应用中已经定义好了相关的数据模型类,我们只需要通过模型迁移操作就能自动在数据库中生成所需的二维表。Terminal window python manage.py migrate -
创建访问
admin应用的超级用户账号,这里需要输入用户名、邮箱和口令。Terminal window python manage.py createsuperuser说明:输入口令时没有回显也不能退格,需要一气呵成完成输入。
-
运行项目,在浏览器中访问
http://127.0.0.1:8000/admin,输入刚才创建的超级用户账号和密码进行登录。(原图缺失:django-admin-login.png,请到原仓库查看)
登录后进入管理员操作平台。
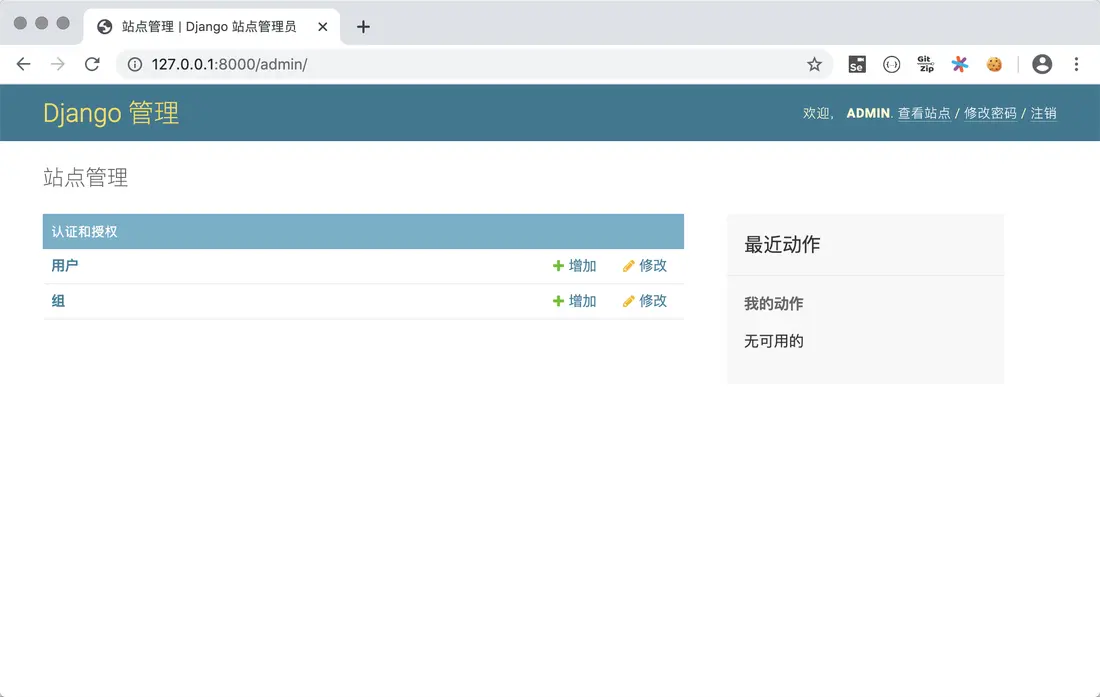
注意,我们暂时还没能在
admin应用中看到之前创建的模型类,为此需要在polls应用的admin.py文件中对需要管理的模型进行注册。 -
注册模型类。
from django.contrib import adminfrom polls.models import Subject, Teacheradmin.site.register(Subject)admin.site.register(Teacher)注册模型类后,就可以在后台管理系统中看到它们。
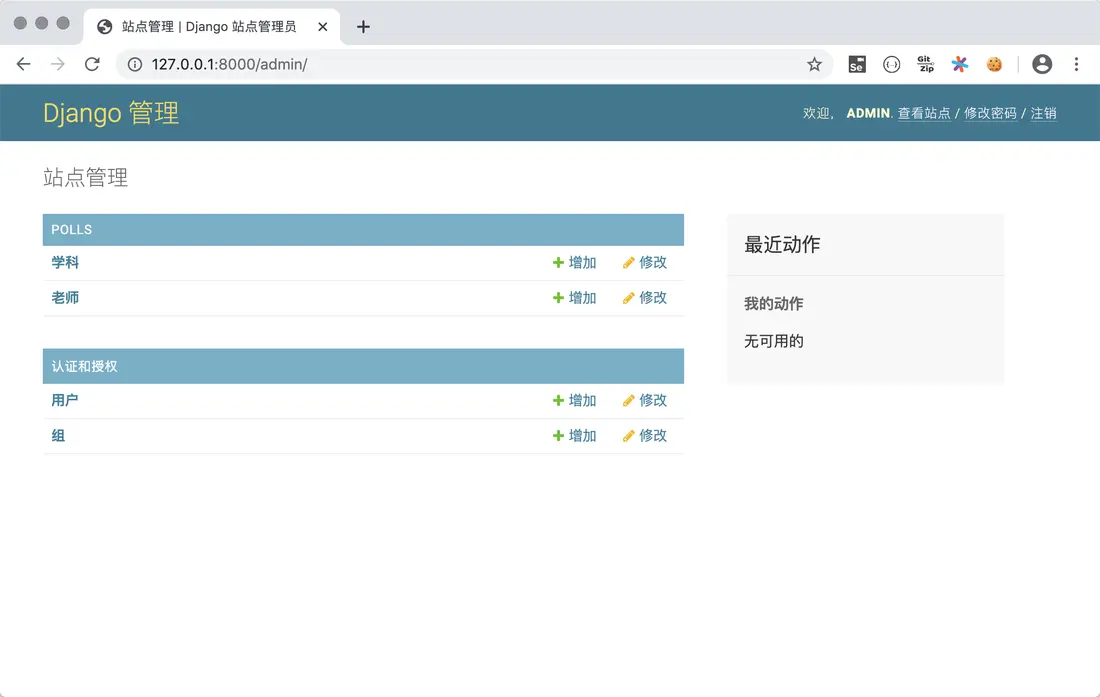
-
对模型进行CRUD操作。
可以在管理员平台对模型进行C(新增)、R(查看)、U(更新)、D(删除)操作,如下图所示。
-
添加学科。
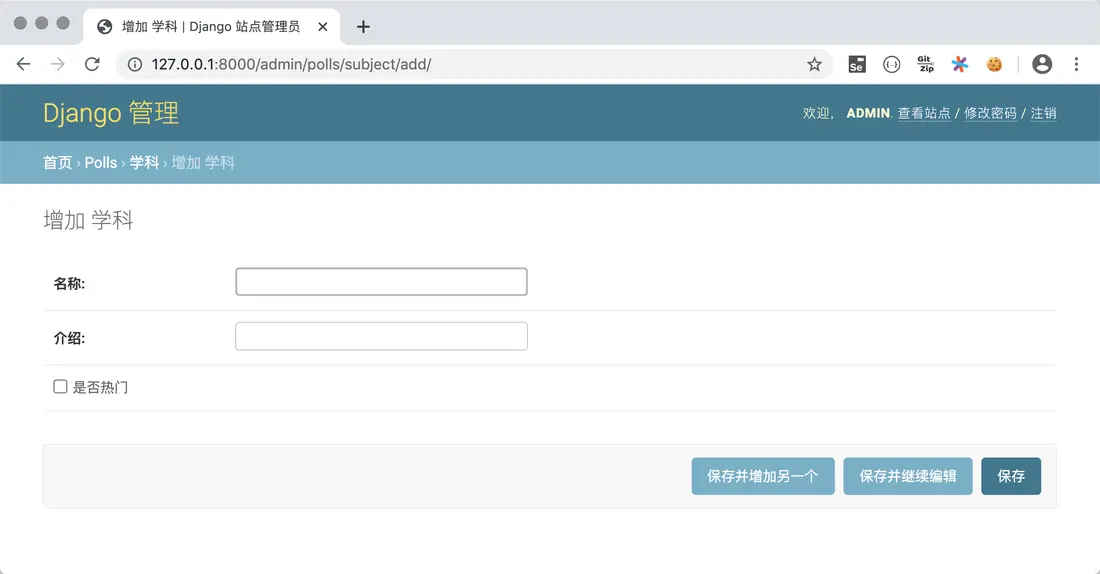
-
查看所有学科。
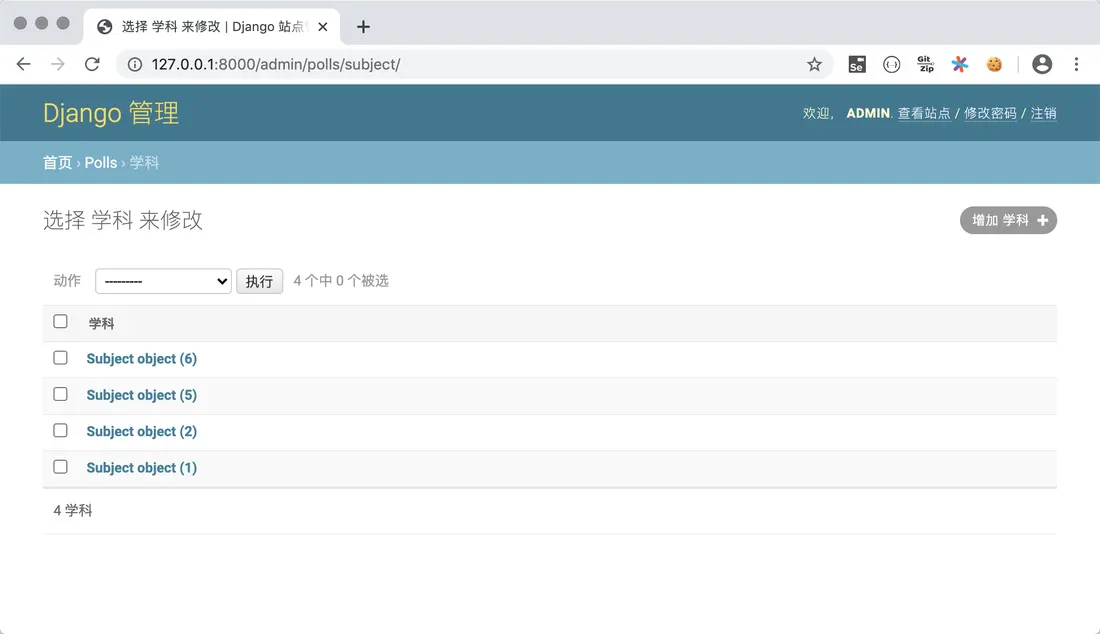
-
删除和更新学科。
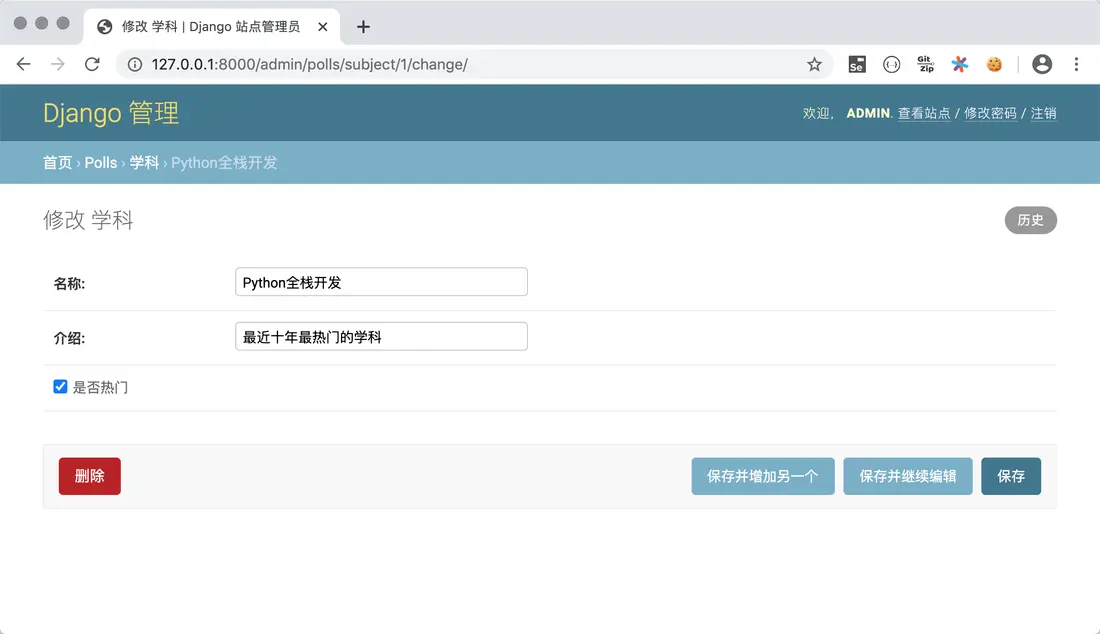
-
-
注册模型管理类。
可能大家已经注意到了,刚才在后台查看部门信息的时候,显示的部门信息并不直观,为此我们再修改
admin.py文件,通过注册模型管理类,可以在后台管理系统中更好的管理模型。from django.contrib import adminfrom polls.models import Subject, Teacherclass SubjectModelAdmin(admin.ModelAdmin):list_display = ('no', 'name', 'intro', 'is_hot')search_fields = ('name', )ordering = ('no', )class TeacherModelAdmin(admin.ModelAdmin):list_display = ('no', 'name', 'sex', 'birth', 'good_count', 'bad_count', 'subject')search_fields = ('name', )ordering = ('no', )admin.site.register(Subject, SubjectModelAdmin)admin.site.register(Teacher, TeacherModelAdmin)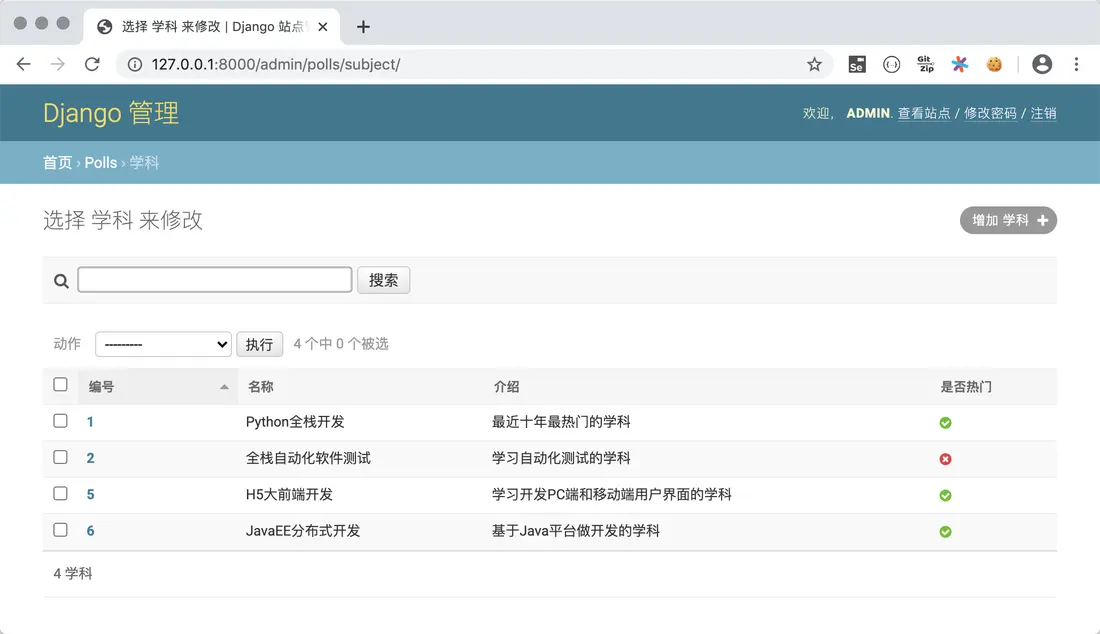
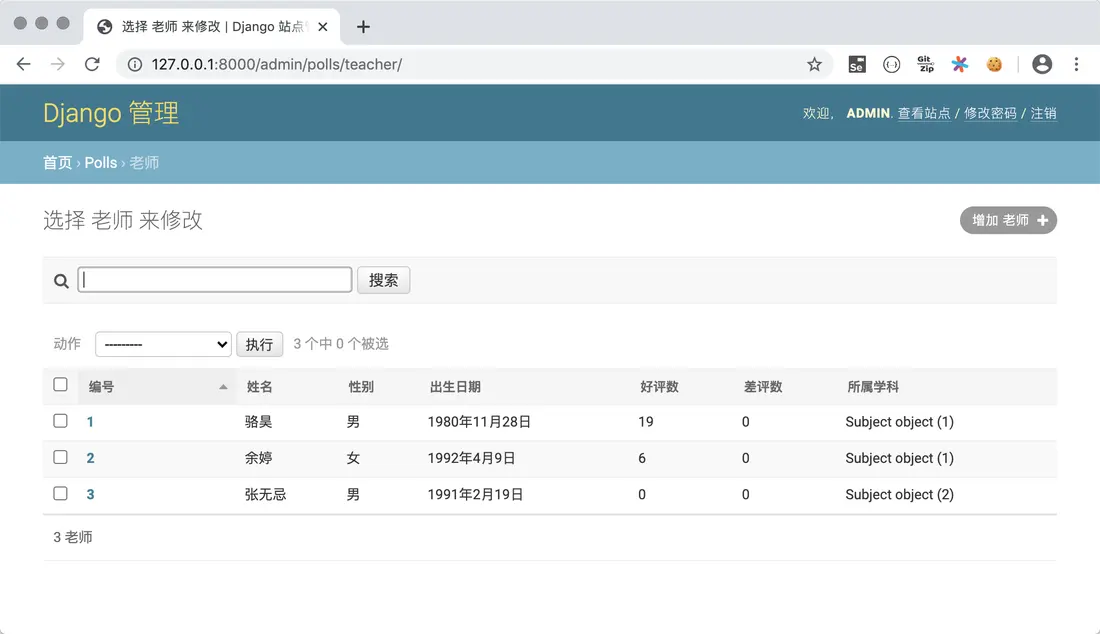
为了更好的查看模型,我们为
Subject类添加__str__魔法方法,并在该方法中返回学科名字。这样在如上图所示的查看老师的页面上显示老师所属学科时,就不再是Subject object(1)这样晦涩的信息,而是学科的名称。
实现学科页和老师页效果
-
修改
polls/views.py文件,编写视图函数实现对学科页和老师页的渲染。from django.shortcuts import render, redirectfrom polls.models import Subject, Teacherdef show_subjects(request):subjects = Subject.objects.all().order_by('no')return render(request, 'subjects.html', {'subjects': subjects})def show_teachers(request):try:sno = int(request.GET.get('sno'))teachers = []if sno:subject = Subject.objects.only('name').get(no=sno)teachers = Teacher.objects.filter(subject=subject).order_by('no')return render(request, 'teachers.html', {'subject': subject,'teachers': teachers})except (ValueError, Subject.DoesNotExist):return redirect('/') -
修改
templates/subjects.html和templates/teachers.html模板页。subjects.html<!DOCTYPE html><html lang="en"><head><meta charset="UTF-8"><title>学科信息</title><style>#container {width: 80%;margin: 10px auto;}.user {float: right;margin-right: 10px;}.user>a {margin-right: 10px;}#main>dl>dt {font-size: 1.5em;font-weight: bold;}#main>dl>dd {font-size: 1.2em;}a {text-decoration: none;color: darkcyan;}</style></head><body><div id="container"><div class="user"><a href="login.html">用户登录</a><a href="register.html">快速注册</a></div><h1>扣丁学堂所有学科</h1><hr><div id="main">{% for subject in subjects %}<dl><dt><a href="/teachers/?sno={{ subject.no }}">{{ subject.name }}</a>{% if subject.is_hot %}<img src="/static/images/hot-icon-small.png">{% endif %}</dt><dd>{{ subject.intro }}</dd></dl>{% endfor %}</div></div></body></html>teachers.html<!DOCTYPE html><html lang="en"><head><meta charset="UTF-8"><title>老师信息</title><style>#container {width: 80%;margin: 10px auto;}.teacher {width: 100%;margin: 0 auto;padding: 10px 0;border-bottom: 1px dashed gray;overflow: auto;}.teacher>div {float: left;}.photo {height: 140px;border-radius: 75px;overflow: hidden;margin-left: 20px;}.info {width: 75%;margin-left: 30px;}.info div {clear: both;margin: 5px 10px;}.info span {margin-right: 25px;}.info a {text-decoration: none;color: darkcyan;}</style></head><body><div id="container"><h1>{{ subject.name }}学科的老师信息</h1><hr>{% if not teachers %}<h2>暂无该学科老师信息</h2>{% endif %}{% for teacher in teachers %}<div class="teacher"><div class="photo"><img src="/static/images/{{ teacher.photo }}" height="140" alt=""></div><div class="info"><div><span><strong>姓名:{{ teacher.name }}</strong></span><span>性别:{{ teacher.sex | yesno:'男,女' }}</span><span>出生日期:{{ teacher.birth | date:'Y年n月j日'}}</span></div><div class="intro">{{ teacher.intro }}</div><div class="comment"><a href="">好评</a> (<strong>{{ teacher.good_count }}</strong>) <a href="">差评</a> <strong>{{ teacher.bad_count }}</strong>)</div></div></div>{% endfor %}<a href="/">返回首页</a></div></body></html> -
修改
vote/urls.py文件,实现映射URL。from django.contrib import adminfrom django.urls import pathfrom polls.views import show_subjects, show_teachersurlpatterns = [path('admin/', admin.site.urls),path('', show_subjects),path('teachers/', show_teachers),]
到此为止,页面上需要的图片(静态资源)还没有能够正常展示,我们在下一章节中为大家介绍如何处理模板页上的需要的静态资源。
补充内容
Django模型最佳实践
- 正确的为模型和关系字段命名。
- 设置适当的
related_name属性。 - 用
OneToOneField代替ForeignKeyField(unique=True)。 - 通过“迁移操作”(migrate)来添加模型。
- 用NoSQL来应对需要降低范式级别的场景。
- 如果布尔类型可以为空要使用
NullBooleanField。 - 在模型中放置业务逻辑。
- 用
<ModelName>.DoesNotExists取代ObjectDoesNotExists。 - 在数据库中不要出现无效数据。
- 不要对
QuerySet调用len()函数。 - 将
QuerySet的exists()方法的返回值用于if条件。 - 用
DecimalField来存储货币相关数据而不是FloatField。 - 定义
__str__方法。 - 不要将数据文件放在同一个目录中。
说明:以上内容来自于STEELKIWI网站的Best Practice working with Django models in Python,有兴趣的小伙伴可以阅读原文。
模型定义参考
字段
对字段名称的限制
- 字段名不能是Python的保留字,否则会导致语法错误
- 字段名不能有多个连续下划线,否则影响ORM查询操作
Django模型字段类
| 字段类 | 说明 |
|---|---|
AutoField | 自增ID字段 |
BigIntegerField | 64位有符号整数 |
BinaryField | 存储二进制数据的字段,对应Python的bytes类型 |
BooleanField | 存储True或False |
CharField | 长度较小的字符串 |
DateField | 存储日期,有auto_now和auto_now_add属性 |
DateTimeField | 存储日期和日期,两个附加属性同上 |
DecimalField | 存储固定精度小数,有max_digits(有效位数)和decimal_places(小数点后面)两个必要的参数 |
DurationField | 存储时间跨度 |
EmailField | 与CharField相同,可以用EmailValidator验证 |
FileField | 文件上传字段 |
FloatField | 存储浮点数 |
ImageField | 其他同FileFiled,要验证上传的是不是有效图像 |
IntegerField | 存储32位有符号整数。 |
GenericIPAddressField | 存储IPv4或IPv6地址 |
NullBooleanField | 存储True、False或null值 |
PositiveIntegerField | 存储无符号整数(只能存储正数) |
SlugField | 存储slug(简短标注) |
SmallIntegerField | 存储16位有符号整数 |
TextField | 存储数据量较大的文本 |
TimeField | 存储时间 |
URLField | 存储URL的CharField |
UUIDField | 存储全局唯一标识符 |
字段属性
通用字段属性
| 选项 | 说明 |
|---|---|
null | 数据库中对应的字段是否允许为NULL,默认为False |
blank | 后台模型管理验证数据时,是否允许为NULL,默认为False |
choices | 设定字段的选项,各元组中的第一个值是设置在模型上的值,第二值是人类可读的值 |
db_column | 字段对应到数据库表中的列名,未指定时直接使用字段的名称 |
db_index | 设置为True时将在该字段创建索引 |
db_tablespace | 为有索引的字段设置使用的表空间,默认为DEFAULT_INDEX_TABLESPACE |
default | 字段的默认值 |
editable | 字段在后台模型管理或ModelForm中是否显示,默认为True |
error_messages | 设定字段抛出异常时的默认消息的字典,其中的键包括null、blank、invalid、invalid_choice、unique和unique_for_date |
help_text | 表单小组件旁边显示的额外的帮助文本。 |
primary_key | 将字段指定为模型的主键,未指定时会自动添加AutoField用于主键,只读。 |
unique | 设置为True时,表中字段的值必须是唯一的 |
verbose_name | 字段在后台模型管理显示的名称,未指定时使用字段的名称 |
ForeignKey属性
limit_choices_to:值是一个Q对象或返回一个Q对象,用于限制后台显示哪些对象。related_name:用于获取关联对象的关联管理器对象(反向查询),如果不允许反向,该属性应该被设置为'+',或者以'+'结尾。to_field:指定关联的字段,默认关联对象的主键字段。db_constraint:是否为外键创建约束,默认值为True。on_delete:外键关联的对象被删除时对应的动作,可取的值包括django.db.models中定义的:CASCADE:级联删除。PROTECT:抛出ProtectedError异常,阻止删除引用的对象。SET_NULL:把外键设置为null,当null属性被设置为True时才能这么做。SET_DEFAULT:把外键设置为默认值,提供了默认值才能这么做。
ManyToManyField属性
symmetrical:是否建立对称的多对多关系。through:指定维持多对多关系的中间表的Django模型。throughfields:定义了中间模型时可以指定建立多对多关系的字段。db_table:指定维持多对多关系的中间表的表名。
模型元数据选项
| 选项 | 说明 |
|---|---|
abstract | 设置为True时模型是抽象父类 |
app_label | 如果定义模型的应用不在INSTALLED_APPS中可以用该属性指定 |
db_table | 模型使用的数据表名称 |
db_tablespace | 模型使用的数据表空间 |
default_related_name | 关联对象回指这个模型时默认使用的名称,默认为<model_name>_set |
get_latest_by | 模型中可排序字段的名称。 |
managed | 设置为True时,Django在迁移中创建数据表并在执行flush管理命令时把表移除 |
order_with_respect_to | 标记对象为可排序的 |
ordering | 对象的默认排序 |
permissions | 创建对象时写入权限表的额外权限 |
default_permissions | 默认为('add', 'change', 'delete') |
unique_together | 设定组合在一起时必须独一无二的字段名 |
index_together | 设定一起建立索引的多个字段名 |
verbose_name | 为对象设定人类可读的名称 |
verbose_name_plural | 设定对象的复数名称 |
查询参考
按字段查找可以用的条件
exact/iexact:精确匹配/忽略大小写的精确匹配查询contains/icontains/startswith/istartswith/endswith/iendswith:基于like的模糊查询in:集合运算gt/gte/lt/lte:大于/大于等于/小于/小于等于关系运算range:指定范围查询(SQL中的between…and…)year/month/day/week_day/hour/minute/second:查询时间日期isnull:查询空值(True)或非空值(False)search:基于全文索引的全文检索(一般很少使用)regex/iregex:基于正则表达式的模糊匹配查询
48 静态资源和Ajax请求
加载静态资源
如果要在Django项目中使用静态资源,可以先创建一个用于保存静态资源的目录。在vote项目中,我们将静态资源置于名为static的文件夹中,在该文件夹包含了三个子文件夹:css、js和images,分别用来保存外部CSS文件、外部JavaScript文件和图片资源,如下图所示。
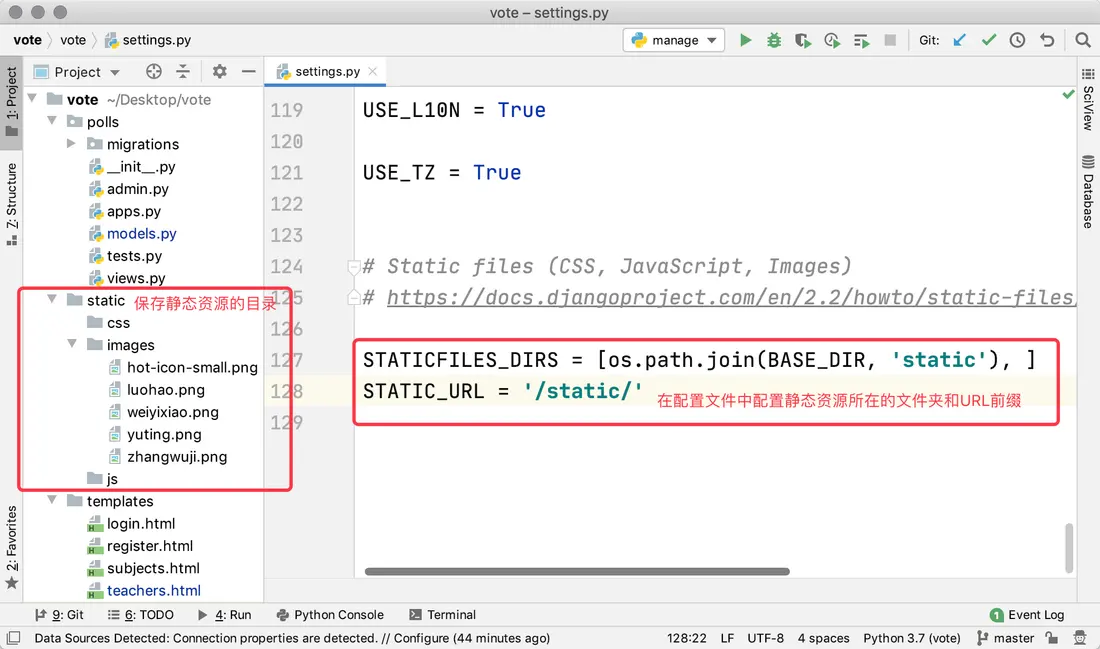
为了能够找到保存静态资源的文件夹,我们还需要修改Django项目的配置文件settings.py,如下所示:
STATICFILES_DIRS = [os.path.join(BASE_DIR, 'static'), ]STATIC_URL = '/static/'配置好静态资源之后,大家可以运行项目,然后看看之前我们写的页面上的图片是否能够正常加载出来。需要说明的是,在项目正式部署到线上环境后,我们通常会把静态资源交给专门的静态资源服务器(如Nginx、Apache)来处理,而不是有运行Python代码的服务器来管理静态资源,所以上面的配置并不适用于生产环境,仅供项目开发阶段测试使用。使用静态资源的正确姿势我们会在后续的章节为大家讲解。
Ajax概述
接下来就可以实现“好评”和“差评”的功能了,很明显如果能够在不刷新页面的情况下实现这两个功能会带来更好的用户体验,因此我们考虑使用Ajax技术来实现“好评”和“差评”。Ajax是Asynchronous Javascript And XML的缩写 , 简单的说,使用Ajax技术可以在不重新加载整个页面的情况下对页面进行局部刷新。
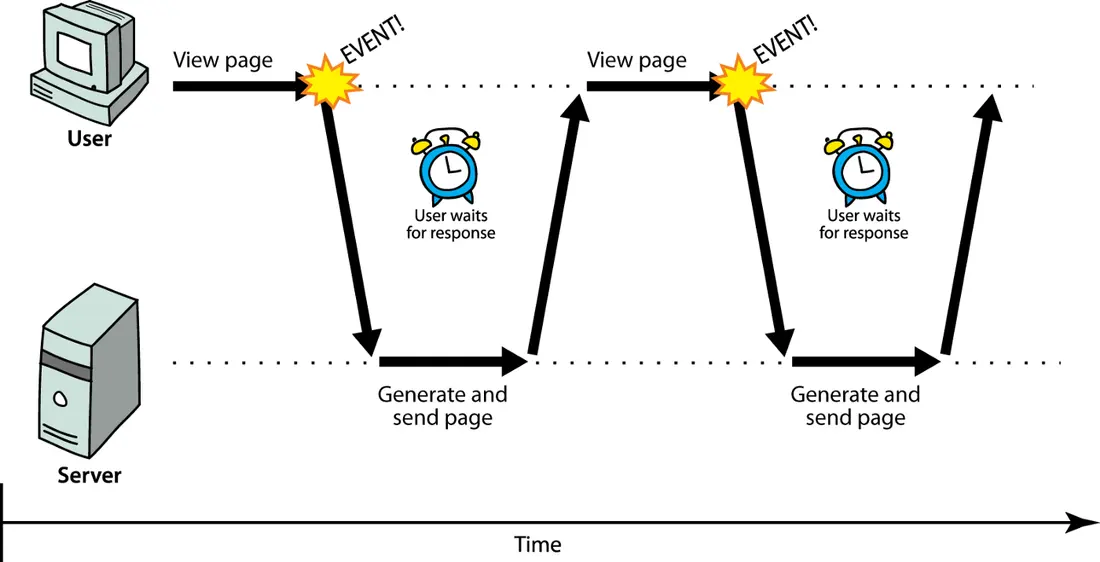
对于传统的Web应用,每次页面上需要加载新的内容都需要重新请求服务器并刷新整个页面,如果服务器短时间内无法给予响应或者网络状况并不理想,那么可能会造成浏览器长时间的空白并使得用户处于等待状态,在这个期间用户什么都做不了,如下图所示。很显然,这样的Web应用并不能带来很好的用户体验。
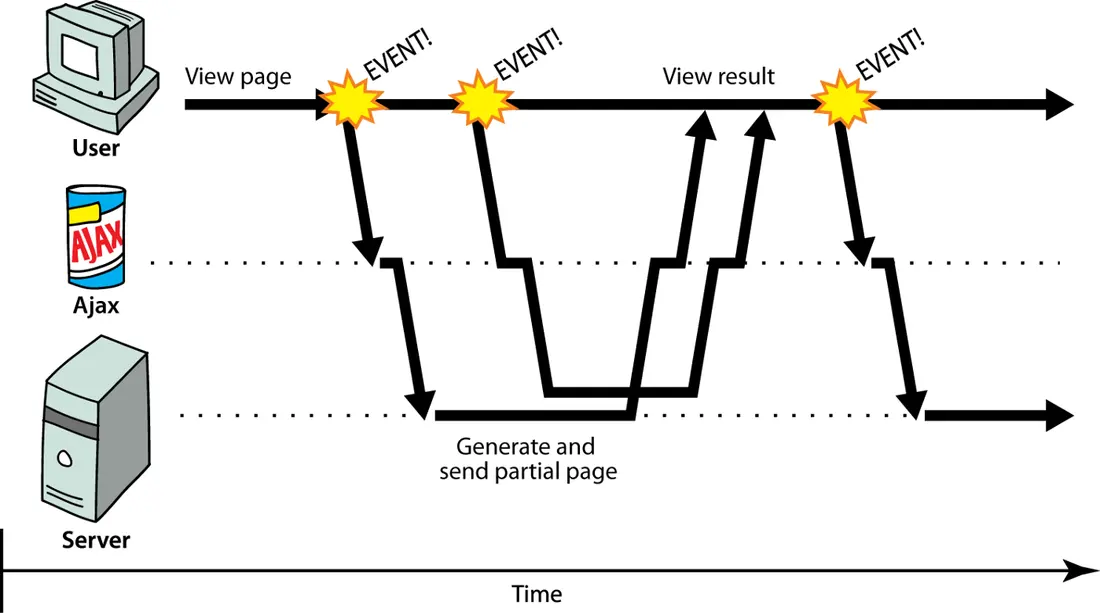
对于使用Ajax技术的Web应用,浏览器可以向服务器发起异步请求来获取数据。异步请求不会中断用户体验,当服务器返回了新的数据,我们可以通过JavaScript代码进行DOM操作来实现对页面的局部刷新,这样就相当于在不刷新整个页面的情况下更新了页面的内容,如下图所示。
在使用Ajax技术时,浏览器跟服务器通常会交换XML或JSON格式的数据,XML是以前使用得非常多的一种数据格式,近年来几乎已经完全被JSON取代,下面是两种数据格式的对比。
XML格式:
<?xml version="1.0" encoding="utf-8"?><message> <from>Alice</from> <to>Bob</to> <content>Dinner is on me!</content></message>JSON格式:
{ "from": "Alice", "to": "Bob", "content": "Dinner is on me!"}通过上面的对比,明显JSON格式的数据要紧凑得多,所以传输效率更高,而且JSON本身也是JavaScript中的一种对象表达式语法,在JavaScript代码中处理JSON格式的数据更加方便。
用Ajax实现投票功能
下面,我们使用Ajax技术来实现投票的功能,首先修改项目的urls.py文件,为“好评”和“差评”功能映射对应的URL。
from django.contrib import adminfrom django.urls import path
from polls import views
urlpatterns = [ path('', views.show_subjects), path('teachers/', views.show_teachers), path('praise/', views.praise_or_criticize), path('criticize/', views.praise_or_criticize), path('admin/', admin.site.urls),]设计视图函数praise_or_criticize来支持“好评”和“差评”功能,该视图函数通过Django封装的JsonResponse类将字典序列化成JSON字符串作为返回给浏览器的响应内容。
def praise_or_criticize(request): """好评""" try: tno = int(request.GET.get('tno')) teacher = Teacher.objects.get(no=tno) if request.path.startswith('/praise'): teacher.good_count += 1 count = teacher.good_count else: teacher.bad_count += 1 count = teacher.bad_count teacher.save() data = {'code': 20000, 'mesg': '操作成功', 'count': count} except (ValueError, Teacher.DoseNotExist): data = {'code': 20001, 'mesg': '操作失败'} return JsonResponse(data)修改显示老师信息的模板页,引入jQuery库来实现事件处理、Ajax请求和DOM操作。
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8"> <title>老师信息</title> <style> #container { width: 80%; margin: 10px auto; } .teacher { width: 100%; margin: 0 auto; padding: 10px 0; border-bottom: 1px dashed gray; overflow: auto; } .teacher>div { float: left; } .photo { height: 140px; border-radius: 75px; overflow: hidden; margin-left: 20px; } .info { width: 75%; margin-left: 30px; } .info div { clear: both; margin: 5px 10px; } .info span { margin-right: 25px; } .info a { text-decoration: none; color: darkcyan; } </style></head><body> <div id="container"> <h1>{{ subject.name }}学科的老师信息</h1> <hr> {% if not teachers %} <h2>暂无该学科老师信息</h2> {% endif %} {% for teacher in teachers %} <div class="teacher"> <div class="photo"> <img src="/static/images/{{ teacher.photo }}" height="140" alt=""> </div> <div class="info"> <div> <span><strong>姓名:{{ teacher.name }}</strong></span> <span>性别:{{ teacher.sex | yesno:'男,女' }}</span> <span>出生日期:{{ teacher.birth }}</span> </div> <div class="intro">{{ teacher.intro }}</div> <div class="comment"> <a href="/praise/?tno={{ teacher.no }}">好评</a> (<strong>{{ teacher.good_count }}</strong>) <a href="/criticize/?tno={{ teacher.no }}">差评</a> (<strong>{{ teacher.bad_count }}</strong>) </div> </div> </div> {% endfor %} <a href="/">返回首页</a> </div> <script src="https://cdn.bootcss.com/jquery/3.4.1/jquery.min.js"></script> <script> $(() => { $('.comment>a').on('click', (evt) => { evt.preventDefault() let url = $(evt.target).attr('href') $.getJSON(url, (json) => { if (json.code == 20000) { $(evt.target).next().text(json.count) } else { alert(json.mesg) } }) }) }) </script></body></html>上面的前端代码中,使用了jQuery库封装的getJSON方法向服务器发送异步请求,如果不熟悉前端的jQuery库,可以参考《jQuery API手册》。
小结
到此为止,这个投票项目的核心功能已然完成,在下面的章节中我们会要求用户必须登录才能投票,没有账号的用户可以通过注册功能注册一个账号。
49 Cookie和Session
我们继续来完成上一章节中的项目,实现“用户登录”的功能,并限制只有登录的用户才能投票。
用户登录的准备工作
我们先为实现用户登录做一些准备工作。
-
创建用户模型。之前我们讲解过如果通过Django的ORM实现从二维表到模型的转换(反向工程),这次我们尝试把模型变成二维表(正向工程)。
class User(models.Model):"""用户"""no = models.AutoField(primary_key=True, verbose_name='编号')username = models.CharField(max_length=20, unique=True, verbose_name='用户名')password = models.CharField(max_length=32, verbose_name='密码')tel = models.CharField(max_length=20, verbose_name='手机号')reg_date = models.DateTimeField(auto_now_add=True, verbose_name='注册时间')last_visit = models.DateTimeField(null=True, verbose_name='最后登录时间')class Meta:db_table = 'tb_user'verbose_name = '用户'verbose_name_plural = '用户' -
使用下面的命令生成迁移文件并执行迁移,将
User模型直接变成关系型数据库中的二维表tb_user。Terminal window python manage.py makemigrations pollspython manage.py migrate polls -
用下面的SQL语句直接插入两条测试数据,通常不能将用户的密码直接保存在数据库中,因此我们将用户密码处理成对应的MD5摘要。MD5消息摘要算法是一种被广泛使用的密码哈希函数(散列函数),可以产生出一个128位(比特)的哈希值(散列值),用于确保信息传输完整一致。在使用哈希值时,通常会将哈希值表示为16进制字符串,因此128位的MD5摘要通常表示为32个十六进制符号。
insert into `tb_user`(`username`, `password`, `tel`, `reg_date`)values('wangdachui', '1c63129ae9db9c60c3e8aa94d3e00495', '13122334455', now()),('hellokitty', 'c6f8cf68e5f68b0aa4680e089ee4742c', '13890006789', now());说明:上面创建的两个用户
wangdachui和hellokitty密码分别是1qaz2wsx和Abc123!!。 -
我们在应用下增加一个名为
utils.py的模块用来保存需要使用的工具函数。Python标准库中的hashlib模块封装了常用的哈希算法,包括:MD5、SHA1、SHA256等。下面是使用hashlib中的md5类将字符串处理成MD5摘要的函数如下所示。import hashlibdef gen_md5_digest(content):return hashlib.md5(content.encode()).hexdigest() -
编写用户登录的视图函数和模板页。
添加渲染登录页面的视图函数:
def login(request: HttpRequest) -> HttpResponse:hint = ''return render(request, 'login.html', {'hint': hint})增加
login.html模板页:<!DOCTYPE html><html lang="en"><head><meta charset="UTF-8"><title>用户登录</title><style>#container {width: 520px;margin: 10px auto;}.input {margin: 20px 0;width: 460px;height: 40px;}.input>label {display: inline-block;width: 140px;text-align: right;}.input>img {width: 150px;vertical-align: middle;}input[name=captcha] {vertical-align: middle;}form+div {margin-top: 20px;}form+div>a {text-decoration: none;color: darkcyan;font-size: 1.2em;}.button {width: 500px;text-align: center;margin-top: 20px;}.hint {color: red;font-size: 12px;}</style></head><body><div id="container"><h1>用户登录</h1><hr><p class="hint">{{ hint }}</p><form action="/login/" method="post">{% csrf_token %}<fieldset><legend>用户信息</legend><div class="input"><label>用户名:</label><input type="text" name="username"></div><div class="input"><label>密码:</label><input type="password" name="password"></div><div class="input"><label>验证码:</label><input type="text" name="captcha"><img id="code" src="/captcha/" alt="" width="150" height="40"></div></fieldset><div class="button"><input type="submit" value="登录"><input type="reset" value="重置"></div></form><div><a href="/">返回首页</a><a href="/register/">注册新用户</a></div></div></body></html>注意,在上面的表单中,我们使用了模板指令
{% csrf_token %}为表单添加一个隐藏域(大家可以在浏览器中显示网页源代码就可以看到这个指令生成的type属性为hidden的input标签),它的作用是在表单中生成一个随机令牌(token)来防范跨站请求伪造(简称为CSRF),这也是Django在提交表单时的硬性要求。如果我们的表单中没有这样的令牌,那么提交表单时,Django框架会产生一个响应状态码为403的响应(禁止访问),除非我们设置了免除CSRF令牌。下图是一个关于CSRF简单生动的例子。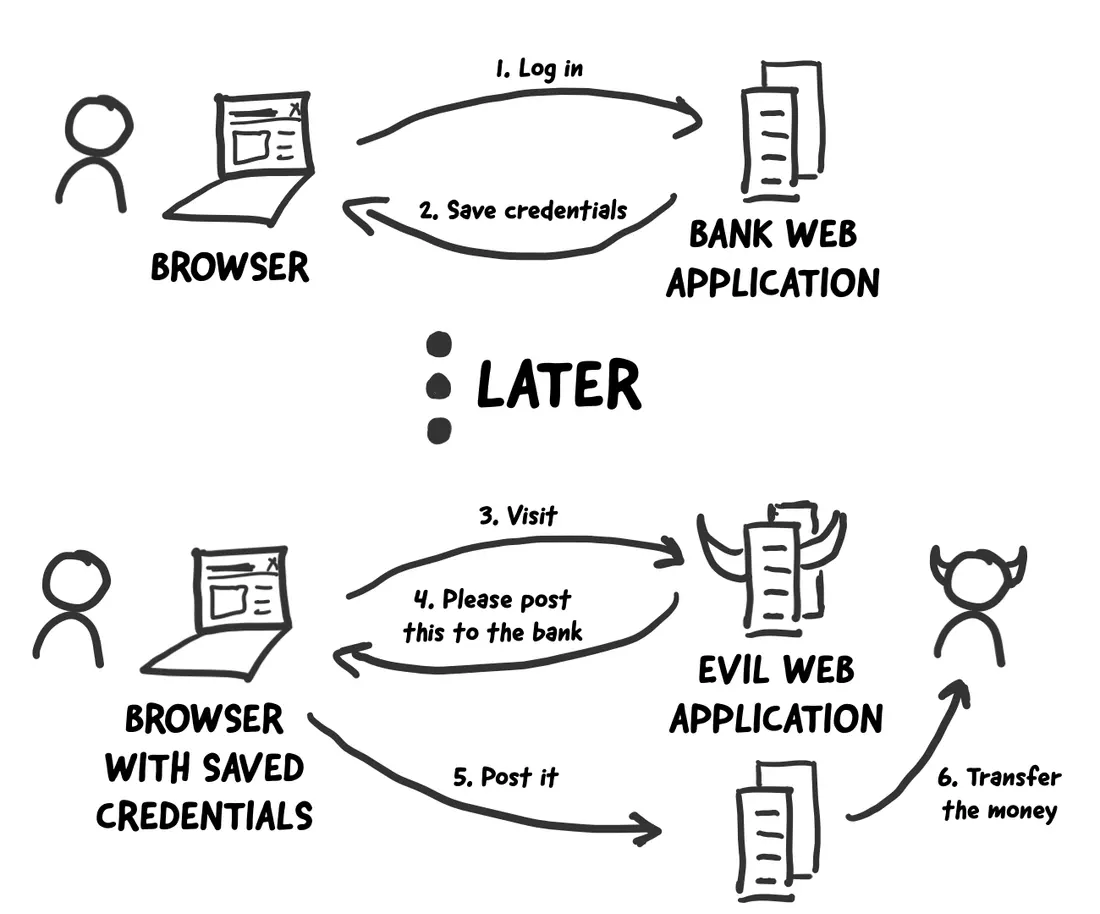
接下来,我们可以编写提供验证码和实现用户登录的视图函数,在此之前,我们先说说一个Web应用实现用户跟踪的方式以及Django框架对实现用户跟踪所提供的支持。对一个Web应用来说,用户登录成功后必然要让服务器能够记住该用户已经登录,这样服务器才能为这个用户提供更好的服务,而且上面说到的CSRF也是通过钓鱼网站来套取用户登录信息进行恶意操作的攻击手段,这些都是以用户跟踪技术为基础的。在理解了这些背景知识后,我们就清楚用户登录时到底需要执行哪些操作。
实现用户跟踪
如今,一个网站如果不通过某种方式记住你是谁以及你之前在网站的活动情况,失去的就是网站的可用性和便利性,继而很有可能导致网站用户的流式,所以记住一个用户(更专业的说法叫用户跟踪)对绝大多数Web应用来说都是必需的功能。
在服务器端,我们想记住一个用户最简单的办法就是创建一个对象,通过这个对象就可以把用户相关的信息都保存起来,这个对象就是我们常说的session(用户会话对象)。那么问题来了,HTTP本身是一个无连接(每次请求和响应的过程中,服务器一旦完成对客户端请求的响应之后就断开连接)、无状态(客户端再次发起对服务器的请求时,服务器无法得知这个客户端之前的任何信息)的协议,即便服务器通过session对象保留了用户数据,还得通过某种方式来确定当前的请求与之前保存过的哪一个session是有关联的。相信很多人都能想到,我们可以给每个session对象分配一个全局唯一的标识符来识别session对象,我们姑且称之为sessionid,每次客户端发起请求时,只要携带上这个sessionid,就有办法找到与之对应的session对象,从而实现在两次请求之间记住该用户的信息,也就是我们之前说的用户跟踪。
要让客户端记住并在每次请求时带上sessionid又有以下几种做法:
-
URL重写。所谓URL重写就是在URL中携带sessionid,例如:
http://www.example.com/index.html?sessionid=123456,服务器通过获取sessionid参数的值来取到与之对应的session对象。 -
隐藏域(隐式表单域)。在提交表单的时候,可以通过在表单中设置隐藏域向服务器发送额外的数据。例如:
<input type="hidden" name="sessionid" value="123456">。 -
本地存储。现在的浏览器都支持多种本地存储方案,包括:cookie、localStorage、sessionStorage、IndexedDB等。在这些方案中,cookie是历史最为悠久也是被诟病得最多的一种方案,也是我们接下来首先为大家讲解的一种方案。简单的说,cookie是一种以键值对方式保存在浏览器临时文件中的数据,每次请求时,请求头中会携带本站点的cookie到服务器,那么只要将sessionid写入cookie,下次请求时服务器只要读取请求头中的cookie就能够获得这个sessionid,如下图所示。
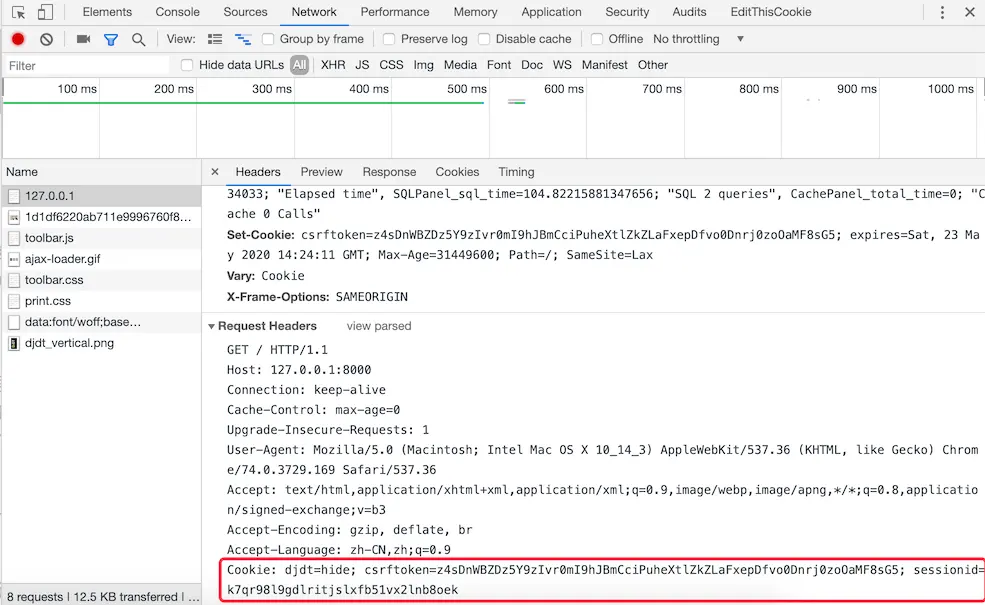
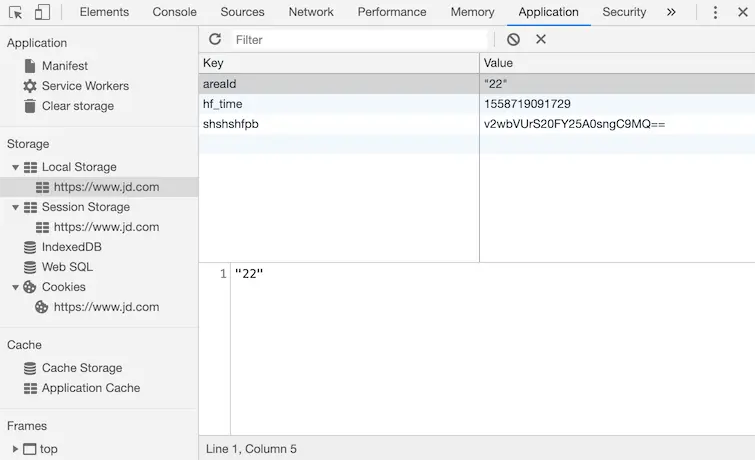
在HTML5时代要,除了cookie,还可以使用新的本地存储API来保存数据,就是刚才提到的localStorage、sessionStorage、IndexedDB等技术,如下图所示。
总结一下,要实现用户跟踪,服务器端可以为每个用户会话创建一个session对象并将session对象的ID写入到浏览器的cookie中;用户下次请求服务器时,浏览器会在HTTP请求头中携带该网站保存的cookie信息,这样服务器就可以从cookie中找到session对象的ID并根据此ID获取到之前创建的session对象;由于session对象可以用键值对的方式保存用户数据,这样之前保存在session对象中的信息可以悉数取出,服务器也可以根据这些信息判定用户身份和了解用户偏好,为用户提供更好的个性化服务。
Django框架对session的支持
在创建Django项目时,默认的配置文件settings.py文件中已经激活了一个名为SessionMiddleware的中间件(关于中间件的知识我们在后面的章节做详细讲解,这里只需要知道它的存在即可),因为这个中间件的存在,我们可以直接通过请求对象的session属性来操作会话对象。前面我们说过,session属性是一个像字典一样可以读写数据的容器对象,因此我们可以使用“键值对”的方式来保留用户数据。与此同时,SessionMiddleware中间件还封装了对cookie的操作,在cookie中保存了sessionid,这一点我们在上面已经提到过了。
在默认情况下,Django将session的数据序列化后保存在关系型数据库中,在Django 1.6以后的版本中,默认的序列化数据的方式是JSON序列化,而在此之前一直使用Pickle序列化。JSON序列化和Pickle序列化的差别在于前者将对象序列化为字符串(字符形式),而后者将对象序列化为字节串(二进制形式),因为安全方面的原因,JSON序列化成为了目前Django框架默认序列化数据的方式,这就要求在我们保存在session中的数据必须是能够JSON序列化的,否则就会引发异常。还有一点需要说明的是,使用关系型数据库保存session中的数据在大多数时候并不是最好的选择,因为数据库可能会承受巨大的压力而成为系统性能的瓶颈,在后面的章节中我们会告诉大家如何将session保存到缓存服务中以提升系统的性能。
实现用户登录验证
首先,我们在刚才的polls/utils.py文件中编写生成随机验证码的函数gen_random_code,内容如下所示。
import random
ALL_CHARS = '0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ'
def gen_random_code(length=4): return ''.join(random.choices(ALL_CHARS, k=length))编写生成验证码图片的类Captcha。
"""图片验证码"""import osimport randomfrom io import BytesIO
from PIL import Imagefrom PIL import ImageFilterfrom PIL.ImageDraw import Drawfrom PIL.ImageFont import truetype
class Bezier: """贝塞尔曲线"""
def __init__(self): self.tsequence = tuple([t / 20.0 for t in range(21)]) self.beziers = {}
def make_bezier(self, n): """绘制贝塞尔曲线""" try: return self.beziers[n] except KeyError: combinations = pascal_row(n - 1) result = [] for t in self.tsequence: tpowers = (t ** i for i in range(n)) upowers = ((1 - t) ** i for i in range(n - 1, -1, -1)) coefs = [c * a * b for c, a, b in zip(combinations, tpowers, upowers)] result.append(coefs) self.beziers[n] = result return result
class Captcha: """验证码"""
def __init__(self, width, height, fonts=None, color=None): self._image = None self._fonts = fonts if fonts else \ [os.path.join(os.path.dirname(__file__), 'fonts', font) for font in ['Arial.ttf', 'Georgia.ttf', 'Action.ttf']] self._color = color if color else random_color(0, 200, random.randint(220, 255)) self._width, self._height = width, height
@classmethod def instance(cls, width=200, height=75): """用于获取Captcha对象的类方法""" prop_name = f'_instance_{width}_{height}' if not hasattr(cls, prop_name): setattr(cls, prop_name, cls(width, height)) return getattr(cls, prop_name)
def _background(self): """绘制背景""" Draw(self._image).rectangle([(0, 0), self._image.size], fill=random_color(230, 255))
def _smooth(self): """平滑图像""" return self._image.filter(ImageFilter.SMOOTH)
def _curve(self, width=4, number=6, color=None): """绘制曲线""" dx, height = self._image.size dx /= number path = [(dx * i, random.randint(0, height)) for i in range(1, number)] bcoefs = Bezier().make_bezier(number - 1) points = [] for coefs in bcoefs: points.append(tuple(sum([coef * p for coef, p in zip(coefs, ps)]) for ps in zip(*path))) Draw(self._image).line(points, fill=color if color else self._color, width=width)
def _noise(self, number=50, level=2, color=None): """绘制扰码""" width, height = self._image.size dx, dy = width / 10, height / 10 width, height = width - dx, height - dy draw = Draw(self._image) for i in range(number): x = int(random.uniform(dx, width)) y = int(random.uniform(dy, height)) draw.line(((x, y), (x + level, y)), fill=color if color else self._color, width=level)
def _text(self, captcha_text, fonts, font_sizes=None, drawings=None, squeeze_factor=0.75, color=None): """绘制文本""" color = color if color else self._color fonts = tuple([truetype(name, size) for name in fonts for size in font_sizes or (65, 70, 75)]) draw = Draw(self._image) char_images = [] for c in captcha_text: font = random.choice(fonts) c_width, c_height = draw.textsize(c, font=font) char_image = Image.new('RGB', (c_width, c_height), (0, 0, 0)) char_draw = Draw(char_image) char_draw.text((0, 0), c, font=font, fill=color) char_image = char_image.crop(char_image.getbbox()) for drawing in drawings: d = getattr(self, drawing) char_image = d(char_image) char_images.append(char_image) width, height = self._image.size offset = int((width - sum(int(i.size[0] * squeeze_factor) for i in char_images[:-1]) - char_images[-1].size[0]) / 2) for char_image in char_images: c_width, c_height = char_image.size mask = char_image.convert('L').point(lambda i: i * 1.97) self._image.paste(char_image, (offset, int((height - c_height) / 2)), mask) offset += int(c_width * squeeze_factor)
@staticmethod def _warp(image, dx_factor=0.3, dy_factor=0.3): """图像扭曲""" width, height = image.size dx = width * dx_factor dy = height * dy_factor x1 = int(random.uniform(-dx, dx)) y1 = int(random.uniform(-dy, dy)) x2 = int(random.uniform(-dx, dx)) y2 = int(random.uniform(-dy, dy)) warp_image = Image.new( 'RGB', (width + abs(x1) + abs(x2), height + abs(y1) + abs(y2))) warp_image.paste(image, (abs(x1), abs(y1))) width2, height2 = warp_image.size return warp_image.transform( (width, height), Image.QUAD, (x1, y1, -x1, height2 - y2, width2 + x2, height2 + y2, width2 - x2, -y1))
@staticmethod def _offset(image, dx_factor=0.1, dy_factor=0.2): """图像偏移""" width, height = image.size dx = int(random.random() * width * dx_factor) dy = int(random.random() * height * dy_factor) offset_image = Image.new('RGB', (width + dx, height + dy)) offset_image.paste(image, (dx, dy)) return offset_image
@staticmethod def _rotate(image, angle=25): """图像旋转""" return image.rotate(random.uniform(-angle, angle), Image.BILINEAR, expand=1)
def generate(self, captcha_text='', fmt='PNG'): """生成验证码(文字和图片) :param captcha_text: 验证码文字 :param fmt: 生成的验证码图片格式 :return: 验证码图片的二进制数据 """ self._image = Image.new('RGB', (self._width, self._height), (255, 255, 255)) self._background() self._text(captcha_text, self._fonts, drawings=['_warp', '_rotate', '_offset']) self._curve() self._noise() self._smooth() image_bytes = BytesIO() self._image.save(image_bytes, format=fmt) return image_bytes.getvalue()
def pascal_row(n=0): """生成毕达哥拉斯三角形(杨辉三角)""" result = [1] x, numerator = 1, n for denominator in range(1, n // 2 + 1): x *= numerator x /= denominator result.append(x) numerator -= 1 if n & 1 == 0: result.extend(reversed(result[:-1])) else: result.extend(reversed(result)) return result
def random_color(start=0, end=255, opacity=255): """获得随机颜色""" red = random.randint(start, end) green = random.randint(start, end) blue = random.randint(start, end) if opacity is None: return red, green, blue return red, green, blue, opacity说明:上面的代码中用到了三个字体文件,字体文件位于
polls/fonts目录下,大家可以自行添加字体文件,但是需要注意字体文件的文件名跟上面代码的第45行保持一致。
接下来,我们先完成提供验证码的视图函数。
def get_captcha(request: HttpRequest) -> HttpResponse: """验证码""" captcha_text = gen_random_code() request.session['captcha'] = captcha_text image_data = Captcha.instance().generate(captcha_text) return HttpResponse(image_data, content_type='image/png')注意上面代码中的第4行,我们将随机生成的验证码字符串保存到session中,稍后用户登录时,我们要将保存在session中的验证码字符串和用户输入的验证码字符串进行比对,如果用户输入了正确的验证码才能够执行后续的登录流程,代码如下所示。
def login(request: HttpRequest) -> HttpResponse: hint = '' if request.method == 'POST': username = request.POST.get('username') password = request.POST.get('password') if username and password: password = gen_md5_digest(password) user = User.objects.filter(username=username, password=password).first() if user: request.session['userid'] = user.no request.session['username'] = user.username return redirect('/') else: hint = '用户名或密码错误' else: hint = '请输入有效的用户名和密码' return render(request, 'login.html', {'hint': hint})说明:上面的代码没有对用户名和密码没有进行验证,实际项目中建议使用正则表达式验证用户输入信息,否则有可能将无效的数据交给数据库进行处理或者造成其他安全方面的隐患。
上面的代码中,我们设定了登录成功后会在session中保存用户的编号(userid)和用户名(username),页面会重定向到首页。接下来我们可以稍微对首页的代码进行调整,在页面的右上角显示出登录用户的用户名。我们将这段代码单独写成了一个名为header.html的HTML文件,首页中可以通过在<body>标签中添加{% include 'header.html' %}来包含这个页面,代码如下所示。
<div class="user"> {% if request.session.userid %} <span>{{ request.session.username }}</span> <a href="/logout">注销</a> {% else %} <a href="/login">登录</a> {% endif %} <a href="/register">注册</a></div>如果用户没有登录,页面会显示登录和注册的超链接;而用户登录成功后,页面上会显示用户名和注销的链接,注销链接对应的视图函数如下所示,URL的映射与之前讲过的类似,不再赘述。
def logout(request): """注销""" request.session.flush() return redirect('/')上面的代码通过session对象flush方法来销毁session,一方面清除了服务器上session对象保存的用户数据,一方面将保存在浏览器cookie中的sessionid删除掉,稍后我们会对如何读写cookie的操作加以说明。
我们可以通过项目使用的数据库中名为django_session 的表来找到所有的session,该表的结构如下所示:
| session_key | session_data | expire_date |
|---|---|---|
| c9g2gt5cxo0k2evykgpejhic5ae7bfpl | MmI4YzViYjJhOGMyMDJkY2M5Yzg3… | 2019-05-25 23:16:13.898522 |
其中,第1列就是浏览器cookie中保存的sessionid;第2列是经过BASE64编码后的session中的数据,如果使用Python的base64对其进行解码,解码的过程和结果如下所示。
import base64
base64.b64decode('MmI4YzViYjJhOGMyMDJkY2M5Yzg3ZWIyZGViZmUzYmYxNzdlNDdmZjp7ImNhcHRjaGEiOiJzS3d0Iiwibm8iOjEsInVzZXJuYW1lIjoiamFja2ZydWVkIn0=')第3列是session的过期时间,session过期后浏览器保存的cookie中的sessionid就会失效,但是数据库中的这条对应的记录仍然会存在,如果想清除过期的数据,可以使用下面的命令。
python manage.py clearsessionsDjango框架默认的session过期时间为两周(1209600秒),如果想修改这个时间,可以在项目的配置文件中添加如下所示的代码。
# 配置会话的超时时间为1天(86400秒)SESSION_COOKIE_AGE = 86400有很多对安全性要求较高的应用都必须在关闭浏览器窗口时让会话过期,不再保留用户的任何信息,如果希望在关闭浏览器窗口时就让会话过期(cookie中的sessionid失效),可以加入如下所示的配置。
# 设置为True在关闭浏览器窗口时session就过期SESSION_EXPIRE_AT_BROWSER_CLOSE = True如果不希望将session的数据保存在数据库中,可以将其放入缓存中,对应的配置如下所示,缓存的配置和使用我们在后面讲解。
# 配置将会话对象放到缓存中存储SESSION_ENGINE = 'django.contrib.sessions.backends.cache'# 配置使用哪一组缓存来保存会话SESSION_CACHE_ALIAS = 'default'如果要修改session数据默认的序列化方式,可以将默认的JSONSerializer修改为PickleSerializer。
SESSION_SERIALIZER = 'django.contrib.sessions.serializers.PickleSerializer'接下来,我们就可以限制只有登录用户才能为老师投票,修改后的praise_or_criticize函数如下所示,我们通过从request.session中获取userid来判定用户是否登录。
def praise_or_criticize(request: HttpRequest) -> HttpResponse: if request.session.get('userid'): try: tno = int(request.GET.get('tno')) teacher = Teacher.objects.get(no=tno) if request.path.startswith('/praise/'): teacher.good_count += 1 count = teacher.good_count else: teacher.bad_count += 1 count = teacher.bad_count teacher.save() data = {'code': 20000, 'mesg': '投票成功', 'count': count} except (ValueError, Teacher.DoesNotExist): data = {'code': 20001, 'mesg': '投票失败'} else: data = {'code': 20002, 'mesg': '请先登录'} return JsonResponse(data)当然,在修改了视图函数后,teachers.html也需要进行调整,用户如果没有登录,就将用户引导至登录页,登录成功再返回到投票页,此处不再赘述。
在视图函数中读写cookie
下面我们对如何使用cookie做一个更为细致的说明以便帮助大家在Web项目中更好的使用这项技术。Django封装的HttpRequest和HttpResponse对象分别提供了读写cookie的操作。
HttpRequest封装的属性和方法:
COOKIES属性 - 该属性包含了HTTP请求携带的所有cookie。get_signed_cookie方法 - 获取带签名的cookie,如果签名验证失败,会产生BadSignature异常。
HttpResponse封装的方法:
set_cookie方法 - 该方法可以设置一组键值对并将其最终将写入浏览器。set_signed_cookie方法 - 跟上面的方法作用相似,但是会对cookie进行签名来达到防篡改的作用。因为如果篡改了cookie中的数据,在不知道密钥和盐的情况下是无法生成有效的签名,这样服务器在读取cookie时会发现数据与签名不一致从而产生BadSignature异常。需要说明的是,这里所说的密钥就是我们在Django项目配置文件中指定的SECRET_KEY,而盐是程序中设定的一个字符串,你愿意设定为什么都可以,只要是一个有效的字符串。
上面提到的方法,如果不清楚它们的具体用法,可以自己查阅一下Django的官方文档,没有什么资料比官方文档能够更清楚的告诉你这些方法到底如何使用。
刚才我们说过了,激活SessionMiddleware之后,每个HttpRequest对象都会绑定一个session属性,它是一个类似字典的对象,除了保存用户数据之外还提供了检测浏览器是否支持cookie的方法,包括:
set_test_cookie方法 - 设置用于测试的cookie。test_cookie_worked方法 - 检测测试cookie是否工作。delete_test_cookie方法 - 删除用于测试的cookie。set_expiry方法 - 设置会话的过期时间。get_expire_age/get_expire_date方法 - 获取会话的过期时间。clear_expired方法 - 清理过期的会话。
下面是在执行登录之前检查浏览器是否支持cookie的代码。通常情况下,浏览器默认开启了对cookie的支持,但是可能因为某种原因,用户禁用了浏览器的cookie功能,遇到这种情况我们可以在视图函数中提供一个检查功能,如果检查到用户浏览器不支持cookie,可以给出相应的提示。
def login(request): if request.method == 'POST': if request.session.test_cookie_worked(): request.session.delete_test_cookie() # Add your code to perform login process here else: return HttpResponse("Please enable cookies and try again.") request.session.set_test_cookie() return render_to_response('login.html')Cookie的替代品
之前我们说过了,cookie的名声一直都不怎么好,当然我们在实际开发中是不会在cookie中保存用户的敏感信息(如用户的密码、信用卡的账号等)的,而且保存在cookie中的数据一般也会做好编码和签名的工作。对于支持HTML5的浏览器来说,可以使用localStorage和sessionStorage做为cookie的替代方案,相信从名字上你就能听出二者的差别,存储在localStorage的数据可以长期保留;而存储在sessionStorage的数据会在浏览器关闭时会被清除 。关于这些cookie替代品的用法,建议大家查阅MDN来进行了解。
50 制作报表
导出Excel报表
报表就是用表格、图表等格式来动态显示数据,所以有人用这样的公式来描述报表:
报表 = 多样的格式 + 动态的数据有很多的三方库支持在Python程序中写Excel文件,包括xlwt、xlwings、openpyxl、xlswriter等,其中的xlwt虽然只支持写xls格式的Excel文件,但在性能方面的表现还是不错的。下面我们就以xlwt为例,来演示如何在Django项目中导出Excel报表。
安装xlwt。
pip install xlwt导出包含所有老师信息的Excel表格的视图函数。
def export_teachers_excel(request): # 创建工作簿 wb = xlwt.Workbook() # 添加工作表 sheet = wb.add_sheet('老师信息表') # 查询所有老师的信息 queryset = Teacher.objects.all() # 向Excel表单中写入表头 colnames = ('姓名', '介绍', '好评数', '差评数', '学科') for index, name in enumerate(colnames): sheet.write(0, index, name) # 向单元格中写入老师的数据 props = ('name', 'detail', 'good_count', 'bad_count', 'subject') for row, teacher in enumerate(queryset): for col, prop in enumerate(props): value = getattr(teacher, prop, '') if isinstance(value, Subject): value = value.name sheet.write(row + 1, col, value) # 保存Excel buffer = BytesIO() wb.save(buffer) # 将二进制数据写入响应的消息体中并设置MIME类型 resp = HttpResponse(buffer.getvalue(), content_type='application/vnd.ms-excel') # 中文文件名需要处理成百分号编码 filename = quote('老师.xls') # 通过响应头告知浏览器下载该文件以及对应的文件名 resp['content-disposition'] = f'attachment; filename*=utf-8\'\'{filename}' return resp映射URL。
urlpatterns = [
path('excel/', views.export_teachers_excel),
]导出PDF报表
在Django项目中,如果需要导出PDF报表,可以借助三方库reportlab来生成PDF文件的内容,再将文件的二进制数据输出给浏览器并指定MIME类型为application/pdf,具体的代码如下所示。
def export_pdf(request: HttpRequest) -> HttpResponse: buffer = io.BytesIO() pdf = canvas.Canvas(buffer) pdf.setFont("Helvetica", 80) pdf.setFillColorRGB(0.2, 0.5, 0.3) pdf.drawString(100, 550, 'hello, world!') pdf.showPage() pdf.save() resp = HttpResponse(buffer.getvalue(), content_type='application/pdf') resp['content-disposition'] = 'inline; filename="demo.pdf"' return resp关于如何用reportlab定制PDF报表的内容,可以参考reportlab的官方文档。
生成前端统计图表
如果项目中需要生成前端统计图表,可以使用百度的ECharts。具体的做法是后端通过提供数据接口返回统计图表所需的数据,前端使用ECharts来渲染出柱状图、折线图、饼图、散点图等图表。例如我们要生成一个统计所有老师好评数和差评数的报表,可以按照下面的方式来做。
def get_teachers_data(request): queryset = Teacher.objects.all() names = [teacher.name for teacher in queryset] good_counts = [teacher.good_count for teacher in queryset] bad_counts = [teacher.bad_count for teacher in queryset] return JsonResponse({'names': names, 'good': good_counts, 'bad': bad_counts})映射URL。
urlpatterns = [ path('teachers_data/', views.get_teachers_data),]使用ECharts生成柱状图。
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8"> <title>老师评价统计</title></head><body> <div id="main" style="width: 600px; height: 400px"></div> <p> <a href="/">返回首页</a> </p> <script src="https://cdn.bootcss.com/echarts/4.2.1-rc1/echarts.min.js"></script> <script> var myChart = echarts.init(document.querySelector('#main')) fetch('/teachers_data/') .then(resp => resp.json()) .then(json => { var option = { color: ['#f00', '#00f'], title: { text: '老师评价统计图' }, tooltip: {}, legend: { data:['好评', '差评'] }, xAxis: { data: json.names }, yAxis: {}, series: [ { name: '好评', type: 'bar', data: json.good }, { name: '差评', type: 'bar', data: json.bad } ] } myChart.setOption(option) }) </script></body></html>运行效果如下图所示。
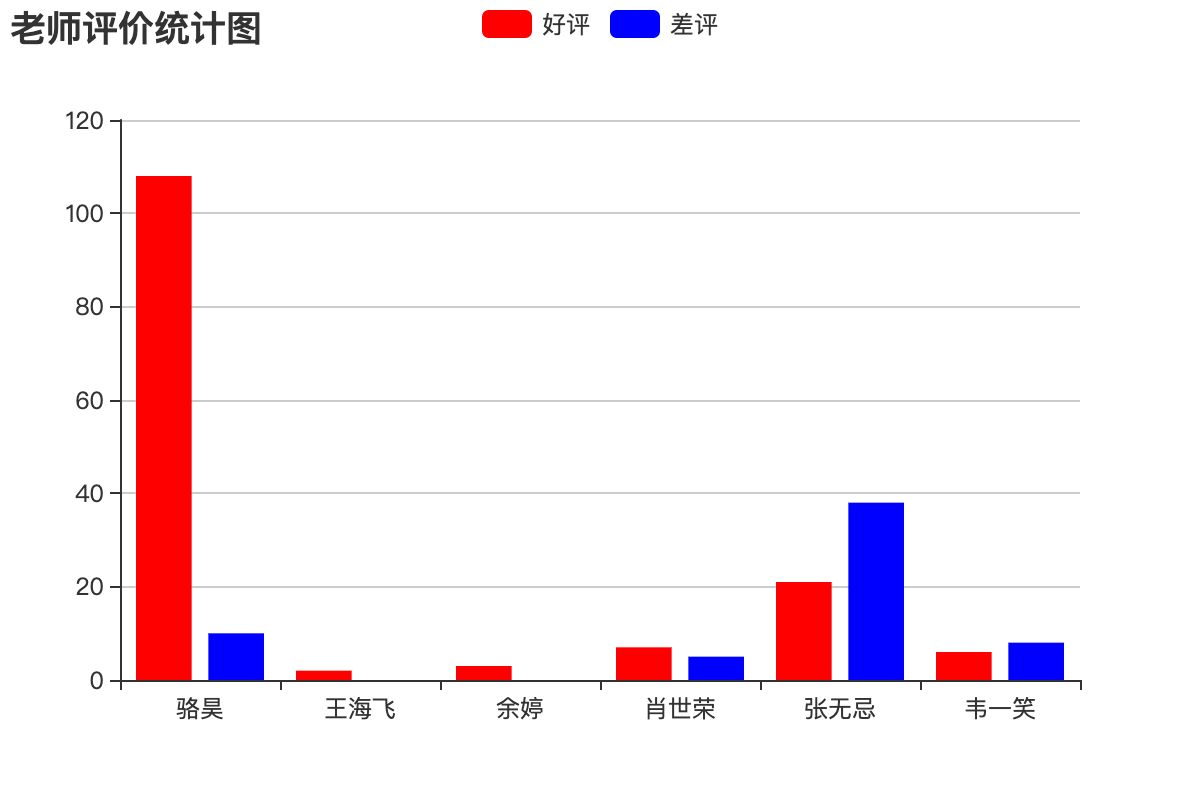
51 日志和调试工具栏
配置日志
项目开发阶段,显示足够的调试信息以辅助开发人员调试代码还是非常必要的;项目上线以后,将系统运行时出现的警告、错误等信息记录下来以备相关人员了解系统运行状况并维护代码也是很有必要的。与此同时,采集日志数据也是为网站做数字化运营奠定一个基础,通过对系统运行日志的分析,我们可以监测网站的流量以及流量分布,同时还可以挖掘出用户的使用习惯和行为模式。
接下来,我们先看看如何通过Django的配置文件来配置日志。Django的日志配置基本可以参照官方文档再结合项目实际需求来进行,这些内容基本上可以从官方文档上复制下来,然后进行局部的调整即可,下面给出一些参考配置。
LOGGING = { 'version': 1, # 是否禁用已经存在的日志器 'disable_existing_loggers': False, # 日志格式化器 'formatters': { 'simple': { 'format': '%(asctime)s %(module)s.%(funcName)s: %(message)s', 'datefmt': '%Y-%m-%d %H:%M:%S', }, 'verbose': { 'format': '%(asctime)s %(levelname)s [%(process)d-%(threadName)s] ' '%(module)s.%(funcName)s line %(lineno)d: %(message)s', 'datefmt': '%Y-%m-%d %H:%M:%S', } }, # 日志过滤器 'filters': { # 只有在Django配置文件中DEBUG值为True时才起作用 'require_debug_true': { '()': 'django.utils.log.RequireDebugTrue', }, }, # 日志处理器 'handlers': { # 输出到控制台 'console': { 'class': 'logging.StreamHandler', 'level': 'DEBUG', 'filters': ['require_debug_true'], 'formatter': 'simple', }, # 输出到文件(每周切割一次) 'file1': { 'class': 'logging.handlers.TimedRotatingFileHandler', 'filename': 'access.log', 'when': 'W0', 'backupCount': 12, 'formatter': 'simple', 'level': 'INFO', }, # 输出到文件(每天切割一次) 'file2': { 'class': 'logging.handlers.TimedRotatingFileHandler', 'filename': 'error.log', 'when': 'D', 'backupCount': 31, 'formatter': 'verbose', 'level': 'WARNING', }, }, # 日志器记录器 'loggers': { 'django': { # 需要使用的日志处理器 'handlers': ['console', 'file1', 'file2'], # 是否向上传播日志信息 'propagate': True, # 日志级别(不一定是最终的日志级别) 'level': 'DEBUG', }, }}大家可能已经注意到了,上面日志配置中的formatters是日志格式化器,它代表了如何格式化输出日志,其中格式占位符分别表示:
%(name)s- 记录器的名称%(levelno)s- 数字形式的日志记录级别%(levelname)s- 日志记录级别的文本名称%(filename)s- 执行日志记录调用的源文件的文件名称%(pathname)s- 执行日志记录调用的源文件的路径名称%(funcName)s- 执行日志记录调用的函数名称%(module)s- 执行日志记录调用的模块名称%(lineno)s- 执行日志记录调用的行号%(created)s- 执行日志记录的时间%(asctime)s- 日期和时间%(msecs)s- 毫秒部分%(thread)d- 线程ID(整数)%(threadName)s- 线程名称%(process)d- 进程ID (整数)
日志配置中的handlers用来指定日志处理器,简单的说就是指定将日志输出到控制台还是文件又或者是网络上的服务器,可用的处理器包括:
logging.StreamHandler(stream=None)- 可以向类似与sys.stdout或者sys.stderr的任何文件对象输出信息logging.FileHandler(filename, mode='a', encoding=None, delay=False)- 将日志消息写入文件logging.handlers.DatagramHandler(host, port)- 使用UDP协议,将日志信息发送到指定主机和端口的网络主机上logging.handlers.HTTPHandler(host, url)- 使用HTTP的GET或POST方法将日志消息上传到一台HTTP 服务器logging.handlers.RotatingFileHandler(filename, mode='a', maxBytes=0, backupCount=0, encoding=None, delay=False)- 将日志消息写入文件,如果文件的大小超出maxBytes指定的值,那么将重新生成一个文件来记录日志logging.handlers.SocketHandler(host, port)- 使用TCP协议,将日志信息发送到指定主机和端口的网络主机上logging.handlers.SMTPHandler(mailhost, fromaddr, toaddrs, subject, credentials=None, secure=None, timeout=1.0)- 将日志输出到指定的邮件地址logging.MemoryHandler(capacity, flushLevel=ERROR, target=None, flushOnClose=True)- 将日志输出到内存指定的缓冲区中
上面每个日志处理器都指定了一个名为level的属性,它代表了日志的级别,不同的日志级别反映出日志中记录信息的严重性。Python中定义了六个级别的日志,按照从低到高的顺序依次是:NOTSET、DEBUG、INFO、WARNING、ERROR、CRITICAL。
最后配置的日志记录器是用来真正输出日志的,Django框架提供了如下所示的内置记录器:
django- 在Django层次结构中的所有消息记录器django.request- 与请求处理相关的日志消息。5xx响应被视为错误消息;4xx响应被视为为警告消息django.server- 与通过runserver调用的服务器所接收的请求相关的日志消息。5xx响应被视为错误消息;4xx响应被记录为警告消息;其他一切都被记录为INFOdjango.template- 与模板渲染相关的日志消息django.db.backends- 有与数据库交互产生的日志消息,如果希望显示ORM框架执行的SQL语句,就可以使用该日志记录器。
日志记录器中配置的日志级别有可能不是最终的日志级别,因为还要参考日志处理器中配置的日志级别,取二者中级别较高者作为最终的日志级别。
配置Django-Debug-Toolbar
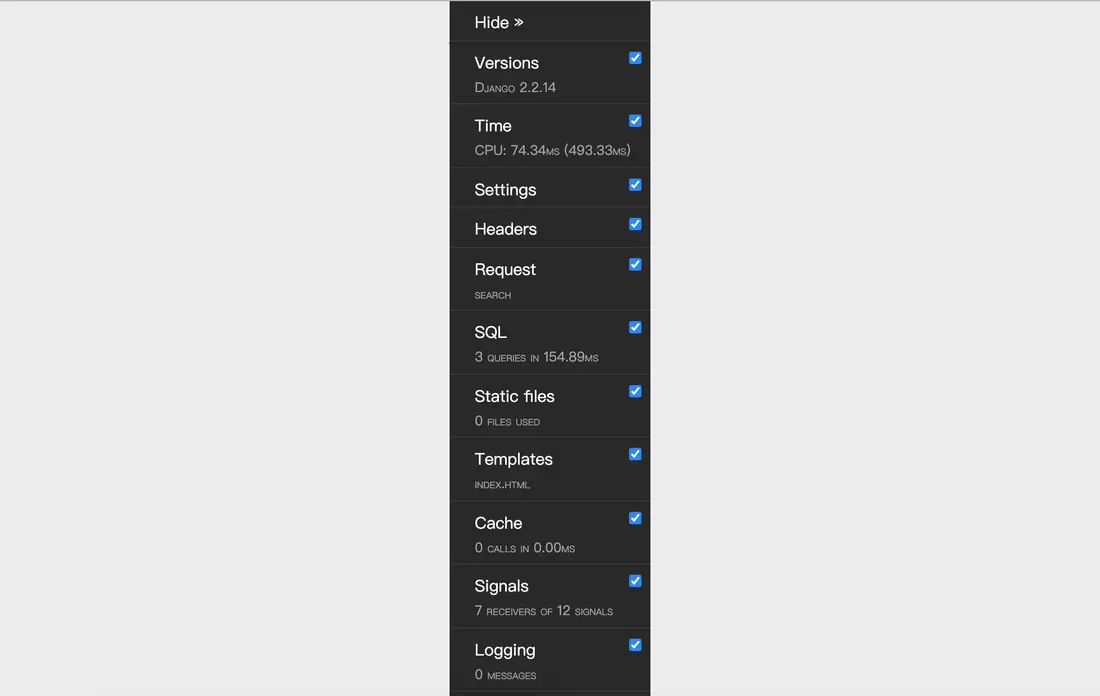
如果想调试你的Django项目,你一定不能不过名为Django-Debug-Toolbar的神器,它是项目开发阶段辅助调试和优化的必备工具,只要配置了它,就可以很方便的查看到如下表所示的项目运行信息,这些信息对调试项目和优化Web应用性能都是至关重要的。
| 项目 | 说明 |
|---|---|
| Versions | Django的版本 |
| Time | 显示视图耗费的时间 |
| Settings | 配置文件中设置的值 |
| Headers | HTTP请求头和响应头的信息 |
| Request | 和请求相关的各种变量及其信息 |
| StaticFiles | 静态文件加载情况 |
| Templates | 模板的相关信息 |
| Cache | 缓存的使用情况 |
| Signals | Django内置的信号信息 |
| Logging | 被记录的日志信息 |
| SQL | 向数据库发送的SQL语句及其执行时间 |
-
安装Django-Debug-Toolbar。
Terminal window pip install django-debug-toolbar -
配置 - 修改settings.py。
INSTALLED_APPS = ['debug_toolbar',]MIDDLEWARE = ['debug_toolbar.middleware.DebugToolbarMiddleware',]DEBUG_TOOLBAR_CONFIG = {# 引入jQuery库'JQUERY_URL': 'https://cdn.bootcss.com/jquery/3.3.1/jquery.min.js',# 工具栏是否折叠'SHOW_COLLAPSED': True,# 是否显示工具栏'SHOW_TOOLBAR_CALLBACK': lambda x: True,} -
配置 - 修改urls.py。
if settings.DEBUG:import debug_toolbarurlpatterns.insert(0, path('__debug__/', include(debug_toolbar.urls))) -
在配置好Django-Debug-Toolbar之后,页面右侧会看到一个调试工具栏,如下图所示,上面包括了如前所述的各种调试信息,包括执行时间、项目设置、请求头、SQL、静态资源、模板、缓存、信号等,查看起来非常的方便。
优化ORM代码
在配置了日志或Django-Debug-Toolbar之后,我们可以查看一下之前将老师数据导出成Excel报表的视图函数执行情况,这里我们关注的是ORM框架生成的SQL查询到底是什么样子的,相信这里的结果会让你感到有一些意外。执行Teacher.objects.all()之后我们可以注意到,在控制台看到的或者通过Django-Debug-Toolbar输出的SQL是下面这样的:
SELECT `tb_teacher`.`no`, `tb_teacher`.`name`, `tb_teacher`.`detail`, `tb_teacher`.`photo`, `tb_teacher`.`good_count`, `tb_teacher`.`bad_count`, `tb_teacher`.`sno` FROM `tb_teacher`; args=()SELECT `tb_subject`.`no`, `tb_subject`.`name`, `tb_subject`.`intro`, `tb_subject`.`create_date`, `tb_subject`.`is_hot` FROM `tb_subject` WHERE `tb_subject`.`no` = 101; args=(101,)SELECT `tb_subject`.`no`, `tb_subject`.`name`, `tb_subject`.`intro`, `tb_subject`.`create_date`, `tb_subject`.`is_hot` FROM `tb_subject` WHERE `tb_subject`.`no` = 101; args=(101,)SELECT `tb_subject`.`no`, `tb_subject`.`name`, `tb_subject`.`intro`, `tb_subject`.`create_date`, `tb_subject`.`is_hot` FROM `tb_subject` WHERE `tb_subject`.`no` = 101; args=(101,)SELECT `tb_subject`.`no`, `tb_subject`.`name`, `tb_subject`.`intro`, `tb_subject`.`create_date`, `tb_subject`.`is_hot` FROM `tb_subject` WHERE `tb_subject`.`no` = 101; args=(101,)SELECT `tb_subject`.`no`, `tb_subject`.`name`, `tb_subject`.`intro`, `tb_subject`.`create_date`, `tb_subject`.`is_hot` FROM `tb_subject` WHERE `tb_subject`.`no` = 103; args=(103,)SELECT `tb_subject`.`no`, `tb_subject`.`name`, `tb_subject`.`intro`, `tb_subject`.`create_date`, `tb_subject`.`is_hot` FROM `tb_subject` WHERE `tb_subject`.`no` = 103; args=(103,)这里的问题通常被称为“1+N查询”(有的地方也将其称之为“N+1查询”),原本获取老师的数据只需要一条SQL,但是由于老师关联了学科,当我们查询到N条老师的数据时,Django的ORM框架又向数据库发出了N条SQL去查询老师所属学科的信息。每条SQL执行都会有较大的开销而且会给数据库服务器带来压力,如果能够在一条SQL中完成老师和学科的查询肯定是更好的做法,这一点也很容易做到,相信大家已经想到怎么做了。是的,我们可以使用连接查询,但是在使用Django的ORM框架时如何做到这一点呢?对于多对一关联(如投票应用中的老师和学科),我们可以使用QuerySet的用select_related()方法来加载关联对象;而对于多对多关联(如电商网站中的订单和商品),我们可以使用prefetch_related()方法来加载关联对象。
在导出老师Excel报表的视图函数中,我们可以按照下面的方式优化代码。
queryset = Teacher.objects.all().select_related('subject')事实上,用ECharts生成前端报表的视图函数中,查询老师好评和差评数据的操作也能够优化,因为在这个例子中,我们只需要获取老师的姓名、好评数和差评数这三项数据,但是在默认的情况生成的SQL会查询老师表的所有字段。可以用QuerySet的only()方法来指定需要查询的属性,也可以用QuerySet的defer()方法来指定暂时不需要查询的属性,这样生成的SQL会通过投影操作来指定需要查询的列,从而改善查询性能,代码如下所示:
queryset = Teacher.objects.all().only('name', 'good_count', 'bad_count')当然,如果要统计出每个学科的老师好评和差评的平均数,利用Django的ORM框架也能够做到,代码如下所示:
queryset = Teacher.objects.values('subject').annotate(good=Avg('good_count'), bad=Avg('bad_count'))这里获得的QuerySet中的元素是字典对象,每个字典中有三组键值对,分别是代表学科编号的subject、代表好评数的good和代表差评数的bad。如果想要获得学科的名称而不是编号,可以按照如下所示的方式调整代码:
queryset = Teacher.objects.values('subject__name').annotate(good=Avg('good_count'), bad=Avg('bad_count'))可见,Django的ORM框架允许我们用面向对象的方式完成关系数据库中的分组和聚合查询。
52 中间件的应用
之前我们已经实现了用户必须登录才能投票的限制,但是一个新的问题来了。如果我们的应用中有很多功能都需要用户先登录才能执行,例如将前面导出Excel报表和查看统计图表的功能都做了必须登录才能访问的限制,那么我们是不是需要在每个视图函数中添加代码来检查session中是否包含userid的代码呢?答案是否定的,如果这样做了,我们的视图函数中必然会充斥着大量的重复代码。编程大师Martin Fowler曾经说过:代码有很多种坏味道,重复是最坏的一种。在Python程序中,我们可以通过装饰器来为函数提供额外的能力;在Django项目中,我们可以把类似于验证用户是否登录这样的重复性代码放到中间件中。
Django中间件概述
中间件是安插在Web应用请求和响应过程之间的组件,它在整个Web应用中扮演了拦截过滤器的角色,通过中间件可以拦截请求和响应,并对请求和响应进行过滤(简单的说就是执行额外的处理)。通常,一个中间件组件只专注于完成一件特定的事,例如:Django框架通过SessionMiddleware中间件实现了对session的支持,又通过AuthenticationMiddleware中间件实现了基于session的请求认证。通过把多个中间件组合在一起,我们可以完成更为复杂的任务,Django框架就是这么做的。
Django项目的配置文件中就包含了对中间件的配置,代码如下所示。
MIDDLEWARE = [ 'django.middleware.security.SecurityMiddleware', 'django.contrib.sessions.middleware.SessionMiddleware', 'django.middleware.common.CommonMiddleware', 'django.middleware.csrf.CsrfViewMiddleware', 'django.contrib.auth.middleware.AuthenticationMiddleware', 'django.contrib.messages.middleware.MessageMiddleware', 'django.middleware.clickjacking.XFrameOptionsMiddleware',]我们稍微为大家解释一下这些中间件的作用:
CommonMiddleware- 基础设置中间件,可以处理以下一些配置参数。- DISALLOWED_USER_AGENTS - 不被允许的用户代理(浏览器)
- APPEND_SLASH - 是否追加
/ - USE_ETAG - 浏览器缓存相关
SecurityMiddleware- 安全相关中间件,可以处理和安全相关的配置项。- SECURE_HSTS_SECONDS - 强制使用HTTPS的时间
- SECURE_HSTS_INCLUDE_SUBDOMAINS - HTTPS是否覆盖子域名
- SECURE_CONTENT_TYPE_NOSNIFF - 是否允许浏览器推断内容类型
- SECURE_BROWSER_XSS_FILTER - 是否启用跨站脚本攻击过滤器
- SECURE_SSL_REDIRECT - 是否重定向到HTTPS连接
- SECURE_REDIRECT_EXEMPT - 免除重定向到HTTPS
SessionMiddleware- 会话中间件。CsrfViewMiddleware- 通过生成令牌,防范跨请求份伪的造中间件。XFrameOptionsMiddleware- 通过设置请求头参数,防范点击劫持攻击的中间件。
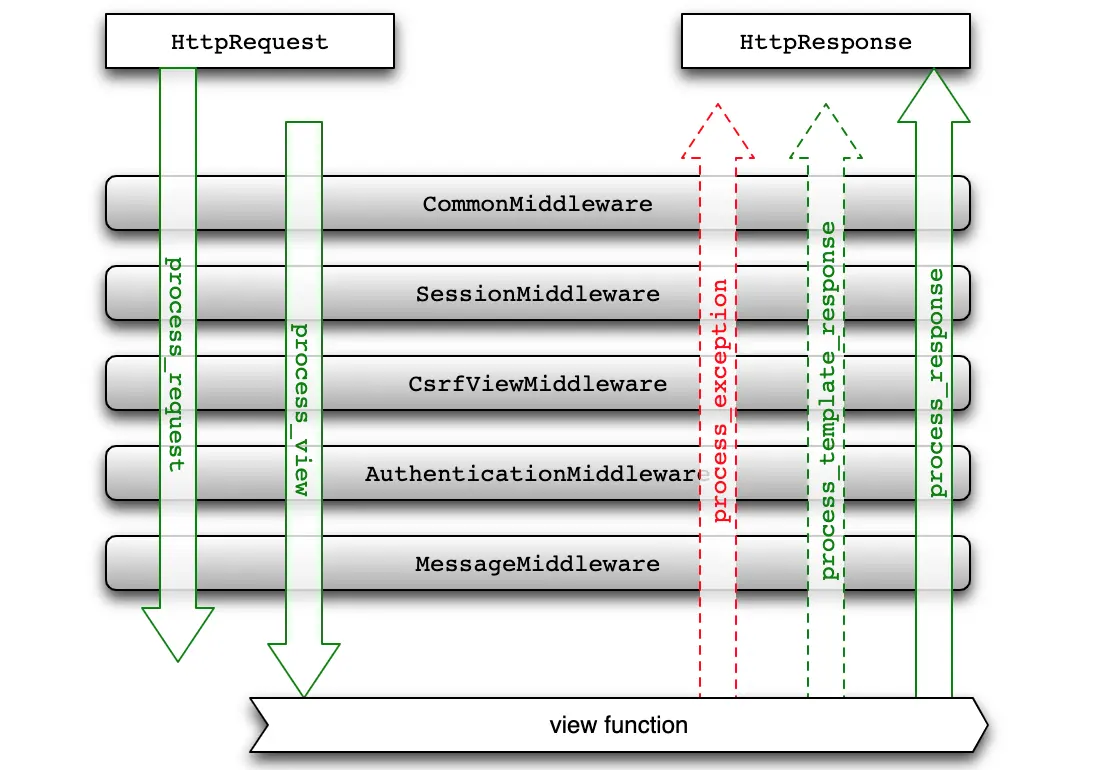
在请求的过程中,上面的中间件会按照书写的顺序从上到下执行,然后是URL解析,最后请求才会来到视图函数;在响应的过程中,上面的中间件会按照书写的顺序从下到上执行,与请求时中间件执行的顺序正好相反。
自定义中间件
Django中的中间件有两种实现方式:基于类的实现方式和基于函数的实现方式,后者更接近于装饰器的写法。装饰器实际上是代理模式的应用,将横切关注功能(与正常业务逻辑没有必然联系的功能,例如:身份认证、日志记录、编码转换之类的功能)置于代理中,由代理对象来完成被代理对象的行为并添加额外的功能。中间件对用户请求和响应进行拦截过滤并增加额外的处理,在这一点上它跟装饰器是完全一致的,所以基于函数的写法来实现中间件就跟装饰器的写法几乎一模一样。下面我们用自定义的中间件来实现用户登录验证的功能。
"""middlewares.py"""from django.http import JsonResponsefrom django.shortcuts import redirect
# 需要登录才能访问的资源路径LOGIN_REQUIRED_URLS = {'/praise/', '/criticize/', '/excel/', '/teachers_data/'}
def check_login_middleware(get_resp):
def wrapper(request, *args, **kwargs): # 请求的资源路径在上面的集合中 if request.path in LOGIN_REQUIRED_URLS: # 会话中包含userid则视为已经登录 if 'userid' not in request.session: # 判断是不是Ajax请求 if request.is_ajax(): # Ajax请求返回JSON数据提示用户登录 return JsonResponse({'code': 10003, 'hint': '请先登录'}) else: backurl = request.get_full_path() # 非Ajax请求直接重定向到登录页 return redirect(f'/login/?backurl={backurl}') return get_resp(request, *args, **kwargs)
return wrapper当然,我们也可以定义一个类来充当装饰器,如果类中有__call__魔术方法,这个类的对象就像函数一样可调用,所以下面是另一种实现中间件的方式,道理跟上面的代码完全一样。
还有一种基于类实现中间件的方式,这种方式在较新版本的Django中已经不推荐使用了,但是大家接触到的代码中,仍然有可能遇到这种写法,大致的代码如下所示。
from django.utils.deprecation import MiddlewareMixin
class MyMiddleware(MiddlewareMixin):
def process_request(self, request): pass
def process_view(self, request, view_func, view_args, view_kwargs): pass
def process_template_response(self, request, response): pass
def process_response(self, request, response): pass
def process_exception(self, request, exception): pass上面类中的五个方法都是中间件的钩子函数,分别在收到用户请求、进入视图函数之前、渲染模板、返回响应和出现异常的时候被回调。当然,写不写这些方法是根据中间件的需求来确定的,并不是所有的场景都需要重写五个方法,下面的图相信能够帮助大家理解这种写法。
写好中间件代码后,需要修改配置文件来激活中间件使其生效。
MIDDLEWARE = [ 'django.middleware.security.SecurityMiddleware', 'django.contrib.sessions.middleware.SessionMiddleware', 'django.middleware.common.CommonMiddleware', 'django.middleware.csrf.CsrfViewMiddleware', 'django.contrib.auth.middleware.AuthenticationMiddleware', 'django.contrib.messages.middleware.MessageMiddleware', 'django.middleware.clickjacking.XFrameOptionsMiddleware', 'debug_toolbar.middleware.DebugToolbarMiddleware', 'vote.middlewares.check_login_middleware',]注意上面这个中间件列表中元素的顺序,当收到来自用户的请求时,中间件按照从上到下的顺序依次执行,这行完这些中间件以后,请求才会最终到达视图函数。当然,在这个过程中,用户的请求可以被拦截,就像上面我们自定义的中间件那样,如果用户在没有登录的情况下访问了受保护的资源,中间件会将请求直接重定向到登录页,后面的中间件和视图函数将不再执行。在响应用户请求的过程中,上面的中间件会按照从下到上的顺序依次执行,这样的话我们还可以对响应做进一步的处理。
中间件执行的顺序是非常重要的,对于有依赖关系的中间件必须保证被依赖的中间件要置于依赖它的中间件的前面,就好比我们刚才自定义的中间件要放到SessionMiddleware的后面,因为我们要依赖这个中间件为请求绑定的session对象才能判定用户是否登录。
53 前后端分离开发入门
在传统的Web应用开发中,大多数的程序员会将浏览器作为前后端的分界线。将浏览器中为用户进行页面展示的部分称之为前端,而将运行在服务器为前端提供业务逻辑和数据准备的所有代码统称为后端。所谓前后端分离的开发,就是前后端工程师约定好数据交互接口,并行的进行开发和测试,后端只提供数据,不负责将数据渲染到页面上,前端通过HTTP请求获取数据并负责将数据渲染到页面上,这个工作是交给浏览器中的JavaScript代码来完成。
使用前后端分离开发有诸多的好处,下面我们简要的说下这些好处:
- 提升开发效率。前后端分离以后,可以实现前后端代码的解耦,只要前后端沟通约定好应用所需接口以及接口参数,便可以开始并行开发,无需等待对方的开发工作结束。在这种情况下,前后端工程师都可以只专注于自己的开发工作,有助于打造出更好的团队。除此之外,在前后端分离的开发模式下,即使需求发生变更,只要接口与数据格式不变,后端开发人员就不需要修改代码,只要前端进行变动即可。
- 增强代码的可维护性。前后端分离后,应用的代码不再是前后端混合,只有在运行期才会有调用依赖关系,这样的话维护代码的工作将变得轻松愉快很多,再不会牵一发而动全身。当你的代码变得简明且整洁时,代码的可读性和可维护性都会有质的提升。
- 支持多终端和服务化架构。前后端分离后,同一套数据接口可以为不同的终端提供服务,更有助于打造多终端应用;此外,由于后端提供的接口之间可以通过HTTP(S)进行调用,有助于打造服务化架构(包括微服务)。
接下来我们就用前后端分离的方式来改写之前的投票应用。
返回JSON格式的数据
刚才说过,在前后端分离的开发模式下,后端需要为前端提供数据接口,这些接口通常返回JSON格式的数据。在Django项目中,我们可以先将对象处理成字典,然后就可以利用Django封装的JsonResponse向浏览器返回JSON格式的数据,具体的做法如下所示。
def show_subjects(request): queryset = Subject.objects.all() subjects = [] for subject in queryset: subjects.append({ 'no': subject.no, 'name': subject.name, 'intro': subject.intro, 'isHot': subject.is_hot }) return JsonResponse(subjects, safe=False)上面的代码中,我们通过循环遍历查询学科得到的QuerySet对象,将每个学科的数据处理成一个字典,在将字典保存在名为subjects的列表容器中,最后利用JsonResponse完成对列表的序列化,向浏览器返回JSON格式的数据。由于JsonResponse序列化的是一个列表而不是字典,所以需要指定safe参数的值为False才能完成对subjects的序列化,否则会产生TypeError异常。
可能大家已经发现了,自己写代码将一个对象转成字典是比较麻烦的,如果对象的属性很多而且某些属性又关联到一个比较复杂的对象时,情况会变得更加糟糕。为此我们可以使用一个名为bpmappers的三方库来简化将对象转成字典的操作,这个三方库本身也提供了对Django框架的支持。
安装三方库bpmappers。
pip install bpmappers编写映射器(实现对象到字典转换)。
from bpmappers.djangomodel import ModelMapper
from poll2.models import Subject
class SubjectMapper(ModelMapper):
class Meta: model = Subject修改视图函数。
def show_subjects(request): queryset = Subject.objects.all() subjects = [] for subject in queryset: subjects.append(SubjectMapper(subject).as_dict()) return JsonResponse(subjects, safe=False)配置URL映射。
urlpatterns = [
path('api/subjects/', show_subjects),
]然后访问该接口,可以得到如下所示的JSON格式数据。
[ { "no": 1, "name": "Python全栈+人工智能", "intro": "Python是一种计算机程序设计语言。是一种面向对象的动态类型语言,最初被设计用于编写自动化脚本(shell),随着版本的不断更新和语言新功能的添加,越来越多被用于独立的、大型项目的开发。", "is_hot": true }, // 此处省略下面的内容]如果不希望在JSON数据中显示学科的成立时间,我们可以在映射器中排除create_date属性;如果希望将是否为热门学科对应的键取名为isHot(默认的名字是is_hot),也可以通过修改映射器来做到。具体的做法如下所示:
from bpmappers import RawFieldfrom bpmappers.djangomodel import ModelMapper
from poll2.models import Subject
class SubjectMapper(ModelMapper): isHot = RawField('is_hot')
class Meta: model = Subject exclude = ('is_hot', )再次查看学科接口返回的JSON数据。
[ { "no": 101, "name": "Python全栈+人工智能", "intro": "Python是一种计算机程序设计语言。是一种面向对象的动态类型语言,最初被设计用于编写自动化脚本(shell),随着版本的不断更新和语言新功能的添加,越来越多被用于独立的、大型项目的开发。", "isHot": true }, // 此处省略下面的内容]关于bpmappers详细的使用指南,请参考它的官方文档,这个官方文档是用日语书写的,可以使用浏览器的翻译功能将它翻译成你熟悉的语言即可。
使用Vue.js渲染页面
接下来我们通过前端框架Vue.js来实现页面的渲染。如果希望全面的了解和学习Vue.js,建议阅读它的官方教程或者在YouTube上搜索Vue.js的新手教程(Vue.js Crash Course)进行学习。
重新改写subjects.html页面,使用Vue.js来渲染页面。
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8"> <title>学科信息</title> <style> /* 此处省略层叠样式表 */ </style></head><body> <div id="container"> <h1>扣丁学堂所有学科</h1> <hr> <div id="main"> <dl v-for="subject in subjects"> <dt> <a :href="'/static/html/teachers.html?sno=' + subject.no"> {{ subject.name }} </a> <img v-if="subject.is_hot" src="/static/images/hot-icon-small.png"> </dt> <dd>{{ subject.intro }}</dd> </dl> </div> </div> <script src="https://cdn.bootcdn.net/ajax/libs/vue/2.6.11/vue.min.js"></script> <script> let app = new Vue({ el: '#main', data: { subjects: [] }, created() { fetch('/api/subjects/') .then(resp => resp.json()) .then(json => { this.subjects = json }) } }) </script></body></html>前后端分离的开发需要将前端页面作为静态资源进行部署,项目实际上线的时候,我们会对整个Web应用进行动静分离,静态资源通过Nginx或Apache服务器进行部署,生成动态内容的Python程序部署在uWSGI或者Gunicorn服务器上,对动态内容的请求由Nginx或Apache路由到uWSGI或Gunicorn服务器上。
在开发阶段,我们通常会使用Django自带的测试服务器,如果要尝试前后端分离,可以先将静态页面放在之前创建的放静态资源的目录下,具体的做法可以参考项目完整代码。
54 RESTful架构和DRF入门
把软件(Software)、平台(Platform)、基础设施(Infrastructure)做成服务(Service)是很多IT企业都一直在做的事情,这就是大家经常听到的SasS(软件即服务)、PasS(平台即服务)和IasS(基础设置即服务)。实现面向服务的架构(SOA)有诸多的方式,包括RPC(远程过程调用)、Web Service、REST等,在技术层面上,SOA是一种抽象的、松散耦合的粗粒度软件架构;在业务层面上,SOA的核心概念是“重用”和“互操作”,它将系统资源整合成可操作的、标准的服务,使得这些资源能够被重新组合和应用。在实现SOA的诸多方案中,REST被认为是最适合互联网应用的架构,符合REST规范的架构也经常被称作RESTful架构。
REST概述
REST这个词,是Roy Thomas Fielding在他2000年的博士论文中提出的,Roy是HTTP协议(1.0和1.1版)的主要设计者、Apache服务器软件主要作者、Apache基金会第一任主席。在他的博士论文中,Roy把他对互联网软件的架构原则定名为REST,即REpresentational State Transfer的缩写,中文通常翻译为“表现层状态转移”或“表述状态转移”。
这里的“表现层”其实指的是“资源”的“表现层”。所谓资源,就是网络上的一个实体,或者说是网络上的一个具体信息。它可以是一段文本、一张图片、一首歌曲或一种服务。我们可以用一个URI(统一资源定位符)指向资源,要获取到这个资源,访问它的URI即可,URI就是资源在互联网上的唯一标识。资源可以有多种外在表现形式。我们把资源具体呈现出来的形式,叫做它的“表现层”。比如,文本可以用text/plain格式表现,也可以用text/html格式、text/xml格式、application/json格式表现,甚至可以采用二进制格式;图片可以用image/jpeg格式表现,也可以用image/png格式表现。URI只代表资源的实体,不代表它的表现形式。严格地说,有些网址最后的.html后缀名是不必要的,因为这个后缀名表示格式,属于“表现层”范畴,而URI应该只代表“资源”的位置,它的具体表现形式,应该在HTTP请求的头信息中用Accept和Content-Type字段指定,这两个字段才是对“表现层”的描述。
访问一个网站,就代表了客户端和服务器的一个互动过程。在这个过程中,势必涉及到数据和状态的变化。Web应用通常使用HTTP作为其通信协议,客户端想要操作服务器,必须通过HTTP请求,让服务器端发生“状态转移”,而这种转移是建立在表现层之上的,所以就是“表现层状态转移”。客户端通过HTTP的动词GET、POST、PUT(或PATCH)、DELETE,分别对应对资源的四种基本操作,其中GET用来获取资源,POST用来新建资源(也可以用于更新资源),PUT(或PATCH)用来更新资源,DELETE用来删除资源。
简单的说RESTful架构就是:“每一个URI代表一种资源,客户端通过四个HTTP动词,对服务器端资源进行操作,实现资源的表现层状态转移”。
我们在设计Web应用时,如果需要向客户端提供资源,就可以使用REST风格的URI,这是实现RESTful架构的第一步。当然,真正的RESTful架构并不只是URI符合REST风格,更为重要的是“无状态”和“幂等性”两个词,我们在后面的课程中会为大家阐述这两点。下面的例子给出了一些符合REST风格的URI,供大家在设计URI时参考。
| 请求方法(HTTP动词) | URI | 解释 |
|---|---|---|
| GET | /students/ | 获取所有学生 |
| POST | /students/ | 新建一个学生 |
| GET | /students/ID/ | 获取指定ID的学生信息 |
| PUT | /students/ID/ | 更新指定ID的学生信息(提供该学生的全部信息) |
| PATCH | /students/ID/ | 更新指定ID的学生信息(提供该学生的部分信息) |
| DELETE | /students/ID/ | 删除指定ID的学生信息 |
| GET | /students/ID/friends/ | 列出指定ID的学生的所有朋友 |
| DELETE | /students/ID/friends/ID/ | 删除指定ID的学生的指定ID的朋友 |
DRF使用入门
在Django项目中,如果要实现REST架构,即将网站的资源发布成REST风格的API接口,可以使用著名的三方库djangorestframework ,我们通常将其简称为DRF。
安装和配置DRF
安装DRF。
pip install djangorestframework配置DRF。
INSTALLED_APPS = [
'rest_framework',
]
# 下面的配置根据项目需要进行设置REST_FRAMEWORK = { # 配置默认页面大小 # 'PAGE_SIZE': 10, # 配置默认的分页类 # 'DEFAULT_PAGINATION_CLASS': '...', # 配置异常处理器 # 'EXCEPTION_HANDLER': '...', # 配置默认解析器 # 'DEFAULT_PARSER_CLASSES': ( # 'rest_framework.parsers.JSONParser', # 'rest_framework.parsers.FormParser', # 'rest_framework.parsers.MultiPartParser', # ), # 配置默认限流类 # 'DEFAULT_THROTTLE_CLASSES': ( # '...' # ), # 配置默认授权类 # 'DEFAULT_PERMISSION_CLASSES': ( # '...', # ), # 配置默认认证类 # 'DEFAULT_AUTHENTICATION_CLASSES': ( # '...', # ),}编写序列化器
前后端分离的开发需要后端为前端、移动端提供API数据接口,而API接口通常情况下都是返回JSON格式的数据,这就需要对模型对象进行序列化处理。DRF中封装了Serializer类和ModelSerializer类用于实现序列化操作,通过继承Serializer类或ModelSerializer类,我们可以自定义序列化器,用于将对象处理成字典,代码如下所示。
from rest_framework import serializers
class SubjectSerializer(serializers.ModelSerializer):
class Meta: model = Subject fields = '__all__'上面的代码直接继承了ModelSerializer,通过Meta类的model属性指定要序列化的模型以及fields属性指定需要序列化的模型字段,稍后我们就可以在视图函数中使用该类来实现对Subject模型的序列化。
编写视图函数
DRF框架支持两种实现数据接口的方式,一种是FBV(基于函数的视图),另一种是CBV(基于类的视图)。我们先看看FBV的方式如何实现数据接口,代码如下所示。
from rest_framework.decorators import api_viewfrom rest_framework.response import Response
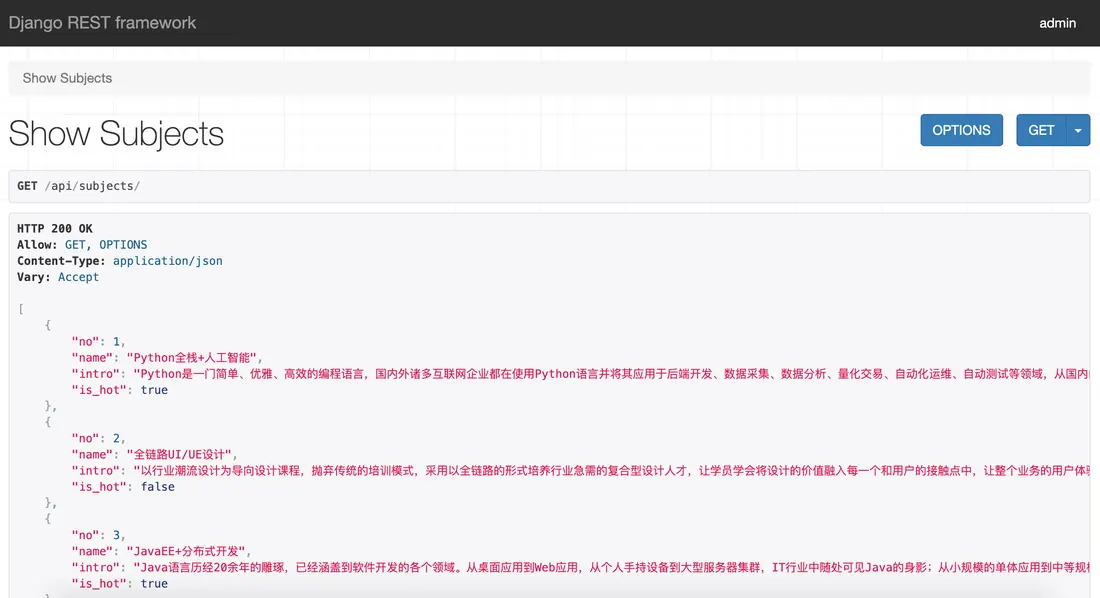
@api_view(('GET', ))def show_subjects(request: HttpRequest) -> HttpResponse: subjects = Subject.objects.all().order_by('no') # 创建序列化器对象并指定要序列化的模型 serializer = SubjectSerializer(subjects, many=True) # 通过序列化器的data属性获得模型对应的字典并通过创建Response对象返回JSON格式的数据 return Response(serializer.data)对比上一个章节的使用bpmapper实现模型序列化的代码,使用DRF的代码更加简单明了,而且DRF本身自带了一套页面,可以方便我们查看我们使用DRF定制的数据接口,如下图所示。
直接使用上一节写好的页面,就可以通过Vue.js把上面接口提供的学科数据渲染并展示出来,此处不再进行赘述。
实现老师信息数据接口
编写序列化器。
class SubjectSimpleSerializer(serializers.ModelSerializer):
class Meta: model = Subject fields = ('no', 'name')
class TeacherSerializer(serializers.ModelSerializer):
class Meta: model = Teacher exclude = ('subject', )编写视图函数。
@api_view(('GET', ))def show_teachers(request: HttpRequest) -> HttpResponse: try: sno = int(request.GET.get('sno')) subject = Subject.objects.only('name').get(no=sno) teachers = Teacher.objects.filter(subject=subject).defer('subject').order_by('no') subject_seri = SubjectSimpleSerializer(subject) teacher_seri = TeacherSerializer(teachers, many=True) return Response({'subject': subject_seri.data, 'teachers': teacher_seri.data}) except (TypeError, ValueError, Subject.DoesNotExist): return Response(status=404)配置URL映射。
urlpatterns = [
path('api/teachers/', show_teachers),
]通过Vue.js渲染页面。
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8"> <title>老师信息</title> <style> /* 此处省略掉层叠样式表 */ </style></head><body> <div id="container"> <h1>{{ subject.name }}学科的老师信息</h1> <hr> <h2 v-if="loaded && teachers.length == 0">暂无该学科老师信息</h2> <div class="teacher" v-for="teacher in teachers"> <div class="photo"> <img :src="'/static/images/' + teacher.photo" height="140" alt=""> </div> <div class="info"> <div> <span><strong>姓名:{{ teacher.name }}</strong></span> <span>性别:{{ teacher.sex | maleOrFemale }}</span> <span>出生日期:{{ teacher.birth }}</span> </div> <div class="intro">{{ teacher.intro }}</div> <div class="comment"> <a href="" @click.prevent="vote(teacher, true)">好评</a> (<strong>{{ teacher.good_count }}</strong>) <a href="" @click.prevent="vote(teacher, false)">差评</a> (<strong>{{ teacher.bad_count }}</strong>) </div> </div> </div> <a href="/static/html/subjects.html">返回首页</a> </div> <script src="https://cdn.bootcdn.net/ajax/libs/vue/2.6.11/vue.min.js"></script> <script> let app = new Vue({ el: '#container', data: { subject: {}, teachers: [], loaded: false }, created() { fetch('/api/teachers/' + location.search) .then(resp => resp.json()) .then(json => { this.subject = json.subject this.teachers = json.teachers }) }, filters: { maleOrFemale(sex) { return sex? '男': '女' } }, methods: { vote(teacher, flag) { let url = flag? '/praise/' : '/criticize/' url += '?tno=' + teacher.no fetch(url).then(resp => resp.json()).then(json => { if (json.code === 10000) { if (flag) { teacher.good_count = json.count } else { teacher.bad_count = json.count } } }) } } }) </script></body></html>前后端分离下的用户登录
之前我们提到过, HTTP是无状态的,一次请求结束连接断开,下次服务器再收到请求,它就不知道这个请求是哪个用户发过来的。但是对于一个Web应用而言,它是需要有状态管理的,这样才能让服务器知道HTTP请求来自哪个用户,从而判断是否允许该用户请求以及为用户提供更好的服务,这个过程就是常说的会话管理。
之前我们做会话管理(用户跟踪)的方法是:用户登录成功后,在服务器端通过一个session对象保存用户相关数据,然后把session对象的ID写入浏览器的cookie中;下一次请求时,HTTP请求头中携带cookie的数据,服务器从HTTP请求头读取cookie中的sessionid,根据这个标识符找到对应的session对象,这样就能够获取到之前保存在session中的用户数据。我们刚才说过,REST架构是最适合互联网应用的架构,它强调了HTTP的无状态性,这样才能保证应用的水平扩展能力(当并发访问量增加时,可以通过增加新的服务器节点来为系统扩容)。显然,基于session实现用户跟踪的方式需要服务器保存session对象,在做水平扩展增加新的服务器节点时,需要复制和同步session对象,这显然是非常麻烦的。解决这个问题有两种方案,一种是架设缓存服务器(如Redis),让多个服务器节点共享缓存服务并将session对象直接置于缓存服务器中;另一种方式放弃基于session的用户跟踪,使用基于token的用户跟踪。
基于token的用户跟踪是在用户登录成功后,为用户生成身份标识并保存在浏览器本地存储(localStorage、sessionStorage、cookie等)中,这样的话服务器不需要保存用户状态,从而可以很容易的做到水平扩展。基于token的用户跟踪具体流程如下:
- 用户登录时,如果登录成功就按照某种方式为用户生成一个令牌(token),该令牌中通常包含了用户标识、过期时间等信息而且需要加密并生成指纹(避免伪造或篡改令牌),服务器将令牌返回给前端;
- 前端获取到服务器返回的token,保存在浏览器本地存储中(可以保存在
localStorage或sessionStorage中,对于使用Vue.js的前端项目来说,还可以通过Vuex进行状态管理); - 对于使用了前端路由的项目来说,前端每次路由跳转,可以先判断
localStroage中有无token,如果没有则跳转到登录页; - 每次请求后端数据接口,在HTTP请求头里携带token;后端接口判断请求头有无token,如果没有token以及token是无效的或过期的,服务器统一返回401;
- 如果前端收到HTTP响应状态码401,则重定向到登录页面。
通过上面的描述,相信大家已经发现了,基于token的用户跟踪最为关键是在用户登录成功时,要为用户生成一个token作为用户的身份标识。生成token的方法很多,其中一种比较成熟的解决方案是使用JSON Web Token。
JWT概述
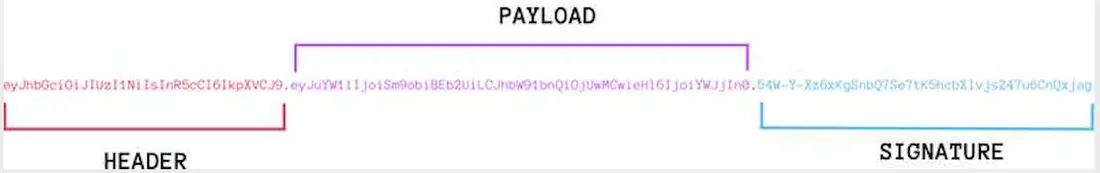
JSON Web Token通常简称为JWT,它是一种开放标准(RFC 7519)。随着RESTful架构的流行,越来越多的项目使用JWT作为用户身份认证的方式。JWT相当于是三个JSON对象经过编码后,用.分隔并组合到一起,这三个JSON对象分别是头部(header)、载荷(payload)和签名(signature),如下图所示。
-
头部
{"alg": "HS256","typ": "JWT"}其中,
alg属性表示签名的算法,默认是HMAC SHA256(简写成HS256);typ属性表示这个令牌的类型,JWT中都统一书写为JWT。 -
载荷
载荷部分用来存放实际需要传递的数据。JWT官方文档中规定了7个可选的字段:
- iss :签发人
- exp:过期时间
- sub:主题
- aud:受众
- nbf:生效时间
- iat:签发时间
- jti:编号
除了官方定义的字典,我们可以根据应用的需要添加自定义的字段,如下所示。
{"sub": "1234567890","nickname": "jackfrued","role": "admin"} -
签名
签名部分是对前面两部分生成一个指纹,防止数据伪造和篡改。实现签名首先需要指定一个密钥。这个密钥只有服务器才知道,不能泄露给用户。然后,使用头部指定的签名算法(默认是
HS256),按照下面的公式产生签名。HS256(base64Encode(header) + '.' + base64Encode(payload), secret)算出签名以后,把头部、载荷、签名三个部分拼接成一个字符串,每个部分用
.进行分隔,这样一个JWT就生成好了。
JWT的优缺点
使用JWT的优点非常明显,包括:
- 更容易实现水平扩展,因为令牌保存在浏览器中,服务器不需要做状态管理。
- 更容易防范CSRF攻击,因为在请求头中添加
localStorage或sessionStorage中的token必须靠JavaScript代码完成,而不是自动添加到请求头中的。 - 可以防伪造和篡改,因为JWT有签名,伪造和篡改的令牌无法通过签名验证,会被认定是无效的令牌。
当然,任何技术不可能只有优点没有缺点,JWT也有诸多缺点,大家需要在使用的时候引起注意,具体包括:
- 可能会遭受到XSS攻击(跨站脚本攻击),通过注入恶意脚本执行JavaScript代码获取到用户令牌。
- 在令牌过期之前,无法作废已经颁发的令牌,要解决这个问题,还需要额外的中间层和代码来辅助。
- JWT是用户的身份令牌,一旦泄露,任何人都可以获得该用户的所有权限。为了降低令牌被盗用后产生的风险,JWT的有效期应该设置得比较短。对于一些比较重要的权限,使用时应通过其他方式再次对用户进行认证,例如短信验证码等。
使用PyJWT
在Python代码中,可以使用三方库PyJWT生成和验证JWT,下面是安装PyJWT的命令。
pip install pyjwt生成令牌。
payload = { 'exp': datetime.datetime.utcnow() + datetime.timedelta(days=1), 'userid': 10001}token = jwt.encode(payload, settings.SECRET_KEY).decode()验证令牌。
try: token = 'eyJ0eXAiOiJKV1QiLCJhbGciOiJIUzI1NiJ9.eyJleHAiOjE1OTQ4NzIzOTEsInVzZXJpZCI6MTAwMDF9.FM-bNxemWLqQQBIsRVvc4gq71y42I9m2zt5nlFxNHUo' payload = jwt.decode(token, settings.SECRET_KEY)except InvalidTokenError: raise AuthenticationFailed('无效的令牌或令牌已经过期')如果不清楚JWT具体的使用方式,可以先看看第55天的内容,里面提供了完整的投票项目代码的地址。
55 RESTful架构和DRF进阶
除了上一节讲到的方法,使用DRF创建REST风格的数据接口也可以通过CBV(基于类的视图)的方式。使用CBV创建数据接口的特点是代码简单,开发效率高,但是没有FBV(基于函数的视图)灵活,因为使用FBV的方式,数据接口对应的视图函数执行什么样的代码以及返回什么的数据是高度可定制的。下面我们以定制学科的数据接口为例,讲解通过CBV方式定制数据接口的具体做法。
使用CBV
继承APIView的子类
修改之前项目中的polls/views.py,去掉show_subjects视图函数,添加一个名为SubjectView的类,该类继承自ListAPIView,ListAPIView能接收GET请求,它封装了获取数据列表并返回JSON数据的get方法。ListAPIView是APIView 的子类,APIView还有很多的子类,例如CreateAPIView可以支持POST请求,UpdateAPIView可以支持PUT和PATCH请求,DestoryAPIView可以支持DELETE请求。SubjectView 的代码如下所示。
from rest_framework.generics import ListAPIView
class SubjectView(ListAPIView): # 通过queryset指定如何获取学科数据 queryset = Subject.objects.all() # 通过serializer_class指定如何序列化学科数据 serializer_class = SubjectSerializer刚才说过,由于SubjectView的父类ListAPIView已经实现了get方法来处理获取学科列表的GET请求,所以我们只需要声明如何获取学科数据以及如何序列化学科数据,前者用queryset属性指定,后者用serializer_class属性指定。要使用上面的SubjectView,需要修改urls.py文件,如下所示。
urlpatterns = [ path('api/subjects/', SubjectView.as_view()),]很显然,上面的做法较之之前讲到的FBV要简单很多。
继承ModelViewSet
如果学科对应的数据接口需要支持GET、POST、PUT、PATCH、DELETE请求来支持对学科资源的获取、新增、更新、删除操作,更为简单的做法是继承ModelViewSet来编写学科视图类。再次修改polls/views.py文件,去掉SubjectView类,添加一个名为SubjectViewSet的类,代码如下所示。
from rest_framework.viewsets import ModelViewSet
class SubjectViewSet(ModelViewSet): queryset = Subject.objects.all() serializer_class = SubjectSerializer通过查看ModelViewSet类的源代码可以发现,该类共有6个父类,其中前5个父类分别实现对POST(新增学科)、GET(获取指定学科)、PUT/PATCH(更新学科)、DELETE(删除学科)和GET(获取学科列表)操作的支持,对应的方法分别是create、retrieve、update、destroy和list。由于ModelViewSet的父类中已经实现了这些方法,所以我们几乎没有编写任何代码就完成了学科数据全套接口的开发,我们要做的仅仅是指出如何获取到数据(通过queryset属性指定)以及如何序列化数据(通过serializer_class属性指定),这一点跟上面继承APIView的子类做法是一致的。
class ModelViewSet(mixins.CreateModelMixin, mixins.RetrieveModelMixin, mixins.UpdateModelMixin, mixins.DestroyModelMixin, mixins.ListModelMixin, GenericViewSet): """ A viewset that provides default `create()`, `retrieve()`, `update()`, `partial_update()`, `destroy()` and `list()` actions. """ pass要使用上面的SubjectViewSet,需要在urls.py文件中进行URL映射。由于ModelViewSet相当于是多个视图函数的汇总,所以不同于之前映射URL的方式,我们需要先创建一个路由器并通过它注册SubjectViewSet,然后将注册成功后生成的URL一并添加到urlspattern列表中,代码如下所示。
from rest_framework.routers import DefaultRouter
router = DefaultRouter()router.register('api/subjects', SubjectViewSet)urlpatterns += router.urls除了ModelViewSet类外,DRF还提供了一个名为ReadOnlyModelViewSet 的类,从名字上就可以看出,该类是只读视图的集合,也就意味着,继承该类定制的数据接口只能支持GET请求,也就是获取单个资源和资源列表的请求。
数据分页
在使用GET请求获取资源列表时,我们通常不会一次性的加载所有的数据,除非数据量真的很小。大多数获取资源列表的操作都支持数据分页展示,也就说我们可以通过指定页码(或类似于页码的标识)和页面大小(一次加载多少条数据)来获取不同的数据。我们可以通过对QuerySet对象的切片操作来实现分页,也可以利用Django框架封装的Paginator和Page对象来实现分页。使用DRF时,可以在Django配置文件中修改REST_FRAMEWORK并配置默认的分页类和页面大小来实现分页,如下所示。
REST_FRAMEWORK = { 'PAGE_SIZE': 10, 'DEFAULT_PAGINATION_CLASS': 'rest_framework.pagination.PageNumberPagination'}除了上面配置的PageNumberPagination分页器之外,DRF还提供了LimitOffsetPagination和CursorPagination分页器,值得一提的是CursorPagination,它可以避免使用页码分页时暴露网站的数据体量,有兴趣的读者可以自行了解。如果不希望使用配置文件中默认的分页设定,可以在视图类中添加一个pagination_class属性来重新指定分页器,通常可以将该属性指定为自定义的分页器,如下所示。
from rest_framework.pagination import PageNumberPagination
class CustomizedPagination(PageNumberPagination): # 默认页面大小 page_size = 5 # 页面大小对应的查询参数 page_size_query_param = 'size' # 页面大小的最大值 max_page_size = 50class SubjectView(ListAPIView): # 指定如何获取数据 queryset = Subject.objects.all() # 指定如何序列化数据 serializer_class = SubjectSerializer # 指定如何分页 pagination_class = CustomizedPagination如果不希望数据分页,可以将pagination_class属性设置为None来取消默认的分页器。
数据筛选
如果希望使用CBV定制获取老师信息的数据接口,也可以通过继承ListAPIView来实现。但是因为要通过指定的学科来获取对应的老师信息,因此需要对老师数据进行筛选而不是直接获取所有老师的数据。如果想从请求中获取学科编号并通过学科编号对老师进行筛选,可以通过重写get_queryset方法来做到,代码如下所示。
class TeacherView(ListAPIView): serializer_class = TeacherSerializer
def get_queryset(self): queryset = Teacher.objects.defer('subject') try: sno = self.request.GET.get('sno', '') queryset = queryset.filter(subject__no=sno) return queryset except ValueError: raise Http404('No teachers found.')除了上述方式之外,还可以使用三方库django-filter来配合DRF实现对数据的筛选,使用django-filter后,可以通过为视图类配置filter-backends属性并指定使用DjangoFilterBackend来支持数据筛选。在完成上述配置后,可以使用filter_fields 属性或filterset_class属性来指定如何筛选数据,有兴趣的读者可以自行研究。
56 使用缓存
通常情况下,Web应用的性能瓶颈都会出现在关系型数据库上,当并发访问量较大时,如果所有的请求都需要通过关系型数据库完成数据持久化操作,那么数据库一定会不堪重负。优化Web应用性能最为重要的一点就是使用缓存,把那些数据体量不大但访问频率非常高的数据提前加载到缓存服务器中,这又是典型的空间换时间的方法。通常缓存服务器都是直接将数据置于内存中而且使用了非常高效的数据存取策略(哈希存储、键值对方式等),在读写性能上远远优于关系型数据库的,因此我们可以让Web应用接入缓存服务器来优化其性能,其中一个非常好的选择就是使用Redis。
Web应用的缓存架构大致如下图所示。
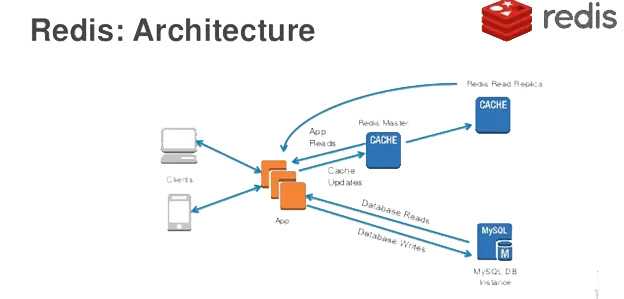
Django项目接入Redis
在此前的课程中,我们介绍过Redis的安装和使用,此处不再进行赘述。如果需要在Django项目中接入Redis,可以使用三方库django-redis,这个三方库又依赖了一个名为redis 的三方库,它封装了对Redis的各种操作。
安装django-redis。
pip install django-redis修改Django配置文件中关于缓存的配置。
CACHES = { 'default': { # 指定通过django-redis接入Redis服务 'BACKEND': 'django_redis.cache.RedisCache', # Redis服务器的URL 'LOCATION': ['redis://1.2.3.4:6379/0', ], # Redis中键的前缀(解决命名冲突) 'KEY_PREFIX': 'vote', # 其他的配置选项 'OPTIONS': { 'CLIENT_CLASS': 'django_redis.client.DefaultClient', # 连接池(预置若干备用的Redis连接)参数 'CONNECTION_POOL_KWARGS': { # 最大连接数 'max_connections': 512, }, # 连接Redis的用户口令 'PASSWORD': 'foobared', } },}至此,我们的Django项目已经可以接入Redis,接下来我们修改项目代码,用Redis为之写的获取学科数据的接口提供缓存服务。
为视图提供缓存服务
声明式缓存
所谓声明式缓存是指不修改原来的代码,通过Python中的装饰器(代理)为原有的代码增加缓存功能。对于FBV,代码如下所示。
from django.views.decorators.cache import cache_page
@api_view(('GET', ))@cache_page(timeout=86400, cache='default')def show_subjects(request): """获取学科数据""" queryset = Subject.objects.all() data = SubjectSerializer(queryset, many=True).data return Response({'code': 20000, 'subjects': data})上面的代码通过Django封装的cache_page装饰器缓存了视图函数的返回值(响应对象),cache_page的本意是缓存视图函数渲染的页面,对于返回JSON数据的视图函数,相当于是缓存了JSON数据。在使用cache_page装饰器时,可以传入timeout参数来指定缓存过期时间,还可以使用cache参数来指定需要使用哪一组缓存服务来缓存数据。Django项目允许在配置文件中配置多组缓存服务,上面的cache='default'指定了使用默认的缓存服务(因为之前的配置文件中我们也只配置了名为default的缓存服务)。视图函数的返回值会被序列化成字节串放到Redis中(Redis中的str类型可以接收字节串),缓存数据的序列化和反序列化也不需要我们自己处理,因为cache_page装饰器会调用django-redis库中的RedisCache来对接Redis,该类使用了DefaultClient来连接Redis并使用了pickle序列化,django_redis.serializers.pickle.PickleSerializer是默认的序列化类。
如果缓存中没有学科的数据,那么通过接口访问学科数据时,我们的视图函数会通过执行Subject.objects.all()向数据库发出SQL语句来获得数据,视图函数的返回值会被缓存,因此下次请求该视图函数如果缓存没有过期,可以直接从缓存中获取视图函数的返回值,无需再次查询数据库。如果想了解缓存的使用情况,可以配置数据库日志或者使用Django-Debug-Toolbar来查看,第一次访问学科数据接口时会看到查询学科数据的SQL语句,再次获取学科数据时,不会再向数据库发出SQL语句,因为可以直接从缓存中获取数据。
对于CBV,可以利用Django中名为method_decorator的装饰器将cache_page这个装饰函数的装饰器放到类中的方法上,效果跟上面的代码是一样的。需要提醒大家注意的是,cache_page装饰器不能直接放在类上,因为它是装饰函数的装饰器,所以Django框架才提供了method_decorator来解决这个问题,很显然,method_decorator是一个装饰类的装饰器。
from django.utils.decorators import method_decoratorfrom django.views.decorators.cache import cache_page
@method_decorator(decorator=cache_page(timeout=86400, cache='default'), name='get')class SubjectView(ListAPIView): """获取学科数据的视图类""" queryset = Subject.objects.all() serializer_class = SubjectSerializer编程式缓存
所谓编程式缓存是指通过自己编写的代码来使用缓存服务,这种方式虽然代码量会稍微大一些,但是相较于声明式缓存,它对缓存的操作和使用更加灵活,在实际开发中使用得更多。下面的代码去掉了之前使用的cache_page装饰器,通过django-redis提供的get_redis_connection函数直接获取Redis连接来操作Redis。
def show_subjects(request): """获取学科数据""" redis_cli = get_redis_connection() # 先尝试从缓存中获取学科数据 data = redis_cli.get('vote:polls:subjects') if data: # 如果获取到学科数据就进行反序列化操作 data = json.loads(data) else: # 如果缓存中没有获取到学科数据就查询数据库 queryset = Subject.objects.all() data = SubjectSerializer(queryset, many=True).data # 将查到的学科数据序列化后放到缓存中 redis_cli.set('vote:polls:subjects', json.dumps(data), ex=86400) return Response({'code': 20000, 'subjects': data})需要说明的是,Django框架提供了cache和caches两个现成的变量来支持缓存操作,前者访问的是默认的缓存(名为default的缓存),后者可以通过索引运算获取指定的缓存服务(例如:caches['default'])。向cache对象发送get和set消息就可以实现对缓存的读和写操作,但是这种方式能做的操作有限,不如上面代码中使用的方式灵活。还有一个值得注意的地方,由于可以通过get_redis_connection函数获得的Redis连接对象向Redis发起各种操作,包括FLUSHDB、SHUTDOWN等危险的操作,所以在实际商业项目开发中,一般都会对django-redis再做一次封装,例如封装一个工具类,其中只提供了项目需要用到的缓存操作的方法,从而避免了直接使用get_redis_connection的潜在风险。当然,自己封装对缓存的操作还可以使用“Read Through”和“Write Through”的方式实现对缓存的更新,这个在下面会介绍到。
缓存相关问题
缓存数据的更新
在使用缓存时,一个必须搞清楚的问题就是,当数据改变时,如何更新缓存中的数据。通常更新缓存有如下几种套路,分别是:
- Cache Aside Pattern
- Read/Write Through Pattern
- Write Behind Caching Pattern
第1种方式的具体做法就是,当数据更新时,先更新数据库,再删除缓存。注意,不能够使用先更新数据库再更新缓存的方式,也不能够使用先删除缓存再更新数据库的方式,大家可以自己想一想为什么(考虑一下有并发的读操作和写操作的场景)。当然,先更新数据库再删除缓存的做法在理论上也存在风险,但是发生问题的概率是极低的,所以不少的项目都使用了这种方式。
第1种方式相当于编写业务代码的开发者要自己负责对两套存储系统(缓存和关系型数据库)的操作,代码写起来非常的繁琐。第2种方式的主旨是将后端的存储系统变成一套代码,对缓存的维护封装在这套代码中。其中,Read Through指在查询操作中更新缓存,也就是说,当缓存失效的时候,由缓存服务自己负责对数据的加载,从而对应用方是透明的;而Write Through是指在更新数据时,如果没有命中缓存,直接更新数据库,然后返回。如果命中了缓存,则更新缓存,然后再由缓存服务自己更新数据库(同步更新)。刚才我们说过,如果自己对项目中的Redis操作再做一次封装,就可以实现“Read Through”和“Write Through”模式,这样做虽然会增加工作量,但无疑是一件“一劳永逸”且“功在千秋”的事情。
第3种方式是在更新数据的时候,只更新缓存,不更新数据库,而缓存服务这边会异步的批量更新数据库。这种做法会大幅度提升性能,但代价是牺牲数据的强一致性。第3种方式的实现逻辑比较复杂,因为他需要追踪有哪数据是被更新了的,然后再批量的刷新到持久层上。
缓存穿透
缓存是为了缓解数据库压力而添加的一个中间层,如果恶意的访问者频繁的访问缓存中没有的数据,那么缓存就失去了存在的意义,瞬间所有请求的压力都落在了数据库上,这样会导致数据库承载着巨大的压力甚至连接异常,类似于分布式拒绝服务攻击(DDoS)的做法。解决缓存穿透的一个办法是约定如果查询返回为空值,把这个空值也缓存起来,但是需要为这个空值的缓存设置一个较短的超时时间,毕竟缓存这样的值就是对缓存空间的浪费。另一个解决缓存穿透的办法是使用布隆过滤器,具体的做法大家可以自行了解。
缓存击穿
在实际的项目中,可能存在某个缓存的key某个时间点过期,但恰好在这个时间点对有对该key的大量的并发请求过来,这些请求没有从缓存中找到key对应的数据,就会直接从数据库中获取数据并写回到缓存,这个时候大并发的请求可能会瞬间把数据库压垮,这种现象称为缓存击穿。比较常见的解决缓存击穿的办法是使用互斥锁,简单的说就是在缓存失效的时候,不是立即去数据库加载数据,而是先设置互斥锁(例如:Redis中的setnx),只有设置互斥锁的操作成功的请求,才能执行查询从数据库中加载数据并写入缓存,其他设置互斥锁失败的请求,可以先执行一个短暂的休眠,然后尝试重新从缓存中获取数据,如果缓存还没有数据,则重复刚才的设置互斥锁的操作,大致的参考代码如下所示。
data = redis_cli.get(key)while not data: if redis_cli.setnx('mutex', 'x'): redis.expire('mutex', timeout) data = db.query(...) redis.set(key, data) redis.delete('mutex') else: time.sleep(0.1) data = redis_cli.get(key)缓存雪崩
缓存雪崩是指在将数据放入缓存时采用了相同的过期时间,这样就导致缓存在某一时刻同时失效,请求全部转发到数据库,导致数据库瞬时压力过大而崩溃。解决缓存雪崩问题的方法也比较简单,可以在既定的缓存过期时间上加一个随机时间,这样可以从一定程度上避免不同的key在同一时间集体失效。还有一种办法就是使用多级缓存,每一级缓存的过期时间都不一样,这样的话即便某个级别的缓存集体失效,但是其他级别的缓存还能够提供数据,避免所有的请求都落到数据库上。
57 接入三方平台
在Web应用的开发过程中,有一些任务并不是我们自己能够完成的。例如,我们的Web项目中需要做个人或企业的实名认证,很显然我们并没有能力判断用户提供的认证信息的真实性,这个时候我们就要借助三方平台提供的服务来完成该项操作。再比如说,我们的项目中需要提供在线支付功能,这类业务通常也是借助支付网关来完成而不是自己去实现,我们只需要接入像微信、支付宝、银联这样的三方平台即可。
在项目中接入三方平台基本上就两种方式:API接入和SDK接入。
- API接入指的是通过访问三方提供的URL来完成操作或获取数据。国内有很多这样的平台提供了大量常用的服务,例如聚合数据上提供了生活服务类、金融科技类、交通地理类、充值缴费类等各种类型的API。我们可以通过Python程序发起网络请求,通过访问URL获取数据,这些API接口跟我们项目中提供的数据接口是一样的,只不过我们项目中的API是供自己使用的,而这类三方平台提供的API是开放的。当然开放并不代表免费,大多数能够提供有商业价值的数据的API都是需要付费才能使用的。
- SDK接入指的是通过安装三方库并使用三方库封装的类、函数来使用三方平台提供的服务的方式。例如我们刚才说到的接入支付宝,就需要先安装支付宝的SDK,然后通过支付宝封装的类和方法完成对支付服务的调用。
下面我们通过具体的例子来讲解如何接入三方平台。
接入短信网关
一个Web项目有很多地方都可以用到短信服务,例如:手机验证码登录、重要消息提醒、产品营销短信等。要实现发送短信的功能,可以通过接入短信网关来实现,国内比较有名的短信网关包括:云片短信、网易云信、螺丝帽、SendCloud等,这些短信网关一般都提供了免费试用功能。下面我们以螺丝帽平台为例,讲解如何在项目中接入短信网关,其他平台操作基本类似。
-
注册账号,新用户可以免费试用。
-
登录到管理后台,进入短信版块。
-
点击“触发发送”可以找到自己专属的API Key(身份标识)。
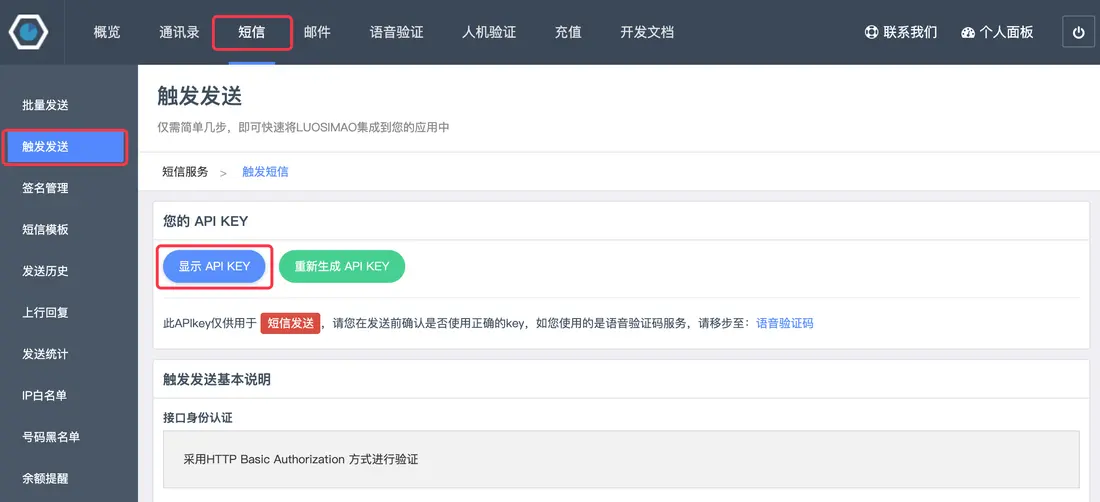
-
点击“签名管理”可以添加短信签名,短信都必须携带签名,免费试用的短信要在短信中添加“【铁壳测试】”这个签名,否则短信无法发送。
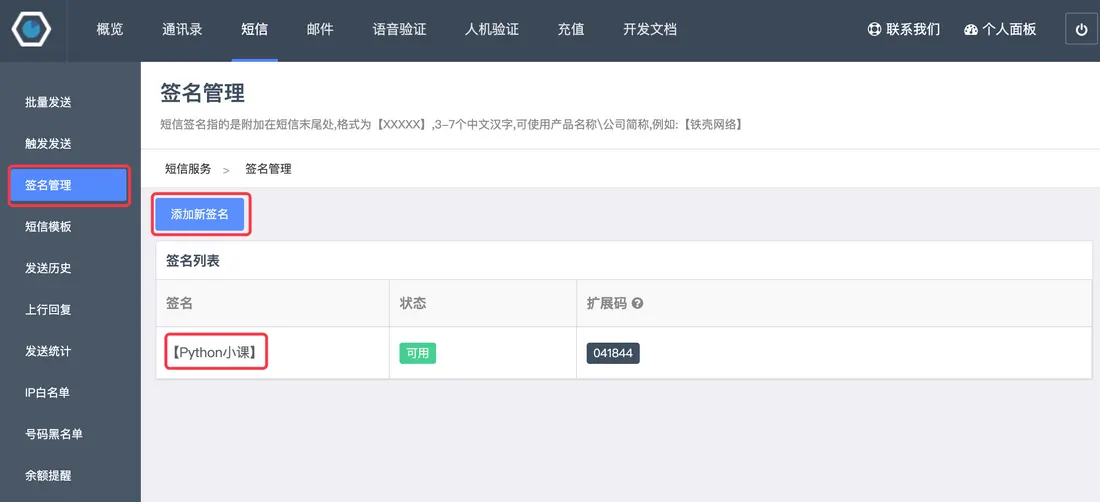
-
点击“IP白名单”将运行Django项目的服务器地址(公网IP地址,本地运行可以打开xxx网站查看自己本机的公网IP地址)填写到白名单中,否则短信无法发送。
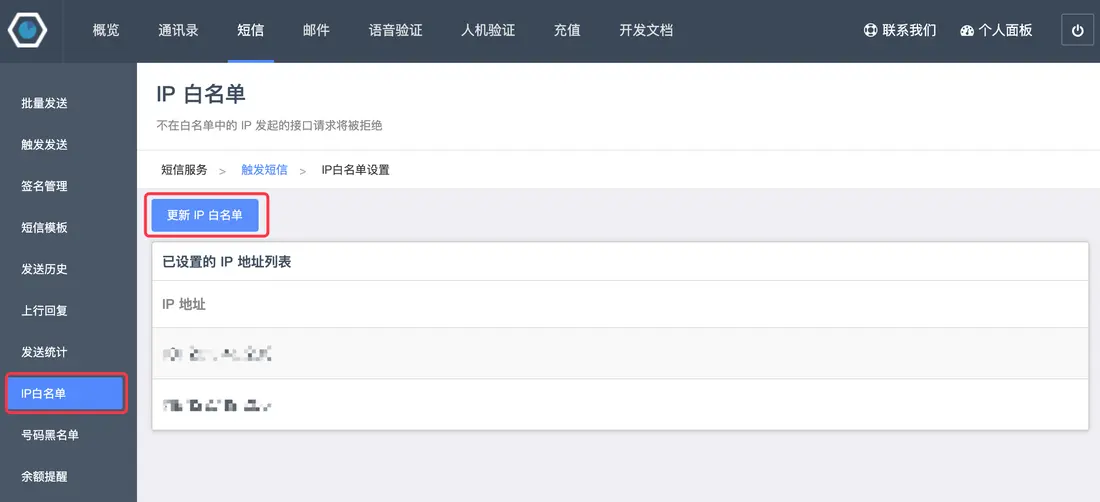
-
如果没有剩余的短信条数,可以到“充值”页面选择“短信服务”进行充值。
接下来,我们可以通过调用螺丝帽短信网关实现发送短信验证码的功能,代码如下所示。
def send_mobile_code(tel, code): """发送短信验证码""" resp = requests.post( url='http://sms-api.luosimao.com/v1/send.json', auth=('api', 'key-自己的APIKey'), data={ 'mobile': tel, 'message': f'您的短信验证码是{code},打死也不能告诉别人哟。【Python小课】' }, verify=False ) return resp.json()运行上面的代码需要先安装requests三方库,这个三方库封装了HTTP网络请求的相关功能,使用起来非常的简单,我们在之前的内容中也讲到过这个三方库。send_mobile_code函数有两个参数,第一个参数是手机号,第二个参数是短信验证码的内容,第5行代码需要提供自己的API Key,就是上面第2步中查看到的自己的API Key。请求螺丝帽的短信网关会返回JSON格式的数据,对于上面的代码如果返回{'err': 0, 'msg': 'ok'},则表示短信发送成功,如果err字段的值不为0而是其他值,则表示短信发送失败,可以在螺丝帽官方的开发文档页面上查看到不同的数值代表的含义,例如:-20表示余额不足,-32表示缺少短信签名。
可以在视图函数中调用上面的函数来完成发送短信验证码的功能,稍后我们可以把这个功能跟用户注册结合起来。
生成随机验证码和验证手机号的函数。
import randomimport re
TEL_PATTERN = re.compile(r'1[3-9]\d{9}')
def check_tel(tel): """检查手机号""" return TEL_PATTERN.fullmatch(tel) is not None
def random_code(length=6): """生成随机短信验证码""" return ''.join(random.choices('0123456789', k=length))发送短信验证码的视图函数。
@api_view(('GET', ))def get_mobilecode(request, tel): """获取短信验证码""" if check_tel(tel): redis_cli = get_redis_connection() if redis_cli.exists(f'vote:block-mobile:{tel}'): data = {'code': 30001, 'message': '请不要在60秒内重复发送短信验证码'} else: code = random_code() send_mobile_code(tel, code) # 通过Redis阻止60秒内容重复发送短信验证码 redis_cli.set(f'vote:block-mobile:{tel}', 'x', ex=60) # 将验证码在Redis中保留10分钟(有效期10分钟) redis_cli.set(f'vote2:valid-mobile:{tel}', code, ex=600) data = {'code': 30000, 'message': '短信验证码已发送,请注意查收'} else: data = {'code': 30002, 'message': '请输入有效的手机号'} return Response(data)说明:上面的代码利用Redis实现了两个额外的功能,一个是阻止用户60秒内重复发送短信验证码,一个是将用户的短信验证码保留10分钟,也就是说这个短信验证码的有效期只有10分钟,我们可以要求用户在注册时提供该验证码来验证用户手机号的真实性。
接入云存储服务
当我们提到云存储这个词的时候,通常是指把数据存放在由第三方提供的虚拟服务器环境下,简单的说就是将某些数据或资源通过第三平台托管。一般情况下,提供云存储服务的公司都运营着大型的数据中心,需要云存储服务的个人或组织通过向其购买或租赁存储空间来满足数据存储的需求。在开发Web应用时,可以将静态资源,尤其是用户上传的静态资源直接置于云存储服务中,云存储通常会提供对应的URL使得用户可以访问该静态资源。国内外比较有名的云存储服务(如:亚马逊的S3、阿里的OSS2等)一般都物美价廉,相比自己架设静态资源服务器,云存储的代价更小,而且一般的云存储平台都提供了CDN服务,用于加速对静态资源的访问,所以不管从哪个角度出发,使用云存储的方式管理Web应用的数据和静态资源都是非常好的选择,除非这些资源涉及到个人或商业隐私,否则就可以托管到云存储中。
下面我们以接入七牛云为例,讲解如何实现将用户上传的文件保存到七牛云存储。七牛云是国内知名的云计算及数据服务提供商,七牛云在海量文件存储、CDN、视频点播、互动直播以及大规模异构数据的智能分析与处理等领域都有自己的产品,而且非付费用户也可以免费接入,使用其提供的服务。下面是接入七牛云的流程:
-
注册账号,登录管理控制台。
-
选择左侧菜单中的对象存储。
-
在空间管理中选择新建空间(例如:myvote),如果提示空间名称已被占用,更换一个再尝试即可。注意,创建空间后会提示绑定自定义域名,如果暂时还没有自己的域名,可以使用七牛云提供的临时域名,但是临时域名会在30天后被回收,所以最好准备自己的域名(域名需要备案,不清楚如何操作的请自行查阅相关资料)。
-
在网页的右上角点击个人头像中的“密钥管理”,查看自己的密钥,稍后在代码中需要使用AK(AccessKey)和SK(SecretKey)两个密钥来认证用户身份。
-
点击网页上方菜单中的“文档”,进入到七牛开发者中心,选择导航菜单中的“SDK&工具”并点击“官方SDK”子菜单,找到Python(服务端)并点击“文档”查看官方文档。
接下来,只要安装官方文档提供的示例,就可以接入七牛云,使用七牛云提供的云存储以及其他服务。首先可以通过下面的命令安装七牛云的三方库。
pip install qiniu接下来可以通过qiniu模块中的put_file和put_stream两个函数实现文件上传,前者可以上传指定路径的文件,后者可以将内存中的二进制数据上传至七牛云,具体的代码如下所示。
import qiniu
AUTH = qiniu.Auth('密钥管理中的AccessKey', '密钥管理中的SecretKey')BUCKET_NAME = 'myvote'
def upload_file_to_qiniu(key, file_path): """上传指定路径的文件到七牛云""" token = AUTH.upload_token(BUCKET_NAME, key) return qiniu.put_file(token, key, file_path)
def upload_stream_to_qiniu(key, stream, size): """上传二进制数据流到七牛云""" token = AUTH.upload_token(BUCKET_NAME, key) return qiniu.put_stream(token, key, stream, None, size)下面是一个文件上传的简单前端页。
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8"> <title>上传文件</title></head><body> <form action="/upload/" method="post" enctype="multipart/form-data"> <div> <input type="file" name="photo"> <input type="submit" value="上传"> </div> </form></body></html>说明:前端如果使用表单实现文件上传,表单的method属性必须设置为post,enctype属性需要设置为multipart/form-data,表单中type属性为file的input标签,就是上传文件的文件选择器。
实现上传功能的视图函数如下所示。
from django.views.decorators.csrf import csrf_exempt
@csrf_exemptdef upload(request): # 如果上传的文件小于2.5M,则photo对象的类型为InMemoryUploadedFile,文件在内存中 # 如果上传的文件超过2.5M,则photo对象的类型为TemporaryUploadedFile,文件在临时路径下 photo = request.FILES.get('photo') _, ext = os.path.splitext(photo.name) # 通过UUID和原来文件的扩展名生成独一无二的新的文件名 filename = f'{uuid.uuid1().hex}{ext}' # 对于内存中的文件,可以使用上面封装好的函数upload_stream_to_qiniu上传文件到七牛云 # 如果文件保存在临时路径下,可以使用upload_file_to_qiniu实现文件上传 upload_stream_to_qiniu(filename, photo.file, photo.size) return redirect('/static/html/upload.html')注意:上面的视图函数使用了
csrf_exempt装饰器,该装饰器能够让表单免除必须提供CSRF令牌的要求。此外,代码第11行使用了uuid模块的uuid1函数来生成全局唯一标识符。
运行项目尝试文件上传的功能,文件上传成功后,可以在七牛云“空间管理”中点击自己空间并进入“文件管理”界面,在这里可以看到我们刚才上传成功的文件,而且可以通过七牛云提供的域名获取该文件。
58 异步任务和定时任务
在Web应用中,如果一个请求执行了耗时间的操作或者该请求的执行时间无法确定,而且对于用户来说只需要知道服务器接收了他的请求,并不需要马上得到请求的执行结果,这样的操作我们就应该对其进行异步化处理。如果说使用缓存是优化网站性能的第一要义,那么将耗时间或执行时间不确定的任务异步化则是网站性能优化的第二要义,简单的说就是能推迟做的事情都不要马上做。
上一章节中讲到的发短信和上传文件到云存储为例,这两个操作前者属于时间不确定的操作(因为作为调用者,我们不能确定三方平台响应的时间),后者属于耗时间的操作(如果文件较大或者三方平台不稳定,都可能导致上传的时间较长),很显然,这两个操作都可以做异步化处理。
在 Python 项目中,我们可以使用三方库Celery来完成异步任务和定时任务,关于Celery的内容,请移步到《使用Django开发商业项目》一文。
59 单元测试
请各位读者移步到《使用Django开发商业项目》一文。
60 项目上线
请各位读者移步到《项目部署上线和性能调优》一文。
Python100天
已完结分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 301 天
部分内容可能已过时
评论