本篇目录
- 36 关系型数据库和MySQL概述
- 37 SQL详解之DDL
- 38 SQL详解之DML
- 39 SQL详解之DQL
- 40 SQL详解之DCL
- 41 MySQL新特性
- 42 视图、函数和过程
- 43 索引
- 44 Python接入MySQL数据库
- 45 Hive实战
目录里每一条都可以点开直达对应章节;右侧(移动端为悬浮按钮)的「文章目录」也会列出同一批标题。
36 关系型数据库和MySQL概述
关系型数据库概述
-
数据持久化 - 将数据保存到能够长久保存数据的存储介质中,在掉电的情况下数据也不会丢失。
-
数据库发展史 - 网状数据库、层次数据库、关系数据库、NoSQL 数据库、NewSQL 数据库。
1970年,IBM的研究员E.F.Codd在Communication of the ACM上发表了名为A Relational Model of Data for Large Shared Data Banks的论文,提出了关系模型的概念,奠定了关系模型的理论基础。后来Codd又陆续发表多篇文章,论述了范式理论和衡量关系系统的12条标准,用数学理论奠定了关系数据库的基础。
-
关系数据库特点。
- 理论基础:关系代数(集合论、一阶谓词、关系运算)。
- 具体表象:用二维表(有行和列)组织数据。
- 编程语言:结构化查询语言(SQL)。
- DDL:数据定义语言
- DML:数据操作语言
- DCL:数据控制语言
- TCL:事务控制语言
-
ER模型(实体关系模型)和概念模型图。
ER模型,全称为实体关系模型(Entity-Relationship Model),由美籍华裔计算机科学家陈品山先生提出,是概念数据模型的高层描述方式,如下图所示。
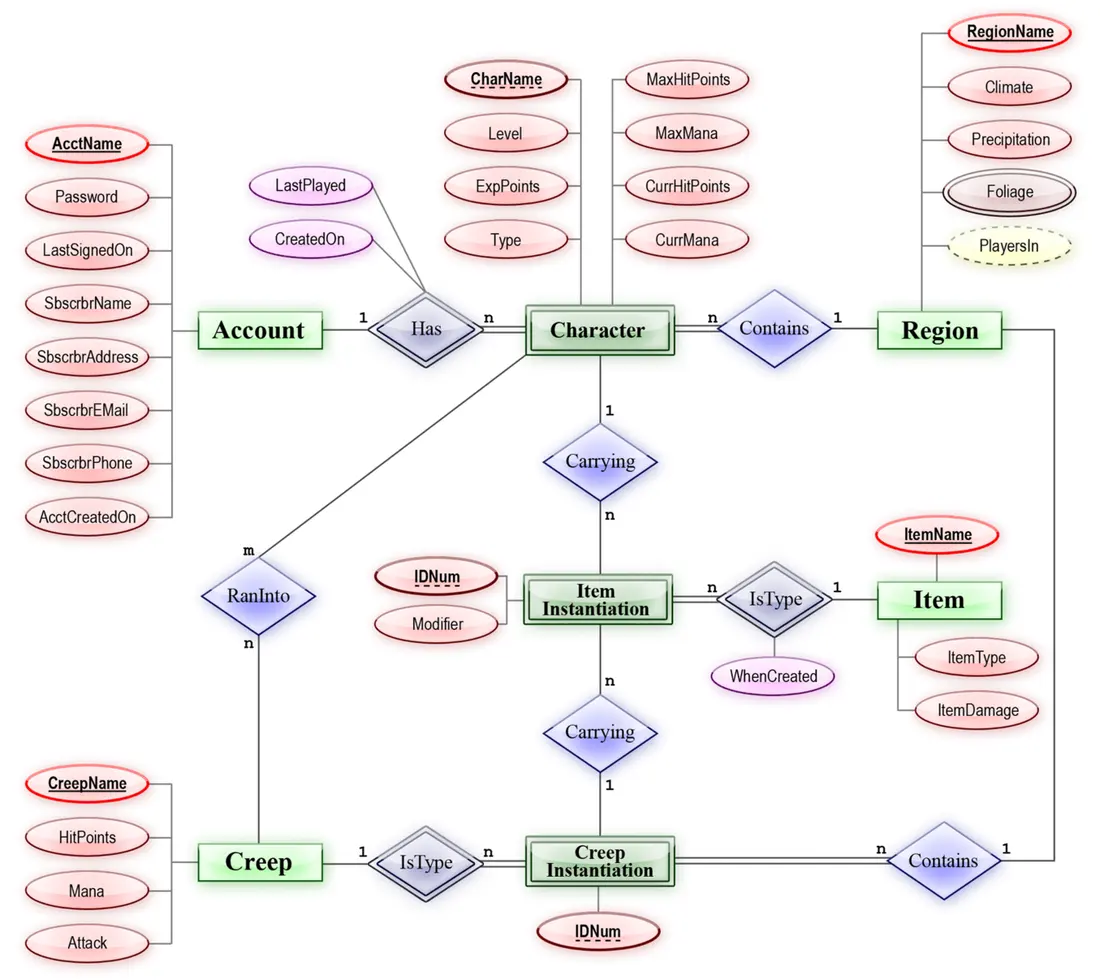
- 实体 - 矩形框
- 属性 - 椭圆框
- 关系 - 菱形框
- 重数 - 1:1(一对一) / 1
(一对多) / M (多对多)
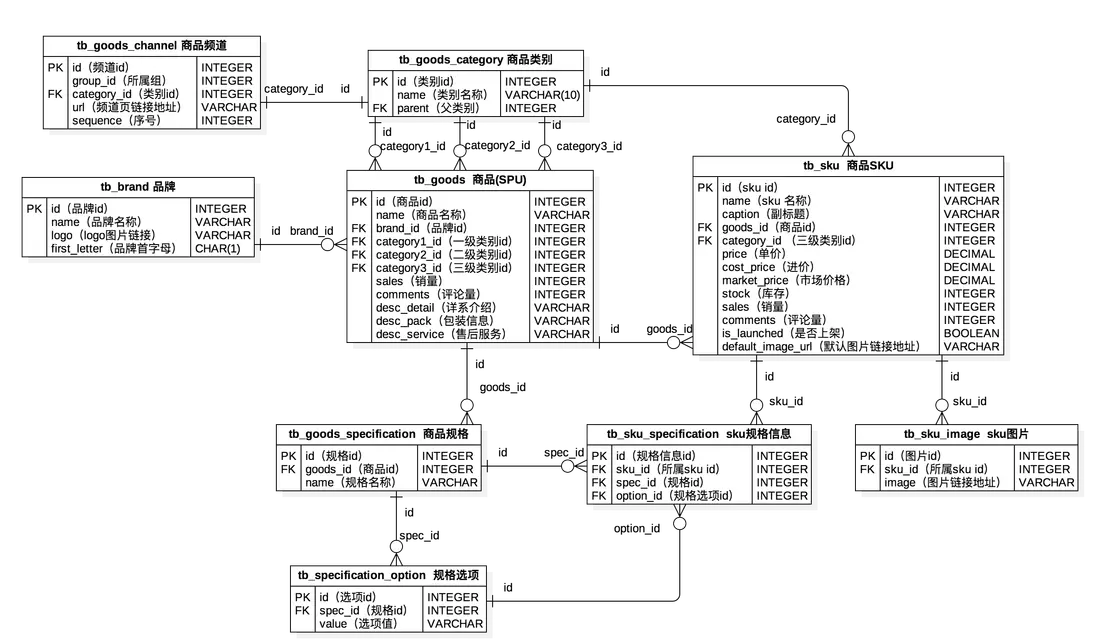
实际项目开发中,我们可以利用数据库建模工具(如:PowerDesigner)来绘制概念数据模型,然后再设置好目标数据库系统,将概念模型转换成物理模型(如下图所示),最终生成创建二维表的 SQL(很多工具都可以根据我们设计的物理模型图以及设定的目标数据库来导出 SQL 或直接生成数据表)。
-
关系数据库产品。
- Oracle - 目前世界上使用最为广泛的数据库管理系统,作为一个通用的数据库系统,它具有完整的数据管理功能;作为一个关系数据库,它是一个完备关系的产品;作为分布式数据库,它实现了分布式处理的功能。在 Oracle 较新的版本中,还引入了多承租方架构,使用该架构可轻松部署和管理数据库云。
- DB2 - IBM 公司开发的、主要运行于 Unix(包括 IBM 自家的 AIX)、Linux、以及 Windows 服务器版等系统的关系数据库产品。DB2 历史悠久且被认为是最早使用 SQL 的数据库产品,它拥有较为强大的商业智能功能。
- SQL Server - 由 Microsoft 开发和推广的关系型数据库产品,最初适用于中小企业的数据管理,但是近年来它的应用范围有所扩展,部分大企业甚至是跨国公司也开始基于它来构建自己的数据管理系统。
- MySQL - MySQL 是开放源代码的,任何人都可以在 GPL(General Public License)的许可下下载并根据个性化的需要对其进行修改。MySQL 因为其速度、可靠性和适应性而备受关注。
- PostgreSQL - 在 BSD 许可证下发行的开放源代码的关系数据库产品。
MySQL 简介
MySQL 最早是由瑞典的 MySQL AB 公司开发的一个开放源码的关系数据库管理系统,该公司于2008年被昇阳微系统公司(Sun Microsystems)收购。在2009年,甲骨文公司(Oracle)收购昇阳微系统公司,因此 MySQL 目前也是 Oracle 旗下产品。
MySQL 在过去由于性能高、成本低、可靠性好,已经成为最流行的开源数据库,因此被广泛地应用于中小型网站开发。随着 MySQL 的不断成熟,它也逐渐被应用于更多大规模网站和应用,比如维基百科、谷歌(Google)、脸书(Facebook)、百度、淘宝、腾讯、新浪、去哪儿等都使用了 MySQL 来提供数据持久化服务。
甲骨文公司收购后昇阳微系统公司,大幅调涨 MySQL 商业版的售价,且甲骨文公司不再支持另一个自由软件项目 OpenSolaris 的发展,因此导致自由软件社区对于 Oracle 是否还会持续支持 MySQL 社区版(MySQL 的各个发行版本中唯一免费的版本)有所担忧,MySQL 的创始人麦克尔·维德纽斯以 MySQL 为基础,创建了 MariaDB(以他女儿的名字命名的数据库)分支。有许多原来使用 MySQL 数据库的公司(例如:维基百科)已经陆续完成了从 MySQL 数据库到 MariaDB 数据库的迁移。
安装 MySQL
Windows 环境
-
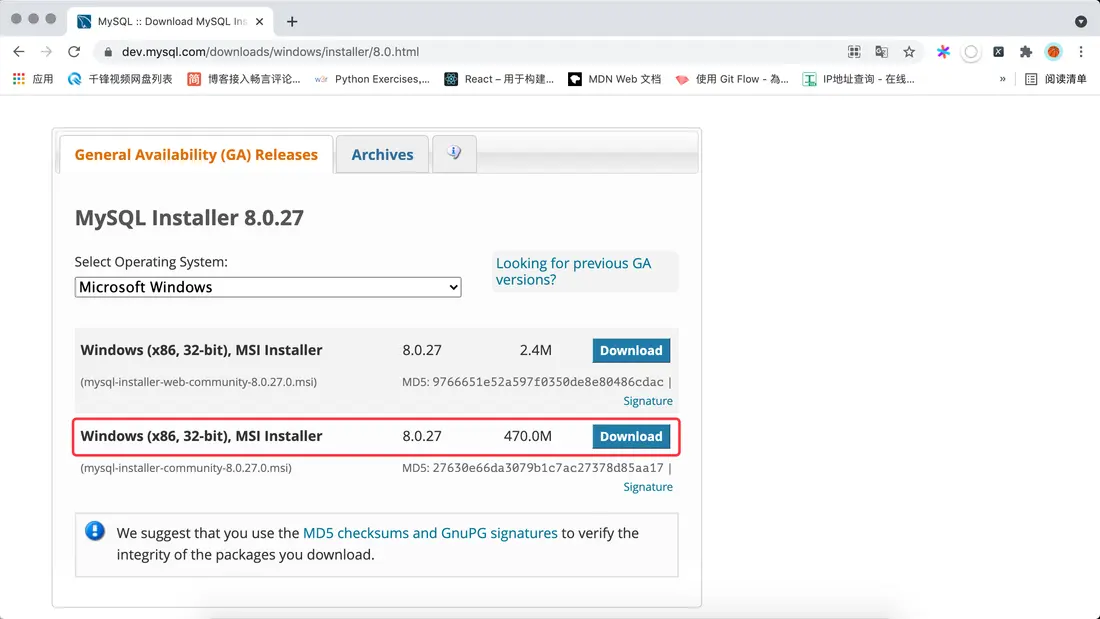
通过官方网站提供的下载链接下载“MySQL社区版服务器”安装程序,如下图所示,建议大家下载离线安装版的MySQL Installer。
-
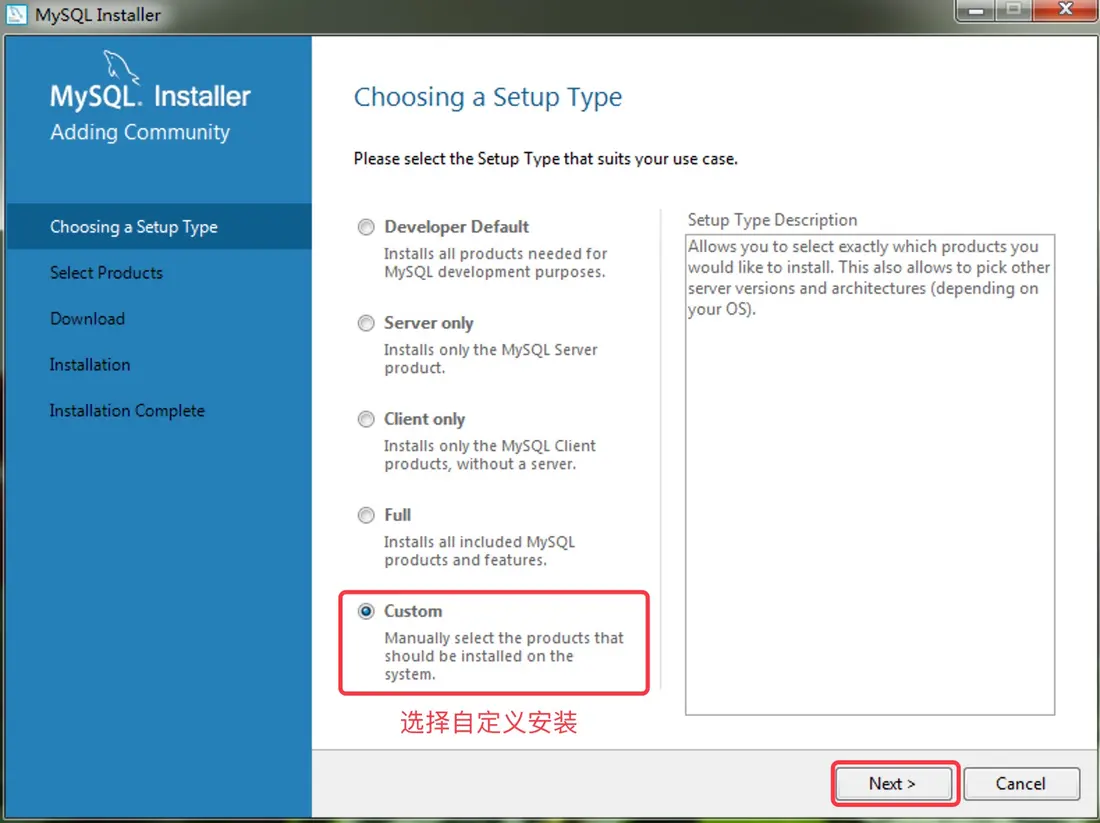
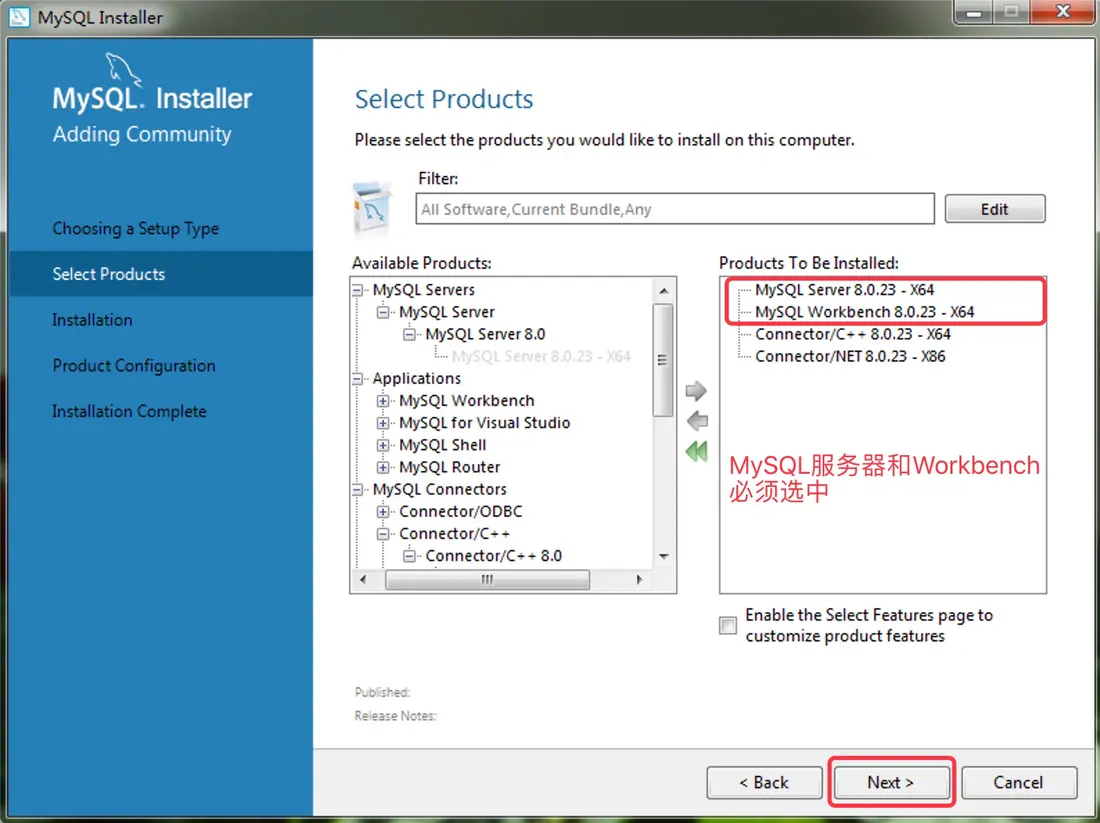
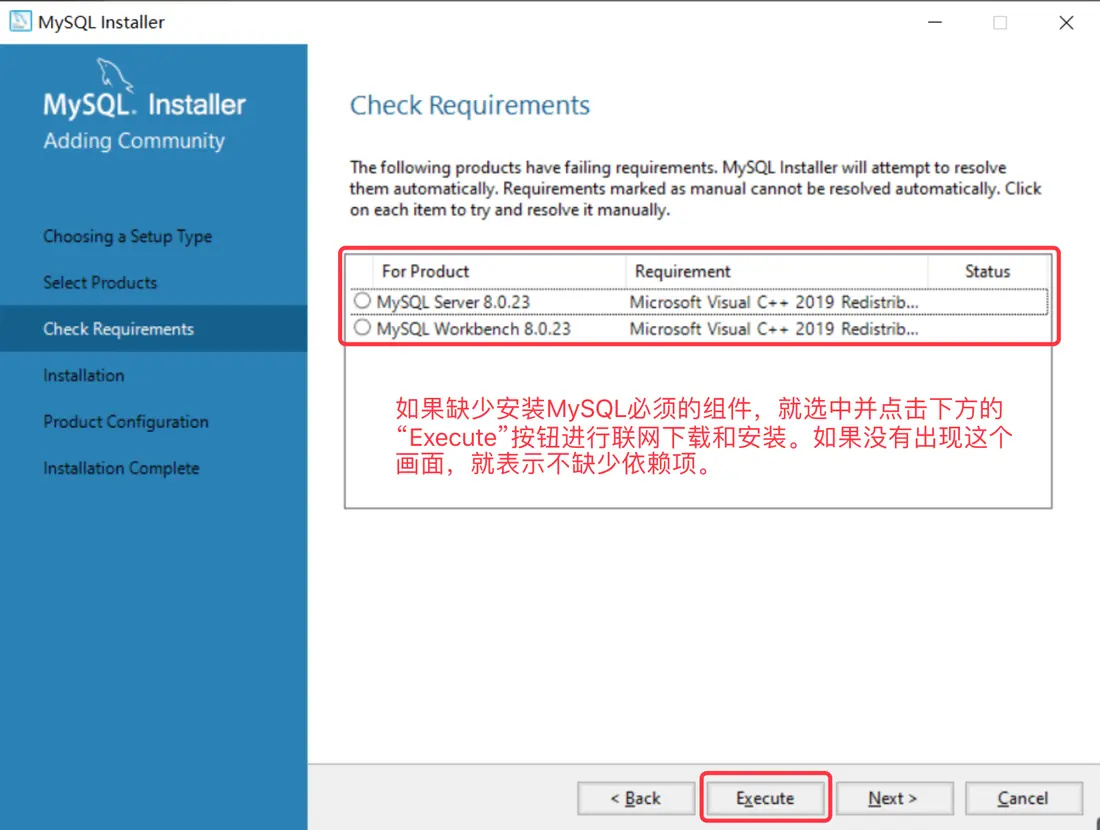
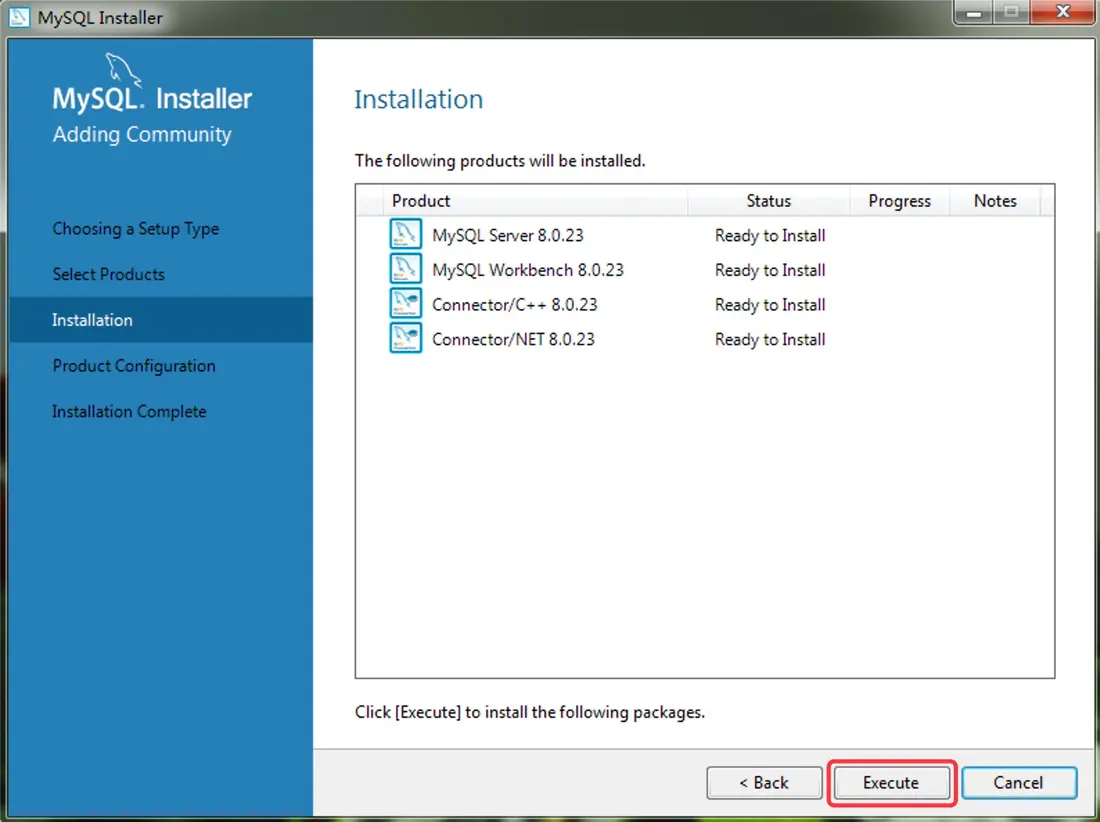
运行 Installer,按照下面的步骤进行安装。
- 选择自定义安装。
- 选择需要安装的组件。
- 如果缺少依赖项,需要先安装依赖项。
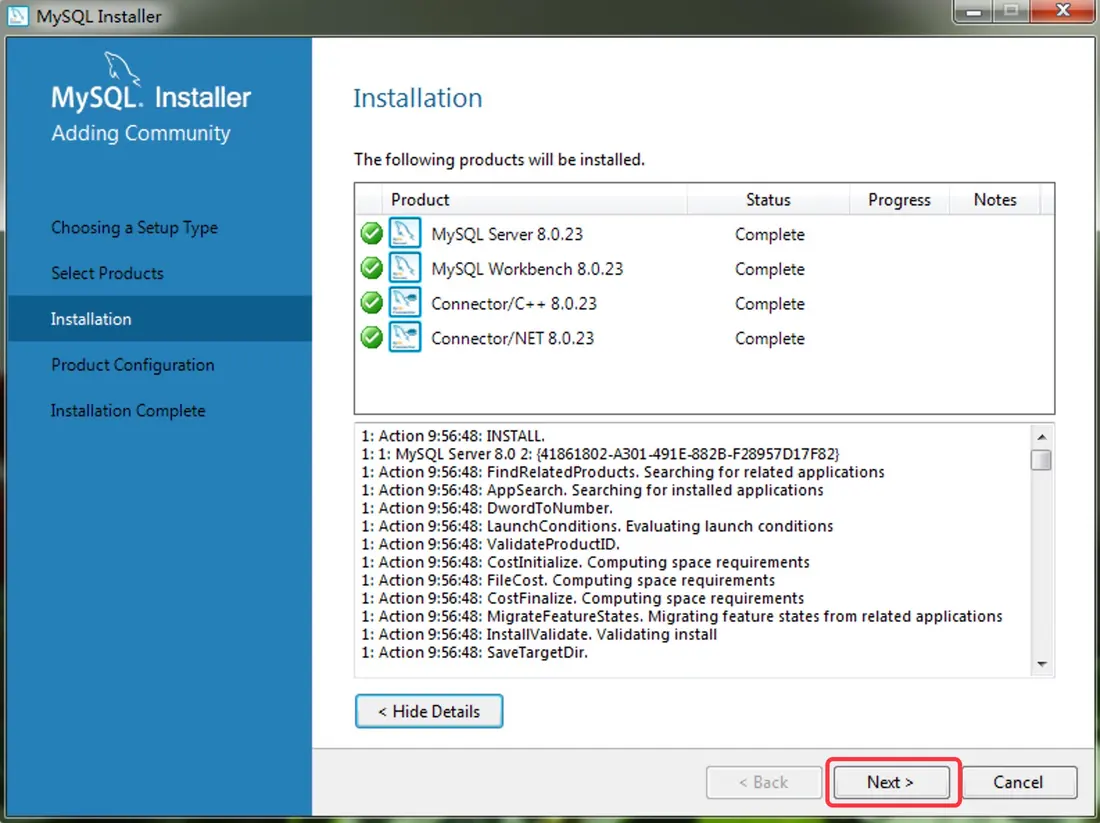
- 准备开始安装。
- 安装完成。
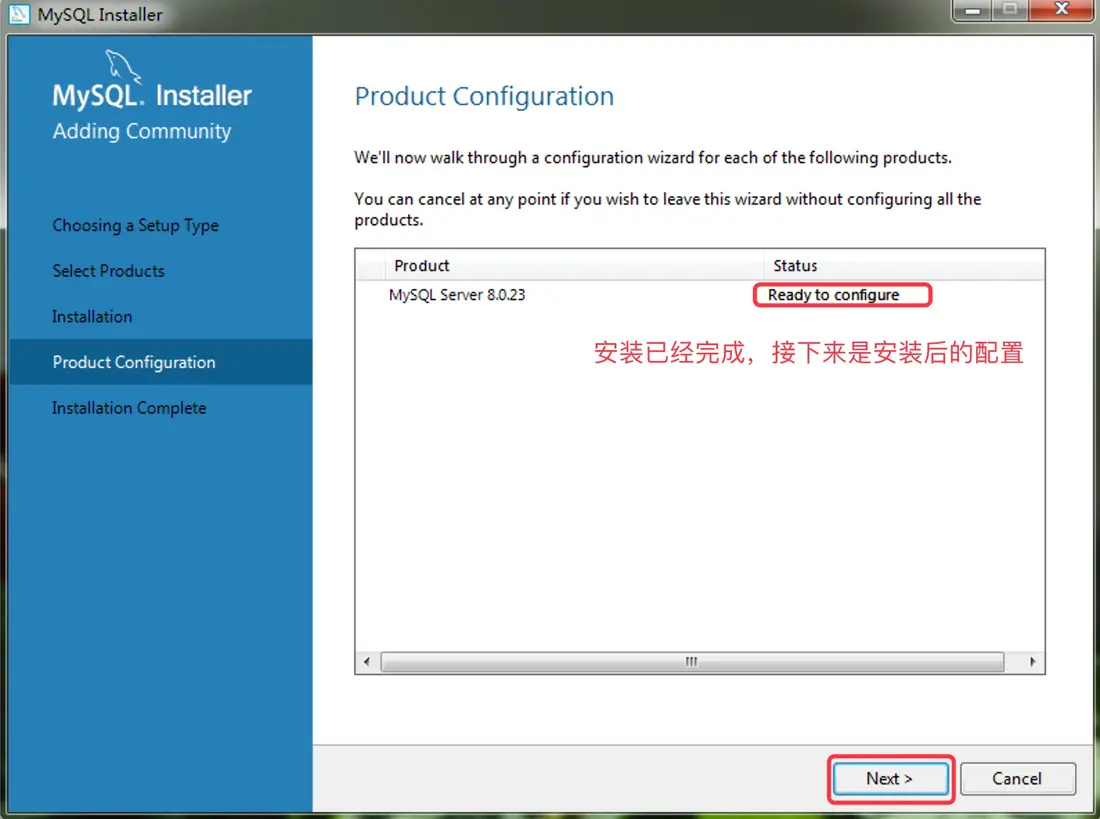
- 准备执行配置向导。
-
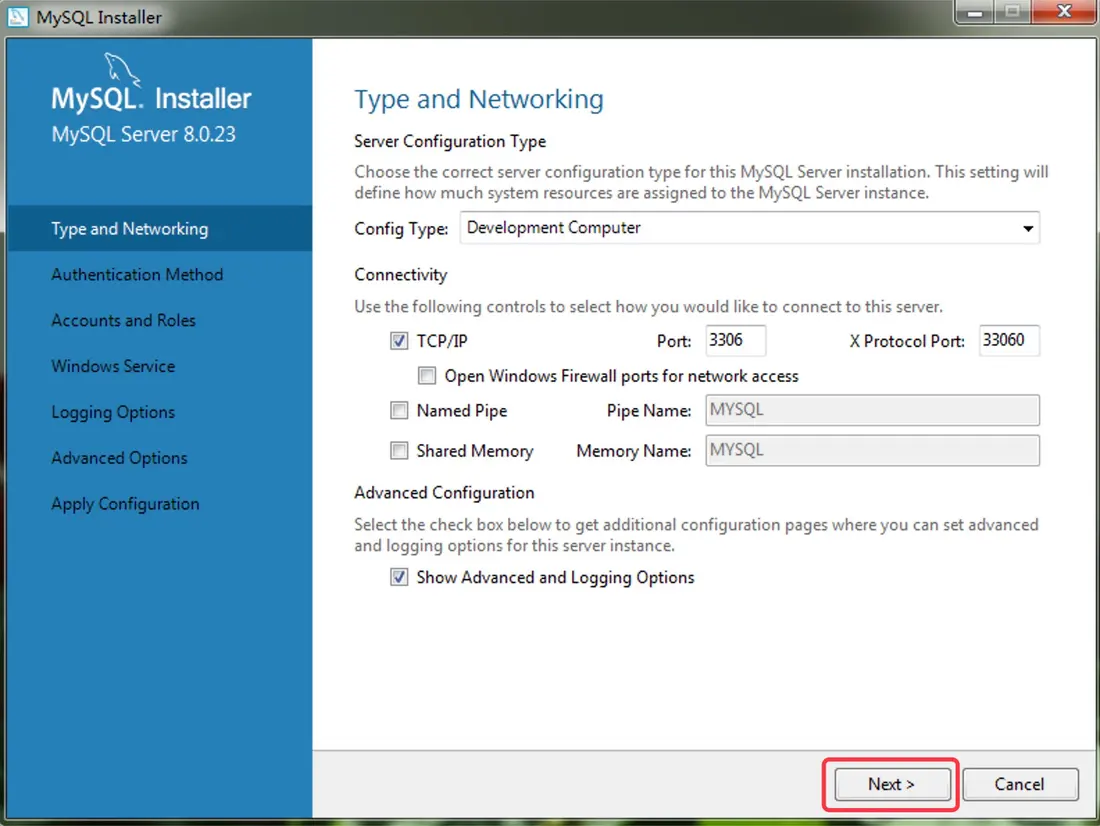
执行安装后的配置向导。
- 配置服务器类型和网络。
-
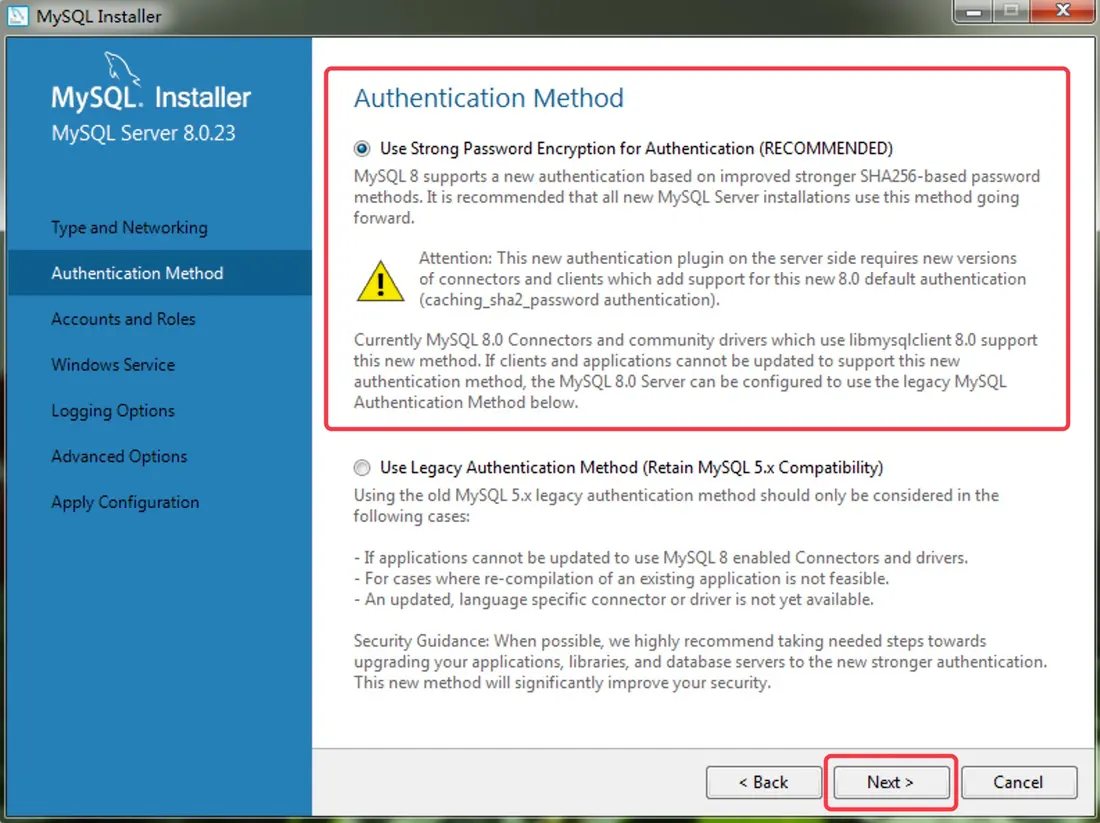
配置认证方法(保护密码的方式)。
-
配置用户和角色。
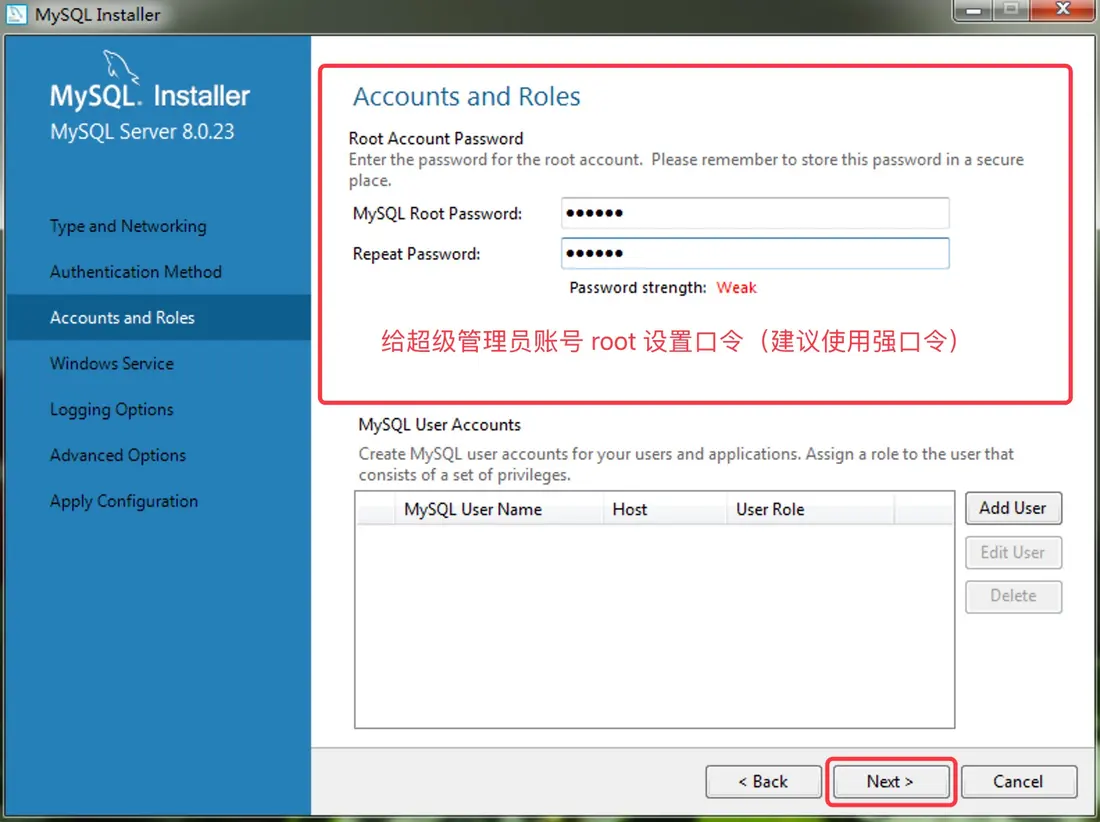
-
配置Windows服务名以及是否开机自启。
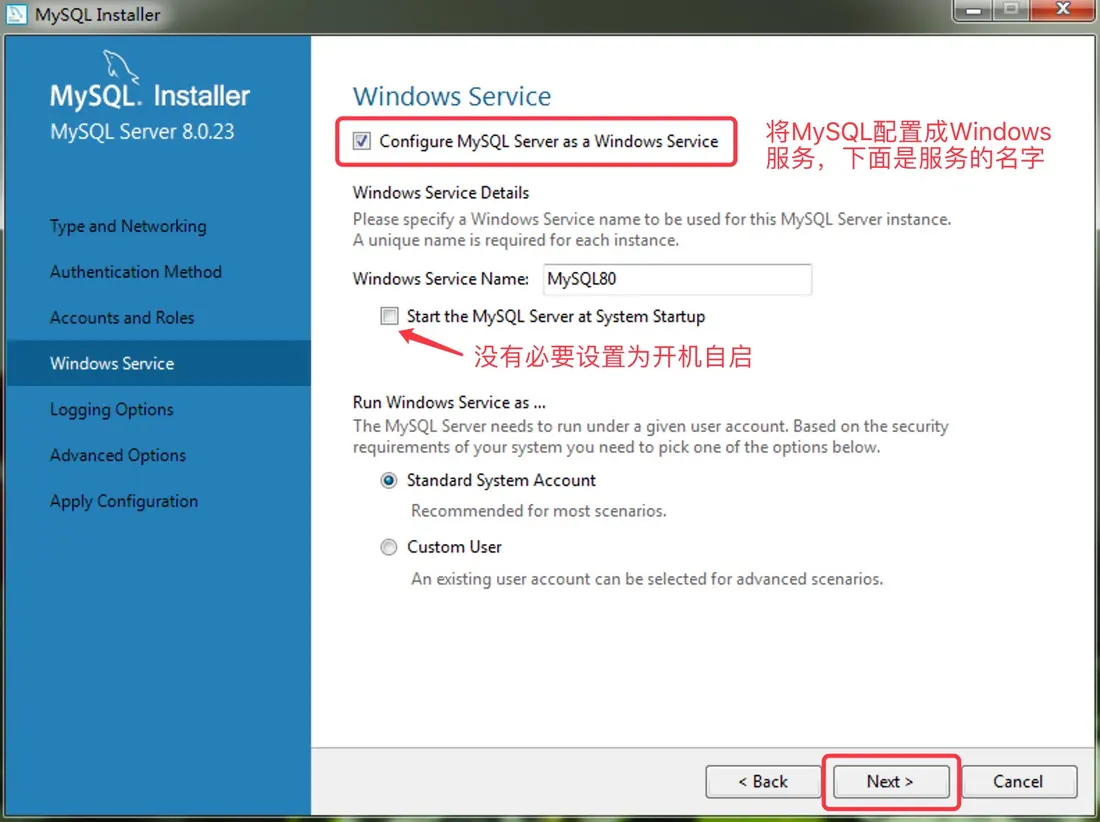
-
配置日志。
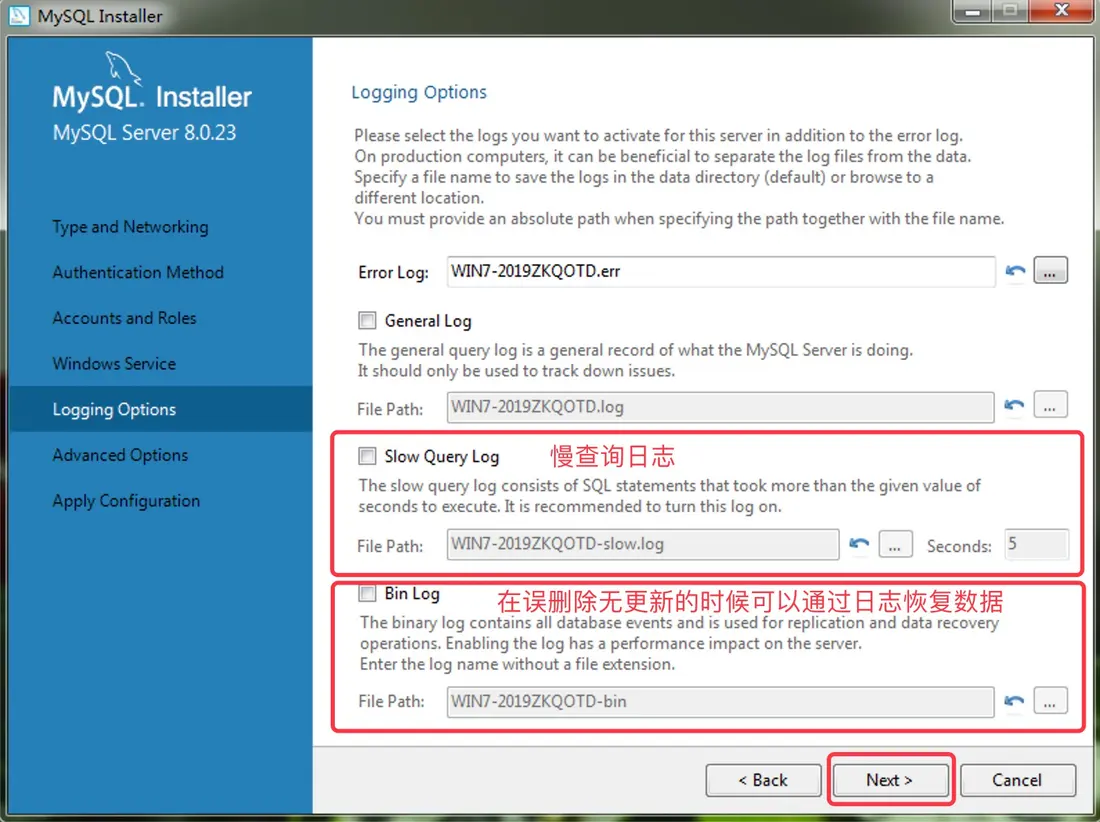
-
配置高级选项。
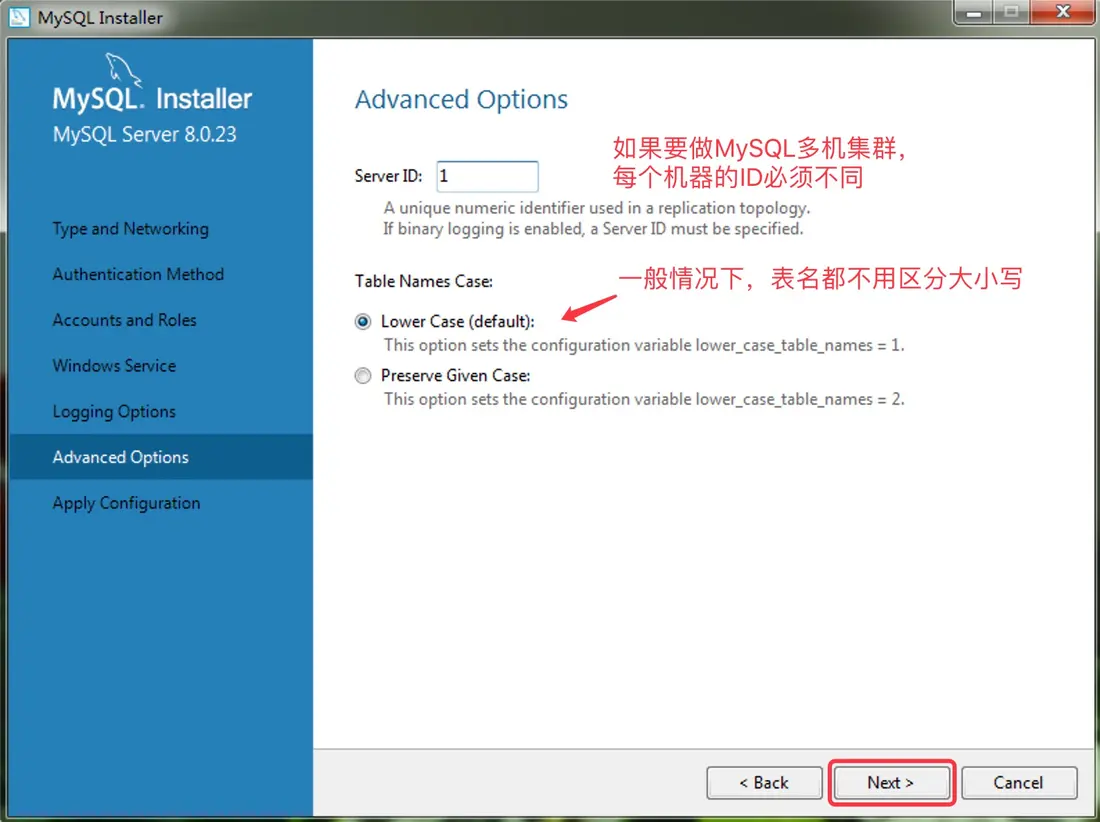
-
应用配置。
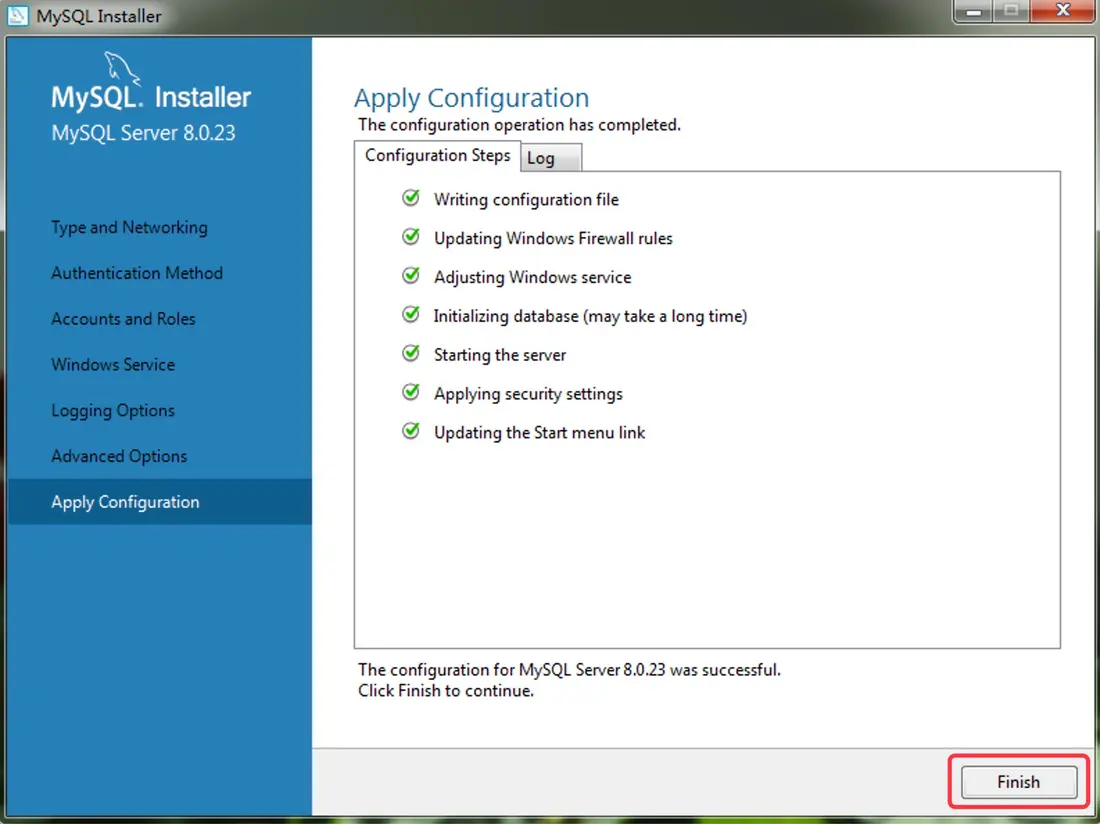
-
可以在 Windows 系统的“服务”窗口中启动或停止 MySQL。
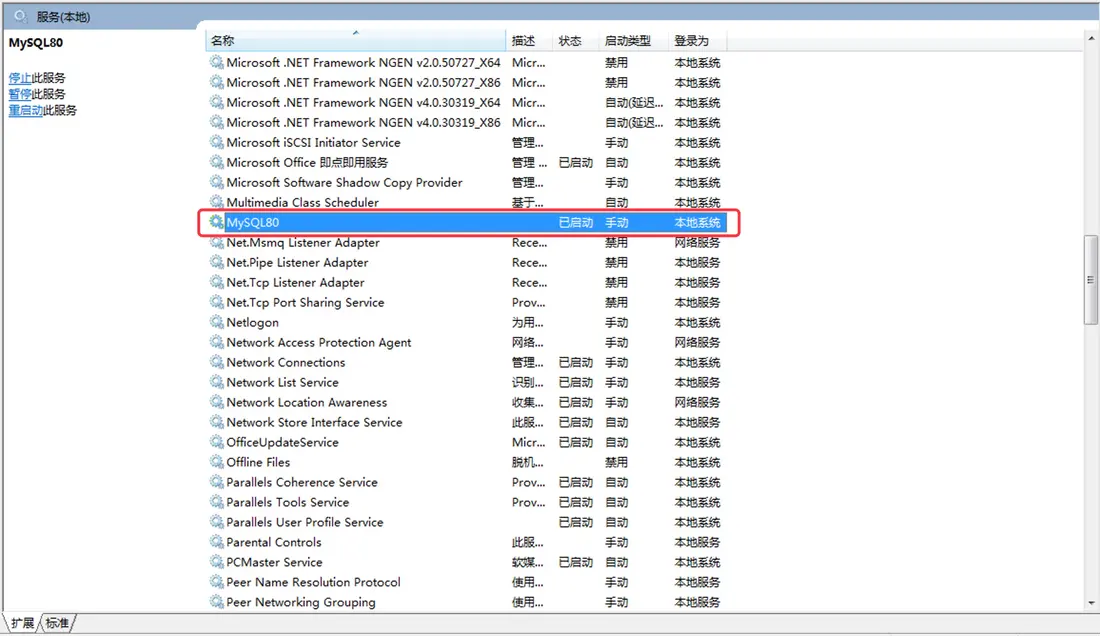
-
配置 PATH 环境变量,以便在命令行提示符窗口使用 MySQL 客户端工具。
-
打开 Windows 的“系统”窗口并点击“高级系统设置”。
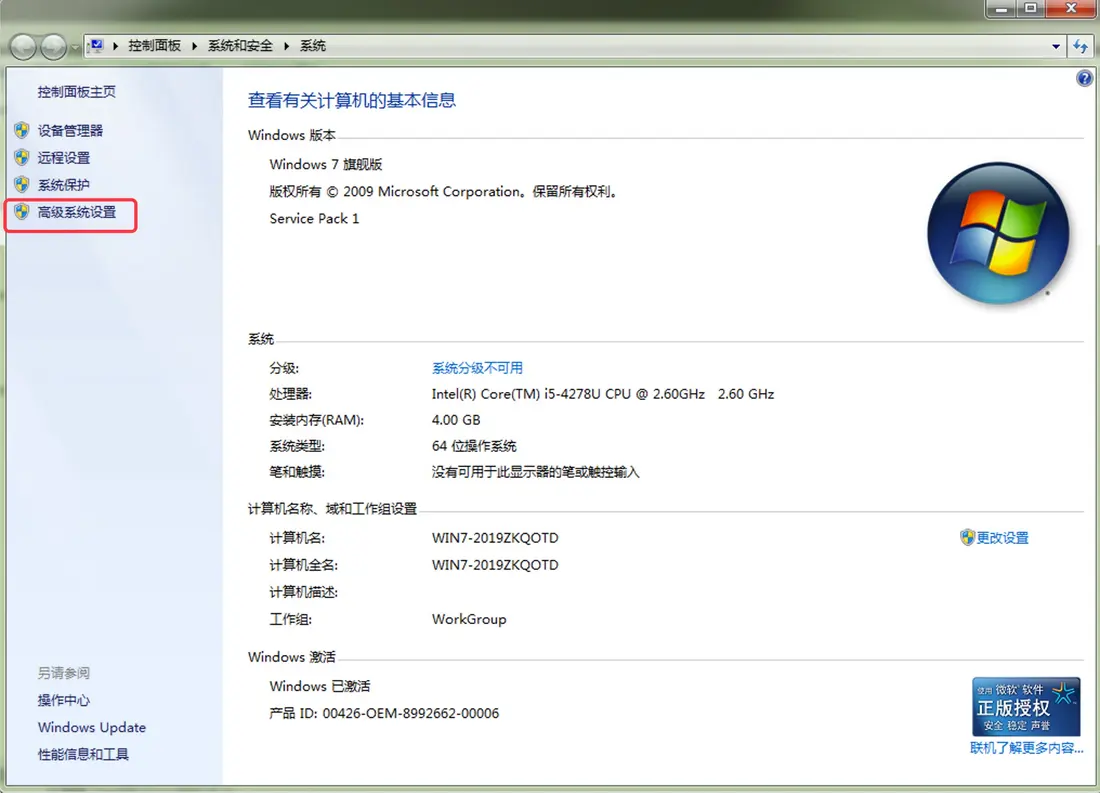
-
在“系统属性”的“高级”窗口,点击“环境变量”按钮。
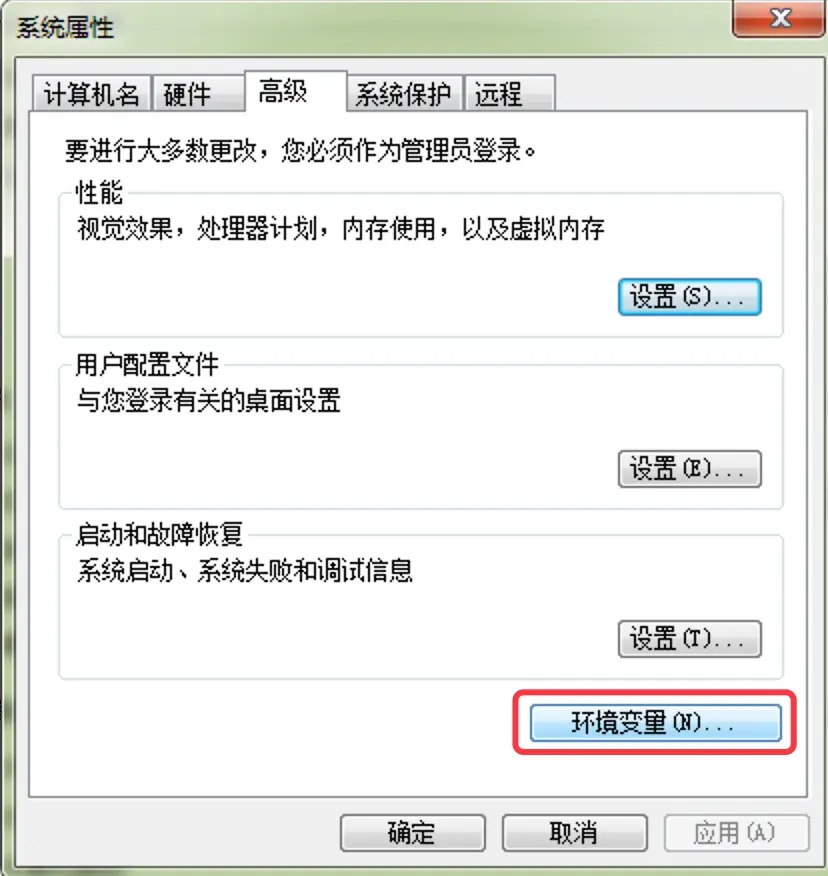
-
修改PATH环境变量,将MySQL安装路径下的
bin文件夹的路径配置到PATH环境变量中。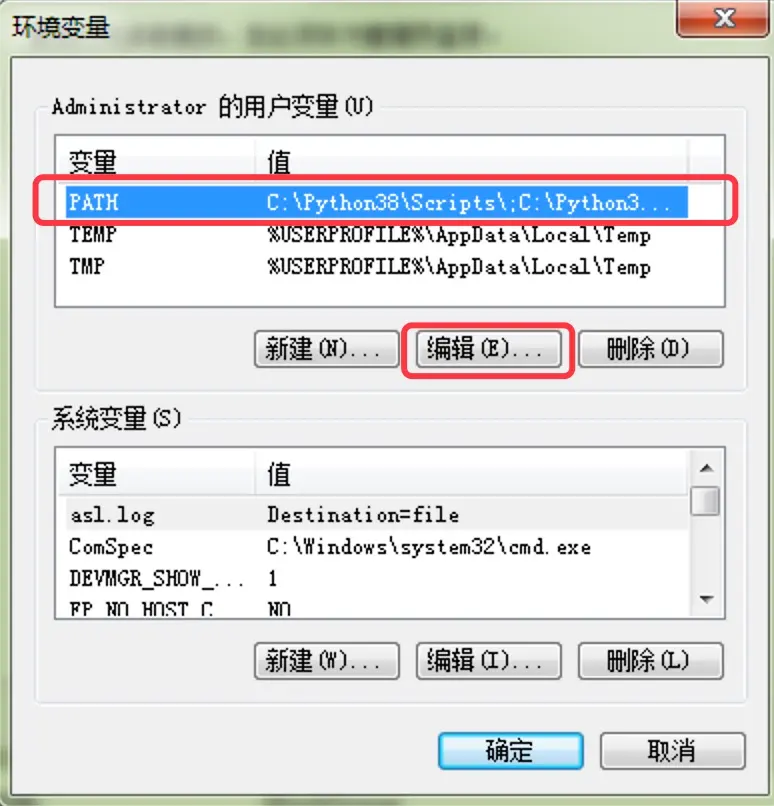
-
配置完成后,可以尝试在“命令提示符”下使用 MySQL 的命令行工具。
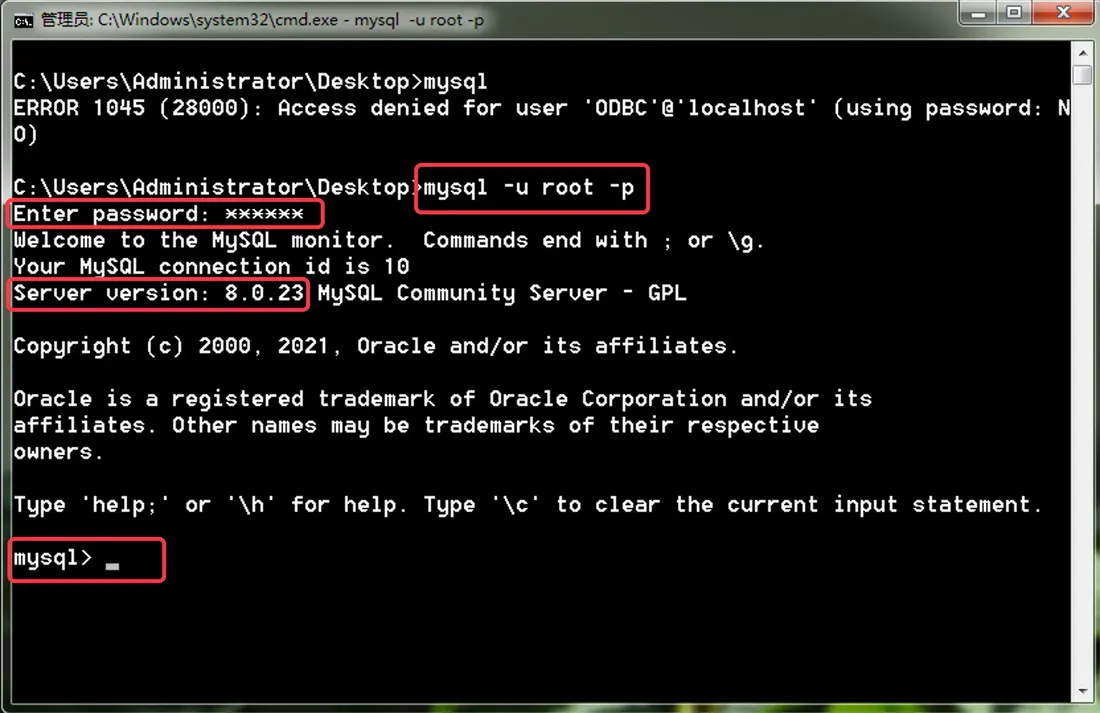
-
Linux 环境
下面以 CentOS 7.x 环境为例,演示如何安装 MySQL 5.7.x,如果需要在其他 Linux 系统下安装其他版本的 MySQL,请读者自行在网络上查找对应的安装教程。
-
安装 MySQL。
可以在 MySQL 官方网站下载安装文件。首先在下载页面中选择平台和版本,然后找到对应的下载链接,直接下载包含所有安装文件的归档文件,解归档之后通过包管理工具进行安装。
Terminal window wget https://dev.mysql.com/get/Downloads/MySQL-5.7/mysql-5.7.26-1.el7.x86_64.rpm-bundle.tartar -xvf mysql-5.7.26-1.el7.x86_64.rpm-bundle.tar如果系统上有 MariaDB 相关的文件,需要先移除 MariaDB 相关的文件。
Terminal window yum list installed | grep mariadb | awk '{print $1}' | xargs yum erase -y更新和安装可能用到的底层依赖库。
Terminal window yum updateyum install -y libaio libaio-devel接下来可以按照如下所示的顺序用 RPM(Redhat Package Manager)工具安装 MySQL。
Terminal window rpm -ivh mysql-community-common-5.7.26-1.el7.x86_64.rpmrpm -ivh mysql-community-libs-5.7.26-1.el7.x86_64.rpmrpm -ivh mysql-community-libs-compat-5.7.26-1.el7.x86_64.rpmrpm -ivh mysql-community-devel-5.7.26-1.el7.x86_64.rpmrpm -ivh mysql-community-client-5.7.26-1.el7.x86_64.rpmrpm -ivh mysql-community-server-5.7.26-1.el7.x86_64.rpm可以使用下面的命令查看已经安装的 MySQL 相关的包。
Terminal window rpm -qa | grep mysql -
配置 MySQL。
MySQL 的配置文件在
/etc目录下,名为my.cnf,默认的配置文件内容如下所示。Terminal window cat /etc/my.cnf# For advice on how to change settings please see# http://dev.mysql.com/doc/refman/5.7/en/server-configuration-defaults.html[mysqld]## Remove leading # and set to the amount of RAM for the most important data# cache in MySQL. Start at 70% of total RAM for dedicated server, else 10%.# innodb_buffer_pool_size = 128M## Remove leading # to turn on a very important data integrity option: logging# changes to the binary log between backups.# log_bin## Remove leading # to set options mainly useful for reporting servers.# The server defaults are faster for transactions and fast SELECTs.# Adjust sizes as needed, experiment to find the optimal values.# join_buffer_size = 128M# sort_buffer_size = 2M# read_rnd_buffer_size = 2Mdatadir=/var/lib/mysqlsocket=/var/lib/mysql/mysql.sock# Disabling symbolic-links is recommended to prevent assorted security riskssymbolic-links=0log-error=/var/log/mysqld.logpid-file=/var/run/mysqld/mysqld.pid通过配置文件,我们可以修改 MySQL 服务使用的端口、字符集、最大连接数、套接字队列大小、最大数据包大小、日志文件的位置、日志过期时间等配置。当然,我们还可以通过修改配置文件来对 MySQL 服务器进行性能调优和安全管控。
-
启动 MySQL 服务。
可以使用下面的命令来启动 MySQL。
Terminal window service mysqld start在 CentOS 7 中,更推荐使用下面的命令来启动 MySQL。
Terminal window systemctl start mysqld启动 MySQL 成功后,可以通过下面的命令来检查网络端口使用情况,MySQL 默认使用
3306端口。Terminal window netstat -ntlp | grep mysql也可以使用下面的命令查找是否有名为
mysqld的进程。Terminal window pgrep mysqld -
使用 MySQL 客户端工具连接服务器。
命令行工具:
Terminal window mysql -u root -p说明:启动客户端时,
-u参数用来指定用户名,MySQL 默认的超级管理账号为root;-p表示要输入密码(用户口令);如果连接的是其他主机而非本机,可以用-h来指定连接主机的主机名或IP地址。如果是首次安装 MySQL,可以使用下面的命令来找到默认的初始密码。
Terminal window cat /var/log/mysqld.log | grep password上面的命令会查看 MySQL 的日志带有
password的行,在显示的结果中root@localhost:后面的部分就是默认设置的初始密码。进入客户端工具后,可以通过下面的指令来修改超级管理员(root)的访问口令为
123456。set global validate_password_policy=0;set global validate_password_length=6;alter user 'root'@'localhost' identified by '123456';说明:MySQL 较新的版本默认不允许使用弱口令作为用户口令,所以上面的代码修改了验证用户口令的策略和口令的长度。事实上我们不应该使用弱口令,因为存在用户口令被暴力破解的风险。近年来,攻击数据库窃取数据和劫持数据库勒索比特币的事件屡见不鲜,要避免这些潜在的风险,最为重要的一点是不要让数据库服务器暴露在公网上(最好的做法是将数据库置于内网,至少要做到不向公网开放数据库服务器的访问端口),另外要保管好
root账号的口令,应用系统需要访问数据库时,通常不使用root账号进行访问,而是创建其他拥有适当权限的账号来访问。再次使用客户端工具连接 MySQL 服务器时,就可以使用新设置的口令了。在实际开发中,为了方便用户操作,可以选择图形化的客户端工具来连接 MySQL 服务器,包括:
-
MySQL Workbench(官方工具)
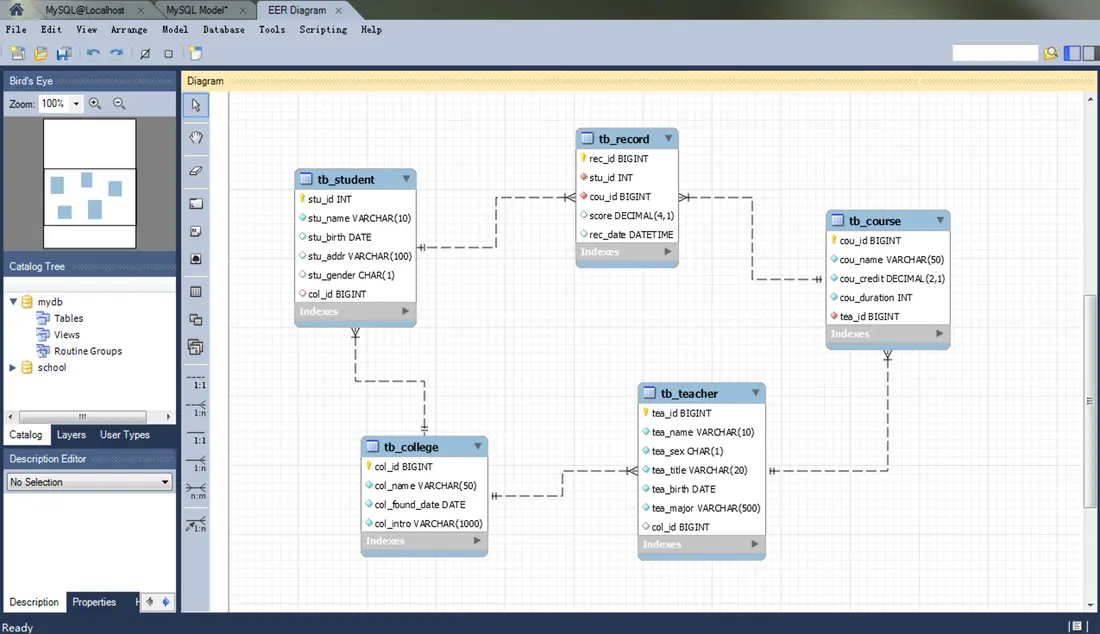
-
Navicat for MySQL(界面简单友好)
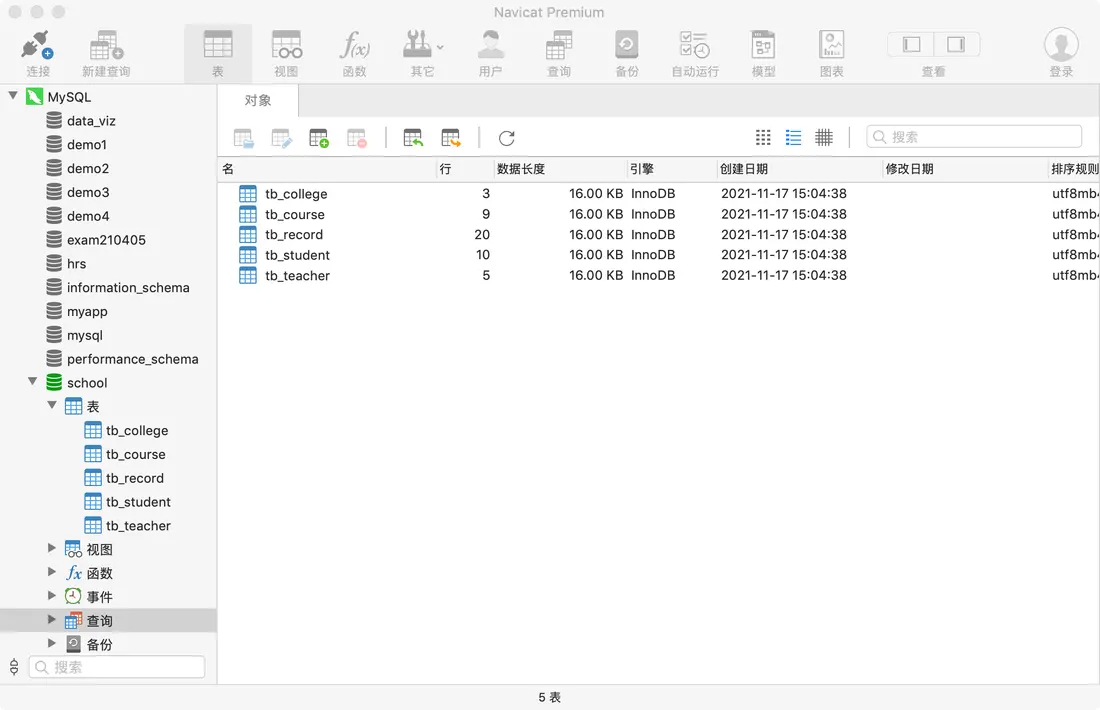
-
macOS环境
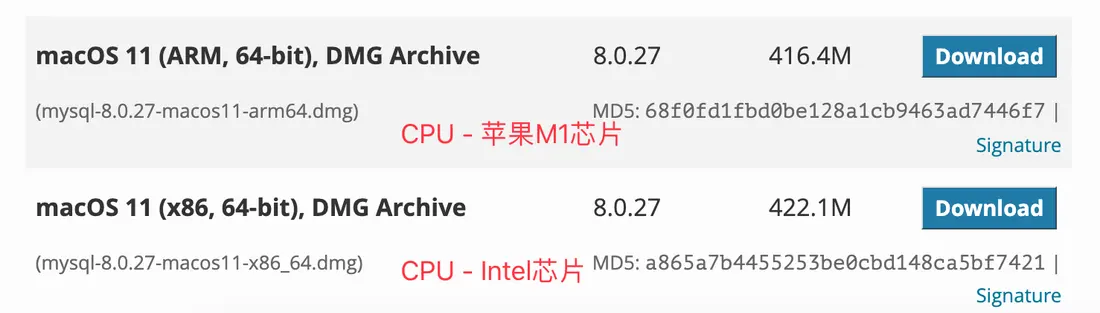
macOS 系统安装 MySQL 是比较简单的,只需要从刚才说到的官方网站下载 DMG 安装文件并运行就可以了,下载的时候需要根据自己使用的是 Intel 的芯片还是苹果的 M1 芯片选择下载链接,如下图所示。
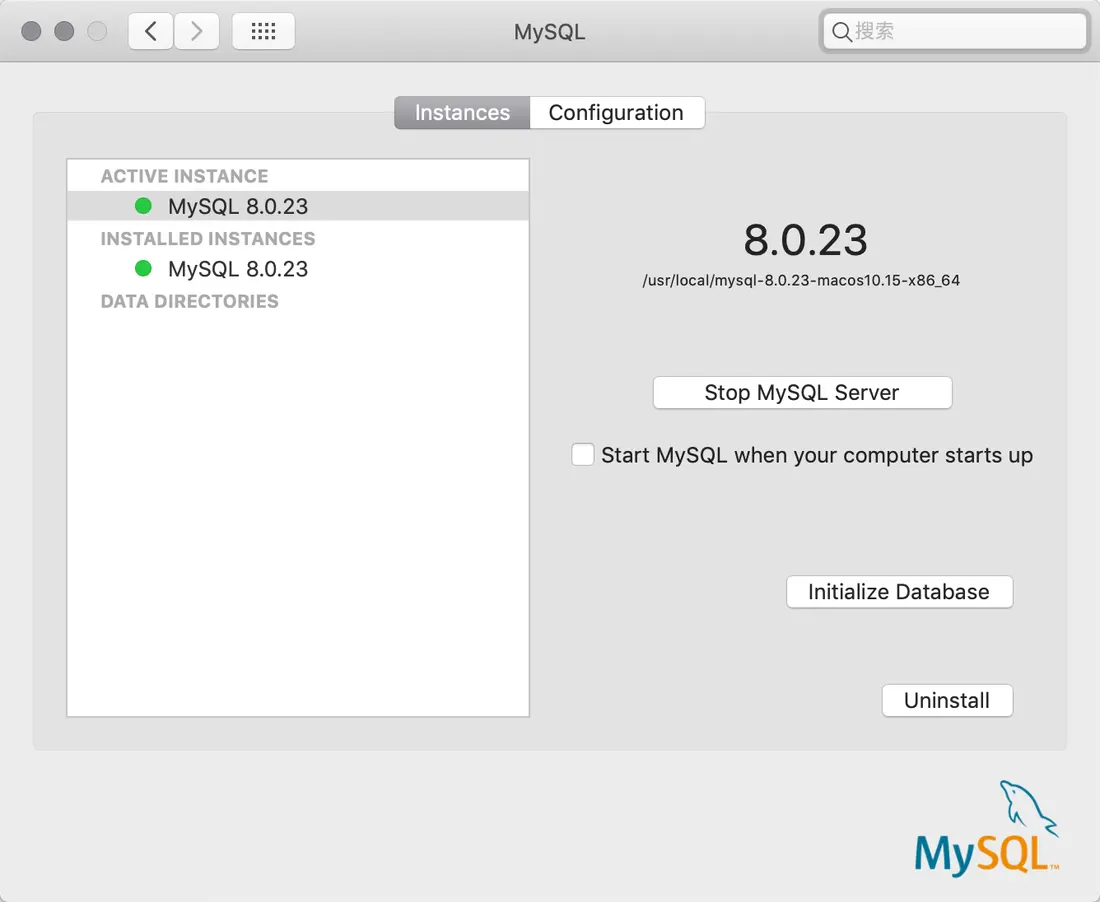
安装成功后,可以在“系统偏好设置”中找到“MySQL”,在如下所示的画面中,可以启动和停止 MySQL 服务器,也可以对 MySQL 核心文件的路径进行配置。
MySQL 基本命令
查看命令
- 查看所有数据库
show databases;- 查看所有字符集
show character set;- 查看所有的排序规则
show collation;- 查看所有的引擎
show engines;- 查看所有日志文件
show binary logs;- 查看数据库下所有表
show tables;获取帮助
在 MySQL 命令行工具中,可以使用help命令或?来获取帮助,如下所示。
-
查看
show命令的帮助。? show -
查看有哪些帮助内容。
? contents -
获取函数的帮助。
? functions -
获取数据类型的帮助。
? data types
其他命令
-
新建/重建服务器连接 -
connect/resetconnection。 -
清空当前输入 -
\c。在输入错误时,可以及时使用\c清空当前输入并重新开始。 -
修改终止符(定界符)-
delimiter。默认的终止符是;,可以使用该命令修改成其他的字符,例如修改为$符号,可以用delimiter $命令。 -
打开系统默认编辑器 -
edit。编辑完成保存关闭之后,命令行会自动执行编辑的内容。 -
查看服务器状态 -
status。 -
修改默认提示符 -
prompt。 -
执行系统命令 -
system。可以将系统命令跟在system命令的后面执行,system命令也可以缩写为\!。 -
执行 SQL 文件 -
source。source命令后面跟 SQL 文件路径。 -
重定向输出 -
tee/notee。可以将命令的输出重定向到指定的文件中。 -
切换数据库 -
use。 -
显示警告信息 -
warnings。 -
退出命令行 -
quit或exit。
37 SQL详解之DDL
我们通常可以将 SQL 分为四类,分别是 DDL(数据定义语言)、DML(数据操作语言)、 DCL(数据控制语言)和 TCL(事务控制语言)。DDL 主要用于创建、删除、修改数据库中的对象,比如创建、删除和修改二维表,核心的关键字包括create、drop和alter;DML 主要负责数据的插入、删除、更新和查询,关键词包括insert、delete、update和select;DCL 用于授予和召回权限,核心关键词是grant和revoke;TCL 通常用于事务控制。
说明:SQL 是不区分大小写的语言,一般情况下我们建议将关键字大写,其他部分小写。 如果公司的 SQL 编程规范有强制规定,那么就按照公司的要求来,个人的喜好不应该凌驾于公司的编程规范之上,这一点对职业人来说应该是常识。
建库建表
下面我们来实现一个非常简单的学校选课系统的数据库。我们将数据库命名为school,四个关键的实体分别是学院、老师、学生和课程,其中,学生跟学院是从属关系,这个关系从数量上来讲是多对一关系,因为一个学院可以有多名学生,而一个学生通常只属于一个学院;同理,老师跟学院的从属关系也是多对一关系。一名老师可以讲授多门课程,一门课程如果只有一个授课老师的话,那么课程跟老师也是多对一关系;如果允许多个老师合作讲授一门课程,那么课程和老师就是多对多关系。简单起见,我们将课程和老师设计为多对一关系。学生和课程是典型的多对多关系,因为一个学生可以选择多门课程,一门课程也可以被多个学生选择,而关系型数据库需要借助中间表才能维持维持两个实体的多对多关系。最终,我们的学校选课系统一共有五张表,分别是学院表(tb_college)、学生表(tb_student)、教师表(tb_teacher)、课程表(tb_course)和选课记录表(tb_record),其中选课记录表就是维持学生跟课程多对多关系的中间表。
-- 如果存在名为school的数据库就删除它DROP DATABASE IF EXISTS `school`;
-- 创建名为school的数据库并设置默认的字符集和排序方式CREATE DATABASE `school` DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci;
-- 切换到school数据库上下文环境USE `school`;
-- 创建学院表CREATE TABLE `tb_college`(`col_id` int unsigned AUTO_INCREMENT COMMENT '编号',`col_name` varchar(50) NOT NULL COMMENT '名称',`col_intro` varchar(500) NOT NULL DEFAULT '' COMMENT '介绍',PRIMARY KEY (`col_id`));
-- 创建学生表CREATE TABLE `tb_student`(`stu_id` int unsigned NOT NULL COMMENT '学号',`stu_name` varchar(20) NOT NULL COMMENT '姓名',`stu_sex` boolean NOT NULL DEFAULT 1 COMMENT '性别',`stu_birth` date NOT NULL COMMENT '出生日期',`stu_addr` varchar(255) DEFAULT '' COMMENT '籍贯',`col_id` int unsigned NOT NULL COMMENT '所属学院',PRIMARY KEY (`stu_id`),CONSTRAINT `fk_student_col_id` FOREIGN KEY (`col_id`) REFERENCES `tb_college` (`col_id`));
-- 创建教师表CREATE TABLE `tb_teacher`(`tea_id` int unsigned NOT NULL COMMENT '工号',`tea_name` varchar(20) NOT NULL COMMENT '姓名',`tea_title` varchar(10) NOT NULL DEFAULT '助教' COMMENT '职称',`col_id` int unsigned NOT NULL COMMENT '所属学院',PRIMARY KEY (`tea_id`),CONSTRAINT `fk_teacher_col_id` FOREIGN KEY (`col_id`) REFERENCES `tb_college` (`col_id`));
-- 创建课程表CREATE TABLE `tb_course`(`cou_id` int unsigned NOT NULL COMMENT '编号',`cou_name` varchar(50) NOT NULL COMMENT '名称',`cou_credit` int NOT NULL COMMENT '学分',`tea_id` int unsigned NOT NULL COMMENT '授课老师',PRIMARY KEY (`cou_id`),CONSTRAINT `fk_course_tea_id` FOREIGN KEY (`tea_id`) REFERENCES `tb_teacher` (`tea_id`));
-- 创建选课记录表CREATE TABLE `tb_record`(`rec_id` bigint unsigned AUTO_INCREMENT COMMENT '选课记录号',`stu_id` int unsigned NOT NULL COMMENT '学号',`cou_id` int unsigned NOT NULL COMMENT '课程编号',`sel_date` date NOT NULL COMMENT '选课日期',`score` decimal(4,1) COMMENT '考试成绩',PRIMARY KEY (`rec_id`),CONSTRAINT `fk_record_stu_id` FOREIGN KEY (`stu_id`) REFERENCES `tb_student` (`stu_id`),CONSTRAINT `fk_record_cou_id` FOREIGN KEY (`cou_id`) REFERENCES `tb_course` (`cou_id`),CONSTRAINT `uk_record_stu_cou` UNIQUE (`stu_id`, `cou_id`));上面的DDL有几个地方需要强调一下:
-
首先,上面 SQL 中的数据库名、表名、字段名都被反引号(`)包裹起来,反引号并不是必须的,但是却可以解决表名、字段名等跟 SQL 关键字(SQL 中有特殊含义的单词)冲突的问题。
-
创建数据库时,我们通过
default character set utf8mb4指定了数据库默认使用的字符集为utf8mb4(最大4字节的utf-8编码),我们推荐使用该字符集,它也是 MySQL 8.x 默认使用的字符集,因为它能够支持国际化编码,还可以存储 Emoji 字符。可以通过下面的命令查看 MySQL 支持的字符集以及默认的排序规则。show character set;+----------+---------------------------------+---------------------+--------+| Charset | Description | Default collation | Maxlen |+----------+---------------------------------+---------------------+--------+| big5 | Big5 Traditional Chinese | big5_chinese_ci | 2 || dec8 | DEC West European | dec8_swedish_ci | 1 || cp850 | DOS West European | cp850_general_ci | 1 || hp8 | HP West European | hp8_english_ci | 1 || koi8r | KOI8-R Relcom Russian | koi8r_general_ci | 1 || latin1 | cp1252 West European | latin1_swedish_ci | 1 || latin2 | ISO 8859-2 Central European | latin2_general_ci | 1 || swe7 | 7bit Swedish | swe7_swedish_ci | 1 || ascii | US ASCII | ascii_general_ci | 1 || ujis | EUC-JP Japanese | ujis_japanese_ci | 3 || sjis | Shift-JIS Japanese | sjis_japanese_ci | 2 || hebrew | ISO 8859-8 Hebrew | hebrew_general_ci | 1 || tis620 | TIS620 Thai | tis620_thai_ci | 1 || euckr | EUC-KR Korean | euckr_korean_ci | 2 || koi8u | KOI8-U Ukrainian | koi8u_general_ci | 1 || gb2312 | GB2312 Simplified Chinese | gb2312_chinese_ci | 2 || greek | ISO 8859-7 Greek | greek_general_ci | 1 || cp1250 | Windows Central European | cp1250_general_ci | 1 || gbk | GBK Simplified Chinese | gbk_chinese_ci | 2 || latin5 | ISO 8859-9 Turkish | latin5_turkish_ci | 1 || armscii8 | ARMSCII-8 Armenian | armscii8_general_ci | 1 || utf8 | UTF-8 Unicode | utf8_general_ci | 3 || ucs2 | UCS-2 Unicode | ucs2_general_ci | 2 || cp866 | DOS Russian | cp866_general_ci | 1 || keybcs2 | DOS Kamenicky Czech-Slovak | keybcs2_general_ci | 1 || macce | Mac Central European | macce_general_ci | 1 || macroman | Mac West European | macroman_general_ci | 1 || cp852 | DOS Central European | cp852_general_ci | 1 || latin7 | ISO 8859-13 Baltic | latin7_general_ci | 1 || utf8mb4 | UTF-8 Unicode | utf8mb4_general_ci | 4 || cp1251 | Windows Cyrillic | cp1251_general_ci | 1 || utf16 | UTF-16 Unicode | utf16_general_ci | 4 || utf16le | UTF-16LE Unicode | utf16le_general_ci | 4 || cp1256 | Windows Arabic | cp1256_general_ci | 1 || cp1257 | Windows Baltic | cp1257_general_ci | 1 || utf32 | UTF-32 Unicode | utf32_general_ci | 4 || binary | Binary pseudo charset | binary | 1 || geostd8 | GEOSTD8 Georgian | geostd8_general_ci | 1 || cp932 | SJIS for Windows Japanese | cp932_japanese_ci | 2 || eucjpms | UJIS for Windows Japanese | eucjpms_japanese_ci | 3 || gb18030 | China National Standard GB18030 | gb18030_chinese_ci | 4 |+----------+---------------------------------+---------------------+--------+41 rows in set (0.00 sec)如果要设置 MySQL 服务启动时默认使用的字符集,可以修改MySQL的配置并添加以下内容。
[mysqld]character-set-server=utf8提示:如果不清楚如何修改 MySQL 的配置文件就先不要管它。
-
创建和删除数据库时,关键字
database也可以替换为schema,二者作用相同。 -
建表语句中的
not null是非空约束,它限定了字段不能为空;default用于为字段指定默认值,我们称之为默认值约束;primary key是主键约束,它设定了能够唯一确定一条记录的列,也确保了每条记录都是独一无二的,因为主键不允许重复;foreign key是外键约束,它维持了两张表的参照完整性,举个例子,由于学生表中为 col_id 字段添加了外键约束,限定其必须引用(references)学院表中的 col_id,因此学生表中的学院编号必须来自于学院表中的学院编号,不能够随意为该字段赋值。如果需要给主键约束、外键约束等起名字,可以使用constriant关键字并在后面跟上约束的名字。 -
建表语句中的
comment关键字用来给列和表添加注释,增强代码的可读性和可维护性。 -
在创建表的时候,可以自行选择底层的存储引擎。MySQL 支持多种存储引擎,可以通过
show engines命令进行查看。MySQL 5.5 以后的版本默认使用的存储引擎是 InnoDB,它是我们推荐大家使用的存储引擎(因为更适合当下互联网应用对高并发、性能以及事务支持等方面的需求),为了 SQL 语句的向下兼容性,我们可以在建表语句结束处右圆括号的后面通过engine=innodb来指定使用 InnoDB 存储引擎。show engines\G说明:上面的 \G 是为了换一种输出方式,在命令行客户端中,如果表的字段很多一行显示不完,就会导致输出的内容看起来非常不舒服,使用 \G 可以将记录的每个列以独占整行的的方式输出,这种输出方式在命令行客户端中看起来会舒服很多。
*************************** 1. row ***************************Engine: InnoDBSupport: DEFAULTComment: Supports transactions, row-level locking, and foreign keysTransactions: YESXA: YESSavepoints: YES*************************** 2. row ***************************Engine: MRG_MYISAMSupport: YESComment: Collection of identical MyISAM tablesTransactions: NOXA: NOSavepoints: NO*************************** 3. row ***************************Engine: MEMORYSupport: YESComment: Hash based, stored in memory, useful for temporary tablesTransactions: NOXA: NOSavepoints: NO*************************** 4. row ***************************Engine: BLACKHOLESupport: YESComment: /dev/null storage engine (anything you write to it disappears)Transactions: NOXA: NOSavepoints: NO*************************** 5. row ***************************Engine: MyISAMSupport: YESComment: MyISAM storage engineTransactions: NOXA: NOSavepoints: NO*************************** 6. row ***************************Engine: CSVSupport: YESComment: CSV storage engineTransactions: NOXA: NOSavepoints: NO*************************** 7. row ***************************Engine: ARCHIVESupport: YESComment: Archive storage engineTransactions: NOXA: NOSavepoints: NO*************************** 8. row ***************************Engine: PERFORMANCE_SCHEMASupport: YESComment: Performance SchemaTransactions: NOXA: NOSavepoints: NO*************************** 9. row ***************************Engine: FEDERATEDSupport: NOComment: Federated MySQL storage engineTransactions: NULLXA: NULLSavepoints: NULL9 rows in set (0.00 sec)下面的表格对MySQL几种常用的数据引擎进行了简单的对比。
特性 InnoDB MRG_MYISAM MEMORY MyISAM 存储限制 有 没有 有 有 事务 支持 锁机制 行锁 表锁 表锁 表锁 B树索引 支持 支持 支持 支持 哈希索引 支持 全文检索 支持(5.6+) 支持 集群索引 支持 数据缓存 支持 支持 索引缓存 支持 支持 支持 支持 数据可压缩 支持 内存使用 高 低 中 低 存储空间使用 高 低 低 批量插入性能 低 高 高 高 是否支持外键 支持 通过上面的比较我们可以了解到,InnoDB 是唯一能够支持外键、事务以及行锁的存储引擎,所以我们之前说它更适合互联网应用,而且在较新版本的 MySQL 中,它也是默认使用的存储引擎。
-
在定义表结构为每个字段选择数据类型时,如果不清楚哪个数据类型更合适,可以通过 MySQL 的帮助系统来了解每种数据类型的特性、数据的长度和精度等相关信息。
? data types说明:在 MySQLWorkbench 中,不能使用
?获取帮助,要使用对应的命令help。You asked for help about help category: "Data Types"For more information, type 'help <item>', where <item> is one of the followingtopics:AUTO_INCREMENTBIGINTBINARYBITBLOBBLOB DATA TYPEBOOLEANCHARCHAR BYTEDATEDATETIMEDECDECIMALDOUBLEDOUBLE PRECISIONENUMFLOATINTINTEGERLONGBLOBLONGTEXTMEDIUMBLOBMEDIUMINTMEDIUMTEXTSET DATA TYPESMALLINTTEXTTIMETIMESTAMPTINYBLOBTINYINTTINYTEXTVARBINARYVARCHARYEAR DATA TYPE获取 varchar 类型的帮助:
? varchar执行结果:
Name: 'VARCHAR'Description:[NATIONAL] VARCHAR(M) [CHARACTER SET charset_name] [COLLATEcollation_name]A variable-length string. M represents the maximum column length incharacters. The range of M is 0 to 65,535. The effective maximum lengthof a VARCHAR is subject to the maximum row size (65,535 bytes, which isshared among all columns) and the character set used. For example, utf8characters can require up to three bytes per character, so a VARCHARcolumn that uses the utf8 character set can be declared to be a maximumof 21,844 characters. Seehttp://dev.mysql.com/doc/refman/5.7/en/column-count-limit.html.MySQL stores VARCHAR values as a 1-byte or 2-byte length prefix plusdata. The length prefix indicates the number of bytes in the value. AVARCHAR column uses one length byte if values require no more than 255bytes, two length bytes if values may require more than 255 bytes.*Note*:MySQL follows the standard SQL specification, and does not removetrailing spaces from VARCHAR values.VARCHAR is shorthand for CHARACTER VARYING. NATIONAL VARCHAR is thestandard SQL way to define that a VARCHAR column should use somepredefined character set. MySQL uses utf8 as this predefined characterset. http://dev.mysql.com/doc/refman/5.7/en/charset-national.html.NVARCHAR is shorthand for NATIONAL VARCHAR.URL: http://dev.mysql.com/doc/refman/5.7/en/string-type-overview.html在数据类型的选择上,保存字符串数据通常都使用 VARCHAR 和 CHAR 两种类型,前者通常称为变长字符串,而后者通常称为定长字符串;对于 InnoDB 存储引擎,行存储格式没有区分固定长度和可变长度列,因此 VARCHAR 类型和 CHAR 类型没有本质区别,后者不一定比前者性能更好。如果要保存的很大字符串,可以使用 TEXT 类型;如果要保存很大的字节串,可以使用 BLOB(二进制大对象)类型。在 MySQL 中,TEXT 和 BLOB又分别包括 TEXT、MEDIUMTEXT、LONGTEXT 和 BLOB、MEDIUMBLOB、LONGBLOB 三种不同的类型,它们主要的区别在于存储数据的最大大小不同。保存浮点数可以用 FLOAT 或 DOUBLE 类型,FLOAT 已经不推荐使用了,而且在 MySQL 后续的版本中可能会被移除掉。而保存定点数应该使用 DECIMAL 类型,它可以指定小数点前后有效数字的位数。如果要保存时间日期,DATETIME 类型优于 TIMESTAMP 类型,因为前者能表示的时间日期范围更大,后者底层其实就是一个整数,记录了指定的日期时间和 1970-01-01 00:00:00 相差多少个毫秒,该类型在 2038-01-19 03:14:07 之后就会溢出。
对于自增字段 AUTO_INCREMENT,如果使用 MySQL 5.x 版本要注意自增字段的回溯问题,当然这个问题在 MySQL 8.x 中已经得到了很好的解决,当然,MySQL 8.x 还有很多其他的好处,不管是功能还是性能上都有很多的优化和调整,因此强烈推荐大家使用 MySQL 8.x 版本。对于高并发访问数据库的场景,AUTO_INCREMENT 不仅存在性能上的问题,还可能在多机结构上产生重复的 ID 值,在这种场景下,使用分布式 ID 生成算法(SnowFlake、TinyID等)才是最好的选择,有兴趣的读者可以自行研究。
删除表和修改表
下面以学生表为例,为大家说明如何删除表和修改表。删除表可以使用drop table,代码如下所示。
DROP TABLE `tb_student`;或
DROP TABLE IF EXISTS `tb_student`;需要注意的是,如果学生表已经录入了数据而且该数据被其他表引用了,那么就不能删除学生表,否则上面的操作会报错。在下一课中,我们会讲解如何向表中插入数据,到时候大家可以试一试,能否顺利删除学生表。
如果要修改学生表,可以使用alter table,具体可以分为以下几种情况:
修改表,添加一个新列,例如给学生表添加一个联系电话的列。
ALTER TABLE `tb_student` ADD COLUMN `stu_tel` varchar(20) NOT NULL COMMENT '联系电话';注意:如果新增列的时候指定了非空约束(
not null),那么学生表不能够有数据,否则原来的数据增加了 stu_tel 列之后是没有数据的,这就违反了非空约束的要求;当然,我们在添加列的时候也可以使用默认值约束来解决这个问题。
修改表,删除指定的列,例如将上面添加的联系电话列删除掉。
ALTER TABLE `tb_student` DROP COLUMN `stu_tel`;修改表,修改列的数据类型,例如将学生表的 stu_sex 修改为字符。
ALTER TABLE `tb_student` MODIFY COLUMN `stu_sex` char(1) NOT NULL DEFAULT 'M' COMMENT '性别';修改表,修改列的命名,例如将学生表的 stu_sex 修改为 stu_gender。
ALTER TABLE `tb_student` CHANGE COLUMN `stu_sex` `stu_gender` boolean DEFAULT 1 COMMENT '性别';修改表,删除约束条件,例如删除学生表的 col_id 列的外键约束。
ALTER TABLE `tb_student` DROP FOREIGN KEY `fk_student_col_id`;修改表,添加约束条件,例如给学生表的 col_id 列加上外键约束。
ALTER TABLE `tb_student` ADD FOREIGN KEY (`col_id`) REFERENCES `tb_college` (`col_id`);或
ALTER TABLE `tb_student` ADD CONSTRAINT `fk_student_col_id` FOREIGN KEY (`col_id`) REFERENCES `tb_college` (`col_id`);说明:在添加外键约束时,还可以通过
on update和on delete来指定在被引用的表发生删除和更新操作时,应该进行何种处理,二者的默认值都是restrict,表示如果存在外键约束,则不允许更新和删除被引用的数据。除了restrict之外,这里可能的取值还有cascade(级联操作)和set null(设置为空),有兴趣的读者可以自行研究。
修改表的名字,例如将学生表的名字修改为 tb_stu_info。
ALTER TABLE `tb_student` RENAME TO `tb_stu_info`;提示:一般情况下,请不要轻易修改数据库或表的名字。
38 SQL详解之DML
我们接着上一课中创建的学校选课系统数据库,为大家讲解 DML 的使用。DML 可以帮助将数据插入到二维表(insert操作)、从二维表删除数据(delete操作)以及更新二维表的数据(update操作)。在执行 DML 之前,我们先通过下面的use命令切换到school数据库。
USE `school`;insert操作
顾名思义,insert是用来插入行到二维表中的,插入的方式包括:插入完整的行、插入行的一部分、插入多行、插入查询的结果。我们通过如下所示的 SQL 向学院表中添加一个学院。
INSERT INTO `tb_college`VALUES (DEFAULT, '计算机学院', '学习计算机科学与技术的地方');其中,由于学院表的主键是一个自增字段,因此上面的 SQL 中用default表示该列使用默认值,我们也可以使用下面的方式完成同样的操作。
INSERT INTO `tb_college` (`col_name`, `col_intro`)VALUES ('计算机学院', '学习计算机科学与技术的地方');我们推荐大家使用下面这种做法,指定为哪些字段赋值,这样做可以不按照建表时设定的字段顺序赋值,可以按照values前面的元组中给定的字段顺序为字段赋值,但是需要注意,除了允许为null和有默认值的字段外,其他的字段都必须要一一列出并在values后面的元组中为其赋值。如果希望一次性插入多条记录,我们可以在values后面跟上多个元组来实现批量插入,代码如下所示。
INSERT INTO `tb_college` (`col_name`, `col_intro`)VALUES ('外国语学院', '学习歪果仁的语言的学院'), ('经济管理学院', '经世济民,治理国家;管理科学,兴国之道'), ('体育学院', '发展体育运动,增强人民体质');在插入数据时,要注意主键是不能重复的,如果插入的数据与表中已有记录主键相同,那么insert操作将会产生 Duplicated Entry 的报错信息。再次提醒大家,如果insert操作省略了某些列,那么这些列要么有默认值,要么允许为null,否则也将产生错误。在业务系统中,为了让insert操作不影响其他操作(主要是后面要讲的select操作)的性能,可以在insert和into之间加一个low_priority来降低insert操作的优先级,这个做法也适用于下面要讲的delete和update操作。
假如有一张名为tb_temp的表中有a和b两个列,分别保存了学院的名称和学院的介绍,我们也可以通过查询操作获得tb_temp表的数据并插入到学院表中,如下所示,其中的select就是我们之前提到的 DQL,在下一课中会详细讲解。
INSERT INTO `tb_college` (`col_name`, `col_intro`)SELECT `a`, `b` FROM `tb_temp`;delete 操作
如果需要从表中删除数据,可以使用delete操作,它可以帮助我们删除指定行或所有行,例如我们要删除编号为1的学院,就可以使用如下所示的 SQL。
DELETE FROM `tb_college` WHERE col_id=1;注意,上面的delete操作中的where子句是用来指定条件的,只有满足条件的行会被删除。如果我们不小心写出了下面的 SQL,就会删除学院表中所有的记录,这是相当危险的,在实际工作中通常也不会这么做。
DELETE FROM `tb_college`;需要说明的是,即便删除了所有的数据,delete操作不会删除表本身,也不会让 AUTO_INCREMENT 字段的值回到初始值。如果需要删除所有的数据而且让 AUTO_INCREMENT 字段回到初始值,可以使用truncate table执行截断表操作,truncate的本质是删除原来的表并重新创建一个表,它的速度其实更快,因为不需要逐行删除数据。但是请大家记住一点,用truncate table删除数据是非常危险的,因为它会删除所有的数据,而且由于原来的表已经被删除了,要想恢复误删除的数据也会变得极为困难。
update 操作
如果要修改表中的数据,可以使用update操作,它可以用来删除指定的行或所有的行。例如,我们将学生表中的“杨过”修改为“杨逍”,这里我们假设“杨过”的学号为1001,代码如下所示。
UPDATE `tb_student` SET `stu_name`='杨逍' WHERE `stu_id`=1001;注意上面 SQL 中的where子句,我们使用学号作为条件筛选出对应的学生,然后通过前面的赋值操作将其姓名修改为“杨逍”。这里为什么不直接使用姓名作为筛选条件,那是因为学生表中可能有多个名为“杨过”的学生,如果使用 stu_name 作为筛选条件,那么我们的update操作有可能会一次更新多条数据,这显然不是我们想要看到的。还有一个需要注意的地方是update操作中的set关键字,因为 SQL 中的=并不表示赋值,而是判断相等的运算符,只有出现在set 关键字后面的=,才具备赋值的能力。
如果要同时修改学生的姓名和生日,我们可以对上面的update语句稍作修改,如下所示。
UPDATE `tb_student` SET `stu_name`='杨逍' , `stu_birth`='1975-12-29' WHERE `stu_id`=1001;update语句中也可以使用查询的方式获得数据并以此来更新指定的表数据,有兴趣的读者可以自行研究。在书写update语句时,通常都会有where子句,因为实际工作中几乎不太会用到更新全表的操作,这一点大家一定要注意。
完整的数据
下面我们给出完整的向 school 数据库的五张表中插入数据的 SQL。
USE `school`;
-- 插入学院数据INSERT INTO `tb_college` (`col_name`, `col_intro`)VALUES ('计算机学院', '计算机学院1958年设立计算机专业,1981年建立计算机科学系,1998年设立计算机学院,2005年5月,为了进一步整合教学和科研资源,学校决定,计算机学院和软件学院行政班子合并统一运作、实行教学和学生管理独立运行的模式。 学院下设三个系:计算机科学与技术系、物联网工程系、计算金融系;两个研究所:图象图形研究所、网络空间安全研究院(2015年成立);三个教学实验中心:计算机基础教学实验中心、IBM技术中心和计算机专业实验中心。'), ('外国语学院', '外国语学院设有7个教学单位,6个文理兼收的本科专业;拥有1个一级学科博士授予点,3个二级学科博士授予点,5个一级学科硕士学位授权点,5个二级学科硕士学位授权点,5个硕士专业授权领域,同时还有2个硕士专业学位(MTI)专业;有教职员工210余人,其中教授、副教授80余人,教师中获得中国国内外名校博士学位和正在职攻读博士学位的教师比例占专任教师的60%以上。'), ('经济管理学院', '经济学院前身是创办于1905年的经济科;已故经济学家彭迪先、张与九、蒋学模、胡寄窗、陶大镛、胡代光,以及当代学者刘诗白等曾先后在此任教或学习。');
-- 插入学生数据INSERT INTO `tb_student` (`stu_id`, `stu_name`, `stu_sex`, `stu_birth`, `stu_addr`, `col_id`)VALUES (1001, '杨过', 1, '1990-3-4', '湖南长沙', 1), (1002, '任我行', 1, '1992-2-2', '湖南长沙', 1), (1033, '王语嫣', 0, '1989-12-3', '四川成都', 1), (1572, '岳不群', 1, '1993-7-19', '陕西咸阳', 1), (1378, '纪嫣然', 0, '1995-8-12', '四川绵阳', 1), (1954, '林平之', 1, '1994-9-20', '福建莆田', 1), (2035, '东方不败', 1, '1988-6-30', NULL, 2), (3011, '林震南', 1, '1985-12-12', '福建莆田', 3), (3755, '项少龙', 1, '1993-1-25', '四川成都', 3), (3923, '杨不悔', 0, '1985-4-17', '四川成都', 3);
-- 插入老师数据INSERT INTO `tb_teacher` (`tea_id`, `tea_name`, `tea_title`, `col_id`)VALUES (1122, '张三丰', '教授', 1), (1133, '宋远桥', '副教授', 1), (1144, '杨逍', '副教授', 1), (2255, '范遥', '副教授', 2), (3366, '韦一笑', DEFAULT, 3);
-- 插入课程数据INSERT INTO `tb_course` (`cou_id`, `cou_name`, `cou_credit`, `tea_id`)VALUES (1111, 'Python程序设计', 3, 1122), (2222, 'Web前端开发', 2, 1122), (3333, '操作系统', 4, 1122), (4444, '计算机网络', 2, 1133), (5555, '编译原理', 4, 1144), (6666, '算法和数据结构', 3, 1144), (7777, '经贸法语', 3, 2255), (8888, '成本会计', 2, 3366), (9999, '审计学', 3, 3366);
-- 插入选课数据INSERT INTO `tb_record` (`stu_id`, `cou_id`, `sel_date`, `score`)VALUES (1001, 1111, '2017-09-01', 95), (1001, 2222, '2017-09-01', 87.5), (1001, 3333, '2017-09-01', 100), (1001, 4444, '2018-09-03', NULL), (1001, 6666, '2017-09-02', 100), (1002, 1111, '2017-09-03', 65), (1002, 5555, '2017-09-01', 42), (1033, 1111, '2017-09-03', 92.5), (1033, 4444, '2017-09-01', 78), (1033, 5555, '2017-09-01', 82.5), (1572, 1111, '2017-09-02', 78), (1378, 1111, '2017-09-05', 82), (1378, 7777, '2017-09-02', 65.5), (2035, 7777, '2018-09-03', 88), (2035, 9999, '2019-09-02', NULL), (3755, 1111, '2019-09-02', NULL), (3755, 8888, '2019-09-02', NULL), (3755, 9999, '2017-09-01', 92);注意:上面的
insert语句使用了批处理的方式来插入数据,这种做法插入数据的效率比较高。
39 SQL详解之DQL
接下来,我们利用之前创建的学校选课系统数据库,为大家讲解 DML 中的查询操作。无论对于开发人员还是数据分析师,查询都是非常重要的,它关系着我们能否从关系数据库中获取我们需要的数据。建议大家把上上一节课中建库建表的 DDL 以及 上一节课中插入数据的 DML 重新执行一次,确保表和数据跟没有问题再执行下面的操作。
USE school;
-- 查询所有学生的所有信息SELECT stu_id, stu_name, stu_sex, stu_birth, stu_addr, col_id FROM tb_student;
-- 查询学生的学号、姓名和籍贯(投影和别名)SELECT stu_id AS 学号, stu_name AS 姓名, stu_addr AS 籍贯 FROM tb_student;
-- 查询所有课程的名称及学分(投影和别名)SELECT cou_name AS 课程名称, cou_credit AS 学分 FROM tb_course;
-- 查询所有女学生的姓名和出生日期(数据筛选)SELECT stu_name, stu_birth FROM tb_student WHERE stu_sex = 0;
-- 查询籍贯为“四川成都”的女学生的姓名和出生日期(数据筛选)SELECT stu_name, stu_birth FROM tb_student WHERE stu_sex = 0 AND stu_addr = '四川成都';
-- 查询籍贯为“四川成都”或者性别是女的学生(数据筛选)SELECT stu_name, stu_birth FROM tb_student WHERE stu_sex = 0 OR stu_addr = '四川成都';
-- 查询所有80后学生的姓名、性别和出生日期(数据筛选)SELECT stu_name, stu_sex, stu_birth FROM tb_student WHERE '1980-1-1' <= stu_birth AND stu_birth <= '1989-12-31';
SELECT stu_name, stu_sex, stu_birth FROM tb_student WHERE stu_birth BETWEEN '1980-1-1' AND '1989-12-31';
-- 查询学分大于2的课程的名称和学分(数据筛选)SELECT cou_name, cou_credit FROM tb_course WHERE cou_credit > 2;
-- 查询学分是奇数的课程的名称和学分(数据筛选)SELECT cou_name, cou_credit FROM tb_course WHERE cou_credit MOD 2 <> 0;
-- 查询选择选了1111的课程考试成绩在90分以上的学生学号(数据筛选)SELECT stu_id FROM tb_record WHERE cou_id = 1111 AND score > 90;
-- 查询名字叫“杨过”的学生的姓名和性别(数据筛选)SELECT stu_name AS 姓名, CASE stu_sex WHEN 1 THEN '男' ELSE '女' END AS 性别 FROM tb_student WHERE stu_name = '杨过';
SELECT stu_name AS 姓名, IF(stu_sex, '男', '女') AS 性别 FROM tb_student WHERE stu_name = '杨过';
-- 查询姓“杨”的学生姓名和性别(模糊匹配)-- 通配符 % 匹配零个或任意多个字符SELECT stu_name AS 姓名, CASE stu_sex WHEN 1 THEN '男' ELSE '女' END AS 性别 FROM tb_student WHERE stu_name LIKE '杨%';
-- 查询姓“杨”名字两个字的学生姓名和性别(模糊匹配)-- 通过符 _ 匹配一个字符SELECT stu_name AS 姓名, CASE stu_sex WHEN 1 THEN '男' ELSE '女' END AS 性别 FROM tb_student WHERE stu_name LIKE '杨_';
-- 查询姓“杨”名字三个字的学生姓名和性别(模糊匹配)SELECT stu_name AS 姓名, CASE stu_sex WHEN 1 THEN '男' ELSE '女' END AS 性别 FROM tb_student WHERE stu_name LIKE '杨__';
-- 查询学号最后一位是3的学生的学号和姓名(模糊匹配)SELECT stu_id, stu_name FROM tb_student WHERE stu_id LIKE '%3';
-- 查询名字中有“不”字或“嫣”字的学生的学号和姓名(模糊匹配和并集运算)SELECT stu_id, stu_name FROM tb_student WHERE stu_name LIKE '%不%' OR stu_name LIKE '%嫣%';
SELECT stu_id, stu_name FROM tb_student WHERE stu_name LIKE '%不%' UNIONSELECT stu_id, stu_name FROM tb_student WHERE stu_name LIKE '%嫣%';
-- 查询姓“杨”或姓“林”名字三个字的学生的学号和姓名(正则表达式模糊匹配)SELECT stu_id, stu_name FROM tb_student WHERE stu_name REGEXP '[林杨][\\u4e00-\\u9fa5]{2}';
-- 查询没有录入籍贯的学生姓名(空值处理)SELECT stu_name FROM tb_student WHERE TRIM(stu_addr) = '' OR stu_addr is null;
-- 查询录入了籍贯的学生姓名(空值处理)SELECT stu_name FROM tb_student WHERE TRIM(stu_addr) <> '' AND stu_addr is not null;
-- 查询学生选课的所有日期(去重)SELECT DISTINCT sel_date FROM tb_record;
-- 查询学生的籍贯(去重)SELECT DISTINCT stu_addr FROM tb_student WHERE TRIM(stu_addr) <> '' AND stu_addr is not null;
-- 查询男学生的姓名和生日按年龄从大到小排列(排序)SELECT stu_name, stu_birth FROM tb_student WHERE stu_sex = 1 ORDER BY stu_birth ASC;
-- 补充:将上面的生日换算成年龄(日期函数、数值函数)SELECT stu_name AS 姓名, FLOOR(DATEDIFF(CURDATE(), stu_birth) / 365) AS 年龄 FROM tb_student WHERE stu_sex = 1 ORDER BY 年龄 DESC;
-- 查询年龄最大的学生的出生日期(聚合函数)SELECT MIN(stu_birth) FROM tb_student;
-- 查询年龄最小的学生的出生日期(聚合函数)SELECT MAX(stu_birth) FROM tb_student;
-- 查询编号为1111的课程考试成绩的最高分(聚合函数)SELECT MAX(score) FROM tb_record WHERE cou_id = 1111;
-- 查询学号为1001的学生考试成绩的最低分、最高分、平均分、标准差、方差(聚合函数)SELECT MIN(score) AS 最低分, MAX(score) AS 最高分, ROUND(AVG(score), 1) AS 平均分, STDDEV(score) AS 标准差, VARIANCE(score) AS 方差 FROM tb_record WHERE stu_id = 1001;
-- 查询学号为1001的学生考试成绩的平均分,如果有null值,null值算0分(聚合函数)SELECT ROUND(SUM(score) / COUNT(*), 1) AS 平均分 FROM tb_record WHERE stu_id = 1001;
-- 查询男女学生的人数(分组和聚合函数)SELECT CASE stu_sex WHEN 1 THEN '男' ELSE '女' END AS 性别, COUNT(*) AS 人数 FROM tb_student GROUP BY stu_sex;
-- 查询每个学院学生人数(分组和聚合函数)SELECT col_id AS 学院编号, COUNT(*) AS 人数 FROM tb_student GROUP BY col_id WITH ROLLUP;
-- 查询每个学院男女学生人数(分组和聚合函数)SELECT col_id AS 学院编号, CASE stu_sex WHEN 1 THEN '男' ELSE '女' END AS 性别, COUNT(*) AS 人数 FROM tb_student GROUP BY col_id, stu_sex;
-- 查询每个学生的学号和平均成绩(分组和聚合函数)SELECT stu_id AS 学号, ROUND(AVG(score), 1) AS 平均分 FROM tb_record GROUP BY stu_id;
-- 查询平均成绩大于等于90分的学生的学号和平均成绩(分组后的数据筛选)SELECT stu_id AS 学号, ROUND(AVG(score), 1) AS 平均分 FROM tb_record GROUP BY stu_idHAVING 平均分 >= 90;
-- 查询1111、2222、3333三门课程平均成绩大于等于90分的学生的学号和平均成绩(分组前后的数据筛选)SELECT stu_id AS 学号, ROUND(AVG(score), 1) AS 平均分 FROM tb_record WHERE cou_id in (1111, 2222, 3333) GROUP BY stu_idHAVING 平均分 >= 90 ORDER BY 平均分 ASC;
-- 查询年龄最大的学生的姓名(子查询)SELECT stu_name FROM tb_student WHERE stu_birth = (SELECT MIN(stu_birth) FROM tb_student);
-- 查询选了两门以上的课程的学生姓名(子查询和集合运算)SELECT stu_name FROM tb_student WHERE stu_id in (SELECT stu_id FROM tb_record GROUP BY stu_id HAVING COUNT(*) > 2);
-- 查询学生的姓名、生日和所在学院名称(表连接)SELECT stu_name, stu_birth, col_name FROM tb_student AS t1, tb_college AS t2 WHERE t1.col_id = t2.col_id;
SELECT stu_name, stu_birth, col_name FROM tb_student INNER JOIN tb_college ON tb_student.col_id = tb_college.col_id;
SELECT stu_name, stu_birth, col_name FROM tb_student NATURAL JOIN tb_college;
SELECT stu_name, stu_birth, col_name FROM tb_student CROSS JOIN tb_college;
-- 查询学生姓名、课程名称以及成绩(表连接)SELECT stu_name, cou_name, score FROM tb_student, tb_course, tb_record WHERE tb_student.stu_id = tb_record.stu_id AND tb_course.cou_id = tb_record.cou_id AND score is not null;
SELECT stu_name, cou_name, score FROM tb_student INNER JOIN tb_record ON tb_student.stu_id = tb_record.stu_id INNER JOIN tb_course ON tb_course.cou_id = tb_record.cou_id WHERE score is not null;
SELECT stu_name, cou_name, score FROM tb_student NATURAL JOIN tb_record NATURAL JOIN tb_course WHERE score is not null;
-- 补充:上面的查询结果取前5条数据(分页查询)SELECT stu_name, cou_name, score FROM tb_student NATURAL JOIN tb_record NATURAL JOIN tb_course WHERE score is not null ORDER BY cou_id ASC, score DESC LIMIT 5;
-- 补充:上面的查询结果取第6-10条数据(分页查询)SELECT stu_name, cou_name, score FROM tb_student NATURAL JOIN tb_record NATURAL JOIN tb_course WHERE score is not null ORDER BY cou_id ASC, score DESC LIMIT 5OFFSET 5;
-- 补充:上面的查询结果取第11-15条数据(分页查询)SELECT stu_name, cou_name, score FROM tb_student NATURAL JOIN tb_record NATURAL JOIN tb_course WHERE score is not null ORDER BY cou_id ASC, score DESC LIMIT 10, 5;
-- 查询选课学生的姓名和平均成绩(子查询和表连接)-- Error Code: 1248. Every derived table must have its own aliasSELECT stu_name, avg_score FROM tb_student NATURAL JOIN (SELECT stu_id, ROUND(AVG(score), 1) AS avg_score FROM tb_record GROUP BY stu_id) as tmp;
-- 查询学生的姓名和选课的数量(子查询和表连接)SELECT stu_name, total FROM tb_student NATURAL JOIN (SELECT stu_id, COUNT(*) AS total FROM tb_record GROUP BY stu_id) as tmp;
-- 查询每个学生的姓名和选课数量(子查询和左外连接)SELECT stu_name AS 姓名, COALESCE(total, 0) AS 选课数量 FROM tb_student AS t1 LEFT JOIN (SELECT stu_id, COUNT(*) AS total FROM tb_record GROUP BY stu_id) AS t2 ON t1.stu_id = t2.stu_id;有几个地方需要加以说明:
-
MySQL目前的版本不支持全外连接,上面我们通过
union操作,将左外连接和右外连接的结果求并集实现全外连接的效果。大家可以通过下面的图来加深对连表操作的认识。
-
MySQL 中支持多种类型的运算符,包括:算术运算符(
+、-、*、/、%)、比较运算符(=、<>、<=>、<、<=、>、>=、BETWEEN...AND...、IN、IS NULL、IS NOT NULL、LIKE、RLIKE、REGEXP)、逻辑运算符(NOT、AND、OR、XOR)和位运算符(&、|、^、~、>>、<<),我们可以在 DML 中使用这些运算符处理数据。 -
在查询数据时,可以在
SELECT语句及其子句(如WHERE子句、ORDER BY子句、HAVING子句等)中使用函数,这些函数包括字符串函数、数值函数、时间日期函数、流程函数等,如下面的表格所示。常用字符串函数。
函数 功能 CONCAT将多个字符串连接成一个字符串 FORMAT将数值格式化成字符串并指定保留几位小数 FROM_BASE64/TO_BASE64BASE64解码/编码 BIN/OCT/HEX将数值转换成二进制/八进制/十六进制字符串 LOCATE在字符串中查找一个子串的位置 LEFT/RIGHT返回一个字符串左边/右边指定长度的字符 LENGTH/CHAR_LENGTH返回字符串的长度以字节/字符为单位 LOWER/UPPER返回字符串的小写/大写形式 LPAD/RPAD如果字符串的长度不足,在字符串左边/右边填充指定的字符 LTRIM/RTRIM去掉字符串前面/后面的空格 ORD/CHAR返回字符对应的编码/返回编码对应的字符 STRCMP比较字符串,返回-1、0、1分别表示小于、等于、大于 SUBSTRING返回字符串指定范围的子串 常用数值函数。
函数 功能 ABS返回一个数的绝度值 CEILING/FLOOR返回一个数上取整/下取整的结果 CONV将一个数从一种进制转换成另一种进制 CRC32计算循环冗余校验码 EXP/LOG/LOG2/LOG10计算指数/对数 POW求幂 RAND返回[0,1)范围的随机数 ROUND返回一个数四舍五入后的结果 SQRT返回一个数的平方根 TRUNCATE截断一个数到指定的精度 SIN/COS/TAN/COT/ASIN/ACOS/ATAN三角函数 常用时间日期函数。
函数 功能 CURDATE/CURTIME/NOW获取当前日期/时间/日期和时间 ADDDATE/SUBDATE将两个日期表达式相加/相减并返回结果 DATE/TIME从字符串中获取日期/时间 YEAR/MONTH/DAY从日期中获取年/月/日 HOUR/MINUTE/SECOND从时间中获取时/分/秒 DATEDIFF/TIMEDIFF/TIMESTAMPDIFF返回两个时间日期表达式相差多少天/小时 MAKEDATE/MAKETIME制造一个日期/时间 常用流程控制函数。
函数 功能 IF根据条件是否成立返回不同的值 IFNULL如果为NULL则返回指定的值否则就返回本身 NULLIF两个表达式相等就返回NULL否则返回第一个表达式的值 其他常用函数。
函数 功能 MD5/SHA1/SHA2返回字符串对应的哈希摘要 CHARSET/COLLATION返回字符集/校对规则 USER/CURRENT_USER返回当前用户 DATABASE返回当前数据库名 VERSION返回当前数据库版本 FOUND_ROWS/ROW_COUNT返回查询到的行数/受影响的行数 LAST_INSERT_ID返回最后一个自增主键的值 UUID/UUID_SHORT返回全局唯一标识符
40 SQL详解之DCL
数据库服务器通常包含了非常重要的数据,可以通过访问控制来确保这些数据的安全,而 DCL 就是解决这一问题的,它可以为指定的用户授予访问权限或者从指定用户处召回指定的权限。DCL 对数据库管理员来说非常重要,因为用户权限的管理关系到数据库的安全。简单的说,我们可以通过 DCL 允许受信任的用户访问数据库,阻止不受信任的用户访问数据库,同时还可以通过 DCL 将每个访问者的的权限最小化(让访问者的权限刚刚够用)。
创建用户
我们可以使用下面的 SQL 来创建一个用户并为其指定访问口令。
CREATE USER 'wangdachui'@'%' IDENTIFIED BY 'Wang.618';上面的 SQL 创建了名为 wangdachui 的用户,它的访问口令是 Wang.618,该用户可以从任意主机访问数据库服务器,因为 @ 后面使用了可以表示任意多个字符的通配符 %。如果要限制 wangdachui 这个用户只能从 192.168.0.x 这个网段的主机访问数据库服务器,可以按照下面的方式来修改 SQL 语句。
DROP USER IF EXISTS 'wangdachui'@'%';
CREATE USER 'wangdachui'@'192.168.0.%' IDENTIFIED BY 'Wang.618';此时,如果我们使用 wangdachui 这个账号访问数据库服务器,我们几乎不能做任何操作,因为该账号没有任何操作权限。
授予权限
我们用下面的语句为 wangdachui 授予查询 school 数据库学院表(tb_college)的权限。
GRANT SELECT ON `school`.`tb_college` TO 'wangdachui'@'192.168.0.%';我们也可以让 wangdachui 对 school 数据库的所有对象都具有查询权限,代码如下所示。
GRANT SELECT ON `school`.* TO 'wangdachui'@'192.168.0.%';如果我们希望 wangdachui 还有 insert、delete 和 update 权限,可以使用下面的方式进行操作。
GRANT INSERT, DELETE, UPDATE ON `school`.* TO 'wangdachui'@'192.168.0.%';如果我们还想授予 wangdachui 执行 DDL 的权限,可以使用如下所示的 SQL。
GRANT CREATE, DROP, ALTER ON `school`.* TO 'wangdachui'@'192.168.0.%';如果我们希望 wangdachui 账号对所有数据库的所有对象都具备所有的操作权限,可以执行如下所示的操作,但是一般情况下,我们不会这样做,因为我们之前说过,权限刚刚够用就行,一个普通的账号不应该拥有这么大的权限。
GRANT ALL PRIVILEGES ON *.* TO 'wangdachui'@'192.168.0.%';召回权限
如果要召回 wangdachui 对 school 数据库的 insert、delete 和 update 权限,可以使用下面的操作。
REVOKE INSERT, DELETE, UPDATE ON `school`.* FROM 'wangdachui'@'192.168.0.%';如果要召回所有的权限,可以按照如下所示的方式进行操作。
REVOKE ALL PRIVILEGES ON *.* FROM 'wangdachui'@'192.168.0.%';需要说明的是,由于数据库可能会缓存用户的权限,可以在授予或召回权限后执行下面的语句使新的权限即时生效。
FLUSH PRIVILEGES;41 MySQL新特性
JSON类型
很多开发者在使用关系型数据库做数据持久化的时候,常常感到结构化的存储缺乏灵活性,因为必须事先设计好所有的列以及对应的数据类型。在业务发展和变化的过程中,如果需要修改表结构,这绝对是比较麻烦和难受的事情。从 MySQL 5.7 版本开始,MySQL引入了对 JSON 数据类型的支持(MySQL 8.0 解决了 JSON 的日志性能瓶颈问题),用好 JSON 类型,其实就是打破了关系型数据库和非关系型数据库之间的界限,为数据持久化操作带来了更多的便捷。
JSON 类型主要分为 JSON 对象和 JSON数组两种,如下所示。
- JSON 对象
{"name": "骆昊", "tel": "13122335566", "QQ": "957658"}- JSON 数组
[1, 2, 3][{"name": "骆昊", "tel": "13122335566"}, {"name": "王大锤", "QQ": "123456"}]哪些地方需要用到JSON类型呢?举一个简单的例子,现在很多产品的用户登录都支持多种方式,例如手机号、微信、QQ、新浪微博等,但是一般情况下我们又不会要求用户提供所有的这些信息,那么用传统的设计方式,就需要设计多个列来对应多种登录方式,可能还需要允许这些列存在空值,这显然不是很好的选择;另一方面,如果产品又增加了一种登录方式,那么就必然要修改之前的表结构,这就更让人痛苦了。但是,有了 JSON 类型,刚才的问题就迎刃而解了,我们可以做出如下所示的设计。
CREATE TABLE `tb_test`(`user_id` bigint unsigned,`login_info` json,PRIMARY KEY (`user_id`));
INSERT INTO `tb_test`VALUES (1, '{"tel": "13122335566", "QQ": "654321", "wechat": "jackfrued"}'), (2, '{"tel": "13599876543", "weibo": "wangdachui123"}');如果要查询用户的手机和微信号,可以用如下所示的 SQL 语句。
SELECT `user_id` , JSON_UNQUOTE(JSON_EXTRACT(`login_info`, '$.tel')) AS 手机号 , JSON_UNQUOTE(JSON_EXTRACT(`login_info`, '$.wechat')) AS 微信FROM `tb_test`;+---------+-------------+-----------+| user_id | 手机号 | 微信 |+---------+-------------+-----------+| 1 | 13122335566 | jackfrued || 2 | 13599876543 | NULL |+---------+-------------+-----------+因为支持 JSON 类型,MySQL 也提供了配套的处理 JSON 数据的函数,就像上面用到的json_extract和json_unquote。当然,上面的 SQL 还有更为便捷的写法,如下所示。
SELECT `user_id` , `login_info` ->> '$.tel' AS 手机号 , `login_info` ->> '$.wechat' AS 微信 FROM `tb_test`;再举个例子,如果我们的产品要实现用户画像功能(给用户打标签),然后基于用户画像给用户推荐平台的服务或消费品之类的东西,我们也可以使用 JSON 类型来保存用户画像数据,示意代码如下所示。
创建画像标签表。
CREATE TABLE `tb_tags`(`tag_id` int unsigned NOT NULL COMMENT '标签ID',`tag_name` varchar(20) NOT NULL COMMENT '标签名',PRIMARY KEY (`tag_id`));
INSERT INTO `tb_tags` (`tag_id`, `tag_name`)VALUES (1, '70后'), (2, '80后'), (3, '90后'), (4, '00后'), (5, '爱运动'), (6, '高学历'), (7, '小资'), (8, '有房'), (9, '有车'), (10, '爱看电影'), (11, '爱网购'), (12, '常点外卖');为用户打标签。
CREATE TABLE `tb_users_tags`(`user_id` bigint unsigned NOT NULL COMMENT '用户ID',`user_tags` json NOT NULL COMMENT '用户标签');
INSERT INTO `tb_users_tags`VALUES (1, '[2, 6, 8, 10]'), (2, '[3, 10, 12]'), (3, '[3, 8, 9, 11]');接下来,我们通过一组查询来了解 JSON 类型的巧妙之处。
-
查询爱看电影(有
10这个标签)的用户ID。SELECT `user_id`FROM `tb_users_tags`WHERE 10 MEMBER OF (`user_tags`->'$'); -
查询爱看电影(有
10这个标签)的80后(有2这个标签)用户ID。SELECT `user_id`FROM `tb_users_tags`WHERE JSON_CONTAINS(`user_tags`->'$', '[2, 10]'); -
查询爱看电影或80后或90后的用户ID。
SELECT `user_id`FROM `tb_users_tags`WHERE JSON_OVERLAPS(user_tags->'$', '[2, 3, 10]');
说明:上面的查询用到了
member of谓词和两个 JSON 函数,json_contains可以检查 JSON 数组是否包含了指定的元素,而json_overlaps可以检查 JSON 数组是否与指定的数组有重叠部分。
窗口函数
MySQL 从8.0开始支持窗口函数,大多数商业数据库和一些开源数据库早已提供了对窗口函数的支持,有的也将其称之为 OLAP(联机分析和处理)函数,听名字就知道跟统计和分析相关。为了帮助大家理解窗口函数,我们先说说窗口的概念。
窗口可以理解为记录的集合,窗口函数也就是在满足某种条件的记录集合上执行的特殊函数,对于每条记录都要在此窗口内执行函数。窗口函数和我们上面讲到的聚合函数比较容易混淆,二者的区别主要在于聚合函数是将多条记录聚合为一条记录,窗口函数是每条记录都会执行,执行后记录条数不会变。窗口函数不仅仅是几个函数,它是一套完整的语法,函数只是该语法的一部分,基本语法如下所示:
<窗口函数> OVER (PARTITION BY <用于分组的列名> ORDER BY <用于排序的列名> ROWS BETWEEN ... AND ...)<窗口函数> OVER (PARTITION BY <用于分组的列名> ORDER BY <用于排序的列名> RANGE BETWEEN ... AND ...)上面语法中,窗口函数的位置可以放以下两种函数:
- 专用窗口函数,包括:
lead、lag、first_value、last_value、rank、dense_rank和row_number等。 - 聚合函数,包括:
sum、avg、max、min和count等。
下面为大家举几个使用窗口函数的简单例子,我们直接使用上一课创建的 hrs 数据库。
例子1:查询按月薪从高到低排在第4到第6名的员工的姓名和月薪。
SELECT * FROM (SELECT `ename` , `sal` , ROW_NUMBER() over (ORDER BY `sal` DESC) AS `rk` FROM `tb_emp`) AS `temp` WHERE `rk` between 4 and 6;说明:上面使用的函数
row_number()可以为每条记录生成一个行号,在实际工作中可以根据需要将其替换为rank()或dense_rank()函数,三者的区别可以参考官方文档或阅读《通俗易懂的学会:SQL窗口函数》进行了解。在MySQL 8以前的版本,我们可以通过下面的方式来完成类似的操作。
例子2:查询每个部门月薪最高的两名的员工的姓名和部门名称。
select `ename`, `sal`, `dname`from ( select `ename`, `sal`, `dno`, rank() over (partition by `dno` order by `sal` desc) as `rank` from `tb_emp`) as `temp` natural join `tb_dept` where `rank`<=2;说明:在MySQL 8以前的版本,我们可以通过下面的方式来完成类似的操作。
natural join tb_dept
where (
select count(*) from tb_emp as t2
where t1.dno=t2.dno and t2.sal>t1.sal
)<2 order by dno asc, sal desc;
42 视图、函数和过程
为了讲解视图、函数和过程,我们首先用下面的 DDL 和 DML 创建名为 hrs 的数据库并为其二维表添加如下所示的数据。
-- 创建名为hrs的数据库并指定默认的字符集create database `hrs` default charset utf8mb4;
-- 切换到hrs数据库use `hrs`;
-- 创建部门表create table `tb_dept`(`dno` int not null comment '编号',`dname` varchar(10) not null comment '名称',`dloc` varchar(20) not null comment '所在地',primary key (`dno`));
-- 插入4个部门insert into `tb_dept` values (10, '会计部', '北京'), (20, '研发部', '成都'), (30, '销售部', '重庆'), (40, '运维部', '深圳');
-- 创建员工表create table `tb_emp`(`eno` int not null comment '员工编号',`ename` varchar(20) not null comment '员工姓名',`job` varchar(20) not null comment '员工职位',`mgr` int comment '主管编号',`sal` int not null comment '员工月薪',`comm` int comment '每月补贴',`dno` int not null comment '所在部门编号',primary key (`eno`),constraint `fk_emp_mgr` foreign key (`mgr`) references tb_emp (`eno`),constraint `fk_emp_dno` foreign key (`dno`) references tb_dept (`dno`));
-- 插入14个员工insert into `tb_emp` values (7800, '张三丰', '总裁', null, 9000, 1200, 20), (2056, '乔峰', '分析师', 7800, 5000, 1500, 20), (3088, '李莫愁', '设计师', 2056, 3500, 800, 20), (3211, '张无忌', '程序员', 2056, 3200, null, 20), (3233, '丘处机', '程序员', 2056, 3400, null, 20), (3251, '张翠山', '程序员', 2056, 4000, null, 20), (5566, '宋远桥', '会计师', 7800, 4000, 1000, 10), (5234, '郭靖', '出纳', 5566, 2000, null, 10), (3344, '黄蓉', '销售主管', 7800, 3000, 800, 30), (1359, '胡一刀', '销售员', 3344, 1800, 200, 30), (4466, '苗人凤', '销售员', 3344, 2500, null, 30), (3244, '欧阳锋', '程序员', 3088, 3200, null, 20), (3577, '杨过', '会计', 5566, 2200, null, 10), (3588, '朱九真', '会计', 5566, 2500, null, 10);视图
视图是关系型数据库中将一组查询指令构成的结果集组合成可查询的数据表的对象。简单的说,视图就是虚拟的表,但与数据表不同的是,数据表是一种实体结构,而视图是一种虚拟结构,你也可以将视图理解为保存在数据库中被赋予名字的 SQL 语句。
使用视图可以获得以下好处:
- 可以将实体数据表隐藏起来,让外部程序无法得知实际的数据结构,让访问者可以使用表的组成部分而不是整个表,降低数据库被攻击的风险。
- 在大多数的情况下视图是只读的(更新视图的操作通常都有诸多的限制),外部程序无法直接透过视图修改数据。
- 重用 SQL 语句,将高度复杂的查询包装在视图表中,直接访问该视图即可取出需要的数据;也可以将视图视为数据表进行连接查询。
- 视图可以返回与实体数据表不同格式的数据,在创建视图的时候可以对数据进行格式化处理。
创建视图。
create view `vw_emp_simple`asselect `eno`, `ename`, `job`, `dno` from `tb_emp`;提示:因为视图不包含数据,所以每次使用视图时,都必须执行查询以获得数据,如果你使用了连接查询、嵌套查询创建了较为复杂的视图,你可能会发现查询性能下降得很厉害。因此,在使用复杂的视图前,应该进行测试以确保其性能能够满足应用的需求。
有了上面的视图,我们就可以使用之前讲过的 DCL, 限制某些用户只能从视图中获取员工信息,这样员工表中的工资(sal)、补贴(comm)等敏感字段便不会暴露给用户。下面的代码演示了如何从视图中获取数据。
select * from `vw_emp_simple`;查询结果:
+------+-----------+--------------+-----+| eno | ename | job | dno |+------+-----------+--------------+-----+| 1359 | 胡二刀 | 销售员 | 30 || 2056 | 乔峰 | 分析师 | 20 || 3088 | 李莫愁 | 设计师 | 20 || 3211 | 张无忌 | 程序员 | 20 || 3233 | 丘处机 | 程序员 | 20 || 3244 | 欧阳锋 | 程序员 | 20 || 3251 | 张翠山 | 程序员 | 20 || 3344 | 黄蓉 | 销售主管 | 30 || 3577 | 杨过 | 会计 | 10 || 3588 | 朱九真 | 会计 | 10 || 4466 | 苗人凤 | 销售员 | 30 || 5234 | 郭靖 | 出纳 | 10 || 5566 | 宋远桥 | 会计师 | 10 || 7800 | 张三丰 | 总裁 | 20 |+------+-----------+--------------+-----+既然视图是一张虚拟的表,那么视图的中的数据可以更新吗?视图的可更新性要视具体情况而定,以下类型的视图是不能更新的:
- 使用了聚合函数(
SUM、MIN、MAX、AVG、COUNT等)、DISTINCT、GROUP BY、HAVING、UNION或者UNION ALL的视图。 SELECT中包含了子查询的视图。FROM子句中包含了一个不能更新的视图的视图。WHERE子句的子查询引用了FROM子句中的表的视图。
删除视图。
drop view if exists `vw_emp_simple`;说明:如果希望更新视图,可以先用上面的命令删除视图,也可以通过
create or replace view来更新视图。
视图的规则和限制。
- 视图可以嵌套,可以利用从其他视图中检索的数据来构造一个新的视图。视图也可以和表一起使用。
- 创建视图时可以使用
order by子句,但如果从视图中检索数据时也使用了order by,那么该视图中原先的order by会被覆盖。 - 视图无法使用索引,也不会激发触发器(实际开发中因为性能等各方面的考虑,通常不建议使用触发器,所以我们也不对这个概念进行介绍)的执行。
函数
MySQL 中的函数跟 Python 中的函数大同小异,因为函数都是用来封装功能上相对独立且会被重复使用的代码的。如果非要找出一些差别来,那么 MySQL 中的函数是可以执行 SQL 语句的。下面的例子,我们通过自定义函数实现了截断超长字符串的功能。
delimiter $$
create function fn_truncate_string( content varchar(10000), max_length int unsigned) returns varchar(10000) no sqlbegin declare result varchar(10000) default content; if char_length(content) > max_length then set result = left(content, max_length); set result = concat(result, '……'); end if; return result;end $$
delimiter ;说明1:函数声明后面的
no sql是声明函数体并没有使用 SQL 语句;如果函数体中需要通过 SQL 读取数据,需要声明为reads sql data。说明2:定义函数前后的
delimiter命令是为了修改终止符(定界符),因为函数体中的语句都是用;表示结束,如果不重新定义定界符,那么遇到的;的时候代码就会被截断执行,显然这不是我们想要的效果。
在查询中调用自定义函数。
select fn_truncate_string('和我在成都的街头走一走,直到所有的灯都熄灭了也不停留', 10) as short_string;+--------------------------------------+| short_string |+--------------------------------------+| 和我在成都的街头走一…… |+--------------------------------------+过程
过程(又称存储过程)是事先编译好存储在数据库中的一组 SQL 的集合,调用过程可以简化应用程序开发人员的工作,减少与数据库服务器之间的通信,对于提升数据操作的性能也是有帮助的。其实迄今为止,我们使用的 SQL 语句都是针对一个或多个表的单条语句,但在实际开发中经常会遇到某个操作需要多条 SQL 语句才能完成的情况。例如,电商网站在受理用户订单时,需要做以下一系列的处理。
- 通过查询来核对库存中是否有对应的物品以及库存是否充足。
- 如果库存有物品,需要锁定库存以确保这些物品不再卖给别人, 并且要减少可用的物品数量以反映正确的库存量。
- 如果库存不足,可能需要进一步与供应商进行交互或者至少产生一条系统提示消息。
- 不管受理订单是否成功,都需要产生流水记录,而且需要给对应的用户产生一条通知信息。
我们可以通过过程将复杂的操作封装起来,这样不仅有助于保证数据的一致性,而且将来如果业务发生了变动,只需要调整和修改过程即可。对于调用过程的用户来说,过程并没有暴露数据表的细节,而且执行过程比一条条的执行一组 SQL 要快得多。
下面的过程实现 hrs 数据库中员工工资的普调,具体的规则是:10部门的员工薪资上浮300, 20部门的员工薪资上浮800,30部门的员工薪资上浮500。
delimiter $$
create procedure sp_upgrade_salary()begin declare flag boolean default 1; -- 定义一个异常处理器 declare continue handler for sqlexception set flag=0;
-- 开启事务环境 start transaction;
update tb_emp set sal=sal+300 where dno=10; update tb_emp set sal=sal+800 where dno=20; update tb_emp set sal=sal+500 where dno=30;
-- 提交或回滚事务 if flag then commit; else rollback; end if;end $$
delimiter ;说明:上面的过程代码中使用了
start transaction来开启事务环境,关于事务,在本课的最后有一个简单的介绍。为了确定代码中是否发生异常,从而提交或回滚事务,上面的过程中定义了一个名为flag的变量和一个异常处理器,如果发生了异常,flag将会被赋值为0,后面的分支结构会根据flag的值来决定是执行commit,还是执行rollback。
调用过程。
call sp_upgrade_salary();删除过程。
drop procedure if exists sp_upgrade_salary;在过程中,我们可以定义变量、条件,可以使用分支和循环语句,可以通过游标操作查询结果,还可以使用事件调度器,这些内容我们暂时不在此处进行介绍。虽然我们说了很多过程的好处,但是在实际开发中,如果频繁的使用过程并将大量复杂的运算放到过程中,会给据库服务器造成巨大的压力,而数据库往往都是性能瓶颈所在,使用过程无疑是雪上加霜的操作。所以,对于互联网产品开发,我们一般建议让数据库只做好存储,复杂的运算和处理交给应用服务器上的程序去完成,如果应用服务器变得不堪重负了,我们可以比较容易的部署多台应用服务器来分摊这些压力。
如果大家对上面讲到的视图、函数、过程包括我们没有讲到的触发器这些知识有兴趣,建议大家阅读 MySQL 的入门读物《MySQL必知必会》进行一般性了解即可,因为这些知识点在大家将来的工作中未必用得上,学了也可能仅仅是为了应付面试而已。
其他内容
范式理论
范式理论是设计关系型数据库中二维表的指导思想。
- 第一范式:数据表的每个列的值域都是由原子值组成的,不能够再分割。
- 第二范式:数据表里的所有数据都要和该数据表的键(主键与候选键)有完全依赖关系。
- 第三范式:所有非键属性都只和候选键有相关性,也就是说非键属性之间应该是独立无关的。
说明:实际工作中,出于效率的考虑,我们在设计表时很有可能做出反范式设计,即故意降低方式级别,增加冗余数据来获得更好的操作性能。
数据完整性
-
实体完整性 - 每个实体都是独一无二的
- 主键(
primary key) / 唯一约束(unique)
- 主键(
-
引用完整性(参照完整性)- 关系中不允许引用不存在的实体
- 外键(
foreign key)
- 外键(
-
域(domain)完整性 - 数据是有效的
-
数据类型及长度
-
非空约束(
not null) -
默认值约束(
default) -
检查约束(
check)说明:在 MySQL 8.x 以前,检查约束并不起作用。
-
数据一致性
-
事务:一系列对数据库进行读/写的操作,这些操作要么全都成功,要么全都失败。
-
事务的 ACID 特性
- 原子性:事务作为一个整体被执行,包含在其中的对数据库的操作要么全部被执行,要么都不执行
- 一致性:事务应确保数据库的状态从一个一致状态转变为另一个一致状态
- 隔离性:多个事务并发执行时,一个事务的执行不应影响其他事务的执行
- 持久性:已被提交的事务对数据库的修改应该永久保存在数据库中
-
MySQL 中的事务操作
-
开启事务环境
start transaction -
提交事务
commit -
回滚事务
rollback
-
-
查看事务隔离级别
show variables like 'transaction_isolation';+-----------------------+-----------------+| Variable_name | Value |+-----------------------+-----------------+| transaction_isolation | REPEATABLE-READ |+-----------------------+-----------------+可以看出,MySQL 默认的事务隔离级别是
REPEATABLE-READ。 -
修改(当前会话)事务隔离级别
set session transaction isolation level read committed;重新查看事务隔离级别,结果如下所示。
+-----------------------+----------------+| Variable_name | Value |+-----------------------+----------------+| transaction_isolation | READ-COMMITTED |+-----------------------+----------------+
关系型数据库的事务是一个很大的话题,因为当存在多个并发事务访问数据时,就有可能出现三类读数据的问题(脏读、不可重复读、幻读)和两类更新数据的问题(第一类丢失更新、第二类丢失更新)。想了解这五类问题的,可以阅读我发布在 CSDN 网站上的《Java面试题全集(上)》一文的第80题。为了避免这些问题,关系型数据库底层是有对应的锁机制的,按锁定对象不同可以分为表级锁和行级锁,按并发事务锁定关系可以分为共享锁和独占锁。然而直接使用锁是非常麻烦的,为此数据库为用户提供了自动锁机制,只要用户指定适当的事务隔离级别,数据库就会通过分析 SQL 语句,然后为事务访问的资源加上合适的锁。此外,数据库还会维护这些锁通过各种手段提高系统的性能,这些对用户来说都是透明的。想了解 MySQL 事务和锁的细节知识,推荐大家阅读进阶读物《高性能MySQL》,这也是数据库方面的经典书籍。
ANSI/ISO SQL 92标准定义了4个等级的事务隔离级别,如下表所示。需要说明的是,事务隔离级别和数据访问的并发性是对立的,事务隔离级别越高并发性就越差。所以要根据具体的应用来确定到底使用哪种事务隔离级别,这个地方没有万能的原则。

总结
关于 MySQL 的知识肯定远远不止上面列出的这些,比如 MySQL 性能调优、MySQL 运维相关工具、MySQL 数据的备份和恢复、监控 MySQL 服务、部署高可用架构等,这一系列的问题在这里都没有办法逐一展开来讨论,那就留到有需要的时候再进行讲解吧,各位读者也可以自行探索。
43 索引
索引是关系型数据库中用来提升查询性能最为重要的手段。关系型数据库中的索引就像一本书的目录,我们可以想象一下,如果要从一本书中找出某个知识点,但是这本书没有目录,这将是一件多么可怕的事情!我们估计得一篇一篇的翻下去,才能确定这个知识点到底在什么位置。创建索引虽然会带来存储空间上的开销,就像一本书的目录会占用一部分篇幅一样,但是在牺牲空间后换来的查询时间的减少也是非常显著的。
MySQL 数据库中所有数据类型的列都可以被索引。对于MySQL 8.0 版本的 InnoDB 存储引擎来说,它支持三种类型的索引,分别是 B+ 树索引、全文索引和 R 树索引。这里,我们只介绍使用得最为广泛的 B+ 树索引。使用 B+ 树的原因非常简单,因为它是目前在基于磁盘进行海量数据存储和排序上最有效率的数据结构。B+ 树是一棵平衡树,树的高度通常为3或4,但是却可以保存从百万级到十亿级的数据,而从这些数据里面查询一条数据,只需要3次或4次 I/O 操作。
B+ 树由根节点、中间节点和叶子节点构成,其中叶子节点用来保存排序后的数据。由于记录在索引上是排序过的,因此在一个叶子节点内查找数据时可以使用二分查找,这种查找方式效率非常的高。当数据很少的时候,B+ 树只有一个根节点,数据也就保存在根节点上。随着记录越来越多,B+ 树会发生分裂,根节点不再保存数据,而是提供了访问下一层节点的指针,帮助快速确定数据在哪个叶子节点上。
在创建二维表时,我们通常都会为表指定主键列,主键列上默认会创建索引,而对于 MySQL InnoDB 存储引擎来说,因为它使用的是索引组织表这种数据存储结构,所以主键上的索引就是整张表的数据,而这种索引我们也将其称之为聚集索引(clustered index)。很显然,一张表只能有一个聚集索引,否则表的数据岂不是要保存多次。我们自己创建的索引都是二级索引(secondary index),更常见的叫法是非聚集索引(non-clustered index)。通过我们自定义的非聚集索引只能定位记录的主键,在获取数据时可能需要再通过主键上的聚集索引进行查询,这种现象称为“回表”,因此通过非聚集索引检索数据通常比使用聚集索引检索数据要慢。
接下来我们通过一个简单的例子来说明索引的意义,比如我们要根据学生的姓名来查找学生,这个场景在实际开发中应该经常遇到,就跟通过商品名称查找商品是一个道理。我们可以使用 MySQL 的explain关键字来查看 SQL 的执行计划(数据库执行 SQL 语句的具体步骤)。
explain select * from tb_student where stuname='林震南'\G*************************** 1. row *************************** id: 1 select_type: SIMPLE table: tb_student partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: 11 filtered: 10.00 Extra: Using where1 row in set, 1 warning (0.00 sec)在上面的 SQL 执行计划中,有几项值得我们关注:
select_type:查询的类型。SIMPLE:简单 SELECT,不需要使用 UNION 操作或子查询。PRIMARY:如果查询包含子查询,最外层的 SELECT 被标记为 PRIMARY。UNION:UNION 操作中第二个或后面的 SELECT 语句。SUBQUERY:子查询中的第一个 SELECT。DERIVED:派生表的 SELECT 子查询。
table:查询对应的表。type:MySQL 在表中找到满足条件的行的方式,也称为访问类型,包括:ALL(全表扫描)、index(索引全扫描,只遍历索引树)、range(索引范围扫描)、ref(非唯一索引扫描)、eq_ref(唯一索引扫描)、const/system(常量级查询)、NULL(不需要访问表或索引)。在所有的访问类型中,很显然 ALL 是性能最差的,它代表的全表扫描是指要扫描表中的每一行才能找到匹配的行。possible_keys:MySQL 可以选择的索引,但是有可能不会使用。key:MySQL 真正使用的索引,如果为NULL就表示没有使用索引。key_len:使用的索引的长度,在不影响查询的情况下肯定是长度越短越好。rows:执行查询需要扫描的行数,这是一个预估值。extra:关于查询额外的信息。Using filesort:MySQL 无法利用索引完成排序操作。Using index:只使用索引的信息而不需要进一步查表来获取更多的信息。Using temporary:MySQL 需要使用临时表来存储结果集,常用于分组和排序。Impossible where:where子句会导致没有符合条件的行。Distinct:MySQL 发现第一个匹配行后,停止为当前的行组合搜索更多的行。Using where:查询的列未被索引覆盖,筛选条件并不是索引的前导列。
从上面的执行计划可以看出,当我们通过学生名字查询学生时实际上是进行了全表扫描,不言而喻这个查询性能肯定是非常糟糕的,尤其是在表中的行很多的时候。如果我们需要经常通过学生姓名来查询学生,那么就应该在学生姓名对应的列上创建索引,通过索引来加速查询。
create index idx_student_name on tb_student(stuname);再次查看刚才的 SQL 对应的执行计划。
explain select * from tb_student where stuname='林震南'\G*************************** 1. row *************************** id: 1 select_type: SIMPLE table: tb_student partitions: NULL type: refpossible_keys: idx_student_name key: idx_student_name key_len: 62 ref: const rows: 1 filtered: 100.00 Extra: NULL1 row in set, 1 warning (0.00 sec)可以注意到,在对学生姓名创建索引后,刚才的查询已经不是全表扫描而是基于索引的查询,而且扫描的行只有唯一的一行,这显然大大的提升了查询的性能。MySQL 中还允许创建前缀索引,即对索引字段的前N个字符创建索引,这样的话可以减少索引占用的空间(但节省了空间很有可能会浪费时间,时间和空间是不可调和的矛盾),如下所示。
create index idx_student_name_1 on tb_student(stuname(1));上面的索引相当于是根据学生姓名的第一个字来创建的索引,我们再看看 SQL 执行计划。
explain select * from tb_student where stuname='林震南'\G*************************** 1. row *************************** id: 1 select_type: SIMPLE table: tb_student partitions: NULL type: refpossible_keys: idx_student_name key: idx_student_name key_len: 5 ref: const rows: 2 filtered: 100.00 Extra: Using where1 row in set, 1 warning (0.00 sec)不知道大家是否注意到,这一次扫描的行变成了2行,因为学生表中有两个姓“林”的学生,我们只用姓名的第一个字作为索引的话,在查询时通过索引就会找到这两行。
如果要删除索引,可以使用下面的SQL。
alter table tb_student drop index idx_student_name;或者
drop index idx_student_name on tb_student;在创建索引时,我们还可以使用复合索引、函数索引(MySQL 5.7 开始支持),用好复合索引实现索引覆盖可以减少不必要的排序和回表操作,这样就会让查询的性能成倍的提升,有兴趣的读者可以自行研究。
我们简单的为大家总结一下索引的设计原则:
- 最适合索引的列是出现在WHERE子句和连接子句中的列。
- 索引列的基数越大(取值多、重复值少),索引的效果就越好。
- 使用前缀索引可以减少索引占用的空间,内存中可以缓存更多的索引。
- 索引不是越多越好,虽然索引加速了读操作(查询),但是写操作(增、删、改)都会变得更慢,因为数据的变化会导致索引的更新,就如同书籍章节的增删需要更新目录一样。
- 使用 InnoDB 存储引擎时,表的普通索引都会保存主键的值,所以主键要尽可能选择较短的数据类型,这样可以有效的减少索引占用的空间,提升索引的缓存效果。
最后,还有一点需要说明,InnoDB 使用的 B-tree 索引,数值类型的列除了等值判断时索引会生效之外,使用>、<、>=、<=、BETWEEN...AND... 、<>时,索引仍然生效;对于字符串类型的列,如果使用不以通配符开头的模糊查询,索引也是起作用的,但是其他的情况会导致索引失效,这就意味着很有可能会做全表查询。
44 Python接入MySQL数据库
在 Python3 中,我们可以使用mysqlclient或者pymysql三方库来接入 MySQL 数据库并实现数据持久化操作。二者的用法完全相同,只是导入的模块名不一样。我们推荐大家使用纯 Python 的三方库pymysql,因为它更容易安装成功。下面我们仍然以之前创建的名为hrs的数据库为例,为大家演示如何通过 Python 程序操作 MySQL 数据库实现数据持久化操作。
接入MySQL
首先,我们可以在命令行或者 PyCharm 的终端中通过下面的命令安装pymysql,如果需要接入 MySQL 8,还需要安装一个名为cryptography的三方库来支持 MySQL 8 的密码认证方式。
pip install pymysql cryptography使用pymysql操作 MySQL 的步骤如下所示:
- 创建连接。MySQL 服务器启动后,提供了基于 TCP (传输控制协议)的网络服务。我们可以通过
pymysql模块的connect函数连接 MySQL 服务器。在调用connect函数时,需要指定主机(host)、端口(port)、用户名(user)、口令(password)、数据库(database)、字符集(charset)等参数,该函数会返回一个Connection对象。 - 获取游标。连接 MySQL 服务器成功后,接下来要做的就是向数据库服务器发送 SQL 语句,MySQL 会执行接收到的 SQL 并将执行结果通过网络返回。要实现这项操作,需要先通过连接对象的
cursor方法获取游标(Cursor)对象。 - 发出 SQL。通过游标对象的
execute方法,我们可以向数据库发出 SQL 语句。 - 如果执行
insert、delete或update操作,需要根据实际情况提交或回滚事务。因为创建连接时,默认开启了事务环境,在操作完成后,需要使用连接对象的commit或rollback方法,实现事务的提交或回滚,rollback方法通常会放在异常捕获代码块except中。如果执行select操作,需要通过游标对象抓取查询的结果,对应的方法有三个,分别是:fetchone、fetchmany和fetchall。其中fetchone方法会抓取到一条记录,并以元组或字典的方式返回;fetchmany和fetchall方法会抓取到多条记录,以嵌套元组或列表装字典的方式返回。 - 关闭连接。在完成持久化操作后,请不要忘记关闭连接,释放外部资源。我们通常会在
finally代码块中使用连接对象的close方法来关闭连接。
代码实操
下面,我们通过代码实操的方式为大家演示上面说的五个步骤。
插入数据
import pymysql
no = int(input('部门编号: '))name = input('部门名称: ')location = input('部门所在地: ')
# 1. 创建连接(Connection)conn = pymysql.connect(host='127.0.0.1', port=3306, user='guest', password='Guest.618', database='hrs', charset='utf8mb4')try: # 2. 获取游标对象(Cursor) with conn.cursor() as cursor: # 3. 通过游标对象向数据库服务器发出SQL语句 affected_rows = cursor.execute( 'insert into `tb_dept` values (%s, %s, %s)', (no, name, location) ) if affected_rows == 1: print('新增部门成功!!!') # 4. 提交事务(transaction) conn.commit()except pymysql.MySQLError as err: # 4. 回滚事务 conn.rollback() print(type(err), err)finally: # 5. 关闭连接释放资源 conn.close()说明:上面的
127.0.0.1称为回环地址,它代表的是本机。下面的guest是我提前创建好的用户,该用户拥有对hrs数据库的insert、delete、update和select权限。我们不建议大家在项目中直接使用root超级管理员账号访问数据库,这样做实在是太危险了。我们可以使用下面的命令创建名为guest的用户并为其授权。
如果要插入大量数据,建议使用游标对象的executemany方法做批处理(一个insert操作后面跟上多组数据),大家可以尝试向一张表插入10000条记录,然后看看不使用批处理一条条的插入和使用批处理有什么差别。游标对象的executemany方法第一个参数仍然是 SQL 语句,第二个参数可以是包含多组数据的列表或元组。
删除数据
import pymysql
no = int(input('部门编号: '))
# 1. 创建连接(Connection)conn = pymysql.connect(host='127.0.0.1', port=3306, user='guest', password='Guest.618', database='hrs', charset='utf8mb4', autocommit=True)try: # 2. 获取游标对象(Cursor) with conn.cursor() as cursor: # 3. 通过游标对象向数据库服务器发出SQL语句 affected_rows = cursor.execute( 'delete from `tb_dept` where `dno`=%s', (no, ) ) if affected_rows == 1: print('删除部门成功!!!')finally: # 5. 关闭连接释放资源 conn.close()说明:如果不希望每次 SQL 操作之后手动提交或回滚事务,可以
connect函数中加一个名为autocommit的参数并将它的值设置为True,表示每次执行 SQL 成功后自动提交。但是我们建议大家手动提交或回滚,这样可以根据实际业务需要来构造事务环境。如果不愿意捕获异常并进行处理,可以在try代码块后直接跟finally块,省略except意味着发生异常时,代码会直接崩溃并将异常栈显示在终端中。
更新数据
import pymysql
no = int(input('部门编号: '))name = input('部门名称: ')location = input('部门所在地: ')
# 1. 创建连接(Connection)conn = pymysql.connect(host='127.0.0.1', port=3306, user='guest', password='Guest.618', database='hrs', charset='utf8mb4')try: # 2. 获取游标对象(Cursor) with conn.cursor() as cursor: # 3. 通过游标对象向数据库服务器发出SQL语句 affected_rows = cursor.execute( 'update `tb_dept` set `dname`=%s, `dloc`=%s where `dno`=%s', (name, location, no) ) if affected_rows == 1: print('更新部门信息成功!!!') # 4. 提交事务 conn.commit()except pymysql.MySQLError as err: # 4. 回滚事务 conn.rollback() print(type(err), err)finally: # 5. 关闭连接释放资源 conn.close()查询数据
- 查询部门表的数据。
import pymysql
# 1. 创建连接(Connection)conn = pymysql.connect(host='127.0.0.1', port=3306, user='guest', password='Guest.618', database='hrs', charset='utf8mb4')try: # 2. 获取游标对象(Cursor) with conn.cursor() as cursor: # 3. 通过游标对象向数据库服务器发出SQL语句 cursor.execute('select `dno`, `dname`, `dloc` from `tb_dept`') # 4. 通过游标对象抓取数据 row = cursor.fetchone() while row: print(row) row = cursor.fetchone()except pymysql.MySQLError as err: print(type(err), err)finally: # 5. 关闭连接释放资源 conn.close()说明:上面的代码中,我们通过构造一个
while循环实现了逐行抓取查询结果的操作。这种方式特别适合查询结果有非常多行的场景。因为如果使用fetchall一次性将所有记录抓取到一个嵌套元组中,会造成非常大的内存开销,这在很多场景下并不是一个好主意。如果不愿意使用while循环,还可以考虑使用iter函数构造一个迭代器来逐行抓取数据,有兴趣的读者可以自行研究。
- 分页查询员工表的数据。
import pymysql
page = int(input('页码: '))size = int(input('大小: '))
# 1. 创建连接(Connection)con = pymysql.connect(host='127.0.0.1', port=3306, user='guest', password='Guest.618', database='hrs', charset='utf8')try: # 2. 获取游标对象(Cursor) with con.cursor(pymysql.cursors.DictCursor) as cursor: # 3. 通过游标对象向数据库服务器发出SQL语句 cursor.execute( 'select `eno`, `ename`, `job`, `sal` from `tb_emp` order by `sal` desc limit %s,%s', ((page - 1) * size, size) ) # 4. 通过游标对象抓取数据 for emp_dict in cursor.fetchall(): print(emp_dict)finally: # 5. 关闭连接释放资源 con.close()案例讲解
下面我们为大家讲解一个将数据库表数据导出到 Excel 文件的例子,我们需要先安装openpyxl三方库,命令如下所示。
pip install openpyxl接下来,我们通过下面的代码实现了将数据库hrs中所有员工的编号、姓名、职位、月薪、补贴和部门名称导出到一个 Excel 文件中。
import openpyxlimport pymysql
# 创建工作簿对象workbook = openpyxl.Workbook()# 获得默认的工作表sheet = workbook.active# 修改工作表的标题sheet.title = '员工基本信息'# 给工作表添加表头sheet.append(('工号', '姓名', '职位', '月薪', '补贴', '部门'))# 创建连接(Connection)conn = pymysql.connect(host='127.0.0.1', port=3306, user='guest', password='Guest.618', database='hrs', charset='utf8mb4')try: # 获取游标对象(Cursor) with conn.cursor() as cursor: # 通过游标对象执行SQL语句 cursor.execute( 'select `eno`, `ename`, `job`, `sal`, coalesce(`comm`, 0), `dname` ' 'from `tb_emp` natural join `tb_dept`' ) # 通过游标抓取数据 row = cursor.fetchone() while row: # 将数据逐行写入工作表中 sheet.append(row) row = cursor.fetchone() # 保存工作簿 workbook.save('hrs.xlsx')except pymysql.MySQLError as err: print(err)finally: # 关闭连接释放资源 conn.close()大家可以参考上面的例子,试一试把 Excel 文件的数据导入到指定数据库的指定表中,看看是否可以成功。
45 Hive实战
Hive概述
Hive 是 Facebook 开源的一款基于 Hadoop 的数据仓库工具,目前由 Apache 软件基金会维护,它是应用最为广泛的大数据解决方案。简单的说,Hive 能将 SQL 查询转变为 MapReduce 或 Spark 任务,对 SQL 提供了完美的支持,能够非常方便的实现大数据统计,让不会使用 Java、Scala 语言的人也可以玩转大数据平台和分布式文件系统,实现对数据的存储和处理。
(原图缺失:QQ20220708-235815@2x.png,请到原仓库查看)

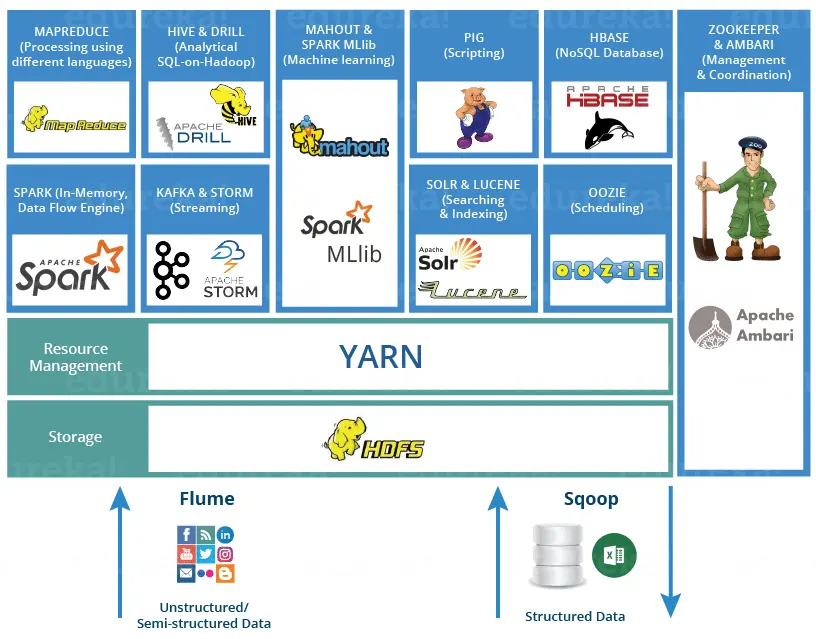
Hive 的主要作用包括:
- 将结构化的数据文件映射为一张表。
- 提供类 SQL 的查询语言 HiveQL来操作大规模数据。
- 底层依赖 Hadoop 的 HDFS 存储和 MapReduce / Spark / Tez 引擎执行任务。
Hive 的特点如下所示:
- 类 SQL 语法:支持 SQL 查询,降低大数据学习门槛。
- 可扩展性:能够比较容易的支持 PB 级别数据。
- 灵活存储:支持多种存储格式(Text、ORC、Parquet、Avro 等)。
- 可选择的计算引擎:底层执行引擎有 MapReduce、Tez、Spark。
- 延迟较高:适合离线分析,不适合低延迟 OLTP 查询。
Hive 和传统关系型数据库的对比:
(原图缺失:QQ20220707-195545@2x.png,请到原仓库查看)

环境搭建
准备工作
说明:下面的操作以 Ubuntu 系统为例。
-
同步时区
Terminal window sudo timedatectl set-timezone Asia/Shanghai -
修改下载源
Terminal window sudo mv /etc/apt/sources.list /etc/apt/sources.list.baksudo vi /etc/apt/sources.listTerminal window # 24.04 /etc/apt/sources.listdeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ focal main restricted universe multiversedeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ focal-updates main restricted universe multiversedeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ focal-backports main restricted universe multiversedeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ focal-security main restricted universe multiverseTerminal window # 18.04 /etc/apt/sources.listdeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic main restricted universe multiversedeb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic main restricted universe multiversedeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-updates main restricted universe multiversedeb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-updates main restricted universe multiversedeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-backports main restricted universe multiversedeb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-backports main restricted universe multiversedeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-security main restricted universe multiversedeb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-security main restricted universe multiversedeb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-proposed main restricted universe multiversedeb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-proposed main restricted universe multiverse -
安装工具软件
Terminal window sudo apt updatesudo apt upgradesudo apt install -y vim wget net-tools openssh-server -
启动 SSH
Terminal window sudo systemctl start sshsudo systemctl enable sshsudo systemctl status ssh -
配置防火墙
Terminal window sudo ufw enablesudo ufw allow sshsudo ufw statussudo ufw disable -
准备 Hadoop
Terminal window wget https://archive.apache.org/dist/hadoop/common/stable2/hadoop-2.10.2.tar.gzsudo tar -zxvf hadoop-2.10.2.tar.gz -C /opt -
准备 Hive
Terminal window wget https://archive.apache.org/dist/hive/stable-2/apache-hive-2.3.9-bin.tar.gzsudo tar -zxvf apache-hive-2.3.9-bin.tar.gz -C /opt
Java 环境
-
检查
Terminal window java -version -
搜索
Terminal window sudo apt search openjdk -
安装
sudo apt install -y openjdk-8-jdk
MySQL 环境
-
安装
Terminal window sudo apt install mysql-server -
配置
Terminal window mysql_secure_installation -
启动
Terminal window sudo systemctl enable mysqlsudo systemctl start mysqlsudo systemctl status mysql
Hadoop 配置
提示:详见 PDF 文档。
Hive 配置
提示:详见 PDF 文档。
启动环境
-
启动 HDFS
Terminal window start-dfs.shstart-yarn.sh -
启动 Hive
Terminal window hive --service metastore &hive --service hiveserver2 > hiveserver2.log 2> hiveerrors.log & -
检查端口
Terminal window ss -ntlnetstat -ntlp
常用命令
| 命令 | 用途说明 |
|---|---|
hadoop fs -ls <path> | 列出目录内容,类似 Linux ls |
hadoop fs -ls -R <path> | 递归列出目录下所有文件 |
hadoop fs -du <path> | 显示文件或目录大小(非递归) |
hadoop fs -du -s <path> | 汇总显示目录总大小 |
hadoop fs -du -h <path> | 以可读格式(KB/MB/GB)显示文件大小 |
hadoop fs -COUNT <path> | 统计目录下的文件数、目录数、总字节数 |
hadoop fs -mkdir <path> | 创建目录 |
hadoop fs -mkdir -p <path> | 递归创建多级目录 |
hadoop fs -rm <path> | 删除文件 |
hadoop fs -rm -r <path> | 递归删除目录 |
hadoop fs -copyFromLocal <local> <hdfs> | 从本地复制文件到 HDFS |
hadoop fs -moveFromLocal <local> <hdfs> | 从本地移动文件到 HDFS(复制后删除本地文件) |
hadoop fs -copyToLocal <hdfs> <local> | 从 HDFS 复制文件到本地 |
hadoop fs -moveToLocal <hdfs> <local> | 从 HDFS 移动文件到本地(复制后删除 HDFS 文件) |
hadoop fs -put <local> <hdfs> | 等价于 -copyFromLocal,上传文件 |
hadoop fs -get <hdfs> <local> | 等价于 -copyToLocal,下载文件 |
hadoop fs -getmerge <hdfs_dir> <local_file> | 合并 HDFS 目录下的文件,保存到本地单一文件 |
hadoop fs -cat <path> | 输出文件内容到标准输出(适合查看小文件) |
hadoop fs -tail <path> | 显示文件结尾的部分内容 |
hadoop fs -text <path> | 以文本方式查看压缩文件(如 Gzip、SequenceFile)内容 |
hadoop fs -appENDToFile <local_file> <hdfs_file> | 将本地文件内容追加到 HDFS 文件末尾 |
hadoop fs -cp <src> <dst> | 在 HDFS 内部复制文件或目录 |
hadoop fs -mv <src> <dst> | 在 HDFS 内部移动/重命名文件或目录 |
hadoop fs -chown <user:group> <path> | 修改文件或目录的所有者和用户组 |
hadoop fs -chgrp <group> <path> | 修改文件或目录所属用户组 |
hadoop fs -chmod <mode> <path> | 修改文件或目录权限,类似 Linux chmod |
hadoop fs -stat <format> <path> | 显示文件或目录状态信息(如大小、修改时间) |
hadoop fs -expunge | 清空 HDFS 垃圾回收站(TrASh) |
hadoop fs -checkSUM <path> | 计算文件的校验和 |
基本语法
-
删除数据库。
DROP DATABASE IF EXISTS eshop CASCADE; -
创建数据库。
CREATE DATABASE IF NOT EXISTS eshop; -
切换上下文。
USE eshop; -
创建外部表。
CREATE EXTERNAL TABLE IF NOT EXISTS dim_user_info(user_id STRING,user_name STRING,sex STRING,age INT,city STRING,first_active_time STRING,level INT,extra1 STRING,extra2 MAP<STRING, STRING>)ROW FORMAT DELIMITEDFIELDS TERMINATED BY '\t'COLLECTION ITEMS TERMINATED BY ','MAP KEYS TERMINATED BY ':'LINES TERMINATED BY '\n'STORED AS TEXTFILE; -
加载数据。
LOAD DATA LOCAL INPATH '/home/hadoop/data/user_info/user_info.txt' OVERWRITE INTO TABLE dim_user_info;LOAD DATA INPATH '/user/data/user_info.txt' OVERWRITE INTO TABLE dim_user_info; -
创建分区表。
CREATE TABLE IF NOT EXISTS fact_user_trade(user_name STRING,piece INT,price DOUBLE,pay_amount DOUBLE,goods_category STRING,pay_time BIGINT)PARTITIONED BY (dt STRING)ROW FORMAT DELIMITEDFIELDS TERMINATED BY '\t'LINES TERMINATED BY '\n'STORED AS TEXTFILE; -
设置动态分区。
-- 设置使用动态分区SET hive.exec.dynamic.partition=true;-- 设置动态分区为非严格模式(严格模式至少要指定一个动态分区列)SET hive.exec.dynamic.partition.mode=nonstrict;-- 一次SQL操作最多能创建多少个动态分区(跨节点)SET hive.exec.max.dynamic.partitions=1000;-- 每个节点上最多能创建多少个动态分区SET hive.exec.max.dynamic.partitions.pernode=10000; -
修复分区。
MSCK REPAIR TABLE fact_user_trade; -
数据提取。
-- 开启本地模式自动判断SET hive.exec.mode.local.auto=true;-- 设置MAPREDUCE文件数量SET hive.exec.mode.local.auto.input.files.max=128;-- 设置MAPREDUCE文件大小SET hive.exec.mode.local.auto.input.bytes.max=134217728;-- 设置Reduce任务个数为1SET mapreduce.job.reduces=1;-- 查询北京女用户的姓名取前10个SELECT user_nameFROM dim_user_infoWHERE city='beijing'AND sex='female'LIMIT 10;-- 查询2019年3月24日购买了food类商品的用户名、购买数量和支付金额(不聚合)SELECT user_name, piece, pay_amountFROM fact_user_tradeWHERE dt='2019-03-24'AND goods_category='food';-- 统计用户 ELLA 在2018年的总支付金额和最近最远两次消费间隔天数SELECT SUM(pay_amount) AS total, DATEDIFF(MAX(FROM_UNIXTIME(pay_time, 'yyyy-MM-dd')),MIN(FROM_UNIXTIME(pay_time, 'yyyy-MM-dd'))) AS gap_daysFROM fact_user_tradeWHERE YEAR(dt)='2018'AND user_name='ELLA'; -
分组聚合。
-- 查询2019年1月到4月,每个品类有多少人购买,累计金额是多少SELECT goods_category, COUNT(DISTINCT user_name) AS total_user, SUM(pay_amount) AS total_payFROM fact_user_tradeWHERE dt BETWEEN '2019-01-01' AND '2019-04-30'GROUP BY goods_category;-- 查询2019年4月支付金额超过5万元的用户SELECT user_name, SUM(pay_amount) AS totalFROM fact_user_tradeWHERE dt BETWEEN '2019-04-01' AND '2019-04-30'GROUP BY user_nameHAVING SUM(pay_amount) > 50000;-- 查询2018年购买的商品品类在两个以上的用户数SELECT COUNT(t.user_name)FROM (SELECT user_name, COUNT(DISTINCT goods_category) AS totalFROM fact_user_tradeWHERE YEAR(dt)='2018'GROUP BY user_nameHAVING COUNT(DISTINCT goods_category)>2) AS t;-- 查询2019年4月支付金额最多的用户前5名SELECT user_name, SUM(pay_amount) AS totalFROM fact_user_tradeWHERE dt BETWEEN '2019-04-01' AND '2019-04-30'GROUP BY user_nameORDER BY total DESCLIMIT 5;-- 统计不同年龄段的用户数SELECT CASE WHEN age < 20 THEN '20岁以下'WHEN age < 30 THEN '30岁以下'WHEN age < 40 THEN '40岁以下'ELSE '40岁以上'END AS age_seg,COUNT(DISTINCT user_id) AS totalFROM dim_user_infoGROUP BY CASE WHEN age < 20 THEN '20岁以下'WHEN age < 30 THEN '30岁以下'WHEN age < 40 THEN '40岁以下'ELSE '40岁以上'END;-- 统计激活时间在2018年,年龄段在20-30岁、30-40岁的用户婚姻状况SELECT age_seg,IF(marriage_status = 1, '已婚', '未婚') AS marriage_status,COUNT(*) AS totalFROM (SELECT CASE WHEN age < 20 THEN '20岁以下'WHEN age < 30 THEN '20-30岁'WHEN age < 40 THEN '30-40岁'ELSE '40岁以上'END AS age_seg,extra2['marriage_status'] AS marriage_statusFROM dim_user_infoWHERE TO_DATE(first_active_time) BETWEEN '2018-01-01' AND '2018-12-31') AS tWHERE age_seg in ('20-30岁', '30-40岁')GROUP BY age_seg, IF(marriage_status = 1, '已婚', '未婚');-- 统计每个用户购买过哪些品类的商品SELECT user_name,COLLECT_SET(goods_category) AS categoriesFROM fact_user_tradeGROUP BY user_name;-- 将数组拼接成字符串SELECT user_name, CONCAT_WS(', ', COLLECT_SET(goods_category)) AS categoriesFROM fact_user_tradeGROUP BY user_name;-- 将数据聚合成映射类型(map)SELECT user_name, STR_TO_MAP(CONCAT_WS(',', COLLECT_LIST(CONCAT(goods_category, ':', cnt)))) AS category_cnt_mapFROM (SELECT user_name, goods_category, COUNT(*) AS cntFROM fact_user_tradeGROUP BY user_name, goods_category) AS tGROUP BY user_name; -
数据抽样。
-- 数据抽样SELECT *FROM fact_user_tradeWHERE RAND() < 0.1;SELECT *FROM fact_user_tradeTABLESAMPLE(BUCKET 1 OUT OF 10 ON user_name);-- 二进制存储支持(如ORC)-- SELECT *-- FROM fact_user_trade-- TABLESAMPLE(BYTE 100M); -
横向展开。
-- 创建视图CREATE OR REPLACE VIEW v_user_categoriesASSELECT user_name, COLLECT_SET(goods_category) AS categoriesFROM fact_user_tradeWHERE dt BETWEEN '2019-04-01' and '2019-04-30'GROUP BY user_name;CREATE OR REPLACE VIEW v_user_categories_mapASSELECT user_name, STR_TO_MAP(CONCAT_WS(',', COLLECT_LIST(CONCAT(goods_category, ':', cnt)))) AS category_cnt_mapFROM (SELECT user_name, goods_category, COUNT(*) AS cntFROM fact_user_tradeWHERE dt BETWEEN '2019-04-01' AND '2019-04-30'GROUP BY user_name, goods_category) AS tGROUP BY user_name;-- 横向展开数组(array)SELECT user_name, categoryFROM v_user_categoriesLATERAL VIEW EXPLODE(categories) t AS category;-- 横向展开映射(map)SELECT user_name, category, cntFROM v_user_categories_mapLATERAL VIEW EXPLODE(category_cnt_map) t AS category, cnt;
建表操作
数据类型
Hive 的数据类型大体分为三类:原始类型、复杂类型、嵌套类型。
| 数据类型 | 类型说明 | 使用场景 |
|---|---|---|
| TINYINT | 1 字节有符号整数,取值范围 -128~127。 | |
| SMALLINT | 2 字节有符号整数,取值范围 -32768 ~ 32767。 | |
| INT | 4 字节有符号整数,取值范围 -2147483648~2147483647。 | |
| BIGINT | 8 字节有符号整数,取值范围 -9223372036854775808~9223372036854775807。 | 计数、ID |
| BOOLEAN | 布尔值,TRUE 或者 FALSE。 | |
| FLOAT | 单精度浮点数(4 字节)。 | |
| DOUBLE | 双精度浮点数(8 字节)。 | |
| DECIMAL(P, S) | 高精度小数,P=总位数,S=小数位数。 | 订单金额 |
| STRING | 长度可变字符串 | 文本、JSON |
| CHAR | 固定长度字符串 | |
| VARCHAR | 限定最大长度字符串 | |
| BINARY | 二进制数据 | |
| TIMESTAMP | 时间戳 | 精确到毫秒 |
| DATE | 日期 | |
| INTERVAL | 时间间隔类型 | |
| STRUCT | 和C语言中的结构体类似,STRUCT<first_name:STRING, lASt_name:STRING> | 玩家行为 |
| MAP | 由键值对构成的元素的集合,MAP<STRING, INT> | 商品属性 |
| ARRAY | 具有相同类型的变量的容器,ARRAY<STRING> | 装备列表 |
复杂类型和嵌套类型的用法如下所示。
CREATE TABLE complex( c1 ARRAY<INT>, c2 MAP<STRING, INT>, c3 STRUCT<a:STRING, b:INT, c:DOUBLE>, c4 STRUCT<name:STRING, addrs:ARRAY<STRUCT<city:STRING, zipcode:STRING>>>);
SELECT c1[0] , c2['key'] , c3.b , c4.addrs[0].city FROM complex;Hive 数据类型支持两种转换:
-
隐式转换:TINYINT → INT → BIGINT → DOUBLE → STRING、FLOAT → DOUBLE。
-
显示转换:
SELECT CAST('123' AS INT);SELECT CAST(3.14159 AS DECIMAL(5,2));
表类型
Hive 中的表类型如下所示:
| 表类型 | 定义/创建方式 | 存储位置 | 生命周期 | 特点 | 应用场景 |
|---|---|---|---|---|---|
| 内部表 (Managed Table) | CREATE TABLE t1 (id INT, name STRING); | 数据存放在 Hive 仓库目录下 (/user/hive/warehouse/...) | 表删除时数据也被删除 | Hive 全权管理元数据和数据 | 临时性数据、实验性数据 |
| 外部表 (External Table) | CREATE EXTERNAL TABLE t2 (id INT, name STRING) LOCATION '/data/t2'; | 数据存放在用户指定目录 | 表删除时数据保留,只删除元数据 | 元数据和数据分离,便于共享 | 数据共享、避免误删、数据湖场景 |
| 分区表 (Partitioned Table) | CREATE TABLE sales (id INT, amount INT) PARTITIONED BY (dt STRING, region STRING); | 每个分区对应一个子目录 | 分区字段不存储在表数据文件里,而作为路径目录 | 提高查询效率(按分区裁剪数据) | 时间序列、地域划分、日志数据 |
| 分桶表 (Bucketed Table) | CREATE TABLE users (id INT, name STRING) CLUSTERED BY (id) INTO 8 BUCKETS; | 每个分桶对应一个文件 | 分桶数固定 | 数据按哈希分布到桶文件,便于采样、Join 优化 | 等值 Join、大表抽样、数据均衡分布 |
| 临时表 (Temporary Table) | CREATE TEMPORARY TABLE tmp (id INT); | 仅存在于当前会话内存中 | 会话结束后自动销毁 | 不会落盘,不更新 Hive 元数据 | 临时计算、会话级中间结果 |
| 视图 (View) | CREATE VIEW v1 AS SELECT ...; | 不存储数据,只存元数据定义 | 与底层表绑定 | 类似虚拟表 | 数据安全、SQL 复用、封装复杂查询 |
修饰符
创建表的时候可以使用的修饰符如下:
| 关键字 | 作用 | 写了时的效果 | 不写时的默认值 |
|---|---|---|---|
| EXTERNAL | 指定外部表 | CREATE EXTERNAL TABLE ... LOCATION ... → 表和数据分离,删表不删数据 | 内部表 (Managed Table),删表时数据目录会一起删除 |
| PARTITIONED BY | 定义分区字段 | PARTITIONED BY (dt STRING, city STRING) → 数据写到子目录 /table/dt=2025-08-26/city=Beijing/ | 非分区表,所有数据放在一个目录下 |
| CLUSTERED BY … INTO N BUCKETS | 分桶 | CLUSTERED BY (user_id) INTO 8 BUCKETS → 数据按哈希分布到 8 个文件桶 | 不分桶,数据就是普通文件 |
| STORED AS | 文件存储格式 | 常用:TEXTFILE、SEQUENCEFILE、ORC、PARQUET | TEXTFILE(文本文件) |
| ROW FORMAT | 指定行格式和 SerDe | 比如 ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' 或 ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.JsonSerDe' | LazySimpleSerDe(默认分隔符 \001,就是不可见的 Ctrl+A) |
| LOCATION | 指定 HDFS 路径 | LOCATION '/user/hive/custom_path' → 表数据存放到自定义路径 | 默认放到 仓库目录:/user/hive/warehouse/<db>.db/<table>/ |
| TBLPROPERTIES/DBPROPERTIES | 存储一些元数据属性 | TBLPROPERTIES ('creator'='Hao') | 空,除非手动添加 |
| COMMENT | 表/字段备注 | COMMENT '用户交易事实表' | 空 |
ROW FORMAT
| 写法 | 说明 | 常见场景 |
|---|---|---|
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' | 按分隔符解析 | CSV/TSV/文本 |
ROW FORMAT DEFAULT | 默认格式,同下 | CSV/TSV/文本 |
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.LazySimpleSerDe' | 默认 SerDe,同上 | 文本表(\001 分隔) |
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OpenCSVSerde' | 更智能的 CSV 解析 | 有引号/转义的 CSV |
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe' | 用正则匹配行 | 日志类数据 |
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.JsonSerDe' | JSON 格式解析 | JSON 文件 |
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.AvroSerDe' | Avro 格式 | JSON + 二进制压缩 |
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.ParquetHiveSerDe' | Parquet 格式 | Parquet 数据 |
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OrcSerde' | ORC 格式 | ORC 数据 |
说明:只有使用非默认格式(CSV/JSON/Regex) 时才需要显式指定 SERDE。
写入数据
| 写入方式 | 示例语法 | 特点 | 适用场景 |
|---|---|---|---|
| INSERT INTO | INSERT INTO TABLE sales PARTITION (dt='2025-08-26') SELECT * FROM tmp_sales; | 向表/分区 追加数据,不会覆盖原有内容 | 日常数据追加写入(日志、交易流水) |
| INSERT OVERWRITE | INSERT OVERWRITE TABLE sales PARTITION (dt='2025-08-26') SELECT * FROM tmp_sales; | 覆盖目标表/分区的数据(先删后写) | 周期性全量刷新数据(如 T+1 日报、月报) |
| LOAD DATA | LOAD DATA INPATH '/user/hadoop/data.txt' INTO TABLE sales; | 移动文件到 Hive 表目录(不做解析),速度快 | 已有 HDFS 文件直接导入 Hive |
| LOAD DATA LOCAL | LOAD DATA LOCAL INPATH '/home/user/data.txt' INTO TABLE sales; | 从 本地文件系统拷贝数据到 Hive 表 | 本地临时数据快速导入 |
| CREATE TABLE AS SELECT (CTAS) | CREATE TABLE new_sales AS SELECT * FROM sales WHERE dt='2025-08-26'; | 新建表并写入查询结果,一步到位 | 生成中间表/派生表,数据探索 |
| INSERT + Directory (写 HDFS) | INSERT OVERWRITE DIRECTORY '/tmp/export/' ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' SELECT * FROM sales; | 把查询结果写到 HDFS 目录,可指定分隔符/格式 | 数据导出,和其他系统交互 |
| INSERT + LOCAL Directory (写本地) | INSERT OVERWRITE LOCAL DIRECTORY '/home/user/export/' ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' SELECT * FROM sales; | 把结果写到 本地目录 | 小规模结果导出,本地分析 |
| 外部表写入 (External Table) | CREATE EXTERNAL TABLE ext_sales (...) LOCATION '/data/sales'; | 外部表只管理元数据,实际写入依赖 LOAD DATA/INSERT | 共享数据目录,防止误删 |
| 动态分区写入 | SET hive.exec.dynamic.partition=true; SET hive.exec.dynamic.partition.mode=nonstrict; INSERT OVERWRITE TABLE sales PARTITION (dt) SELECT id, amount, dt FROM tmp; | 自动根据字段值生成分区目录 | 大规模分区表装载数据 |
常用函数
数学函数 (Math Functions)
| 函数 | 说明 | 示例 |
|---|---|---|
abs(x) | 绝对值 | abs(-10) = 10 |
round(x[, d]) | 四舍五入,d 为保留小数位 | round(3.14159, 2) = 3.14 |
floor(x) | 向下取整 | floor(3.9) = 3 |
ceil(x) | 向上取整 | ceil(3.1) = 4 |
rand() | 生成 [0,1) 随机数 | rand() |
pow(x, y) / power(x,y) | 幂运算 | pow(2,3) = 8 |
sqrt(x) | 开平方 | sqrt(16) = 4 |
exp(x) | e^x | exp(1) ≈ 2.718 |
ln(x) | 自然对数 | ln(e) = 1 |
log10(x) | 以 10 为底对数 | log10(100) = 2 |
字符串函数 (String Functions)
| 函数 | 说明 | 示例 |
|---|---|---|
length(str) | 字符串长度 | length('hive') = 4 |
upper(str) | 转大写 | upper('hive') = HIVE |
lower(str) | 转小写 | lower('HIVE') = hive |
concat(str1,str2,…) | 拼接字符串 | concat('hive','sql') = hivesql |
concat_ws(sep,str1,str2,…) | 用分隔符拼接 | concat_ws('-', 'a','b','c') = a-b-c |
substr(str, start, len) | 截取子串 | substr('hive',2,2) = iv |
instr(str, substr) | 返回子串位置 | instr('hive','iv') = 2 |
split(str, regex) | 字符串分割成数组 | split('a,b,c',',') = ['a','b','c'] |
regexp_extract(str, pattern, idx) | 正则提取 | regexp_extract('abc123','([0-9]+)',1) = 123 |
regexp_replace(str, pattern, rep) | 正则替换 | regexp_replace('abc123','[0-9]','X') = abcXXX |
trim(str) | 去掉首尾空格 | trim(' hi ') = hi |
lpad(str,n,pad) | 左填充到 n 长度 | lpad('hi',5,'*') = ***hi |
rpad(str,n,pad) | 右填充到 n 长度 | rpad('hi',5,'*') = hi*** |
日期时间函数 (Date & Time Functions)
| 函数 | 说明 | 示例 |
|---|---|---|
current_date | 当前日期 | 2025-09-15 |
current_timestamp | 当前时间戳 | 2025-09-15 22:00:00 |
unix_timestamp() | 当前时间戳(秒) | 1694784000 |
from_unixtime(ts, fmt) | 时间戳转字符串 | from_unixtime(1694784000,'yyyy-MM-dd') = 2025-09-15 |
to_date(str) | 字符串转日期 | to_date('2025-09-15 22:00:00') = 2025-09-15 |
year(dt) | 提取年 | year('2025-09-15') = 2025 |
month(dt) | 提取月 | month('2025-09-15') = 9 |
day(dt) / dayofmonth(dt) | 提取日 | day('2025-09-15') = 15 |
hour(ts) | 提取小时 | hour('2025-09-15 22:30:00') = 22 |
minute(ts) | 提取分钟 | minute('2025-09-15 22:30:00') = 30 |
second(ts) | 提取秒 | second('2025-09-15 22:30:00') = 0 |
datediff(dt1,dt2) | 日期相差天数 | datediff('2025-09-15','2025-09-10') = 5 |
add_months(dt,n) | 日期加 n 月 | add_months('2025-09-15',2) = 2025-11-15 |
date_add(dt,n) | 日期加 n 天 | date_add('2025-09-15',10) = 2025-09-25 |
date_sub(dt,n) | 日期减 n 天 | date_sub('2025-09-15',10) = 2025-09-05 |
条件函数 (Conditional Functions)
| 函数 | 说明 | 示例 |
|---|---|---|
if(cond, t, f) | 条件判断 | if(1=1,'yes','no') = yes |
case when ... then ... else ... end | 多条件判断 | case when age>18 then 'adult' else 'child' end |
coalesce(x1,x2,...) | 返回第一个非 NULL 值 | coalesce(null,'hive','sql') = hive |
nvl(x, y) | 如果 x 为 NULL,返回 y | nvl(null,0) = 0 |
聚合函数 (Aggregate Functions)
| 函数 | 说明 | 示例 |
|---|---|---|
count(*) | 计数 | count(*) |
sum(x) | 求和 | sum(price) |
avg(x) | 平均值 | avg(score) |
max(x) | 最大值 | max(age) |
min(x) | 最小值 | min(age) |
collect_set(x) | 去重集合 | ['a','b','c'] |
collect_list(x) | 包含重复的集合 | ['a','b','a'] |
类型转换函数 (Type Conversion Functions)
| 函数 | 说明 | 示例 |
|---|---|---|
cast(x AS type) | 类型转换 | cast('123' as int) = 123 |
typeof(x) | 返回字段类型 | typeof(123) = int |
复杂类型函数 (Complex Types)
| 函数 | 说明 | 示例 |
|---|---|---|
size(array/map) | 获取大小 | size(array('a','b')) = 2 |
map_keys(map) | 返回所有 key | map_keys(map('a',1,'b',2)) = ['a','b'] |
map_values(map) | 返回所有 value | map_values(map('a',1,'b',2)) = [1,2] |
sort_array(array) | 数组排序 | sort_array(array(3,1,2)) = [1,2,3] |
array_contains(array, val) | 是否包含元素 | array_contains(array('a','b'),'a') = true |
窗口函数 (Window Functions)
常用于 排名、累计计算、分组内计算。
| 函数 | 说明 | 示例 |
|---|---|---|
row_number() | 分组内行号 | row_number() over(partition by dept order by salary desc) |
rank() | 排名(有并列,跳跃排名) | rank() over(order by score desc) |
dense_rank() | 排名(有并列,不跳跃) | dense_rank() over(order by score desc) |
lag(col,n,default) | 往前取第 n 行值 | lag(salary,1,0) over(order by id) |
lead(col,n,default) | 往后取第 n 行值 | lead(salary,1,0) over(order by id) |
first_value(col) | 分组内第一个值 | first_value(salary) over(order by id) |
last_value(col) | 分组内最后一个值 | last_value(salary) over(order by id) |
sum(col) over(...) | 窗口内累计和 | sum(sales) over(partition by region order by month) |
应用举例
-
FROM_UNIXTIME:将时间戳转换成日期SELECT FROM_UNIXTIME(pay_time, 'yyyy-MM-dd hh:mm:ss')FROM fact_user_trade LIMIT 10; -
DATEDIFF:计算两个日期的时间差-- 用户首次激活时间与设定参照时间的间隔SELECT user_name, DATEDIFF('2019-4-1', to_date(firstactivetime))FROM dim_user_info LIMIT 10; -
IF:根据条件返回不同的值-- 不同性别高级等用户数量SELECT sex, IF(level > 5, '高', '低') AS level_type, COUNT(DISTINCT user_id) AS totalFROM dim_user_infoGROUP BY sex, IF(level > 5, '高', '低'); -
SUBSTR:字符串取子串-- 统计每个月激活的新用户数SELECT SUBSTR(first_active_time, 1, 7) AS month, COUNT(DISTINCT user_id) AS totalFROM dim_user_infoGROUP BY substr(first_active_time, 1, 7); -
GET_JSON_OBJECT:从 JSON 字符串中取出指定的key对应的value,如:GET_JSON_OBJECT(info, '$.first_name')。-- 统计不同手机品牌的用户数SELECT GET_JSON_OBJECT(extra1, '$.phonebrand') AS phone, COUNT(DISTINCT user_id) AS totalFROM user_infoGROUP BY GET_JSON_OBJECT(extra1, '$.phonebrand');说明:MySQL 对应的函数名字叫
JSON_EXTRACT。
分组聚合
| 操作 | 示例语法 | 功能说明 | 结果特点 | 典型应用场景 |
|---|---|---|---|---|
| GROUP BY | SELECT region, product, SUM(amount) FROM sales GROUP BY region, product; | 按指定列分组 | 只输出 一个维度组合 的聚合 | 单维度或固定组合汇总 |
| GROUPING SETS | SELECT region, product, SUM(amount) FROM sales GROUP BY GROUPING SETS ((region, product), (region), (product), ()); | 一次性指定多个分组组合 | 输出指定的 多个维度组合结果,可包含总计 | 报表统计时只关心部分组合 |
| CUBE | SELECT region, product, SUM(amount) FROM sales GROUP BY CUBE(region, product); | 自动生成所有维度的组合 | 输出 所有维度组合(2^n 种) | OLAP 全量多维分析 |
抽样操作
| 抽样方式 | 语法示例 | 核心语义 | 是否随机 | 可重复性 | 精度/偏差 | 依赖前提 | 性能与注意点 | 典型用途 |
|---|---|---|---|---|---|---|---|---|
| BUCKET 抽样(物理桶) | SELECT * FROM t TABLESAMPLE(BUCKET 2 OUT OF 8); | 选取分桶表的第2个物理桶(总8桶) | 否 | 稳定(由分桶写入决定) | 与建表分桶分布一致 | 表必须是 CLUSTERED BY … INTO 8 BUCKETS | 只读命中部分文件,快;但只在分桶表可用 | 大表等比例取样/一致性校验 |
| BUCKET 抽样(逻辑桶) | SELECT * FROM t TABLESAMPLE(BUCKET 1 OUT OF 4 ON user_id); | 按 hASh(user_id) 把数据映射到4个逻辑桶,取第1桶 | 伪随机(哈希) | 稳定(同 key 结果一致) | 近似 1/4,受 key 倾斜影响 | 无需分桶表 | 只扫命中行;分布受 key 倾斜影响 | 训练/评估集一致切分、AB 分流 |
| 概率抽样(Bernoulli) | SELECT * FROM t WHERE RAND() < 0.1; | 按 10% 概率独立抽取每行 | 是 | 可用 RAND(42) 固定种子 | 期望10%,小样本波动大 | 无 | 全表扫描;易受数据量影响 | 快速下采样、探索性分析 |
| 按组固定样本数 | SELECT * FROM (SELECT *, ROW_NUMBER() OVER(PARTITION BY gid ORDER BY RAND()) rn FROM t) x WHERE rn ≤ 100; | 每组(gid)随机取 固定 N 条 | 是 | 可用 RAND(42) | 各组样本量严格相等 | 需支持窗口函数 | 两次扫描+排序,成本中等 | 类均衡采样、按省份/品类取样 |
| 每组比例抽样 | WHERE RAND() < CASE WHEN gid='A' THEN 0.2 ELSE 0.05 END | 按组设定不同抽样率 | 是 | 可固定种子 | 期望比例,组内波动 | 无 | 全表扫描 | 不同业务线/权重抽样 |
| LIMIT 截取(非随机) | SELECT * FROM t LIMIT 1000; | 取前 N 行(非随机) | 否 | 稳定(受文件/分片顺序影响) | 有偏(非随机) | 无 | 最快;仅用于调试预览 | 开发调试、字段检查 |
| 每桶/每Reducer取 Top-N(非随机) | ... DISTRIBUTE BY k SORT BY k LIMIT 100;(或每组 ROW_NUMBER) | 每个分片/组取前 N | 否 | 稳定 | 有偏(按排序规则) | 需分发/排序 | 适合并行 TopN,不是随机抽样 | TopN per group、分片抽取 |
排序操作
| 排序方式 | 语法示例 | 核心语义 | Reducer 数 | 是否全局有序 | Shuffle/排序行为 | 性能与注意点 | 典型用途 |
|---|---|---|---|---|---|---|---|
| ORDER BY | SELECT * FROM t ORDER BY ts DESC; | 全局排序 | 1 个(单 reducer) | 是 | 所有数据进 1 个 reducer 做总排序 | 最慢;单点瓶颈;大结果易 OOM;适合小结果集或配合 LIMIT | 导出小结果、最终展示 |
| ORDER BY … LIMIT | SELECT * FROM t ORDER BY score DESC LIMIT 1000; | 全局 Top-N | 1 个 | 是 | 仍单 reducer,但 LIMIT 可提前剪枝 | 可接受;Top-N 常用写法 | 全局 Top-N |
| SORT BY | SELECT * FROM t SORT BY ts DESC; | 每个 reducer 内部排序(局部有序) | 多个 | 否 | Map 输出按 key 分区到多 reducer;各自排序 | 快于 ORDER BY;结果整体不全局有序 | 大表分片排序、并行导出 |
| DISTRIBUTE BY | SELECT * FROM t DISTRIBUTE BY key; | 控制按 key 分发到 reducer | 多个 | 否 | 相同 key 去同一 reducer;无排序 | 常与 SORT BY 搭配使用 | 为后续聚合/排序分区 |
| DISTRIBUTE BY + SORT BY | SELECT * FROM t DISTRIBUTE BY key SORT BY key, ts DESC; | 同 key 同分片 + 分片内排序 | 多个 | 否(但每个 key 内有序) | 同一 key 的记录在同一 reducer 内按规则有序 | 常用;利于下游 merge/sort-bASed 处理 | 按用户/商品时间序列排序 |
| CLUSTER BY | SELECT * FROM t CLUSTER BY key; | DISTRIBUTE BY key + SORT BY key(升序) | 多个 | 否 | 语法糖,不能指定 ASC/DESC | 简洁,但排序方向不可控 | 分桶写入/等值 Join 预排序 |
| 分区内排序 | ... WHERE dt='2025-08-26' SORT BY ts; | 只处理某个分区的数据 | 依配置 | 分区内局部有序 | 同 SORT BY | 缩小数据量显著提速 | 分区数据导出、窗口函数前置 |
横向展开
LATERAL VIEW是 Hive 里一个非常重要的语法,主要用于和表生成函数(如:EXPLODE)结合,把一行数据拆成多行。最常见的应用场景是处理 ARRAY、MAP、 JSON 等类型的字段,也可以实现从宽表到窄表的转换。
| 用法 | 示例语法 | 功能说明 | 典型应用场景 |
|---|---|---|---|
| LATERAL VIEW explode(array) | SELECT order_id, item FROM orders LATERAL VIEW explode(items) t AS item; | 将数组拆成多行,每个元素一行 | 订单明细、事件埋点 |
| LATERAL VIEW posexplode(array) | SELECT order_id, pos, item FROM orders LATERAL VIEW explode(items) t AS pos, item; | 数组拆成多行,同时输出元素下标 | 保留顺序的点击流分析 |
| LATERAL VIEW explode(map) | SELECT user_id, k, v FROM user_tags LATERAL VIEW explode(tags) t AS k, v; | Map 拆成多行,得到 (key, value) | 用户标签、属性键值对 |
| LATERAL VIEW json_tuple(json, …) | SELECT log_id, ip, device FROM event_log LATERAL VIEW json_tuple(log_json,'ip','device') t AS ip, device; | 从 JSON 中抽取字段并生成列 | 日志解析、半结构化数据 |
| LATERAL VIEW inline(array) | SELECT order_id, col1, col2 FROM orders LATERAL VIEW inline(item_structs) t AS col1,col2; | struct 数组展开成多行多列 | 一行存多维属性时拆分 |
| LATERAL VIEW stack(n, …) | SELECT user_id, subject, score FROM user_score LATERAL VIEW stack(3,'math',math,'eng',english,'phy',physics) t AS subject, score; | 将多列转为多行 (列转行) | 宽表转长表、UNPIVOT |
HiveSQL vs. MySQL
| 特性 | Hive SQL | MySQL SQL | 区别说明 |
|---|---|---|---|
| 表分区 | PARTITIONED BY(分区):创建表时使用分区来按某一字段划分数据,能加速查询时的数据筛选。 | 不支持分区。 | Hive可以通过分区将数据分开存储,适合大数据场景。MySQL没有类似的分区机制。 |
| 表分桶 | CLUSTERED BY(分桶): 将表数据根据某一字段进行分桶,适合用于大表连接优化。 | 不支持分桶。 | Hive支持通过分桶优化连接操作,MySQL不支持分桶功能。 |
| 存储格式 | STORED AS:支持ORC、Parquet等列式存储格式。 | 使用行式存储,如InnoDB。 | Hive支持列式存储格式,优化查询和压缩,而MySQL主要使用行式存储。 |
| 查询引擎 | 支持MapReduce、Tez、Spark等多种执行引擎。 | 仅支持InnoDB引擎。 | Hive的查询可以通过不同的执行引擎(如Tez或Spark)优化执行效率,而MySQL只能使用单一引擎。 |
| 复杂查询支持 | 支持LATERAL VIEW、MAP、ARRAY等复杂数据结构处理。 | 不支持LATERAL VIEW等复杂的数据类型和处理。 | Hive支持更复杂的嵌套查询和复杂数据类型,MySQL不支持类似功能。 |
| JOIN类型 | 支持MapJoin(Map-side Join):小表加载到内存中进行Map阶段的连接,避免了Shuffle。 | 支持标准的INNER JOIN、LEFT JOIN、RIGHT JOIN、OUTER JOIN等。 | Hive的MapJoin优化可以加速小表与大表的连接操作,而MySQL没有MapJoin这种优化策略。 |
| 自定义函数(UDF) | 支持用户定义函数(UDF)和用户定义表函数(UDTF)。 | 支持用户定义函数(UDF)和触发器。 | Hive更侧重于自定义函数的灵活性,MySQL则更注重与表操作相关的函数。 |
| 查询优化 | 支持分区裁剪(Partition Pruning)、列裁剪(Column Pruning)、动态分区插入等优化。 | 基于索引的优化,但不支持类似Hive的列裁剪和分区裁剪。 | Hive拥有更多的针对大数据的查询优化机制,而MySQL主要依赖于索引和查询缓存等。 |
| 索引 | 支持CREATE INDEX:但通常不建议在Hive中使用索引,性能开销较大。 | 支持CREATE INDEX,索引是MySQL查询性能的关键之一。 | Hive中索引的使用相对较少且较为消耗资源,而MySQL通过索引大大提高了查询性能。 |
| 数据类型 | 支持ARRAY、MAP、STRUCT等复杂数据类型。 | 只支持基本数据类型,如INT、VARCHAR等。 | Hive支持更丰富的数据类型,特别是在处理结构化数据时,MySQL相对简单。 |
| NULL值处理 | 支持IS NULL、IS NOT NULL,但有时对NULL值的处理可能与MySQL有所不同,具体行为可能会受到执行引擎的影响。 | 支持IS NULL、IS NOT NULL,NULL值处理比较一致。 | Hive和MySQL都支持NULL值判断,但在大数据量查询时,Hive的NULL处理可能表现不如MySQL精确。 |
| 聚合函数 | 支持常见的聚合函数(如SUM()、COUNT()、AVG()等),并扩展支持APPROX_COUNT_DISTINCT()等近似聚合函数。 | 支持常见的聚合函数(如SUM()、COUNT()、AVG()等)。 | Hive提供了APPROX_COUNT_DISTINCT()等高效的近似聚合函数,更适合处理海量数据,而MySQL的聚合函数通常是精确计算的。 |
| 支持子查询 | 支持子查询,但对于大数据集的子查询可能不如MySQL高效,通常需要通过优化(如MAPJOIN)来加速。 | 支持子查询,MySQL的子查询优化较好,尤其在小数据量查询时表现优异。 | Hive的子查询在大数据量下性能可能不如MySQL,MySQL对子查询的优化更成熟。 |
| 表创建语法 | Hive创建表时需要指定存储格式、分区、文件格式等,示例如下: | MySQL创建表时,主要关注字段类型、索引等,示例如下: | Hive的表创建更复杂,涉及存储格式和分区等,适用于大数据场景,而MySQL的表创建更加简洁。 |
| 物化视图 | Hive支持创建物化视图(Materialized View),在某些情况下可以提升查询性能。 | MySQL不直接支持物化视图,通常通过临时表或应用层缓存实现类似功能。 | Hive提供物化视图,允许预先计算并存储查询结果,从而提高查询效率。MySQL没有原生的物化视图支持。 |
| 查询缓存 | Hive不支持查询缓存,通常通过MapJoin、索引等方式进行性能优化。 | MySQL支持查询缓存,可以缓存常见查询的结果以提高查询效率。 | MySQL具有强大的查询缓存机制,而Hive通常依赖其他优化策略来提高性能。 |
| 字符串函数 | Hive支持字符串函数,如CONCAT(), LENGTH(), SUBSTRING()等。 | MySQL也支持字符串函数,且函数的支持程度较全面。 | Hive和MySQL支持相似的字符串操作,但Hive的字符串处理通常更适合大数据分析应用。 |
| NULL默认值 | Hive中字段通常不支持为NULL指定默认值,插入数据时通常使用INSERT INTO语句。 | MySQL允许在创建表时为字段指定NULL或默认值。 | Hive不直接支持字段默认值,而MySQL允许为字段设置默认值(包括NULL)。 |
性能优化
Hive SQL查询性能优化方法有很多种,从表结构设计、查询优化到执行引擎调整等多个方面都有不同的优化方式。
| 优化方法 | 描述 | 适用场景 |
|---|---|---|
| 分区(Partitioning) | 将表按某个字段(如日期)进行分区。通过分区裁剪,只扫描符合条件的分区,减少扫描的数据量。 | 当数据量大且查询常根据某个字段(如时间、地区等)过滤时使用。 |
| 分桶(Bucketing) | 将数据根据某个字段的哈希值分成固定数量的桶。用于优化大表与小表的连接操作,特别是在进行聚合时。 | 当需要高效的连接操作和聚合时,尤其是多次对某列进行操作时。 |
| 列裁剪(Column Pruning) | 查询时仅选择需要的列,减少不必要的列扫描。 | 当查询中只需要表的部分列时。 |
| 分区裁剪(Partition Pruning) | 查询时通过裁剪掉不符合条件的分区,只扫描满足条件的分区。 | 当表有分区并且查询包含分区字段的过滤条件时。 |
| 压缩存储格式(ORC、Parquet) | 使用列式存储格式(如ORC、Parquet),比行式存储格式(如TextFile)更高效,尤其是在读取大量数据时。 | 当表的数据量大,特别是需要快速扫描时。 |
| MapJoin(Map-side Join) | 小表与大表连接时,将小表加载到内存中在Map阶段完成连接,避免了Shuffle和Reduce阶段的开销。 | 当小表足够小,能够加载到内存中时,进行小表和大表的连接。 |
| 合适的Join类型 | 使用合适的Join类型(如Sort Merge Join或Bucketed Join)可以优化连接操作的效率。 | 当两张表都根据相同列进行分桶或排序时。 |
| 合理使用Hive执行引擎 | 选择合适的执行引擎(MapReduce、Tez、Spark)可以提高查询效率。例如,Tez或Spark通常比MapReduce更高效。 | 根据数据量和查询类型选择不同的执行引擎。 |
| 使用合适的文件格式 | 选择合适的文件格式(如ORC、Parquet)可以提高存储和读取效率,特别是对于大规模数据操作。 | 需要高效存储和读取时。 |
| 开启动态分区插入 | 通过设置hive.exec.dynamic.partition=true,可以实现动态分区插入,避免手动指定每个分区。 | 当数据需要按分区动态插入时,避免手动指定分区。 |
| 减少数据扫描(推迟计算) | 使用WHERE子句避免在执行查询时扫描不必要的数据,尽量在早期阶段过滤数据。 | 当查询中涉及大量数据时,尽量在查询的早期阶段减少扫描的数据量。 |
| 分批次执行 | 对查询结果使用LIMIT进行分页查询,或者使用数据抽样(TABLESAMPLE)来减少查询的数据量。 | 当数据量过大,且对数据的完整性要求不高时。 |
| 适当使用索引 | 创建索引加速查询,尤其是对常用查询条件的列创建索引。 | 当某些列经常用作查询条件时。 |
| 查询缓存 | 启用Hive的查询缓存,缓存结果集,提高相同查询的效率。 | 当相同的查询频繁执行时。 |
| 减少MapReduce任务数量 | 通过调整mapreduce.map.memory.mb和mapreduce.reduce.memory.mb等参数,减少MapReduce任务的数量,提升计算效率。 | 当查询中涉及多个复杂的MapReduce任务时。 |
| 合理选择表的存储格式 | 为表选择合适的存储格式,避免存储格式不匹配导致性能问题。比如,ORC和Parquet格式在大数据查询中效率较高。 | 当查询的数据量很大,尤其是在读取和聚合时。 |
| 物化视图(Materialized View) | 创建物化视图,预先计算并存储查询结果,减少重复计算的开销。 | 当某些查询结果被频繁使用时,使用物化视图来提高查询效率。 |
| 并行执行(Parallel Execution) | 使用并行执行功能,设置hive.exec.parallel=true,可以并行执行多个查询任务,减少执行时间。 | 当需要执行多个查询且能够并行时。 |
Python100天
已完结分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 301 天
部分内容可能已过时
评论